DeepSeek V4.1 Flash を RTX 4090 で測定:27.9 tok/s、使えるRAMを64GiBに制限すると15.0
投稿日 動画公開
DeepSeek V4.1 Flash を Strata で RTX 4090 24GB のサーバー1台で測ると毎秒27.9トークン、エンジンが使えるRAMだけを64GiBに減らした試験では15.0トークンでした。韓国語の選択式150問は106問正解。
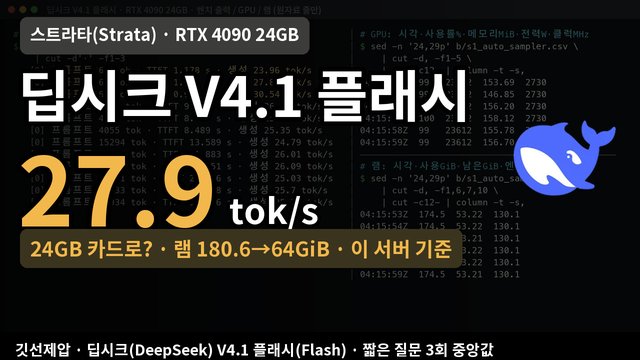
平均2.25ビットに圧縮した274GB版の DeepSeek V4.1 Flash を、Strata 0.2.13.1 で、クラウドで借りたサーバー1台(RTX 4090 24GB、RAM 実効180.6GiB)で動かして測定しました。短い質問の生成速度は毎秒27.9トークン(3回の中央値、範囲24.0~30.5)でした。エンジンが使えるRAMを64GiBまで減らすと15.0トークンまで下がりましたが、止まることはありませんでした。韓国語の選択式問題150問では106問に正解しました(70.7%)。
すべてこのサーバー1台での1回の測定で得た値です(速度は3回の中央値)。RAMの読み出し速度(このサーバーの最高値は毎秒61.4GB)が、ほかのコンピューターでも同じ値になるとは保証できません。
結論から
- 速度: 入力を約3万1千トークンに増やしても生成は毎秒25.3トークンでしたが、最初の文字が出るまで18.8秒かかり、約11万9千トークンの入力では60.6秒でした。
- RAM: エンジンが使えるRAMを180.6GiBから128、96、64GiBに減らすと、27.3、23.8、20.1、15.0トークンに下がりました(最大時に対して87、74、55%)。容量だけを減らした試験です。
- 韓国語・コーディング: KMMLU 150問中106問正解(95%区間 62.9~77.4%)。コーディングは全52問のうち最初の20問だけを解かせて16問、ツール呼び出しは49課題のうち最初の15課題で14課題が合格しました。比較するモデルがないため、良い悪いは言いません。
この記事の数字の種類
- 当チャンネルの測定: このサーバーで直接測った値です。速度は3回(長い入力は2回)の中央値です。
- 計算: 当チャンネルの値を使った算数です(最大時に対する%、採用率、信頼区間、コスト)。
- プログラム出力: Strata がサーバーで出した計画と指標です。
- 公式ドキュメント・他者の報告: Strata リポジトリのドキュメントと、そこに引用されている他の人の値です。当チャンネルの値と同じ行には並べません。
- 推定: 数字としては使っていません。
274GBのモデルが動く仕組み
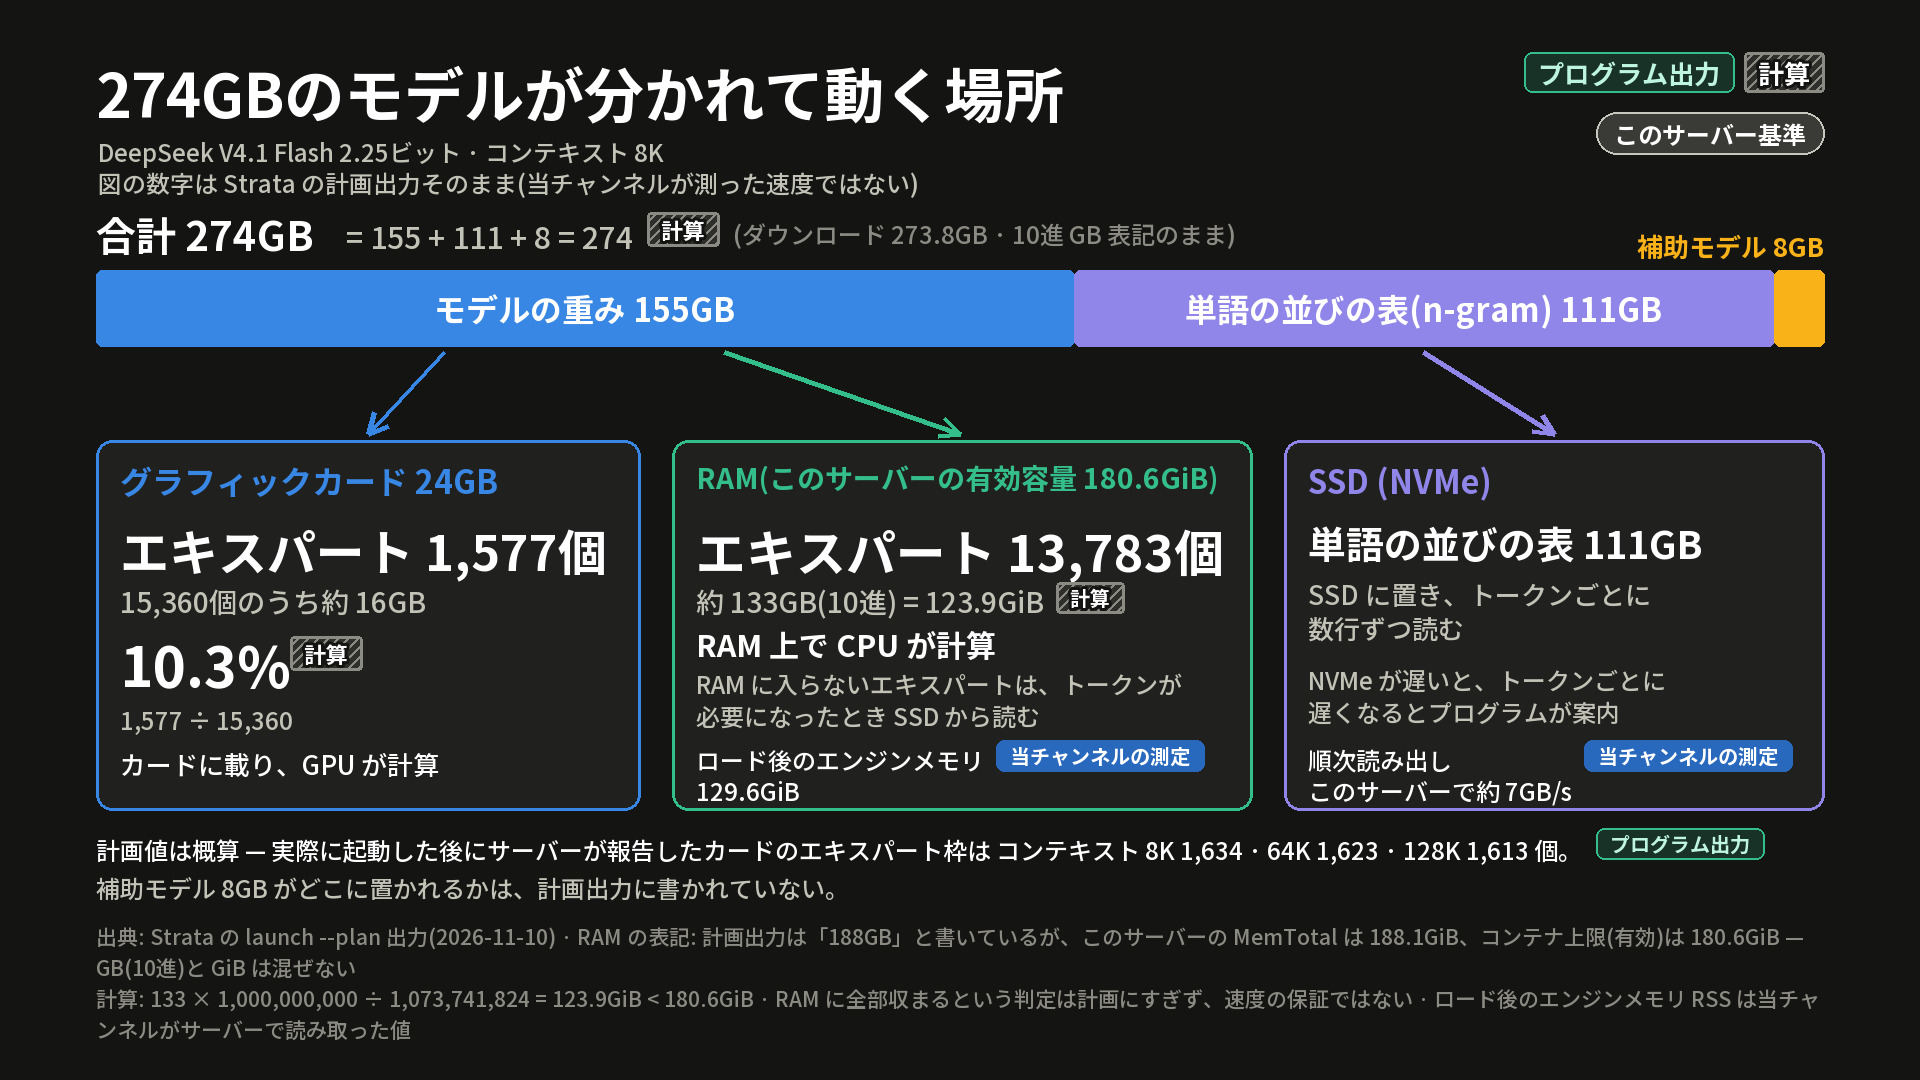
274GBは、本体155GB、単語の並びの表(n-gram)111GB、補助モデル(DSpark)8GBを足した値です(プログラム出力)。24GBのカードには丸ごと入りません。プログラムが出した計画では、エキスパート15,360個のうち1,577個(約16GB、10.3%)だけをカードに載せ、残りの13,783個(約133GB)は CPU がRAM上で計算し、RAMに入りきらないものと n-gram の表は SSD から読む、というものでした。1,577個は計画値で、実際に起動したサーバーが報告したカード上のエキスパート枠は、コンテキスト8Kで1,634個、64Kで1,623個、128Kで1,613個でした。
Strata のドキュメントには24GBのカードで測った DeepSeek の数字はなく、作者も RTX 40 シリーズでは直接試せていないと書かれています(公式ドキュメント、2026-11-10 閲覧)。
速度: 生成は毎秒22~28トークン台、最初の文字までは入力が長いほど長くなる
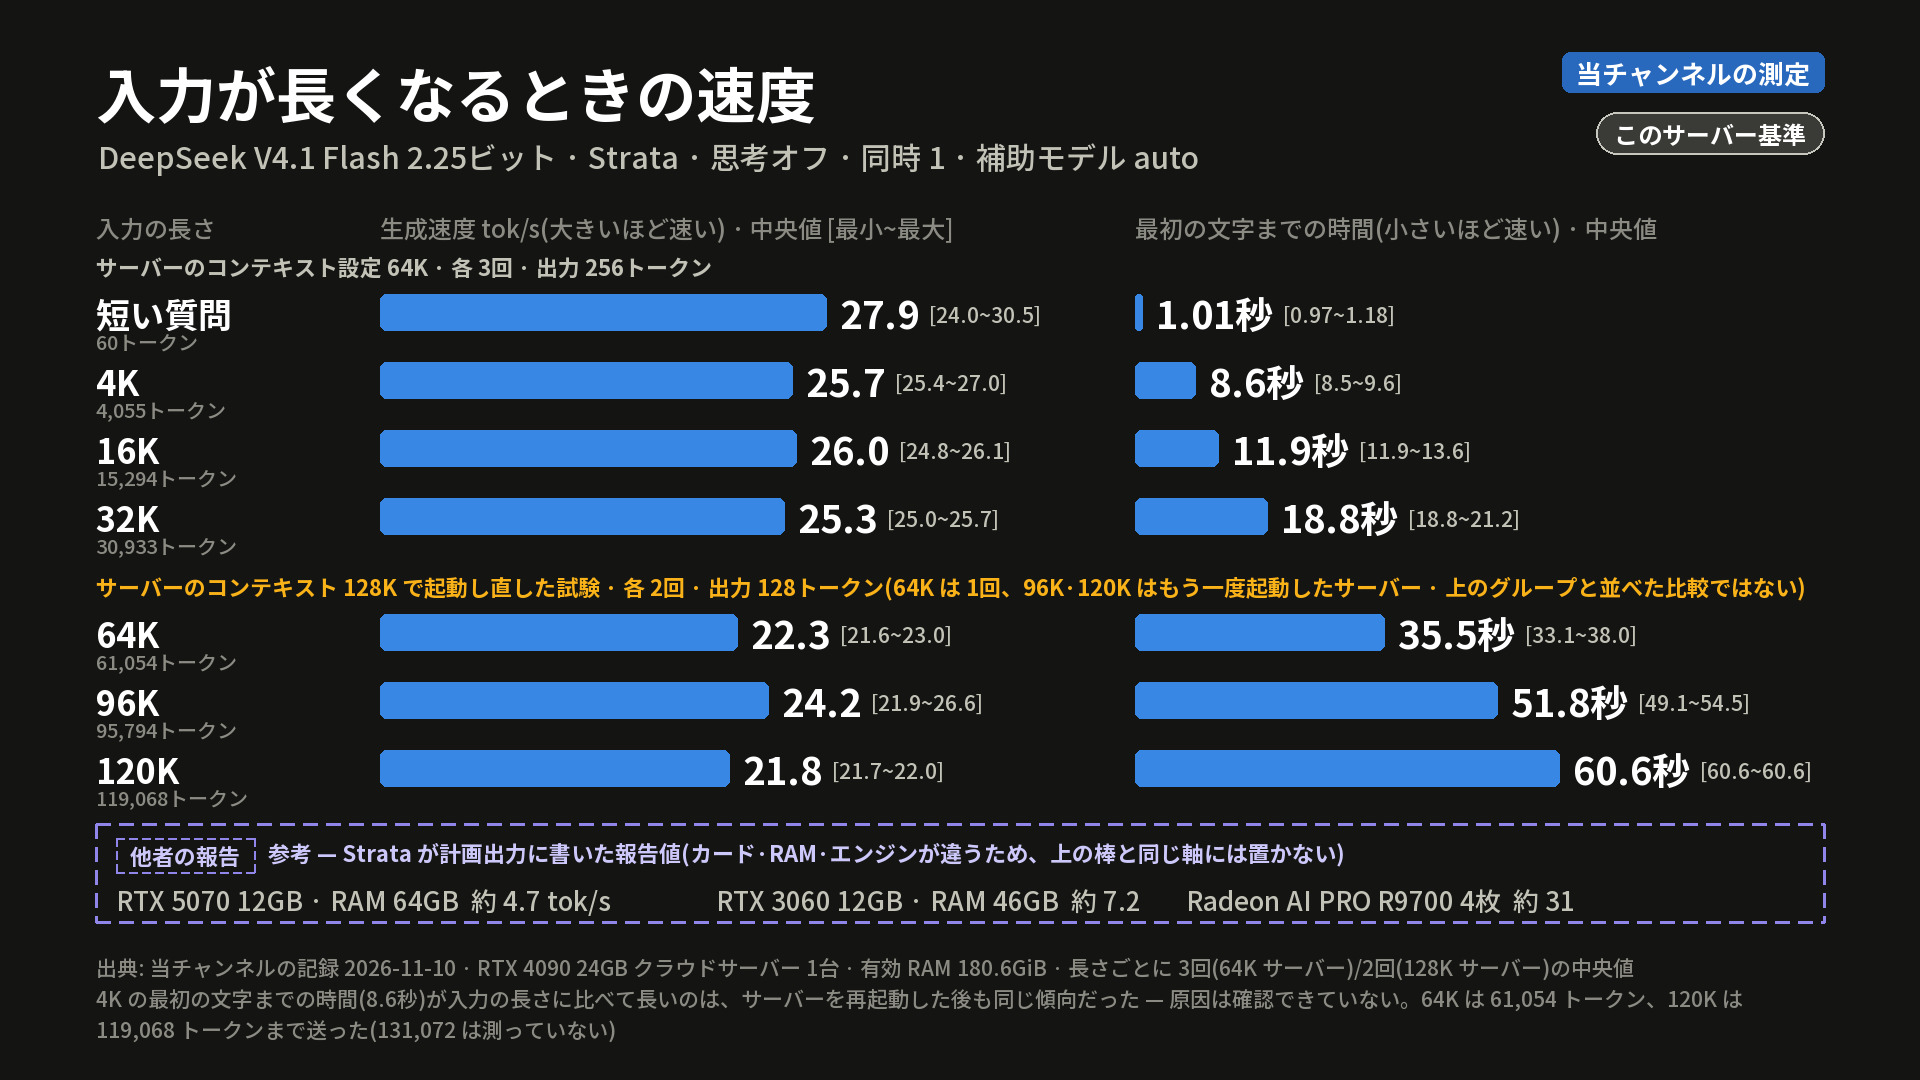
思考機能をオフにして、一度に1リクエストずつ送りました。速度試験は temperature 1.0、出力256トークンです。
| 入力 | 生成 tok/s(中央値) | 最初の文字まで |
|---|---|---|
| 短い質問(60トークン) | 27.9 | 1.01秒 |
| 4,055トークン | 25.7 | 8.6秒 |
| 15,294トークン | 26.0 | 11.9秒 |
| 30,933トークン | 25.3 | 18.8秒 |
| 61,054トークン* | 22.3 | 35.5秒 |
| 95,794トークン* | 24.2 | 51.8秒 |
| 119,068トークン* | 21.8 | 60.6秒 |
*コンテキスト上限を131,072トークンにして起動したサーバーで、各2回、出力128トークンで測りました。61,054トークンと残りの2つは、サーバーを別々に起動した値なので、上の4行と並べた比較ではありません。最も長い入力は119,069トークンで、131,072トークンのものは測れませんでした。4K入力の最初の文字までの時間(8.6秒)は、入力の長さに比べて長いのですが、サーバーを起動し直しても同じでした。理由は確認できていません。図の下の点線の枠にある RTX 5070・3060・Radeon の値は、Strata の計画出力が引用している他者の報告なので、当チャンネルの棒と同じ軸ではありません。
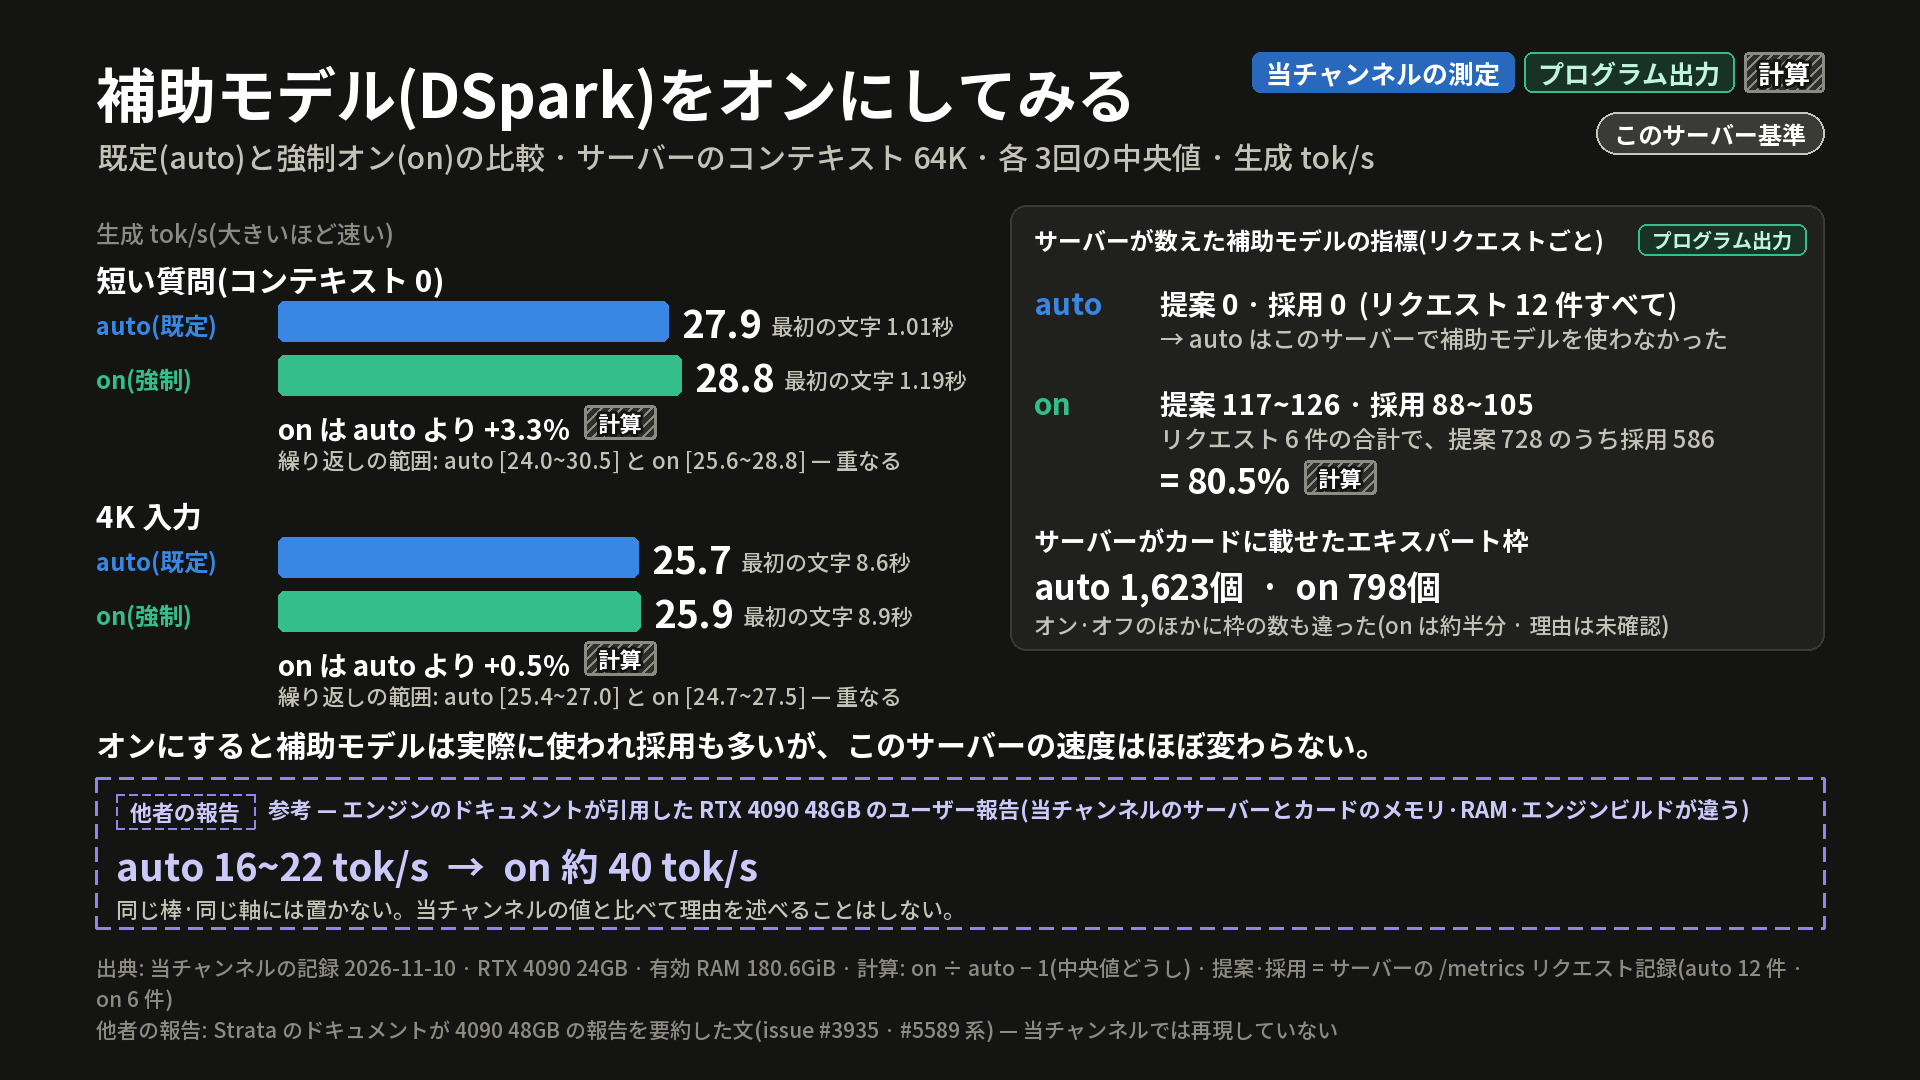
補助モデル DSpark は、デフォルト(auto)設定ではこのサーバーで使われませんでした(リクエスト12個すべてで提案0、採用0)。無理にオンにすると、提案728個のうち586個(80.5%)が採用されましたが、速度は28.8と25.9トークンで、それぞれ3.3%、0.5%高いにとどまり、3回の範囲は重なります。オンにしたサーバーはカード上のエキスパート枠が798個(デフォルトは1,623個)なので、1点だけを変えた比較でもありません。点線の枠にある RTX 4090 48GB の報告値は、カードのメモリが違うため、当チャンネルの値と並べていません(他者の報告)。
RAMを減らすと
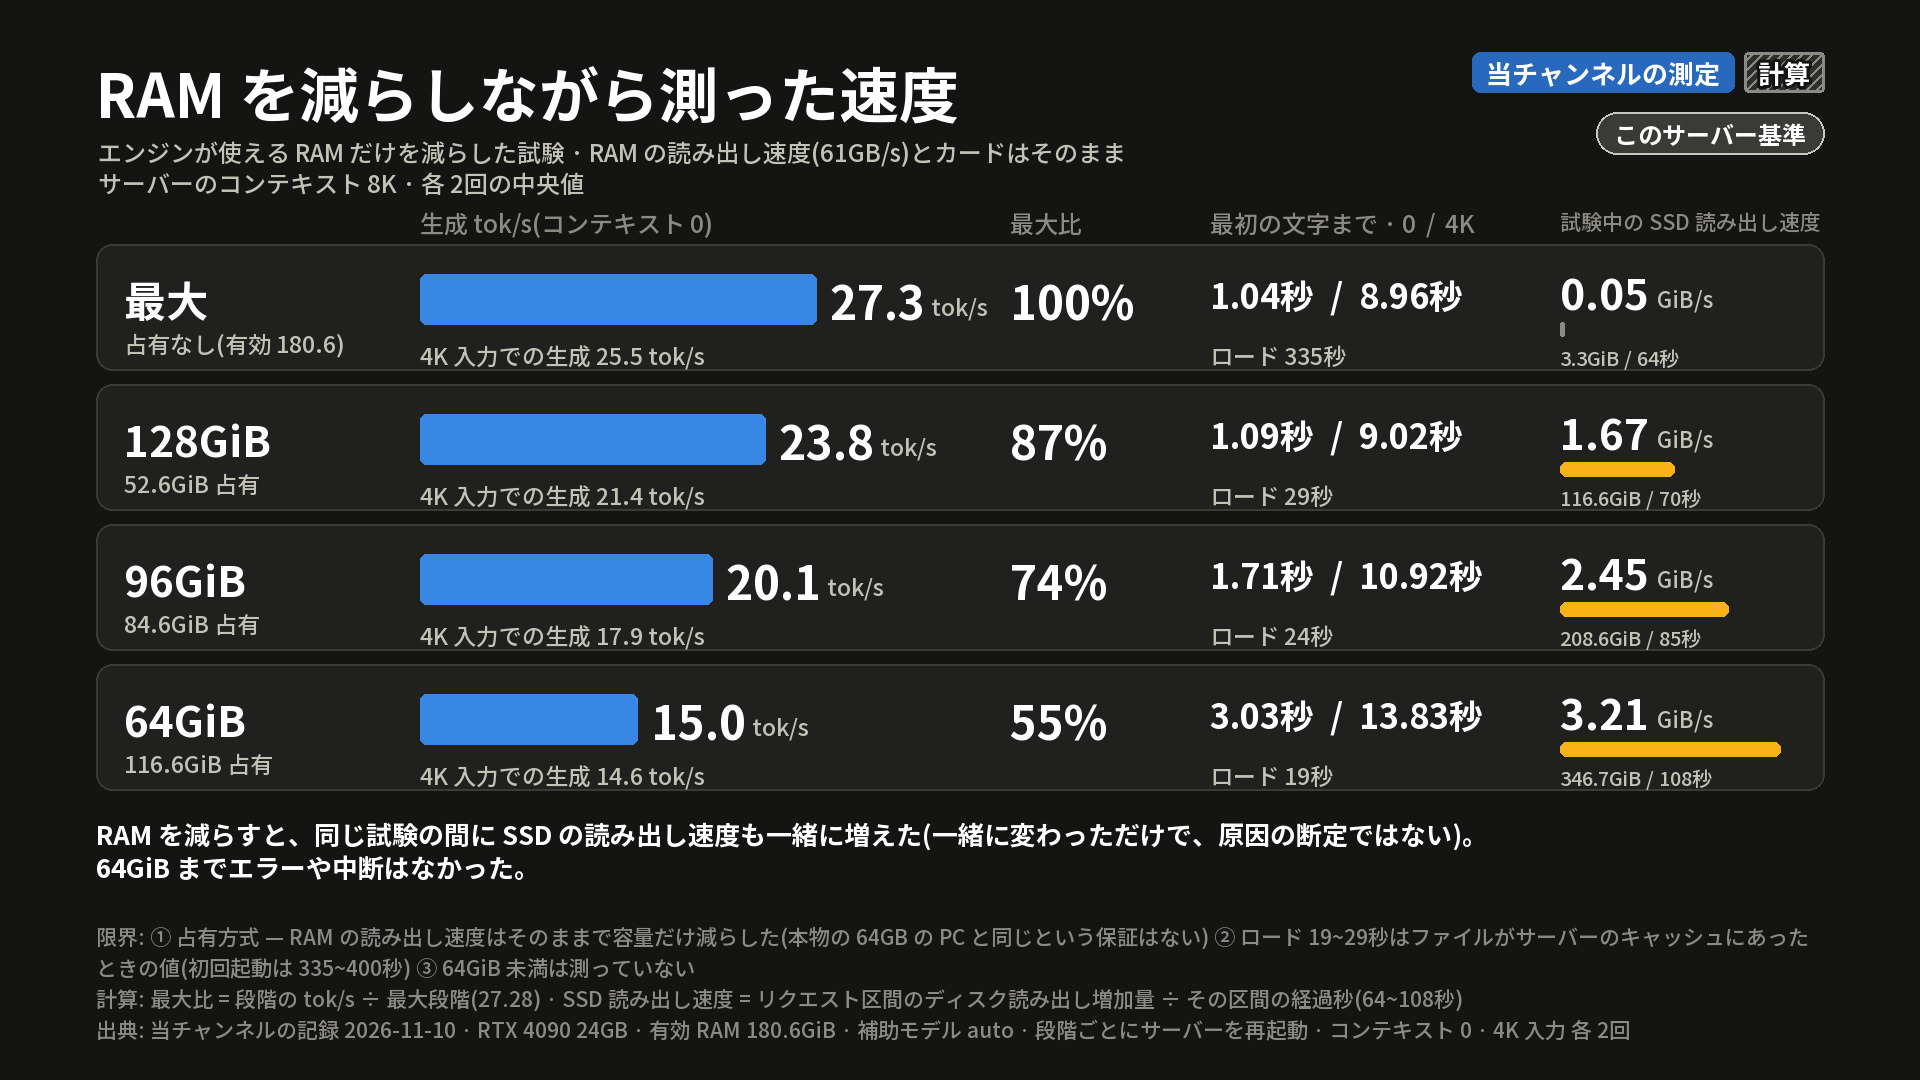
同じサーバーで、RAMを占有して、エンジンが使えるRAMだけを減らしました。RAMの読み出し速度とカードはそのままです。サーバーのコンテキストは8K、各段階2回の中央値、コンテキスト0(短い質問)基準です。
| エンジンが使えるRAM | 生成 tok/s | 最大時に対して | 最初の文字まで | 試験中のSSD読み出し |
|---|---|---|---|---|
| 180.6GiB(最大) | 27.3 | 100% | 1.04秒 | 0.05GiB/s |
| 128GiB | 23.8 | 87% | 1.09秒 | 1.67GiB/s |
| 96GiB | 20.1 | 74% | 1.71秒 | 2.45GiB/s |
| 64GiB | 15.0 | 55% | 3.03秒 | 3.21GiB/s |
64GiBでもエラーや停止はありませんでした。最大時に対する%は計算で、SSD読み出しは試験区間のあいだに増えた読み出し量を時間で割った計算値です。RAMが減るほどSSD読み出しも増えましたが、確認できたのは相関だけで、原因とは断定しません。最大段階の27.3は、サーバー設定(コンテキスト8K)が異なるため、速度の表の27.9とは別の値です。64GiBより小さいRAMは測っておらず、占有する方式なので、実際にRAMが64GBのコンピューターと同じになる保証もありません。
韓国語、コーディング、ツール呼び出し
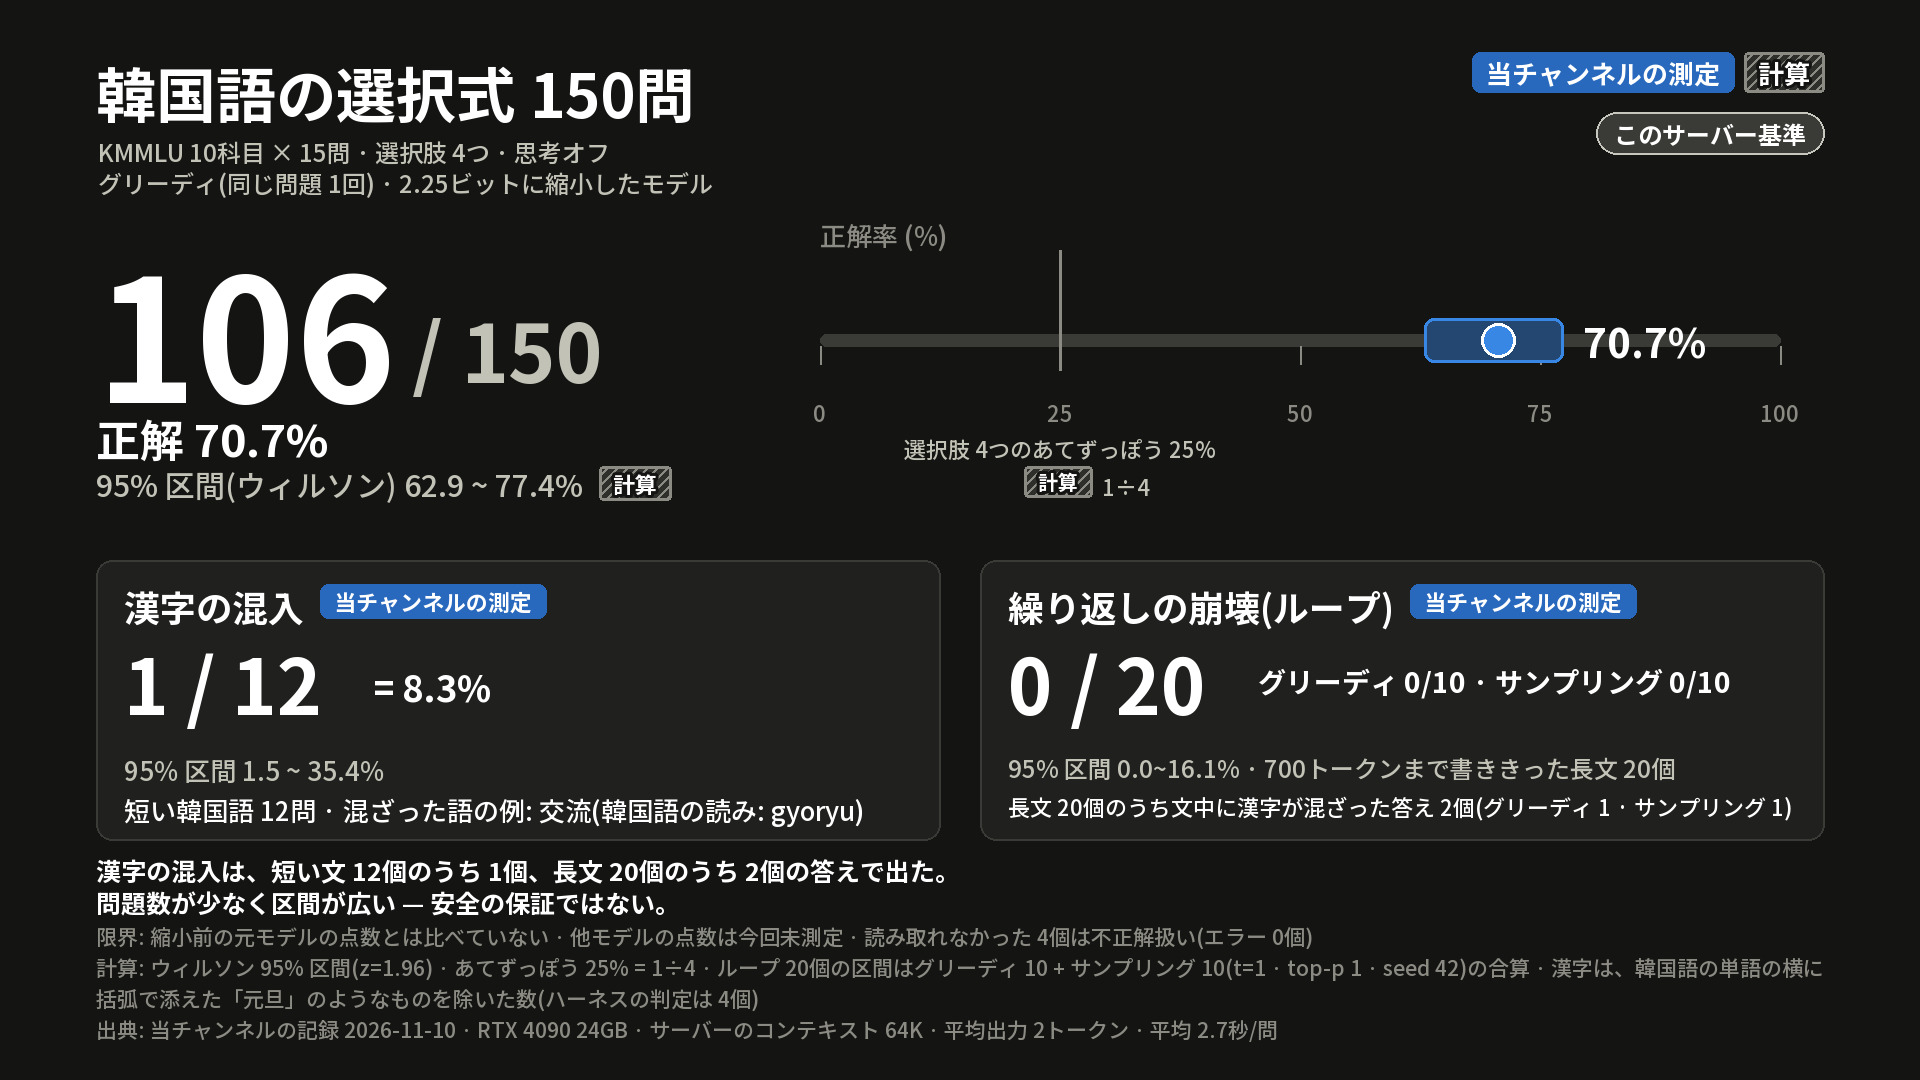
すべて思考をオフにして、グリーディ(同じ問題を1回)で測りました。KMMLU の選択式問題(10科目 × 15問、選択肢4つ)は150問中106問正解で70.7%、95%区間は62.9~77.4%です。当てずっぽうなら25%になります。答えを読み取れなかった4つは不正解として数えました。同じ問題を解いた他のモデルの点数がないため、良い悪いは言いません。
漢字の混入は、短い韓国語のリクエスト12個のうち1個でした('교류' が '交流' と出力されました)。700トークンまで書かせた長い文20個では、同じ言葉を繰り返して崩れた答えと判定されたものは0件でした。漢字・中国語が混ざった答えはグリーディ10個のうち1個、サンプリング10個のうち1個で、原文を読み、かっこ書きの併記を除いて数えた個数です。
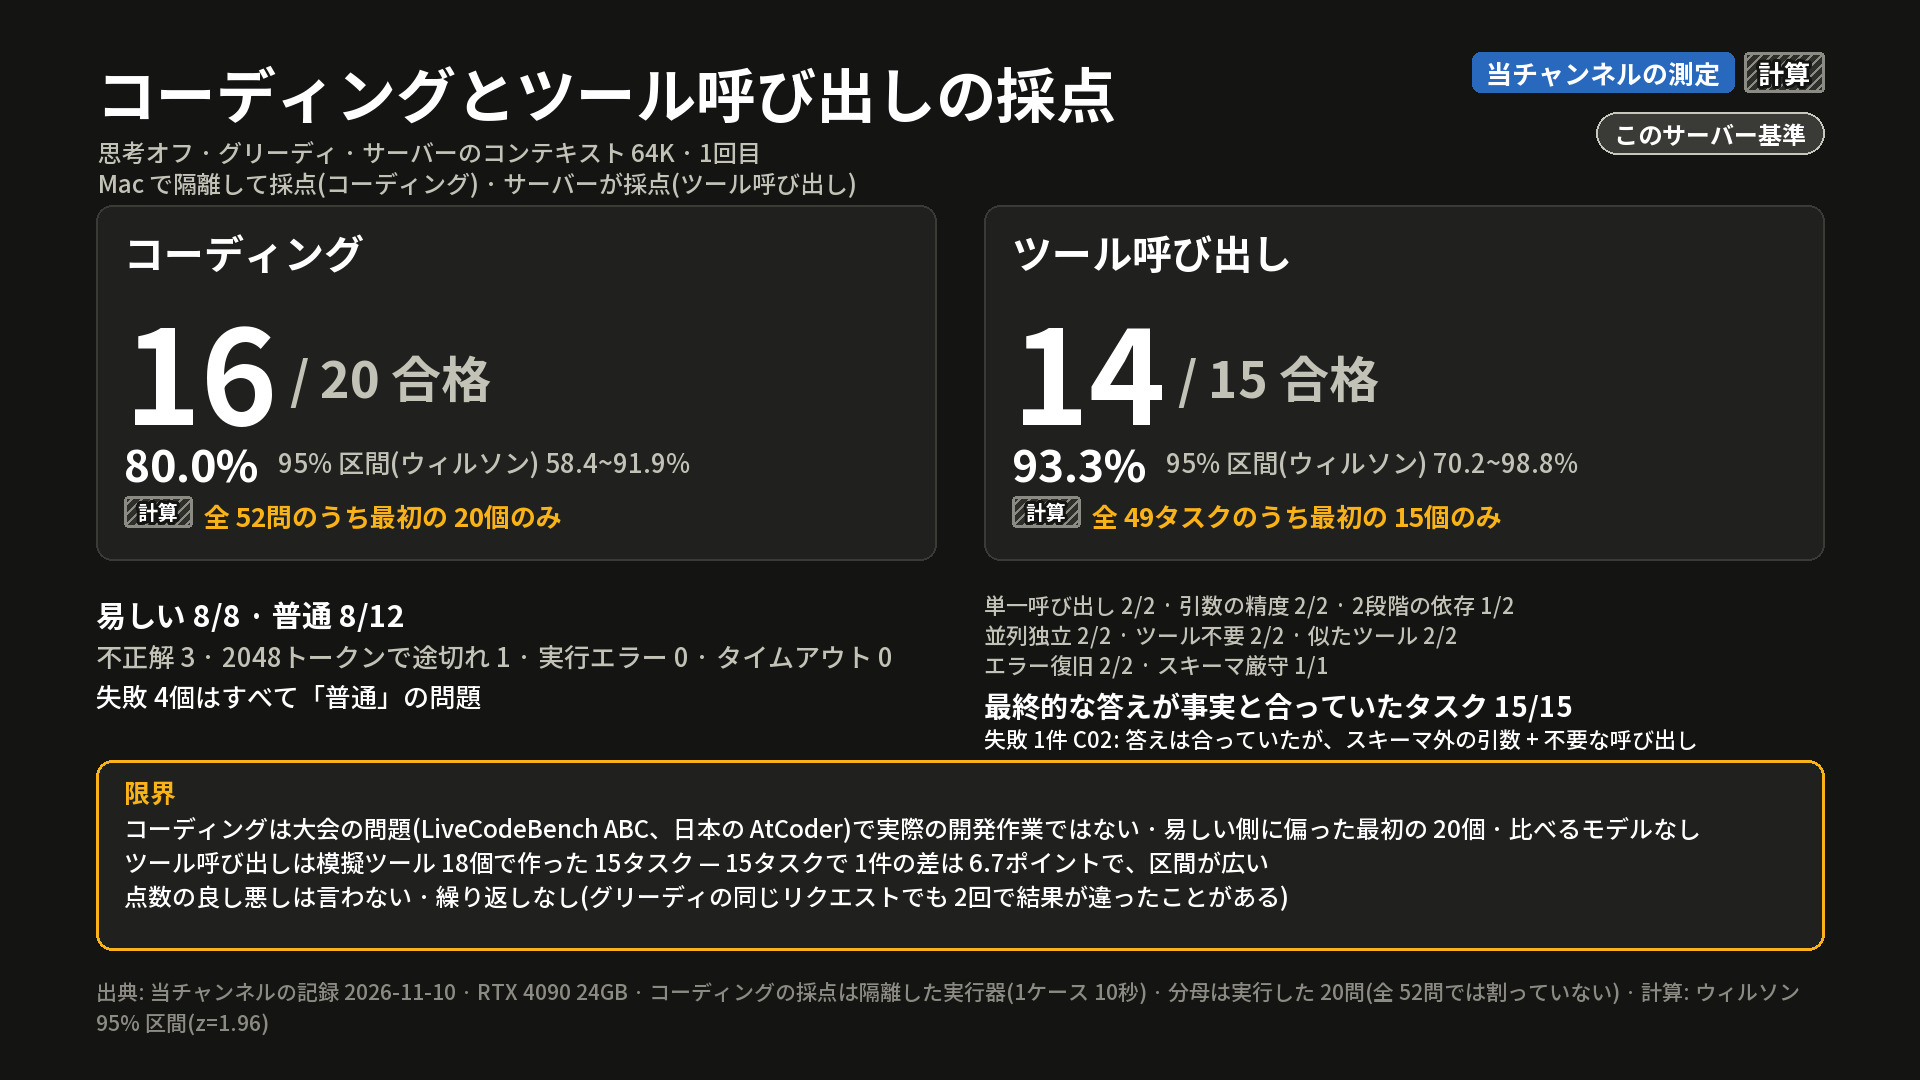
コーディングは全52問(コンテスト問題27個と自作の実戦型25個)のうち最初の20問だけを解かせ、その20問はすべてコンテスト問題(日本の AtCoder を基にした LiveCodeBench)です。16問が合格し(80.0%、95%区間 58.4~91.9%)、易しい問題は8/8、普通は8/12でした。自作の実戦型25問は1問も実行していません。ツール呼び出しは49課題のうち最初の15課題で14課題が合格しました(93.3%、70.2~98.8%)。失敗した1件は、許可されていない引数と不要なツール呼び出し1回が理由で、最終的な答えは合っていました。どちらも前のほうだけを選んだ1回ずつの結果なので、実際の開発作業の点数ではありません。
コストの計算
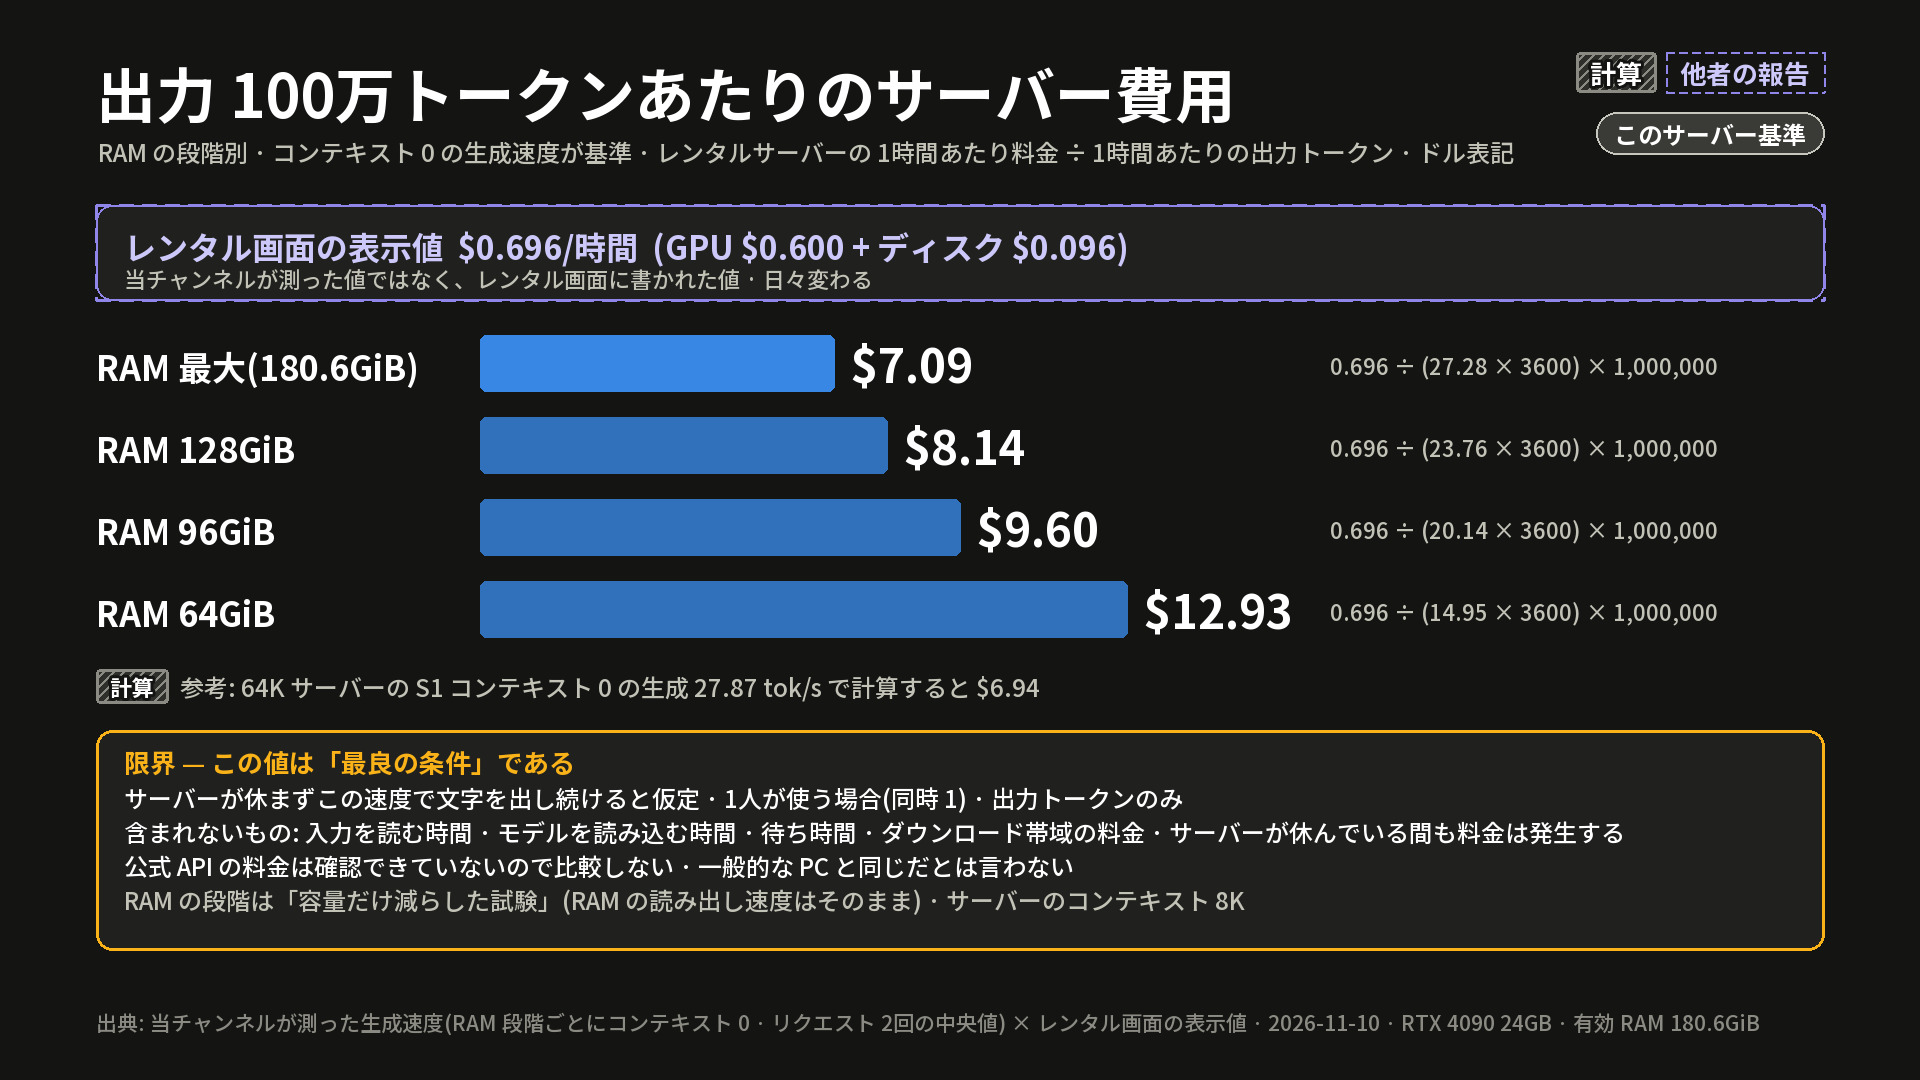
レンタル画面に表示されたサーバー料金は1時間あたり0.696ドル(グラフィックカード0.600 + ディスク0.096)です。サーバーが休まず1リクエストずつ文字だけを作ると仮定すると、出力100万トークンあたりのコストは 0.696 ÷ (生成速度 × 3,600) × 1,000,000 で、RAM最大で7.09ドル、128GiBで8.14ドル、96GiBで9.60ドル、64GiBで12.93ドルです(計算、料金はレンタル画面の表示値)。入力を読む時間、モデルを読み込む時間、遊んでいる時間、ダウンロードの帯域料金(約2.61ドル)は除いた、最も有利な条件です。公式 API の料金は確認できなかったので、比較していません。
限界と確認できていないこと
- サーバー1台、1回目です。同じ試験をほかのサーバーでやり直していません。
- RAM読み出し61.4GB/sは、エンジンを止めた状態で24スレッドで読んだ連続読み出しの最高値で、エンジンの実際のアクセスはもっと低いと思われますが、測っていません。RAMの種類・速度・モジュール構成は、コンテナで遮られていて確認できませんでした。
- カードの電力は最大450Wのうち350Wに制限されていました(動画と同じ表記で、450Wはサーバーのセッションで確認した値です)。上限を変えて測り直していないので、速度に影響したかどうかは分かりません。
- 比較モデル(同じ問題を別のモデルや元の精度で解いた点数)がありません。
- 見出しの速度は、速度試験(temperature 1.0、出力256トークン)の値です。韓国語・コーディング試験の最中にエンジンが報告した生成速度は、出力100トークン以上のリクエストで毎秒31~42トークンで、違いの理由は確認できていません。
- 同じリクエストをグリーディで2回送ったところ、答えが違ったことがあるので、点数を測り直しても同じになるとは言えません。
- カードメモリを減らす試験、壁の電力、同時リクエスト、ほかのエンジンとの比較はしていません。
- 作業をさせる試験(temperature 0.7、各1回)では、思考をオンにするとお詫びのメールが8.2秒から19.0秒に増え、スネークゲームは3,500トークンの上限で途切れました。成果物が動くかどうかは採点していません。
基準日
測定は2026-11-10に行い、この記事は動画公開日(2026-11-10)を基準にしています。Strata 0.2.13.1(エンジン 0.1.59.1)で、モデルは平均2.25ビット版です。レンタル料金とドキュメントの内容は変わることがあります。