Strata RTX 3090で125Bの量子化5種を実測、RAM 32GB級でIQ3_Sのプリフィル2045→207
投稿日 動画公開
RTX 3090 1枚でStrataを使い、Qwen 3.8 Flash-Next 125Bの量子化5種を実測しました。韓国語の正答率は重なり、RAM 32GB級でIQ3_Sのプリフィルは2045→207トークン/秒に落ちました。
RTX 3090(24GB)1枚でStrata(ストラタ)エンジンを使ってQwen 3.8 Flash-Next(125B MoE)を動かすとき、量子化5種は何が違うのでしょうか。レンタルしたクラウドの3090サーバーで実際に測ったところ、韓国語の正答率は大きく重なり、先に差がついたのはRAMと速度でした。使えるRAMを32GB級に減らして再現すると、IQ3_Sの4,000トークンのプリフィルは毎秒2045.1トークンから206.7トークンに落ちました。この記事はYouTube動画の内容を記事として整理し直したものです。
結論から
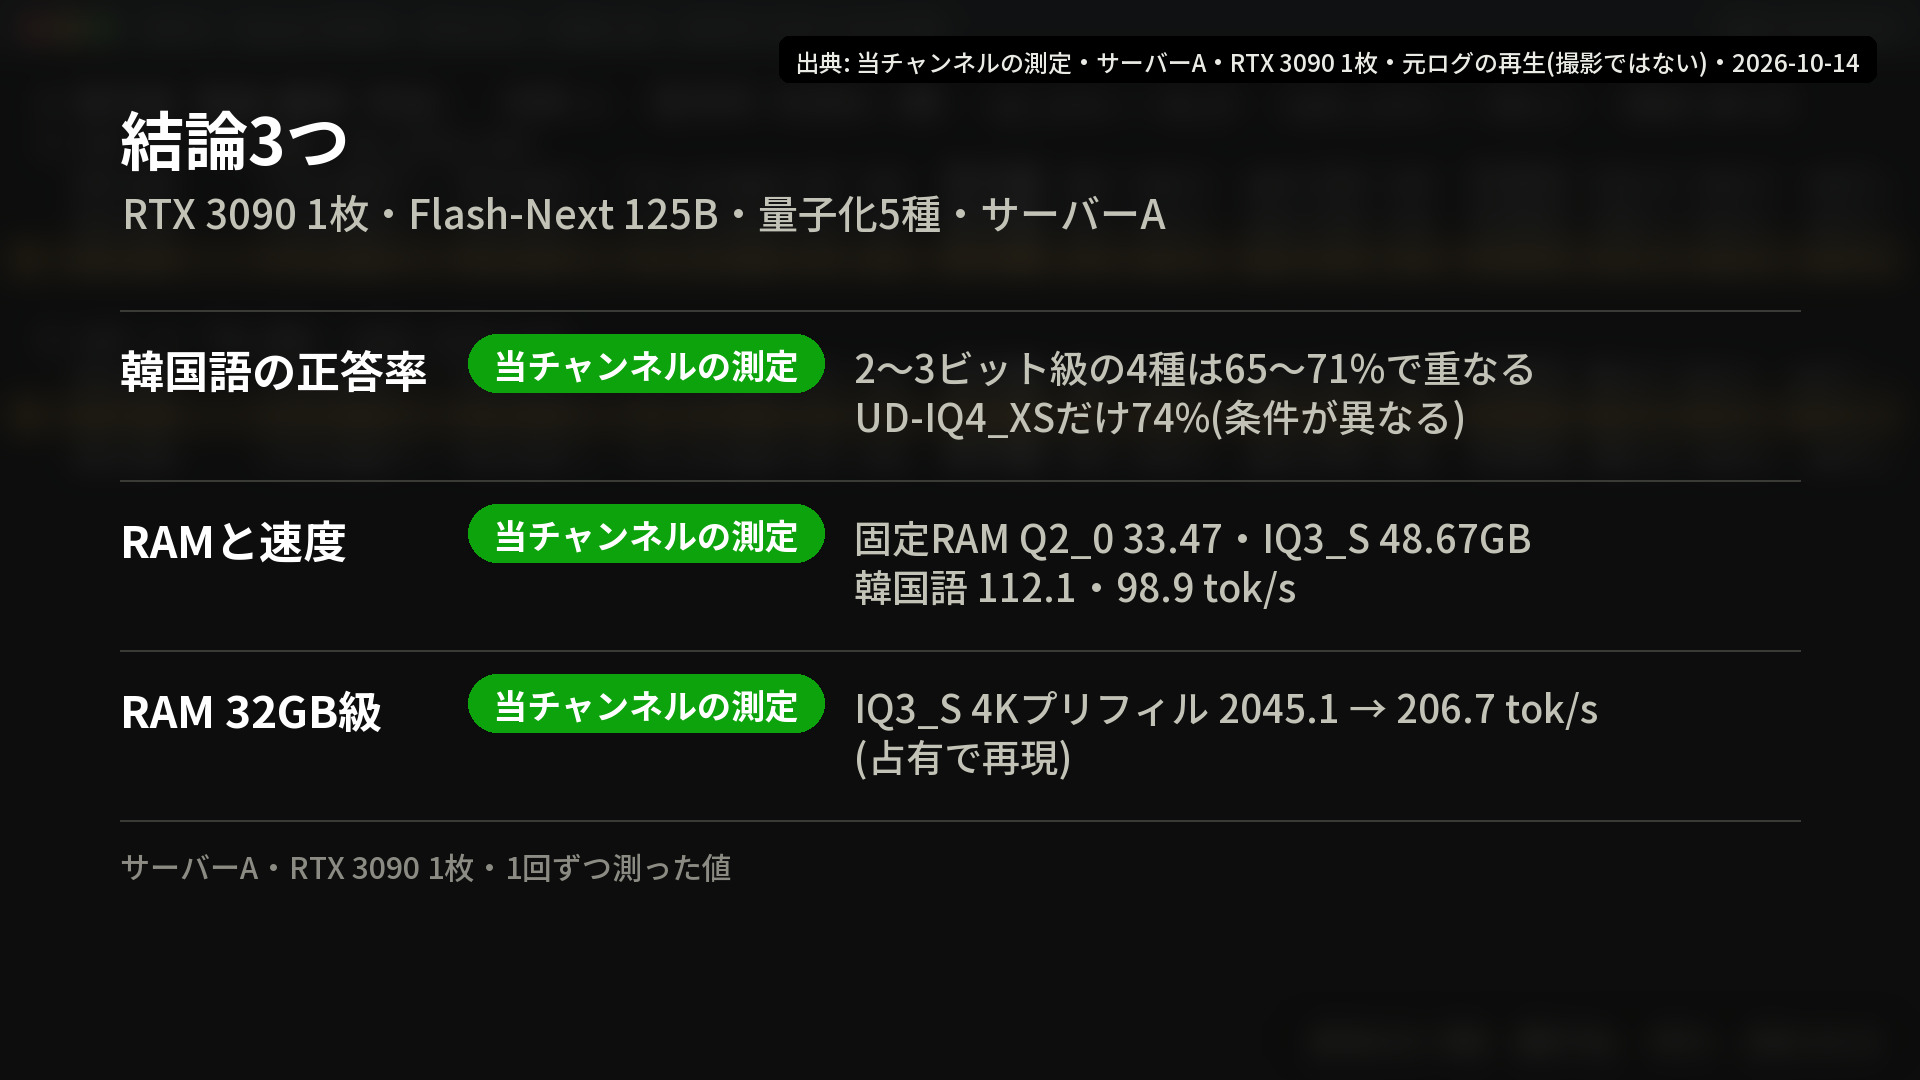
- 韓国語の正答率(KMMLU 450問):2〜3ビット級の4種(Q2_0、IQ2_XS、IQ3_XXS、IQ3_S)は65〜71%で大きく重なりました。条件の違うUD-IQ4_XSだけが74%でした。
- 先に分かれたのはRAMと速度です。最小のQ2_0は固定RAM 33.47GiBで韓国語のデコードが毎秒112.1トークン、IQ3_Sは48.67GiBで98.9トークンでした。
- 使えるRAMを32GB級に減らすと、IQ3_Sの4,000トークンのプリフィルは2045.1→206.7 tok/sに落ち、Q2_0は2276.8→1664.4と落ち幅が小さくなりました。
- この条件では、正答率よりも自分のRAMを先に見て選ぶほうがよい、というのが動画の読み方です。すべて1回ずつ測った値です。
この記事の数字の種類
数字はほぼすべて当チャンネルの測定です(サーバーA、1回、グリーディ、思考オフ形式)。カード2枚の倍率は、同じサーバー内で1枚の値と2枚の値を割った計算です。RAM区間の値は、実際にそのRAMを持つ機械ではなく、同じサーバーで占有プロセスを使って使えるRAMを減らして再現した値です。レビューでの実測、公式スペック、価格は使っていません。
なぜ測ったか
動画は、直近1か月半に投稿されたStrata関連の動画77本のうちコメントのある63本、約4,600件のコメントを読むところから始まります(質問の分類は手作業のおおよその数です)。最も多い質問は「自分のグラフィックカードとRAMで動くか」で、調べた範囲では韓国語の正答率を数値で測った動画はなかったそうです。
測定条件
サーバーAはレンタルのクラウドサーバーで、Ryzen 9 5950X、RTX 3090 24GB 1枚、PCIe 4.0、電力上限420Wです。エンジンはStrata 0.1.44.1(5種すべて同じコミット)、コンテキスト32768、KV int8、MTP使用、思考オフ形式でグリーディ(温度0)、速度は3回の中央値です。GGUFファイルサイズはQ2_0が66.4、IQ2_XSが68.0、IQ3_XXSが75.8、IQ3_Sが83.6、UD-IQ4_XSが93.7GBです。UD-IQ4_XSだけがROUTE_TAIL_SKIP=0、STRATA_HC_Q8=1で動いており、ほかの4種とは条件が異なります。カード2枚のテストは、XeonのCPU、PCIe 3.0、NVLinkなし、1枚あたり220W制限の別のサーバーで行ったため、サーバーAとの絶対速度は比べていません。
韓国語の正答率は重なった
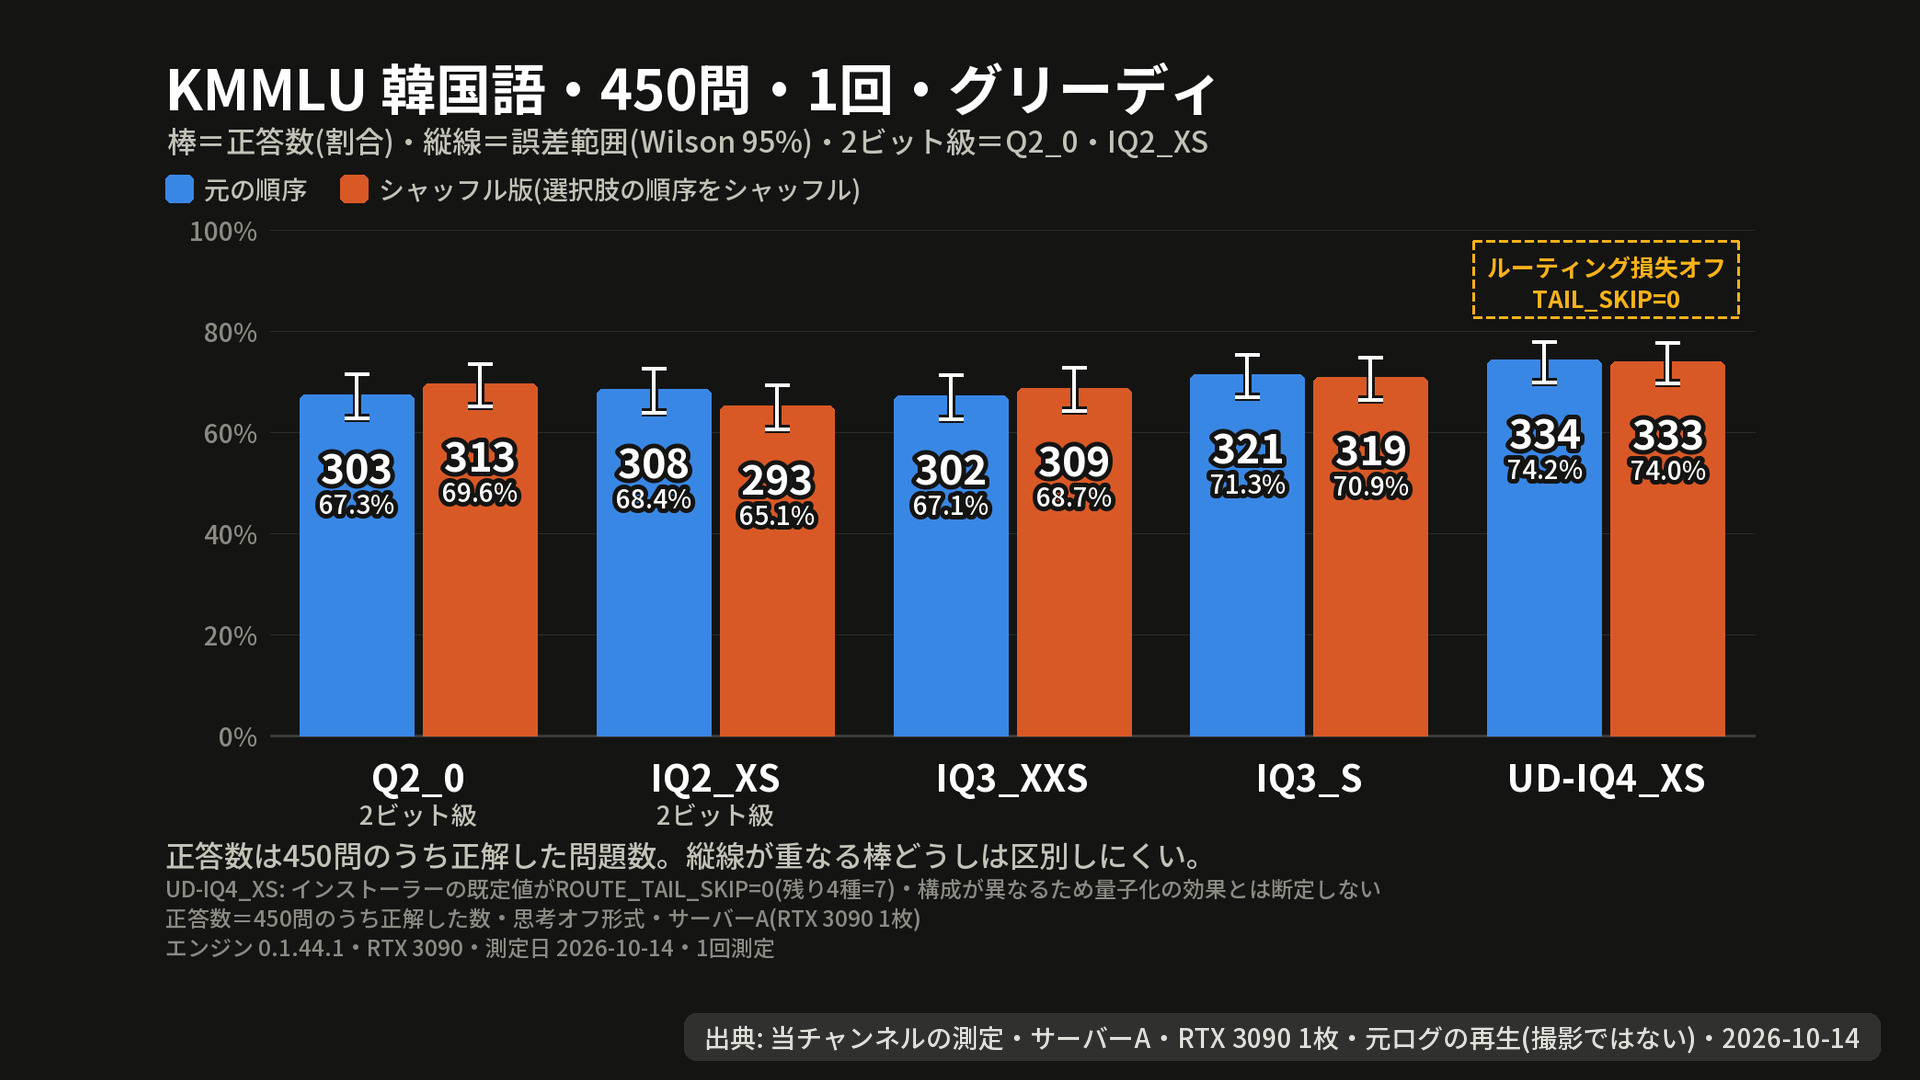
KMMLU 450問を、元の選択肢の順序と選択肢をシャッフルした順序で解かせました。正解が2番目の選択肢である問題は113問あり、IQ2_XSはシャッフル版で2番目の選択肢を179回選びました。こうした選択肢の偏りが値を動かしたようなので、片方の順序だけを引用しないことにしました。95%信頼区間は上下4パーセントポイントほどで、多くが重なります。20通りのペア比較のうち厳しい基準を超えたのは5ペアで、そのうち4ペアは条件の違うUD-IQ4_XSを含むため、量子化の効果とは断定できません。
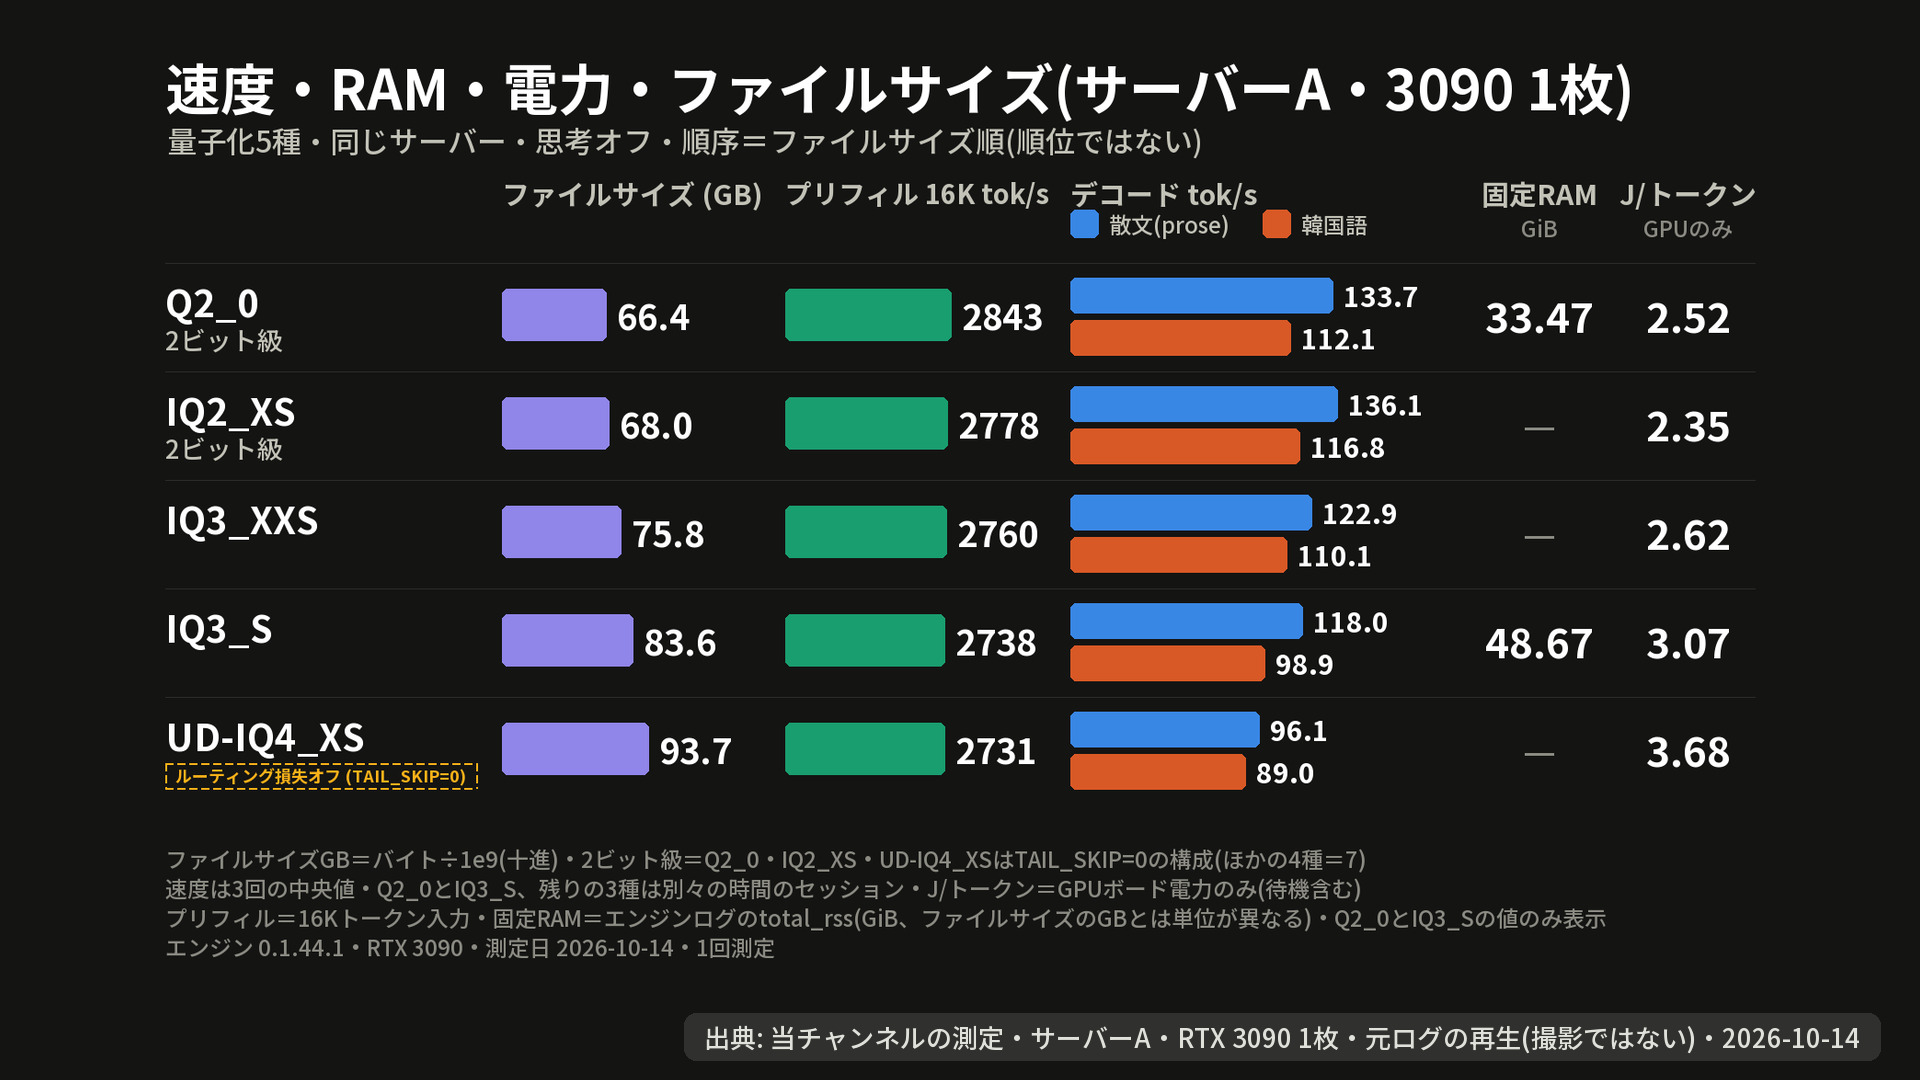
5種を一覧で(サーバーA、当チャンネルの測定)
| 量子化 | ファイルGB | KMMLU 元/シャッフル % | デコード 散文/韓国語 tok/s | GPU J/トークン | コーディング52 | ツールコール49(v2) |
|---|---|---|---|---|---|---|
| Q2_0 | 66.4 | 67.3 / 69.6 | 133.7 / 112.1 | 2.52 | 34 | 48 |
| IQ2_XS | 68.0 | 68.4 / 65.1 | 136.1 / 116.8 | 2.35 | 37 | 46 |
| IQ3_XXS | 75.8 | 67.1 / 68.7 | 122.9 / 110.1 | 2.62 | 40 | 48 |
| IQ3_S | 83.6 | 71.3 / 70.9 | 118.0 / 98.9 | 3.07 | 38 | 48 |
| UD-IQ4_XS | 93.7 | 74.2 / 74.0 | 96.1 / 89.0 | 3.68 | 39 | 47 |
長い入力を読むプリフィル(1万6,000トークン)は、毎秒2843から2731トークンまで5種でほぼ同じでした。差がついたのは文章を書くデコードで、ファイルが大きいほど概ね遅くなり、トークンあたりのエネルギー(GPU電力のみ、待機電力を含む)も増えました。速度は同じサーバーで時間を変えて2回に分けて測った値です。固定RAMはQ2_0とIQ3_Sだけ記録があります。
コーディング・ツールコール・漢字・繰り返し
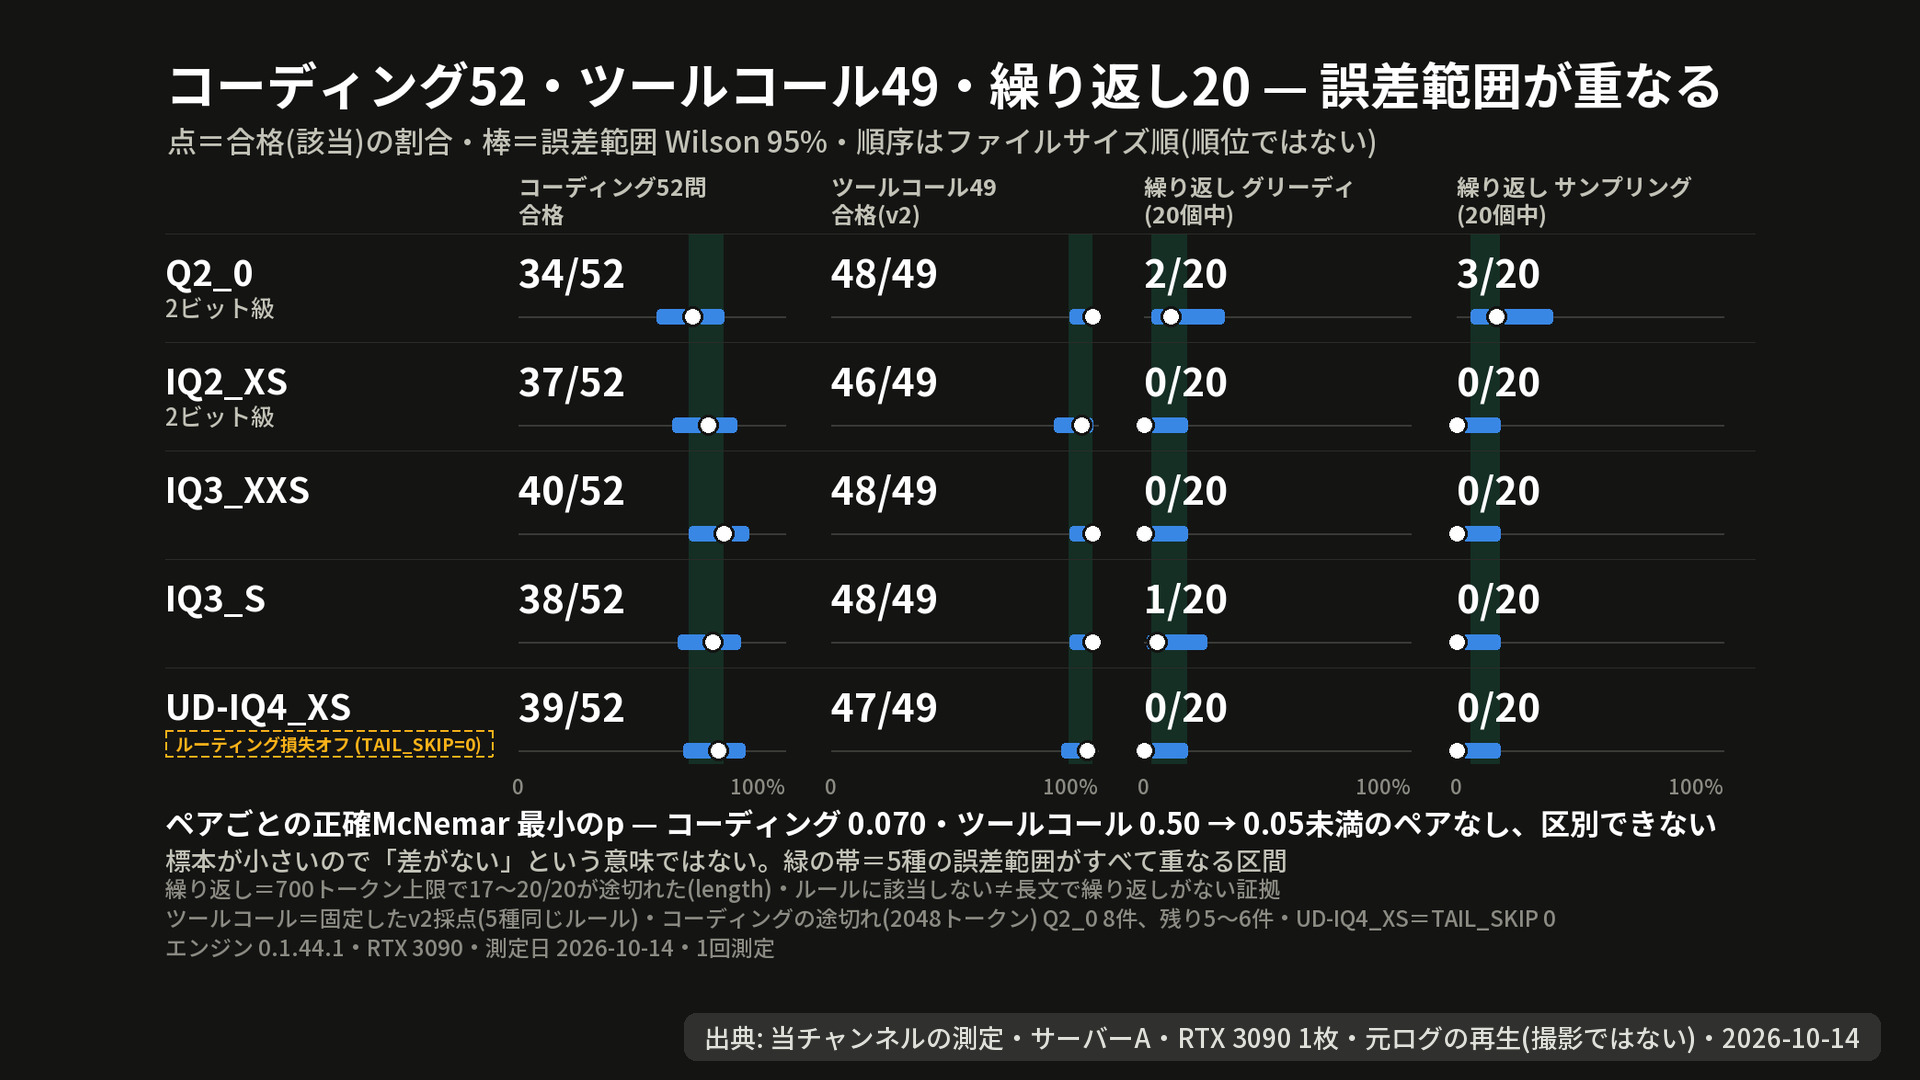
コーディング52問の合格は34〜40問で、10組をペアで比べても5%基準を超える差はありませんでした。2048トークンで途切れた回答はQ2_0が8件、IQ2_XSが5件、残りは各6件で、合格率に短く終える癖が混じっている可能性があります。ツールコール49問は、固定した採点器v2で46〜48問が合格し、採点上の例外がQ2_0にだけ作用したため、順位は述べません。漢字の混入は、短い韓国語プロンプト12個ではQ2_0の5個の回答に混じり、ほかは0個、700トークンの長文20個ではQ2_0が16個、IQ2_XSが2個、残りは0個でした。繰り返しの判定は、グリーディでQ2_0が2個、IQ3_Sが1個、サンプリングでQ2_0が3個該当しましたが、ほとんどの回答が700トークンで途切れているため、長い文章で繰り返しが起きないという意味に読んではいけません。
RAMが足りなくなると
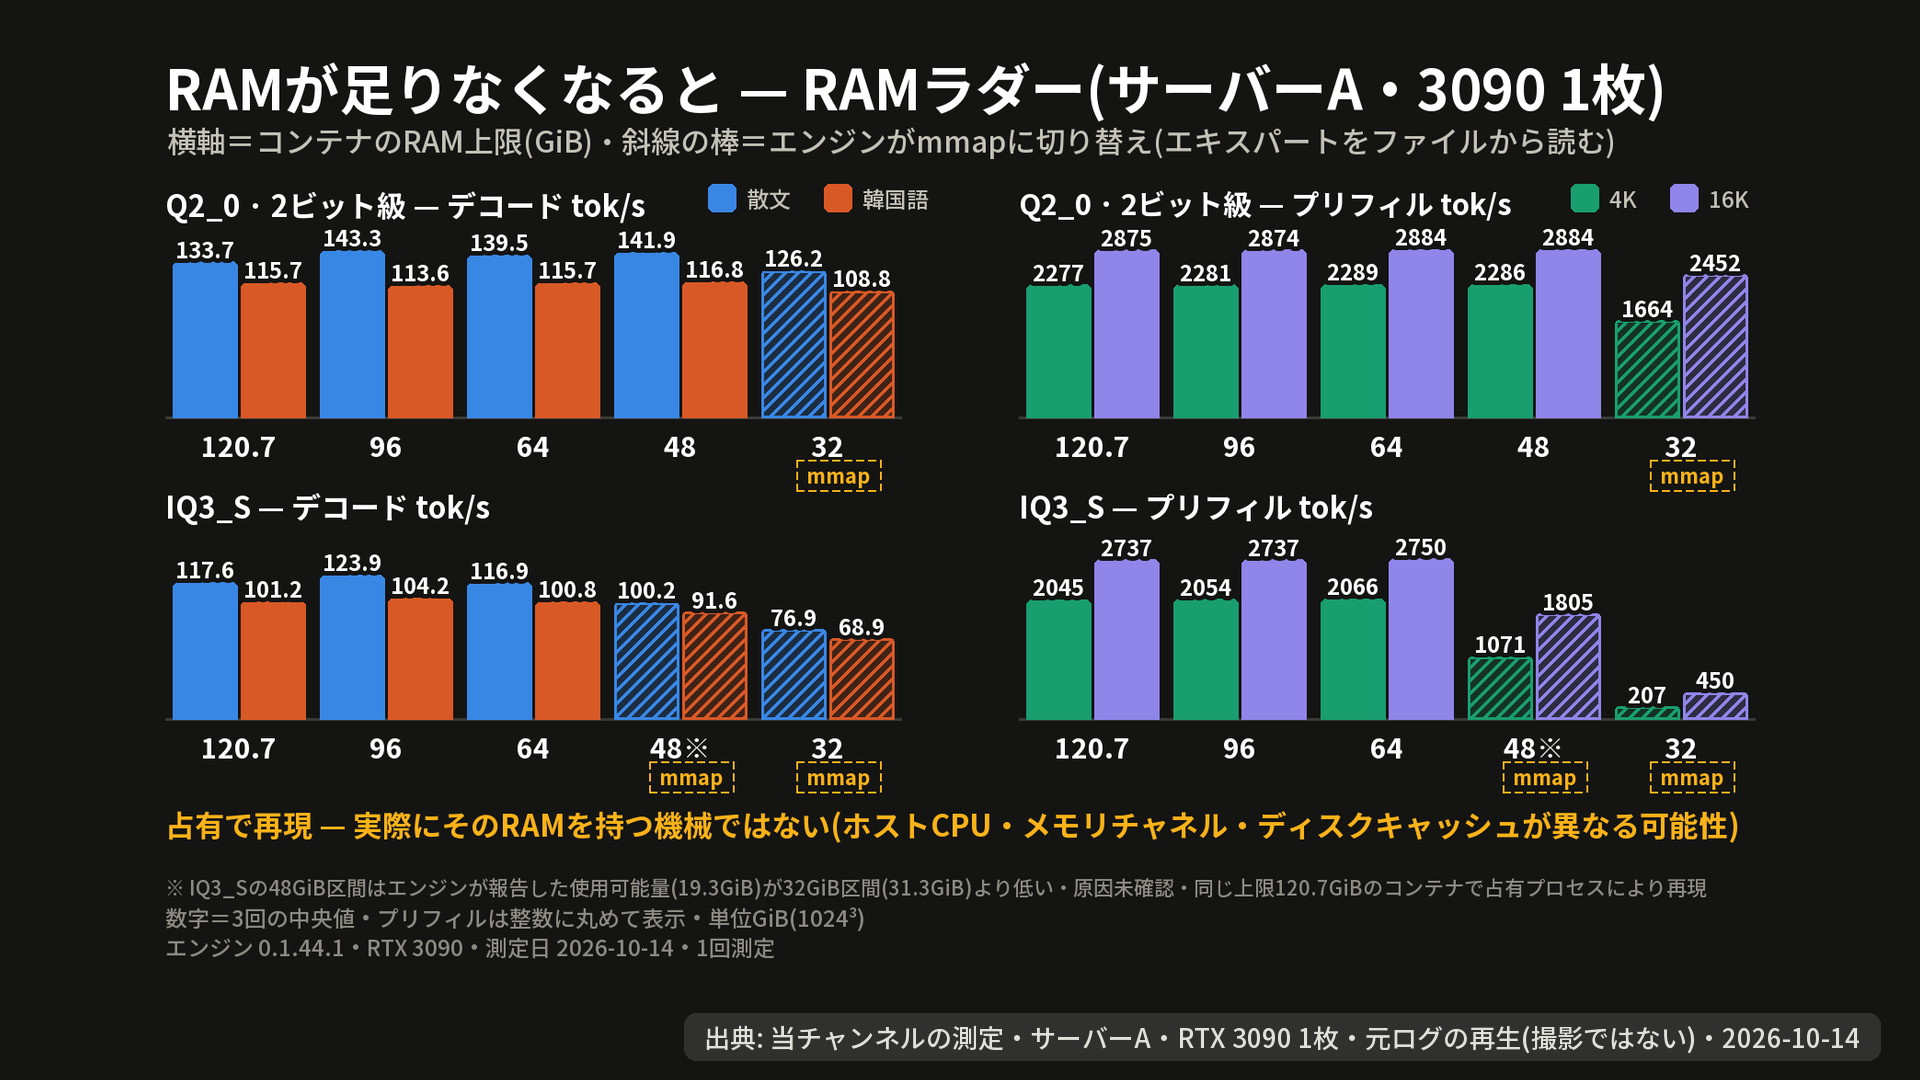
同じサーバーAで占有プロセスを使って使えるRAMを減らし、Q2_0とIQ3_Sの2種だけを再現しました。RAMが足りなくなると、エンジンはエキスパートをすべてRAMに載せる通常モードから、エキスパートをファイルから読むモード(mmap)に落ちます。
| 使えるRAM | Q2_0 デコード平均 / 4Kプリフィル | IQ3_S デコード平均 / 4Kプリフィル |
|---|---|---|
| 自然(約120GiB) | 124.7 / 2276.8 | 109.4 / 2045.1 |
| 96GiB | 128.4 / 2281.4 | 114.1 / 2054.2 |
| 64GiB | 127.6 / 2289 | 108.8 / 2066 |
| 48GiB | 129.3 / 2285.5 | ファイル読み込みモード、数値は省略(原因未確認) |
| 32GiB級 | 117.5 / 1664.4(ファイル読み込みモード) | 72.9 / 206.7(ファイル読み込みモード) |
デコードは散文と韓国語の平均です。Q2_0は48GiBまで通常モードで、32GiB級で落ち、IQ3_Sは64GiBまで通常で、48GiBから落ちました。IQ3_Sの48GiB区間は、エンジンが報告した使用可能量の原因を確認できなかったため、数値を使っていません。
カードをもう1枚
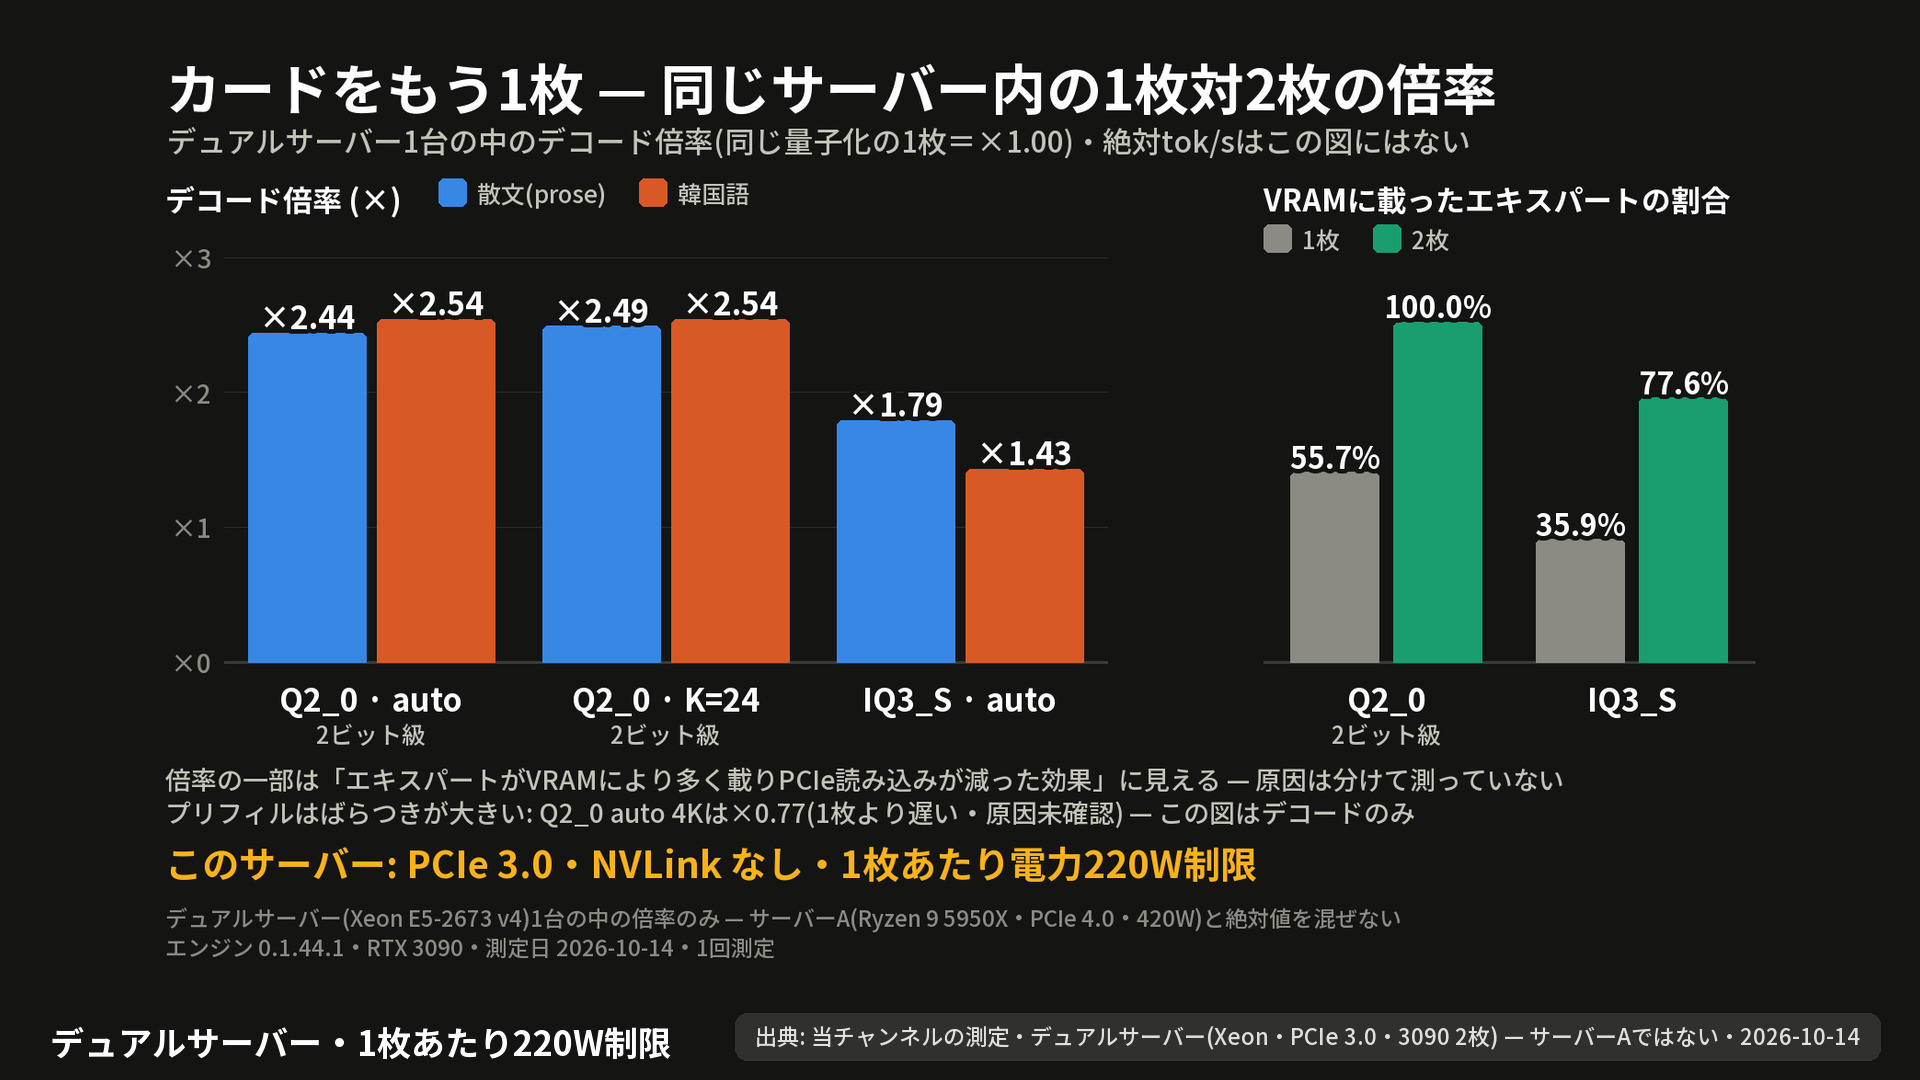
3090が2枚ある別のサーバーで、同じサーバー内の1枚対2枚だけを比べた倍率です。このサーバーはPCIe 3.0でNVLinkがなく、1枚あたりの電力が220Wに制限されています。
散文のデコードはQ2_0が2.44倍(分割を手動で指定すると2.49倍)、IQ3_Sが1.79倍でした。この倍率には、カードの演算と、エキスパートがすべてグラフィックカードのメモリに入った効果が混ざっており、原因は分けて測っていません。グラフィックカードのメモリに載ったエキスパートの割合は、Q2_0が55.7%から100%、IQ3_Sが35.9%から77.6%でした。Q2_0の4Kプリフィルは2枚でむしろ0.77倍で、原因は確認できませんでした。
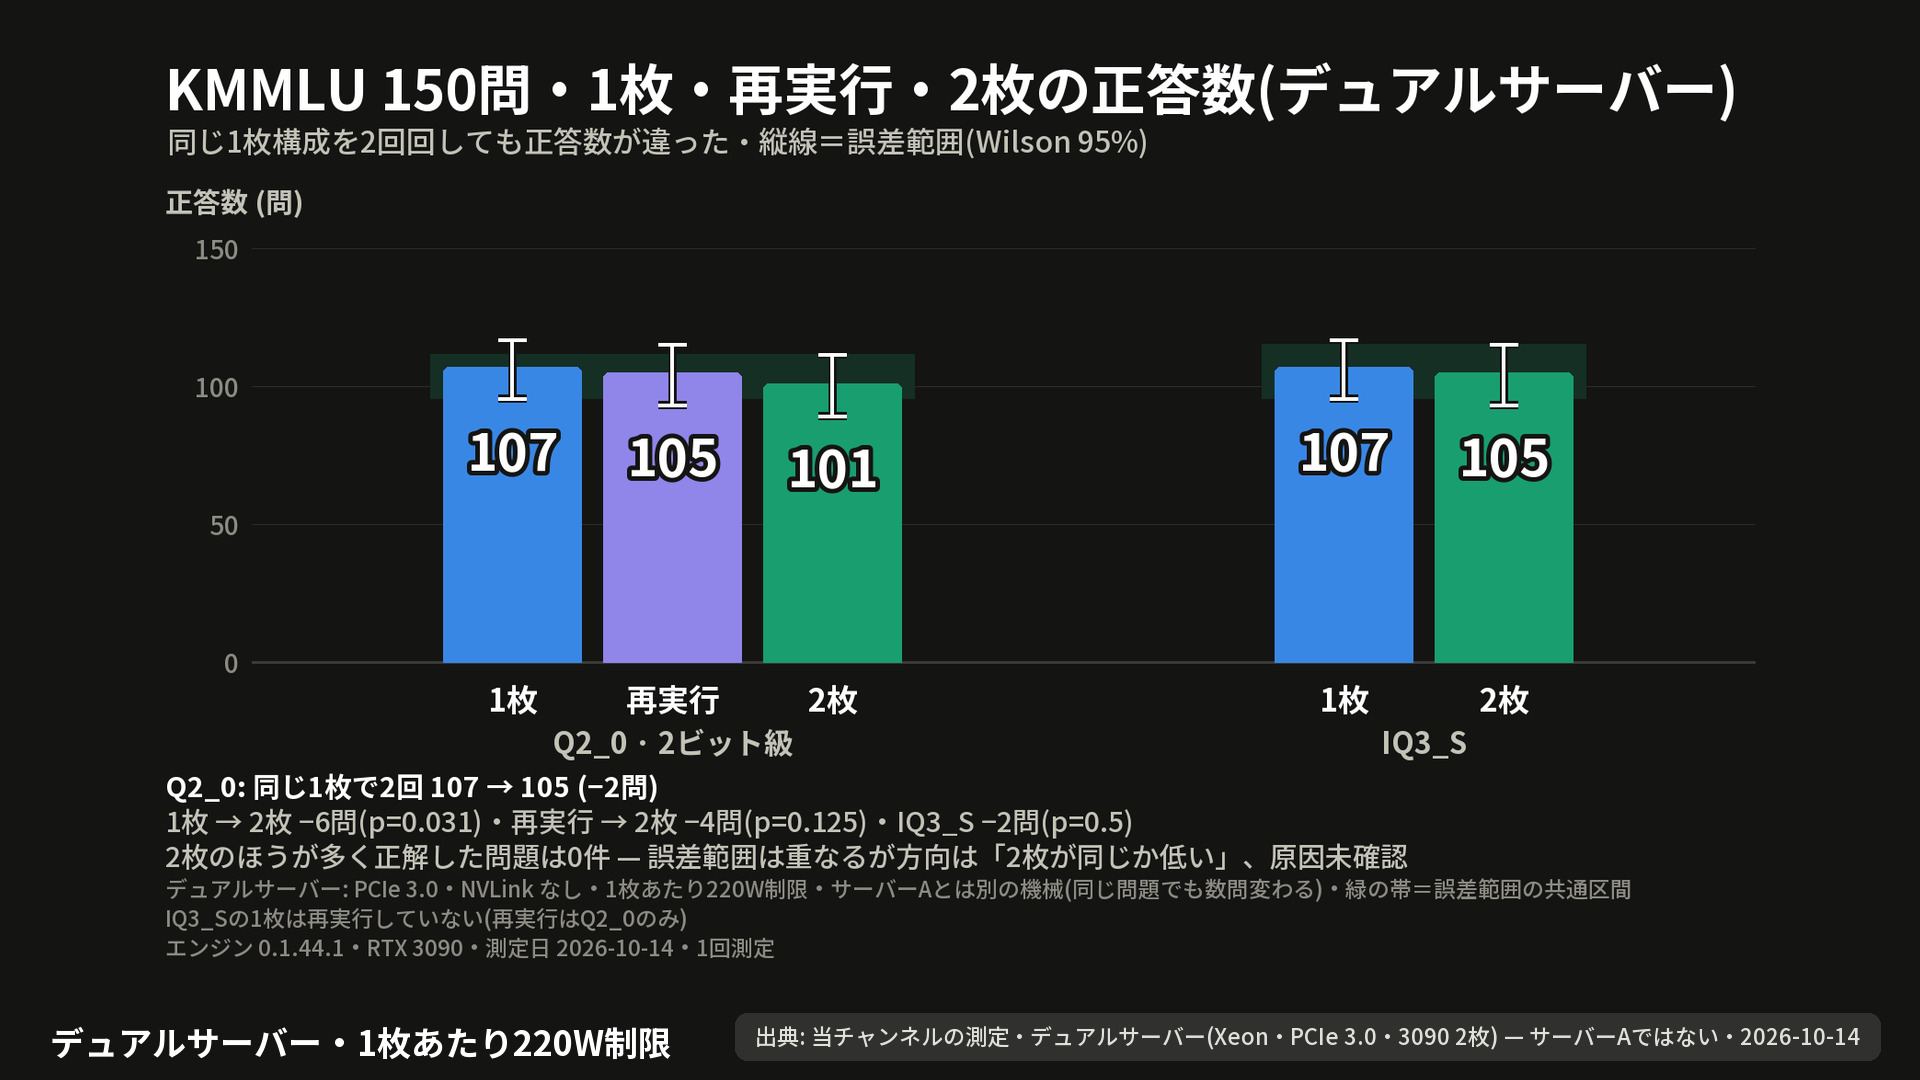
KMMLU 150問のサブセットでは、Q2_0が1枚で107問、同じ1枚をもう一度回して105問、2枚で101問、IQ3_Sが1枚で107問、2枚で105問でした。2枚のほうが2〜6問低く出ました。同じ1枚でも2〜3問ぶれるのでそのぶれの範囲内の可能性はありますが、Q2_0の最初の比較(107対101)は6対0でp=0.03でした。原因はカードの分け方かもしれないという程度で、確認できていません。そのため、2枚でも正答率が変わらないとは断定しません。2枚のほうが多く正解した問題は、どちらの量子化も0件でした。
限界・基準日
- すべてのテストは1回測定で、グリーディ、思考オフ形式です。2ビット級の2種、漢字12個、繰り返し20個、コーディング52問、ツールコール49問はサンプルが小さく、一般化できません。
- サーバーAの値とデュアルサーバーの値は混ぜていません。RAM区間の値は占有による再現なので、実際にそのRAMを持つ機械とは異なる可能性があります(ホストCPU、メモリチャネル、ディスクキャッシュ)。
- UD-IQ4_XSは条件が異なるため、量子化の効果とは断定できません。
- 基準日:測定と動画公開は2026-10-14〜15(動画公開日は2026-10-15)。エンジンはStrata 0.1.44.1です。
まとめ
- 正答率は誤差範囲の中で重なり、RAMが足りなくなるとIQ3_Sは大きく、Q2_0は緩やかに落ちました。
- カードをもう1枚足す効果は、このサーバーで1.79〜2.49倍でしたが、メモリの効果が混ざっているため、ほかの構成にそのまま当てはめることはできません。