Strata Mac mini 32GB実測 思考オン10.3~22.1トークン、27Bと比較
投稿日 動画公開
Mac mini M6 32GBでQwen3.8 Flash-Next Q2_0(66.4GB)をStrataで測定。10.3~22.1トークン(思考オン)。150問とコーディング52問は27B 4ビットと差を確認できず。開発者の値は別掲。
Mac mini M6 32GBでは、66.4GBのQwen3.8 Flash-Next(2ビット Q2_0)のファイルがStrataエンジンで動き、速度は質問によって毎秒10.3~22.1トークン(思考オンの形式の場合。思考オフの形式は17.2~24.0トークン)でした。同じMacのQwen3.8 27B 4ビットと比べると、150問の正答率もコーディング52問も差を確認できず、分かれたのはファイルサイズ・メモリの余裕・韓国語の回答に混ざる漢字でした。
Strataは、1,250億パラメータのエキスパート混合(MoE)モデルを12GBのグラフィックカードで動かすエンジンで、元の開発者はMacを対象外と明記しています。今回使ったstrata-mlxは、同じモデルファイルを読み込んでMacで動かす、非公式の独立プロジェクトです。この記事は10分18秒の動画(公開2026-10-13)の測定を文章として整理し直したもので、すべての値は2026-10-13にMac mini 1台でChromeを閉じて測りました。動画は韓国語で進行します。
測定条件:同じファイル、2つの質問形式
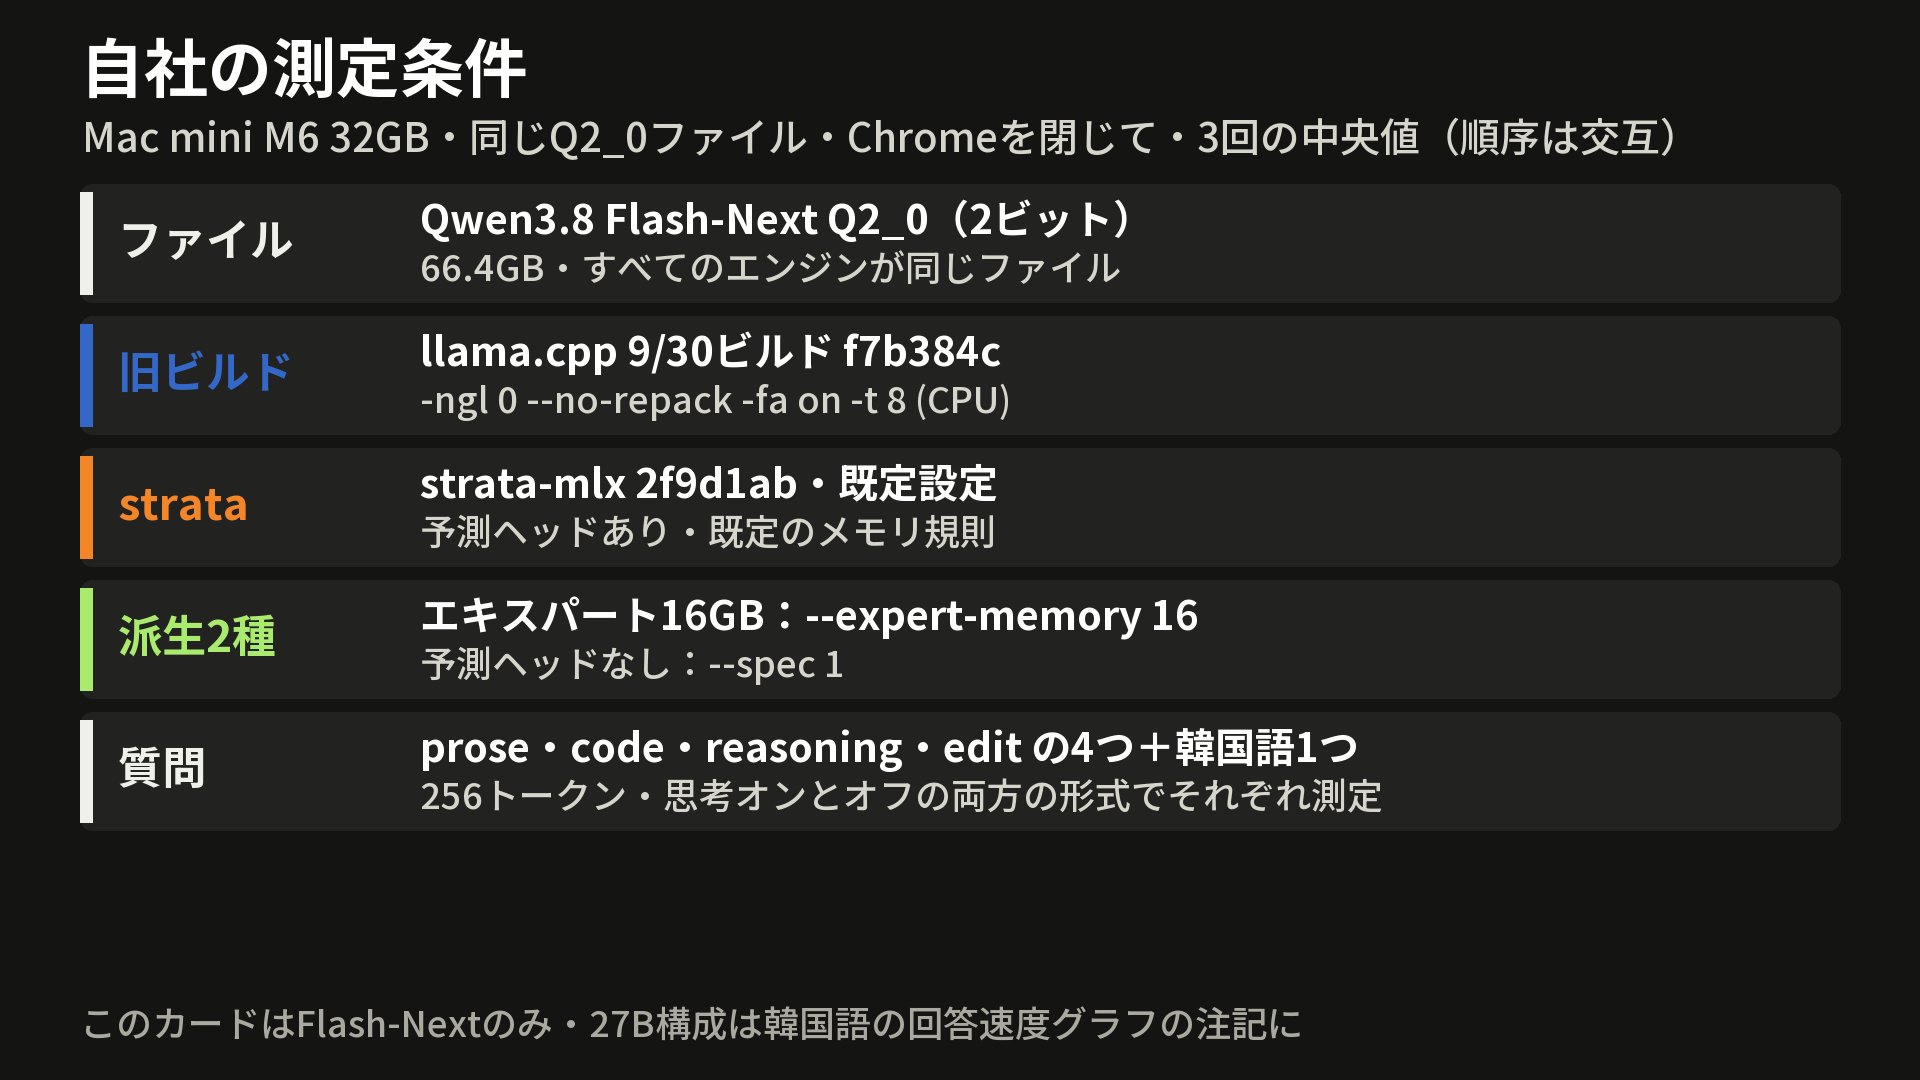
同じファイル・同じ質問・256トークンの生成を、質問5種(文章作成・コード・推論・修正・韓国語)で3回測り、中央値を使いました。質問形式は2つに分けました。思考オンの形式は開発者のドキュメントと同じ方式で、モデルが先に英語で考えることが多くなります。思考オフの形式は、空の思考ブロックを付けて、韓国語で直接答えさせたものです。比較は同じ形式どうしでのみ行います。
他人の値は自分たちの表に混ぜない
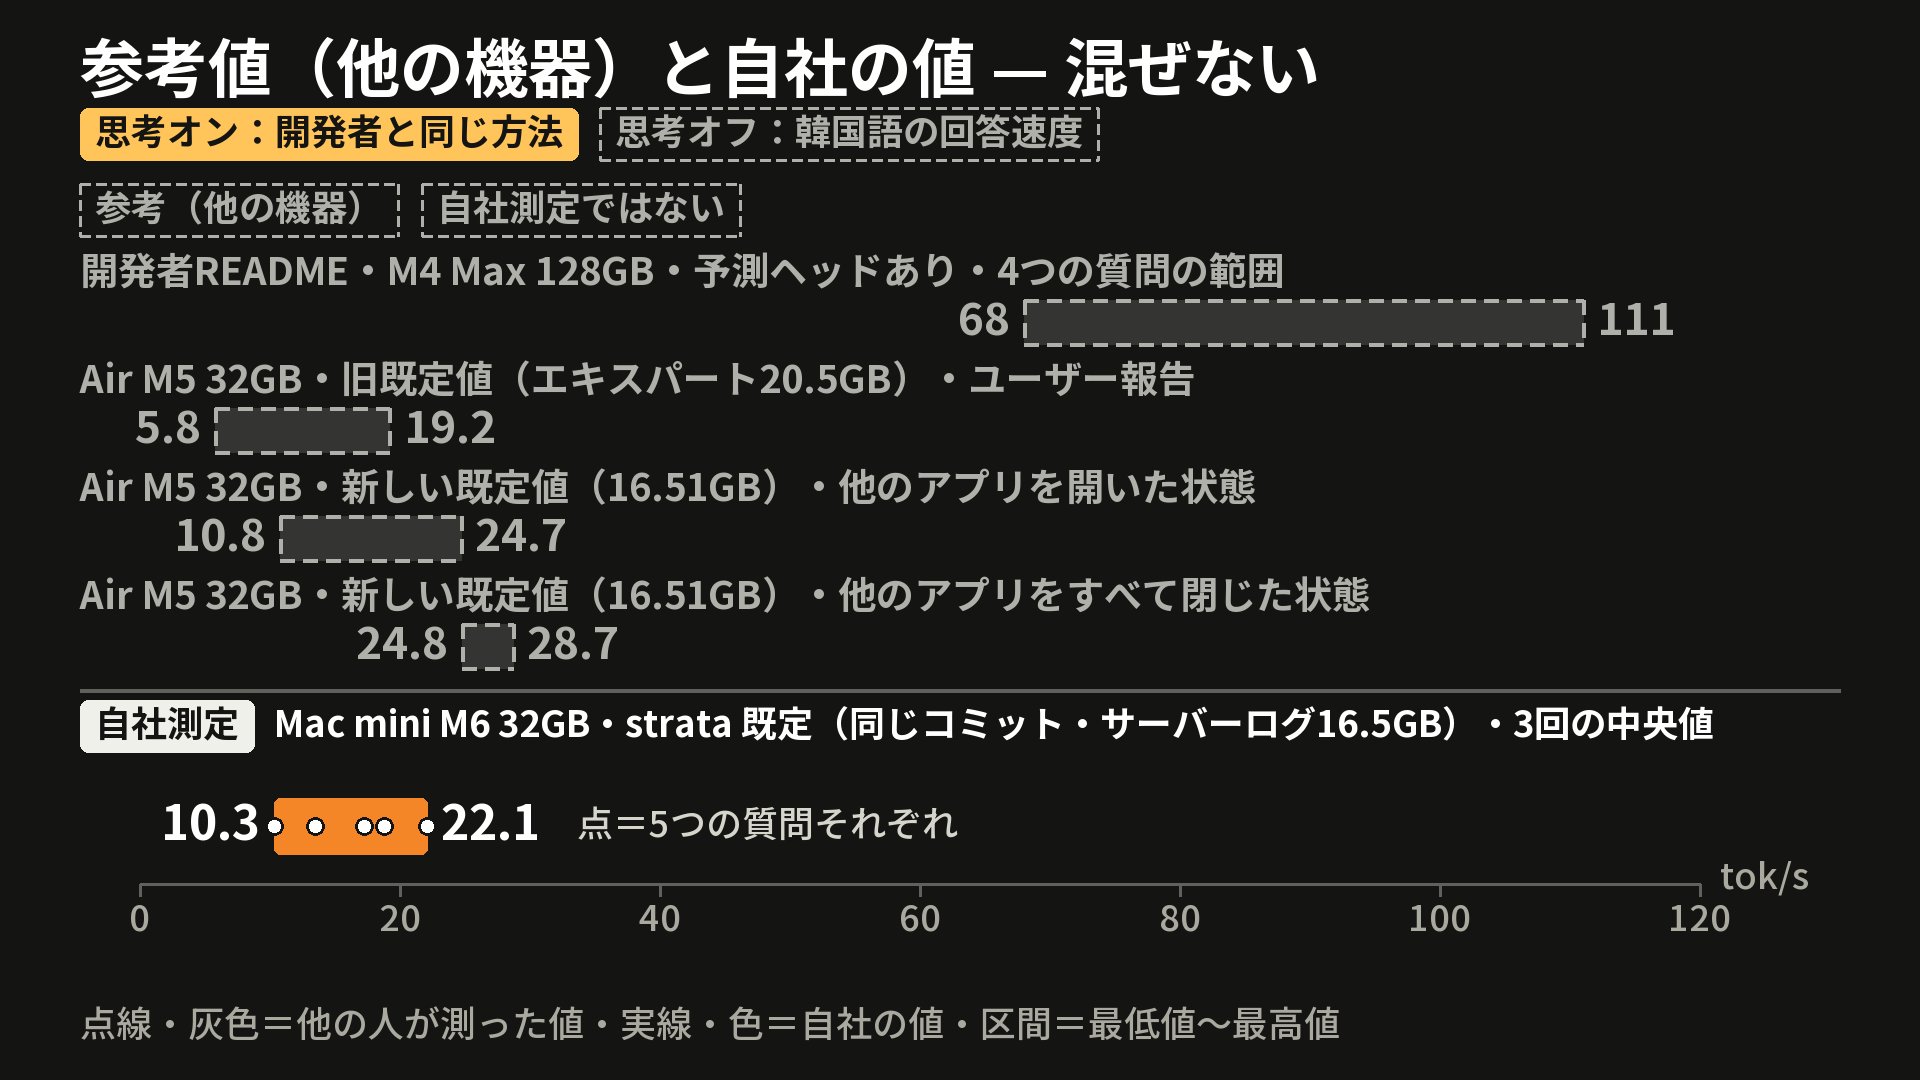
| 値 | 毎秒トークン | 区分 |
|---|---|---|
| 開発者 M4 Max 128GB、予測ヘッドあり | 68~111 | 引用(自社測定ではない) |
| MacBook Air M5 32GBのユーザー、新しい既定値、アプリを開いた状態・閉じた状態 | 10.8~24.7 · 24.8~28.7 | 引用 |
| 自社 Mac mini M6 32GB、思考オンの形式 | 10.3~22.1 | 実測 |
機器と条件が違うため理由は分からず、優劣の比較には使いません。旧既定値の5.8~19.2は、現在と異なる設定です。
速度:同じファイルでエンジンだけを変えると
思考オンの形式では、llama.cppの旧ビルド(CPU)は5つの質問すべてで7.1~7.9トークンです。strataの既定は、修正10.3・韓国語13.5・コード17.3・文章作成18.8・推論22.1トークンです。思考オフの形式では、llama.cppが7.2~7.8、strataの既定が韓国語17.2・推論17.5・コード18.8・修正20.8・文章作成24.0トークンです。
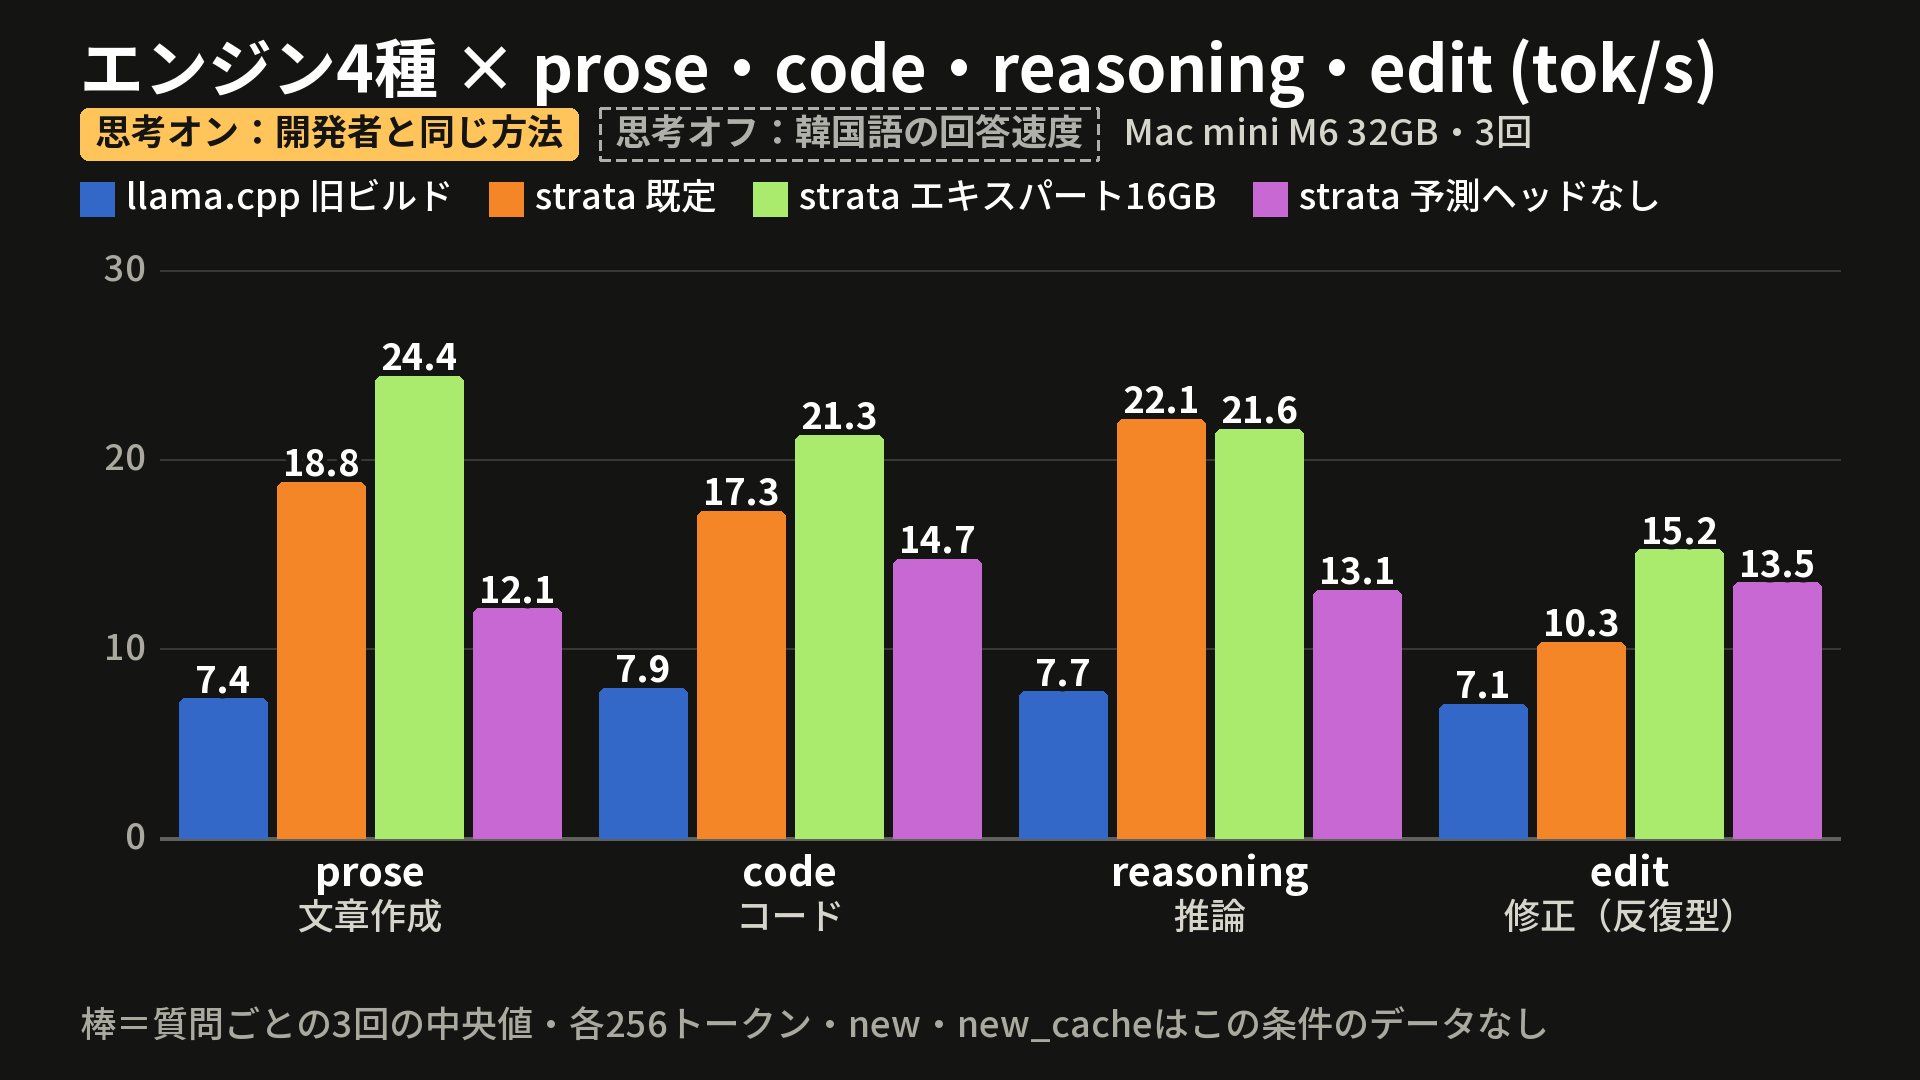
ただしstrataの既定は、回ごとにばらつきました。思考オンの文章作成は15.9~22.5トークンでした。スワップ・発熱・順序のうち原因はどれか、このデータでは切り分けられませんでした。
韓国語の回答速度と27Bとの比較
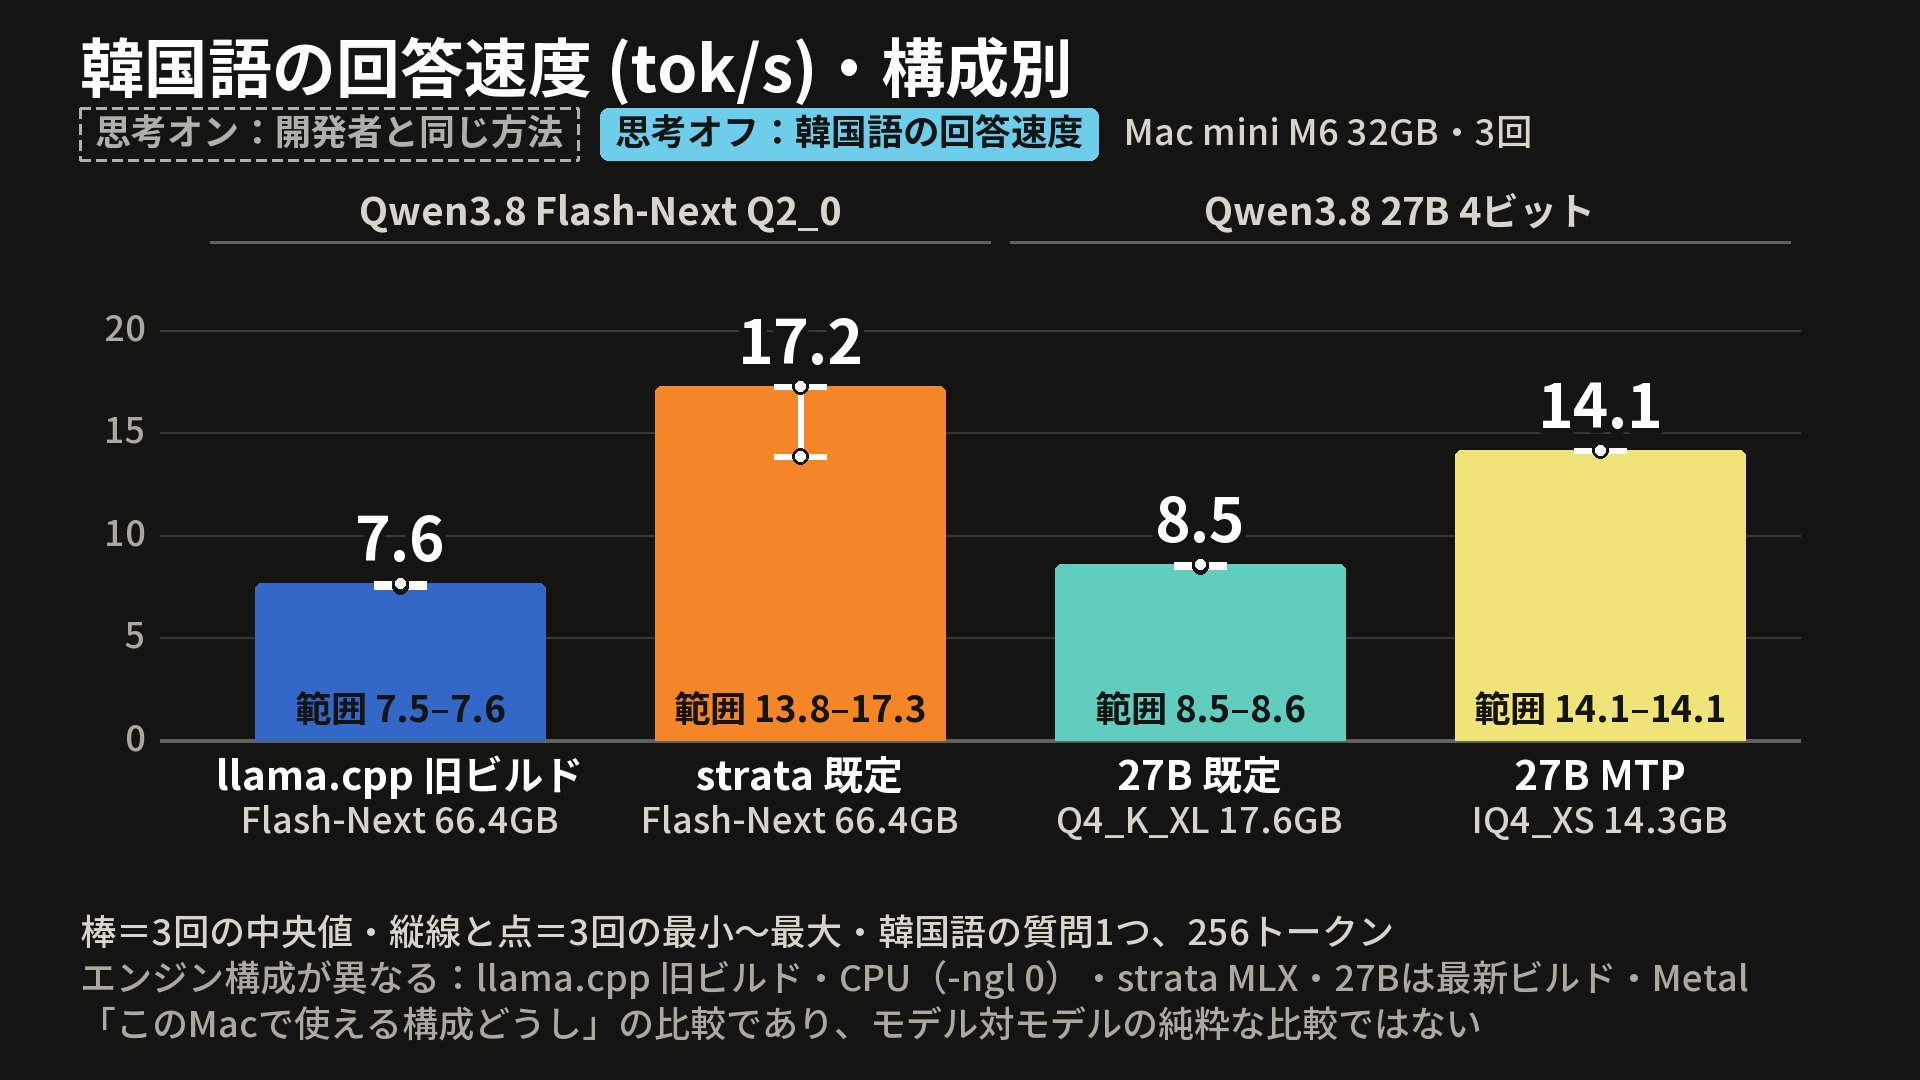
27B 4ビットは最新のllama.cpp(Metal)、Flash-Nextは旧ビルド(CPU)なので、モデル対モデルではなく「このMacで使える構成どうし」の比較です。思考オフの形式で、韓国語の質問が基準です(実測)。
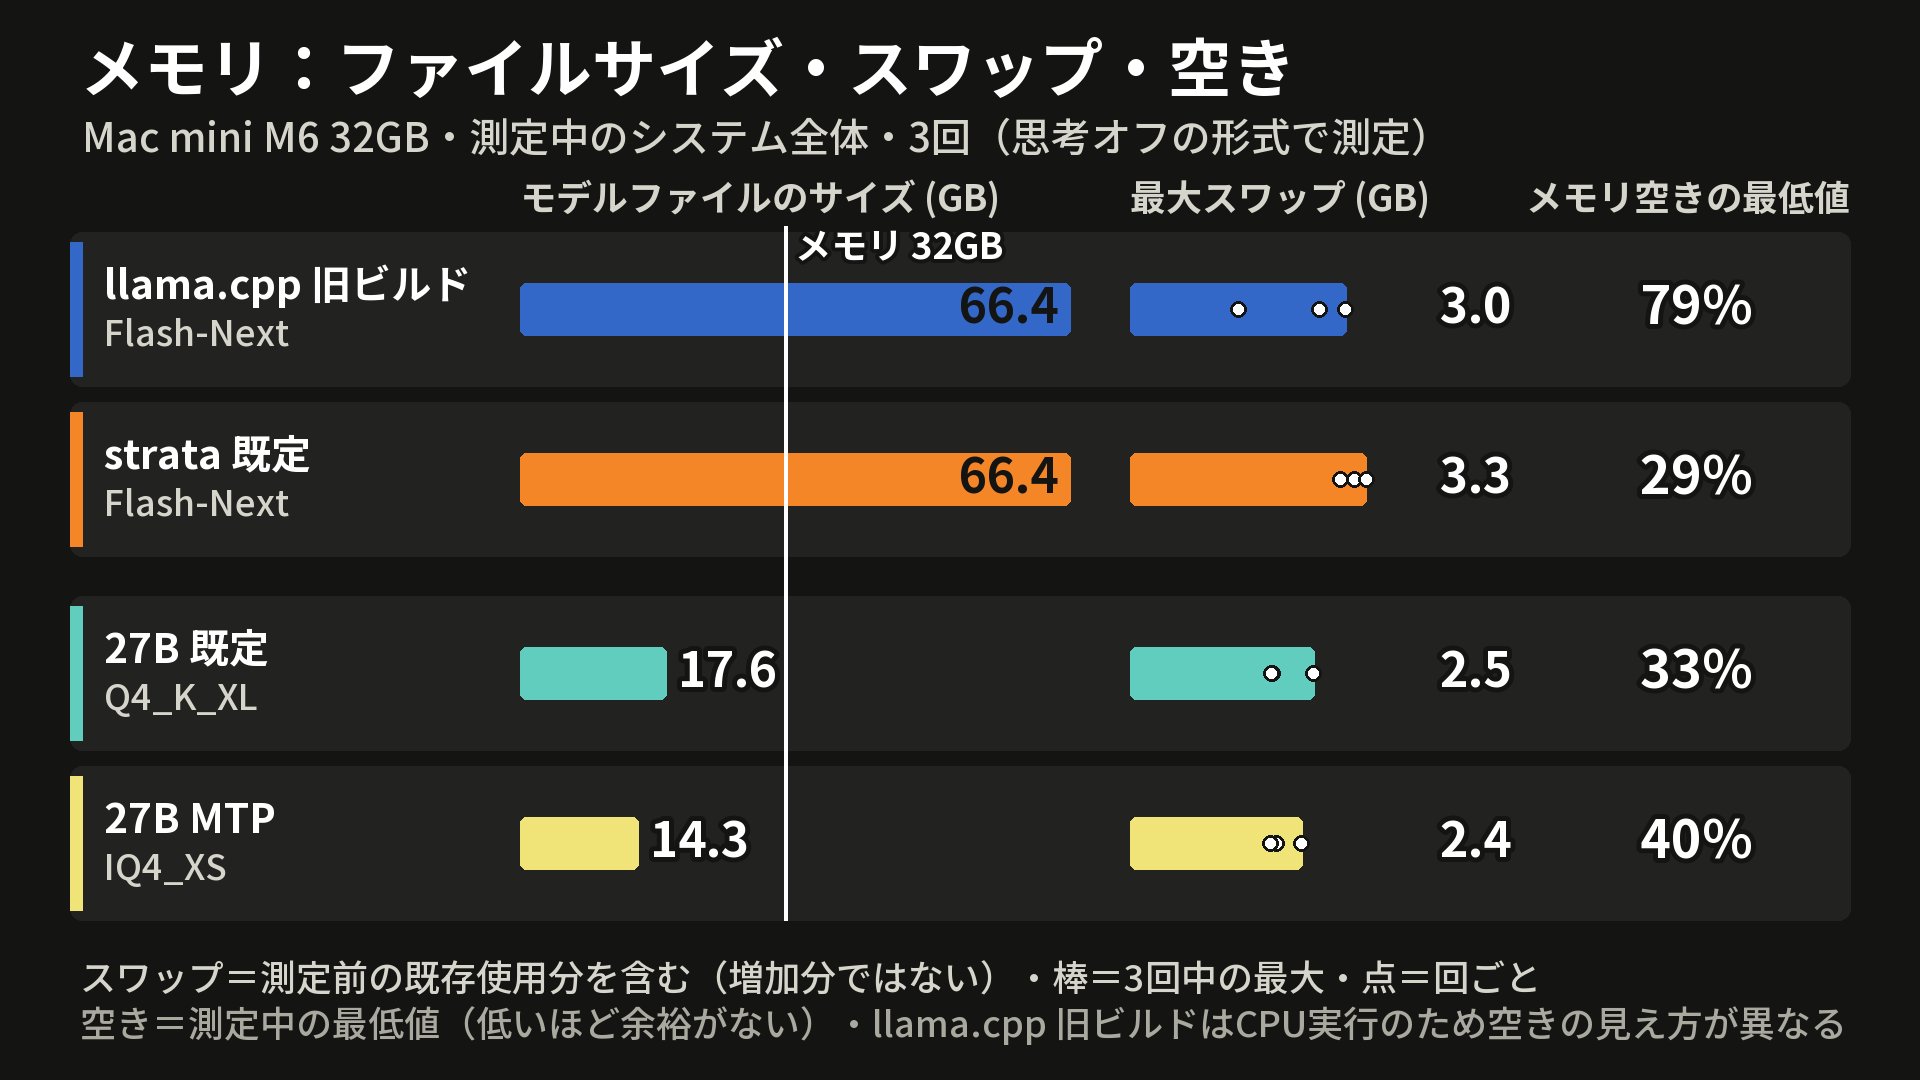
| 構成 | ファイル | 毎秒トークン | 最大スワップ | 空きの最低値 |
|---|---|---|---|---|
| Flash-Next llama.cpp | 66.4GB | 7.6 | 約3.0GB | 79% |
| Flash-Next strata 既定 | 66.4GB | 17.2 | 3.3GB | 29% |
| 27B 既定 Q4_K_XL | 17.6GB | 8.5 | 2.5GB | 33% |
| 27B MTP UD-IQ4_XS | 14.3GB | 14.1 | 2.4GB | 40% |
strata既定の韓国語は3回の値が13.8・17.2・17.3トークン(中央値17.2)で、そのうち最小値の13.8が27B MTPの14.1より低いため、「同等か、少し速い」までしか言えません。スワップは測定前の使用分を含むため、速度の原因だと断定はしません。
正確さ・コーディング・漢字:2ビットの代償
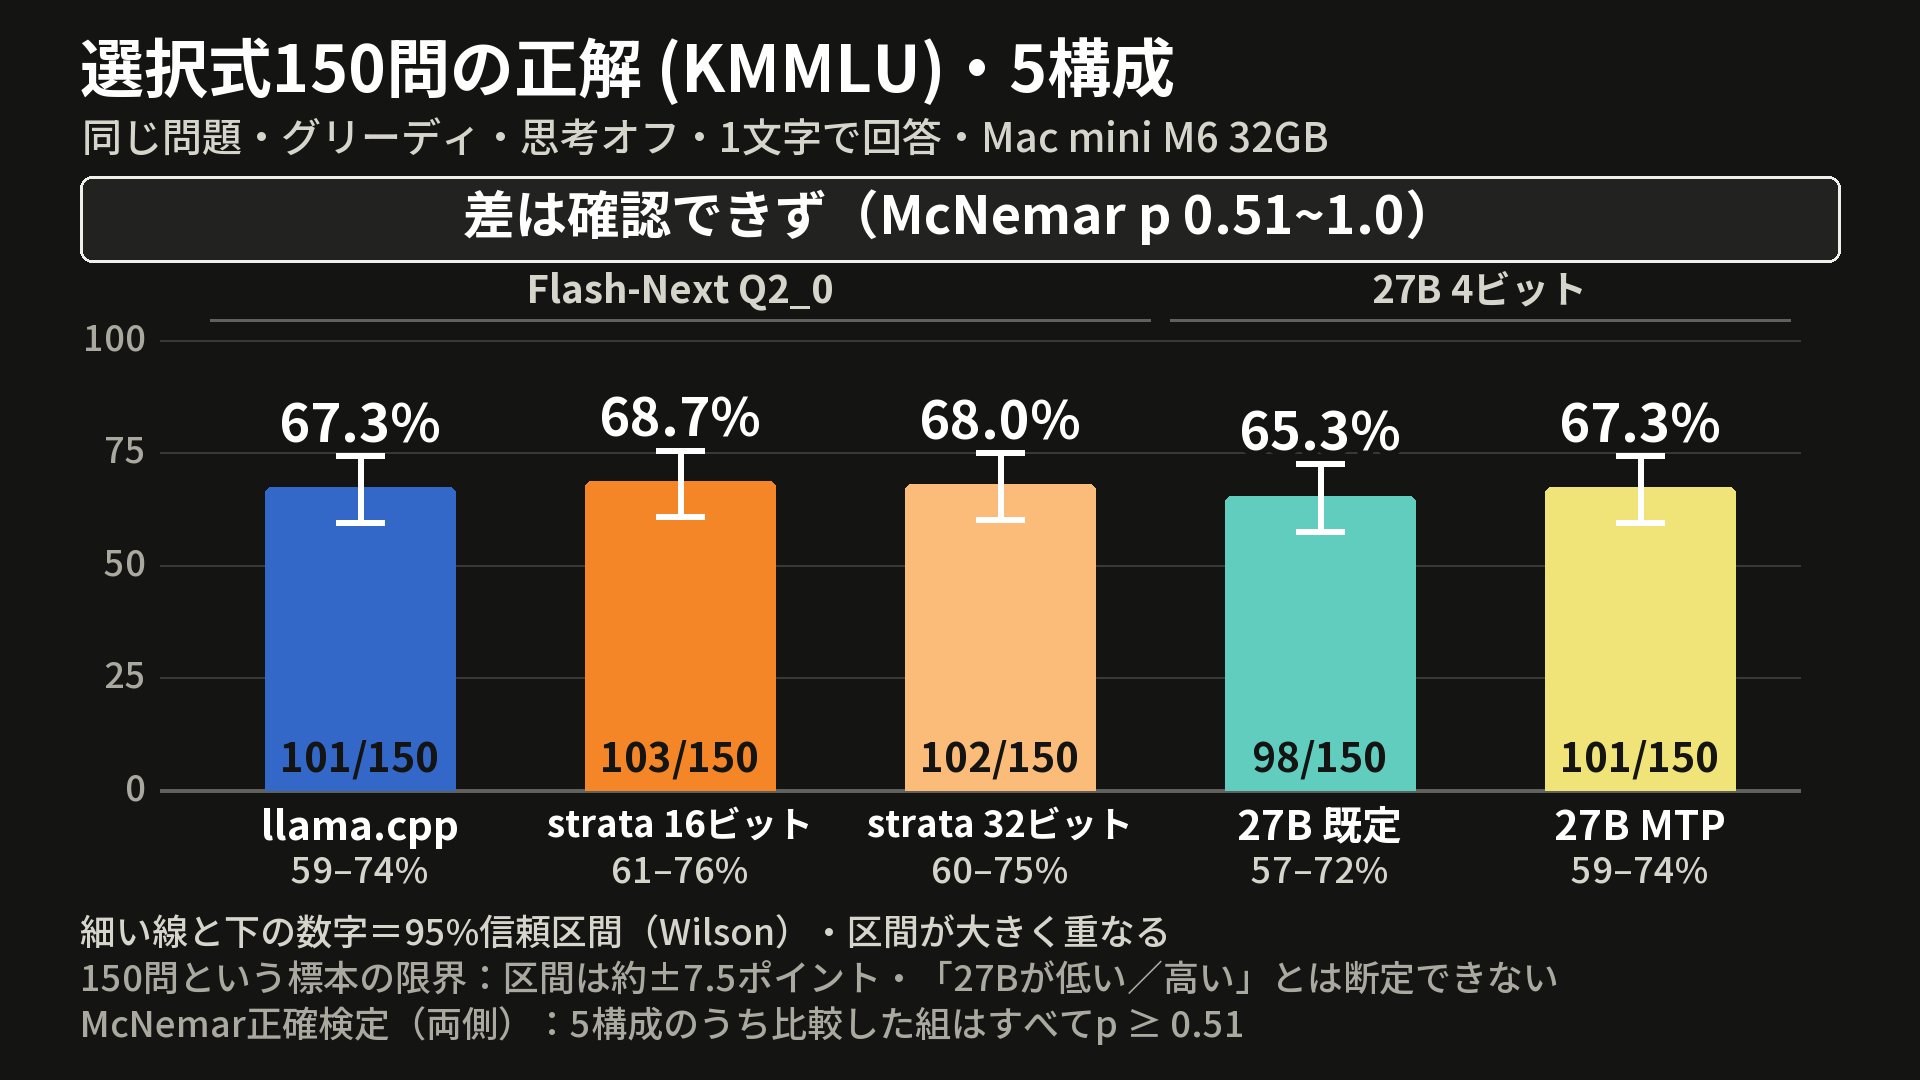
韓国語の選択式問題(KMMLU)150問の正解は、llama.cppが101、strata fp16が103、fp32が102、27B既定が98、27B MTPが101問で、統計検定では差が確認されませんでした。150問では区間の幅が約±7.5ポイントあるため、小さな差は見えません。
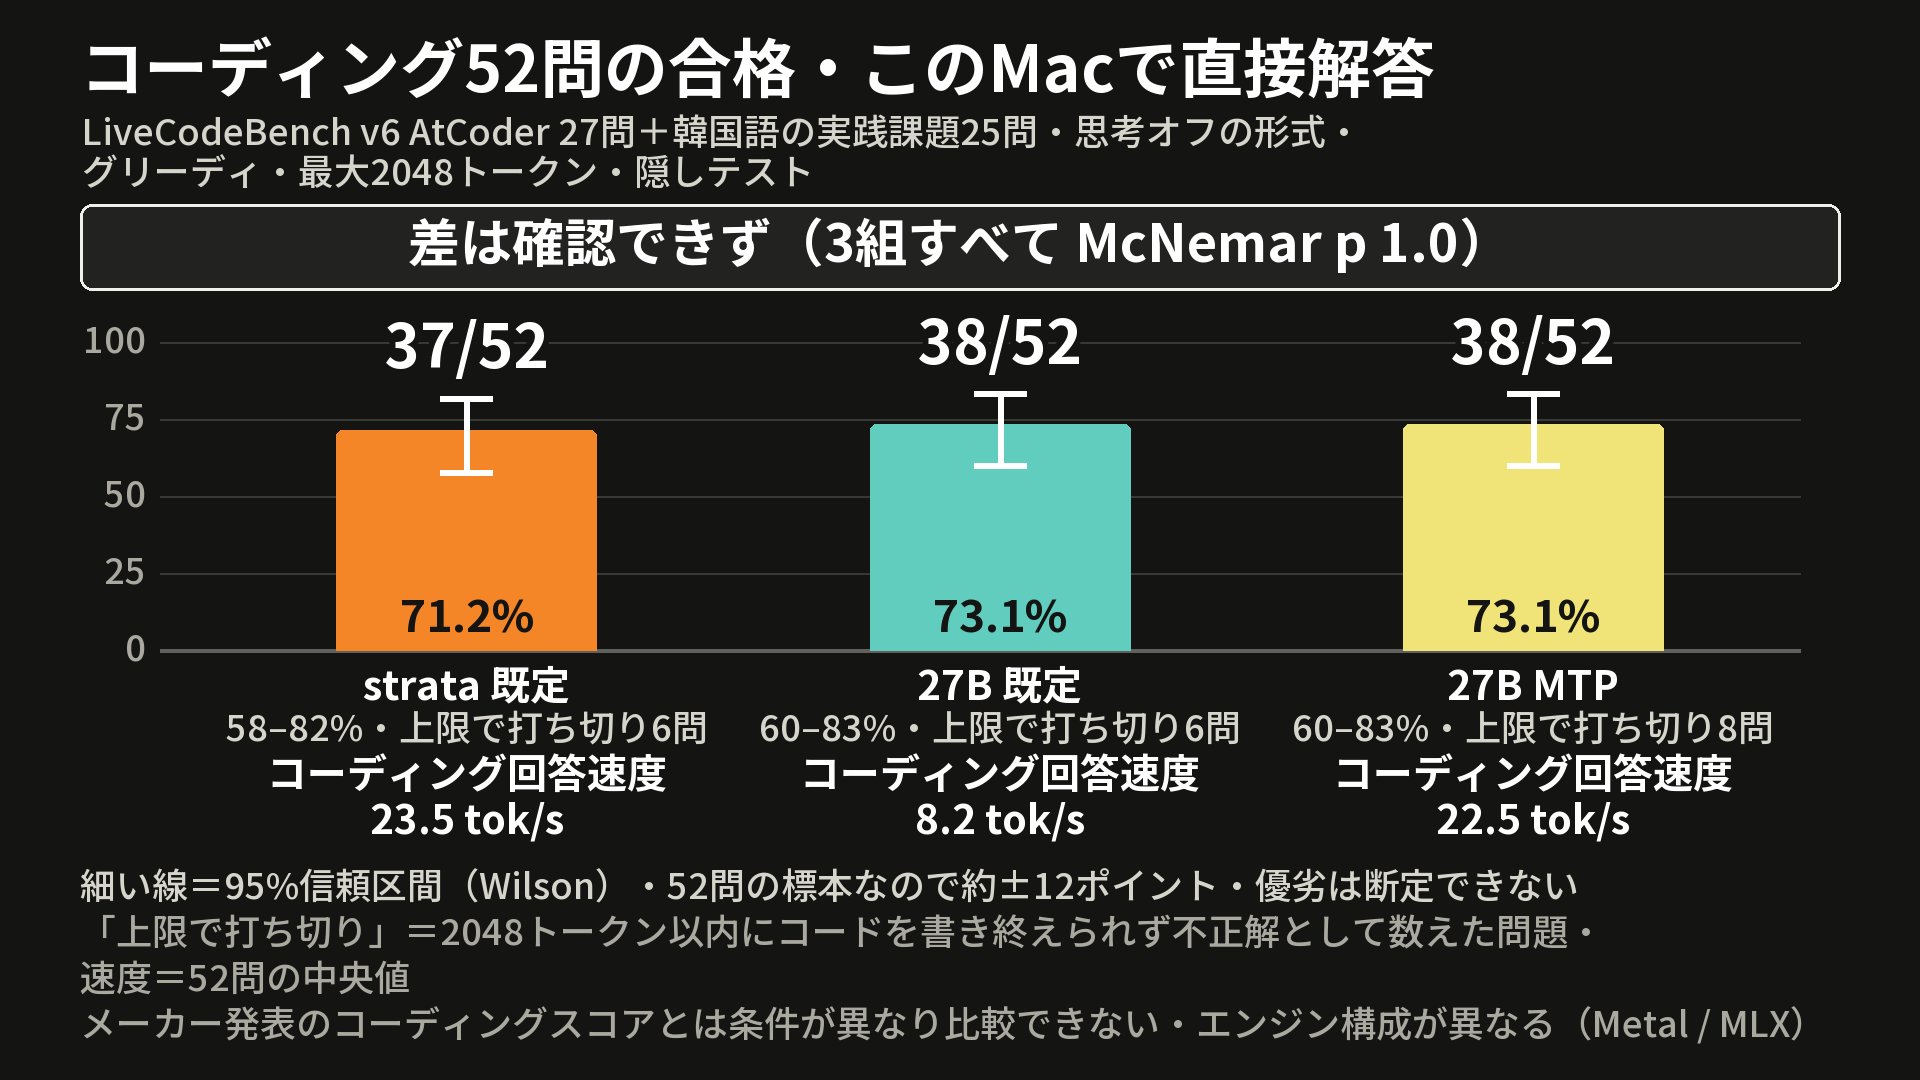
コーディングは、LiveCodeBench v6の27問と韓国語の実践課題25問、合計52問を、隠しテストで採点しました(思考オフの形式、最大2,048トークン)。
| 構成 | 合格 | コーディング回答速度の中央値 |
|---|---|---|
| strata 既定 | 37/52(71.2%) | 23.5トークン |
| 27B 既定 | 38/52(73.1%) | 8.2トークン |
| 27B MTP | 38/52(73.1%) | 22.5トークン |
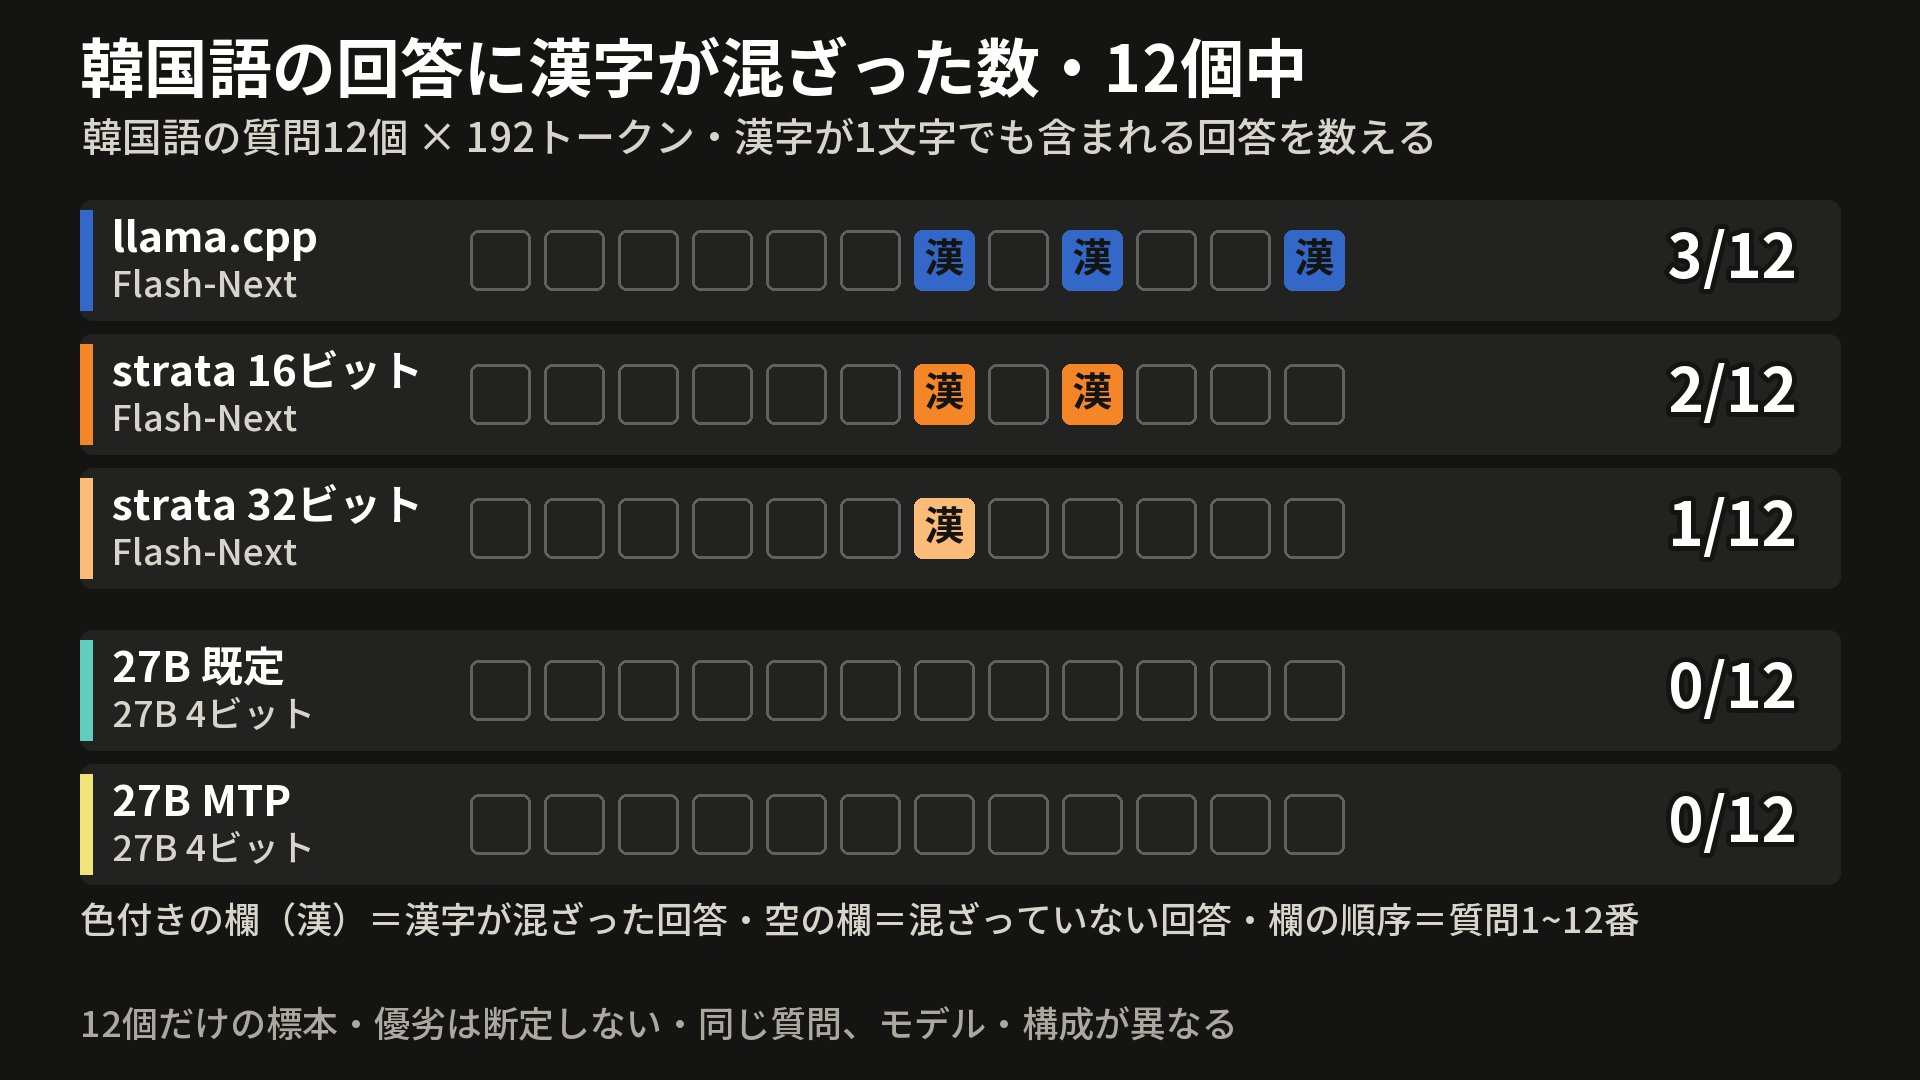
3つの組み合わせすべてで、差を確認できませんでした(McNemar p=1.0)。韓国語の12個の質問で漢字が混ざった回答は、Flash-Nextが1~3個、27Bが0個でしたが、12個の標本なので参考程度にしてください。
公式のモデルカードのスコア(メーカー報告、元の精度)は、Flash-Nextのほうが高くなっています。DeepSWE 58.7対42.2、SWE-bench Pro 62.5対61.7、LiveCodeBench v6 91.9対90.3です。ただしQ2_0のファイルは圧縮したものなので、ファイル作成者の英語での測定では、LiveCodeBenchが87.43から81.14に下がりました(引用)。2つのファイルのコーディングスコアを同じ条件で測った値はありません。
選ぶ基準
- ファイルサイズ・メモリの余裕・漢字の混ざらない韓国語の回答を先に見るなら、27Bのほうです。
- 公式スコアを先に見て、66GBのファイルの代償を受け入れるなら、Flash-Nextです。
- 速度は27B MTPとstrata既定が同程度で、コーディングの正答率で選ぶ根拠は、この測定にはありません。
限界と出典
Mac mini 1台・1日、速度は3回、正確さは150問、コーディングは52問の標本です。strata-mlxは非公式のエンジンで、このモデル専用です。
出典・基準日。 実測は2026-10-13。strata-mlxのリポジトリとissue #6、公式モデルカード(Qwen/Qwen3.8-Flash-Next、Qwen3.8-27B)。
ナレーションはAI音声で、執筆にもAIの補助を使っています。情報提供を目的としたもので、購入を勧めるものではありません。