無料ChatGPT級のローカルAIは24GB 1枚で足りる?3090・5090・Mac mini実測
投稿日 動画公開
24GBのGPU1枚(RTX 3090、4ビット)なら無料ChatGPT級のローカルAIと同じ土俵に立てます。3090・5090・Mac mini M6を同じ問題で測ったメモリ・速度・品質の表と比較基準、限界を整理しました。
結論から言うと、無料ChatGPT級のローカルAIは、24GBのグラフィックカード1枚(RTX 3090、4ビット)で「同じ土俵」までは届きます。 ただし性格が違います。無料のChatGPTは短くて間違いが少なく、ローカルのQwen(Qwen3.8 27B)はより詳しい一方で、ときどき作り話をしました。Mac mini M6 32GBにも載りますが、速度は毎秒8トークン前後です。数字は2026年10月1~2日に自分たちで測った値で、計算と引用は別に表示しています。この記事はYouTube動画の測定内容を文章として整理し直したものです。動画は韓国語で進行します。
「無料ChatGPT級」の基準と比較方法
基準は、ChatGPT無料プランのモデルであるGPT-5.6 Lunaです(公式、料金プランページの無料の欄、2026-10-02確認)。「思考」をオンにした場合とオフにした場合の両方に質問しました。ローカルはQwen3.8 27B 1つを、元のサイズ54.7GB、8ビット29.05GB、4ビット17.56GBに変換して載せました。
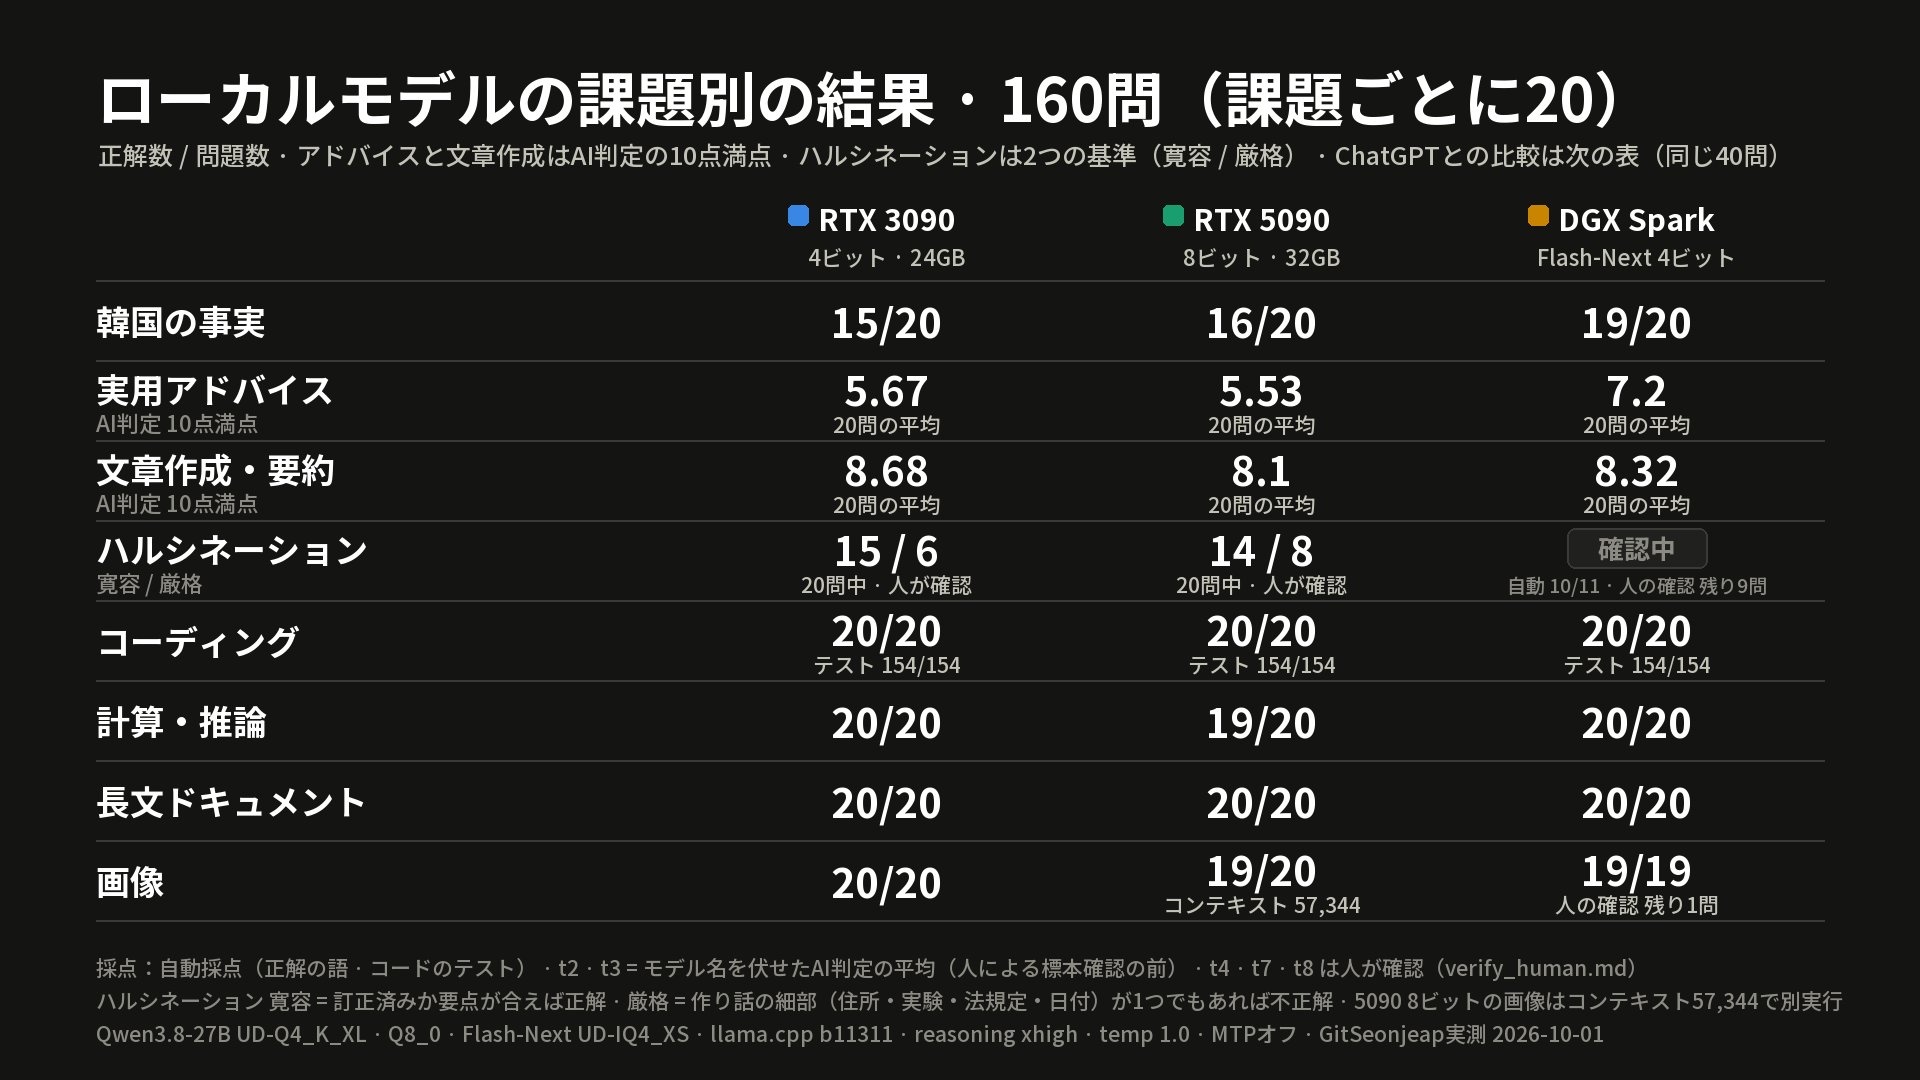
試験は自作の160問(8課題×20問)で、そのうち無作為の40問(8課題×5問)は無料ChatGPTにも同じものを出しました。ただし無料ChatGPTは画像の添付が1日3枚までで、画像の課題はThinkをオンにした3問しか送れませんでした。正解・コードは自動採点、ハルシネーションは人が2つの基準(寛容/厳格)で、アドバイスと文章作成はモデル名を伏せたAI判定の10点満点で採点しています。
公開されている指標(引用)は割れています。Artificial Analysisは、最大の推論設定でLuna 34.56、Qwen 33.70(中間設定なら27.55)、Arena韓国語は1413対1397で、誤差の範囲が重なります。benchlmは66.2対55.4で、差は大きいとみています。
限界:課題ごとに5問なので標本が小さく、アドバイスと文章作成はAI判定です。無料ChatGPTは約20問の後にモデル名が小さいモデルに切り替わったため、その回答(オン3・オフ4)は除外しました。
3機種の測定表
| 機種 | モデル・量子化 | メモリ | 生成速度 | 品質(160問) |
|---|---|---|---|---|
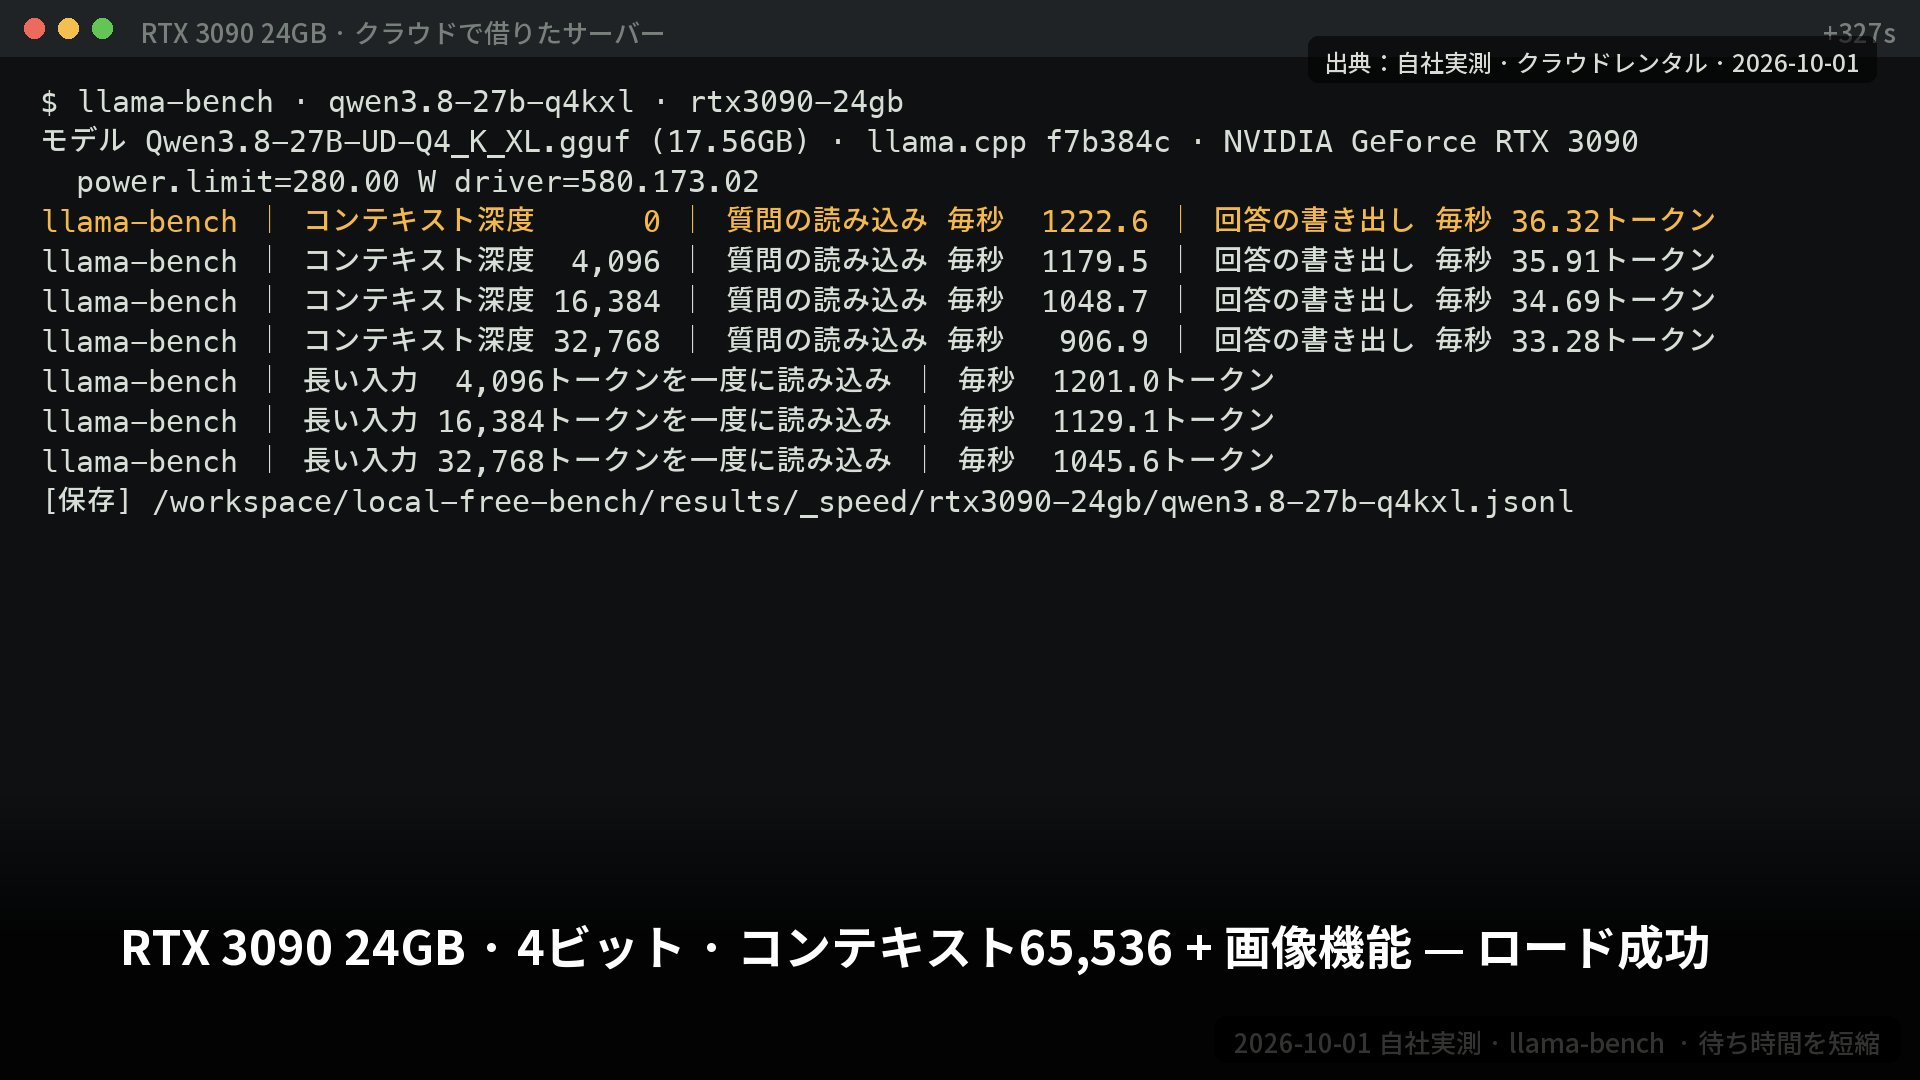
| RTX 3090 24GB | 4ビット | 最大21,838MiB(コンテキスト65,536) | 36.3 トークン/秒 | 韓国の事実 15/20・コーディング 20/20・アドバイス 5.67 |
| RTX 5090 32GB | 8ビット | 31,891MiB(コンテキスト65,536、余裕716MiB) | 52.7 トークン/秒 | 韓国の事実 16/20・コーディング 20/20・アドバイス 5.53 |
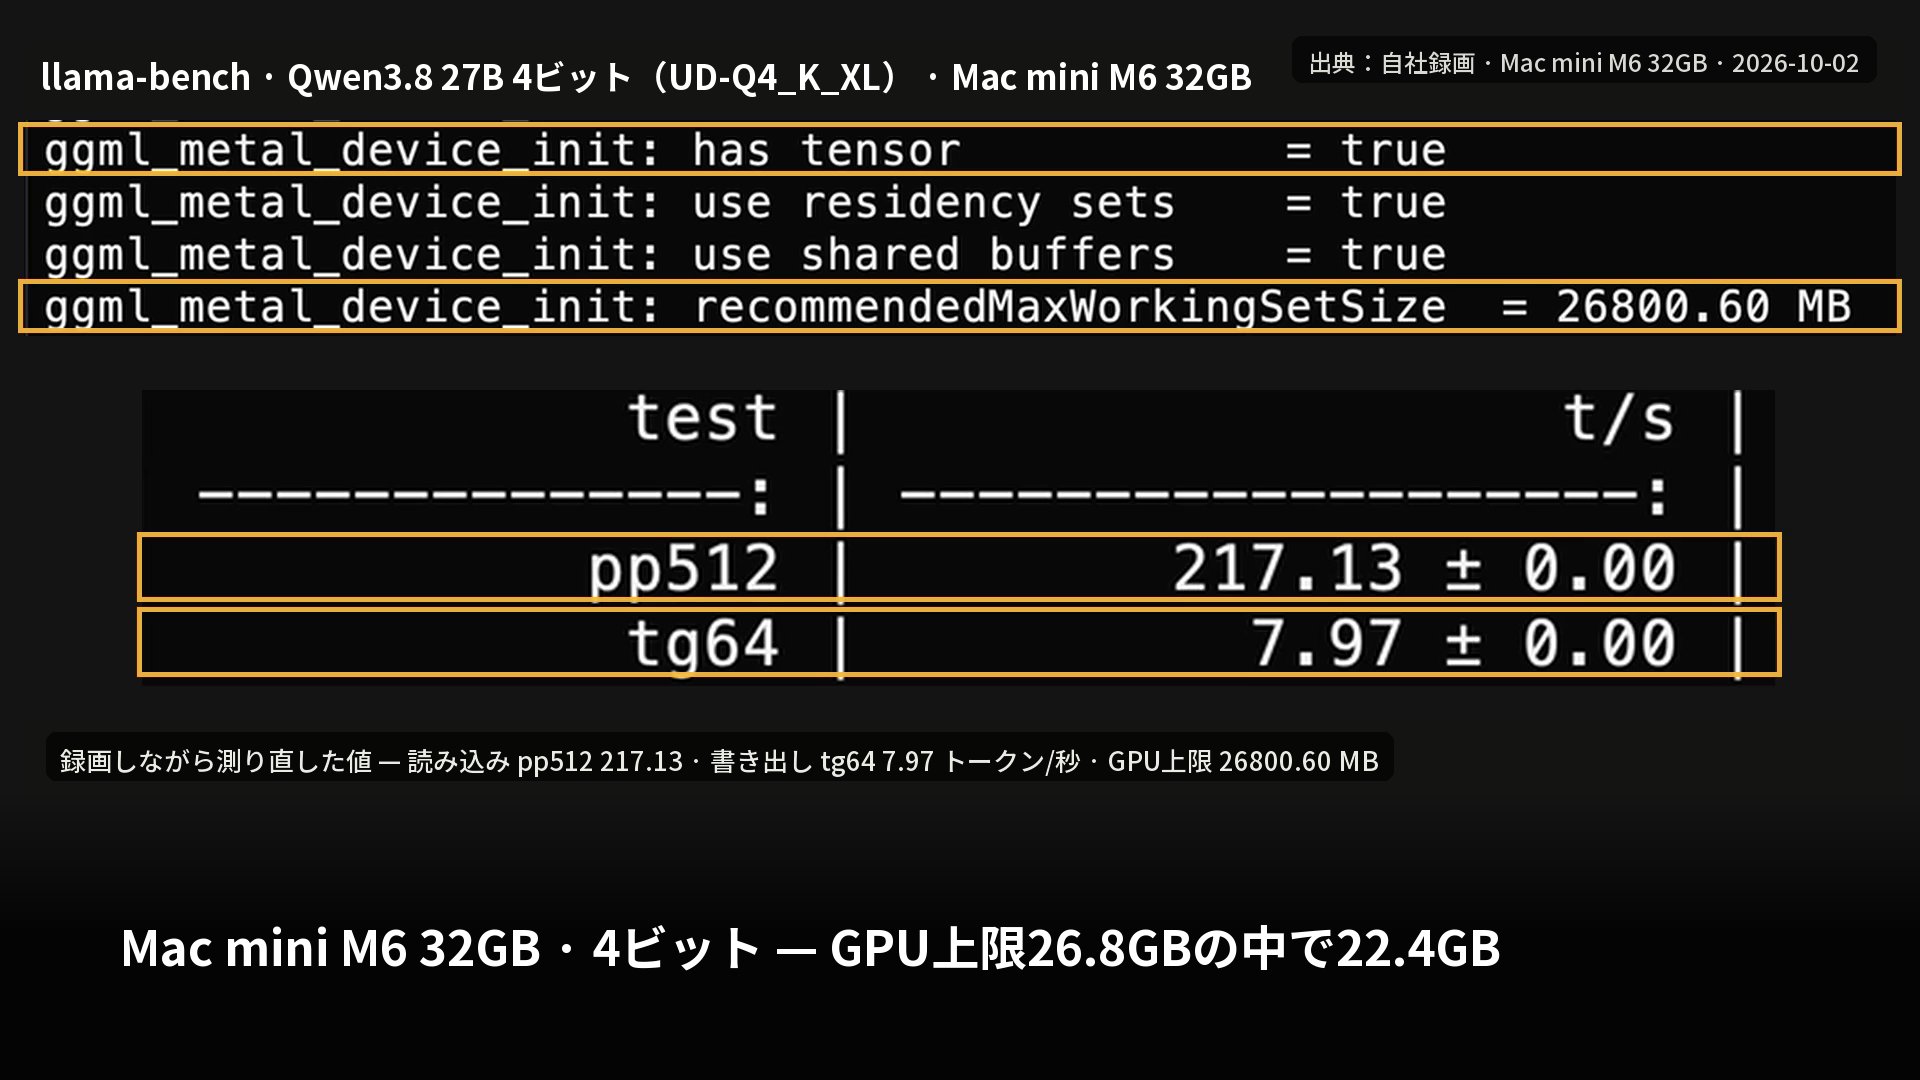
| Mac mini M6 32GB | 4ビット llama.cpp | 22.36GiB(コンテキスト32,768) | 8.17 トークン/秒 | 試験せず |
| Mac mini M6 32GB | MLX 4bit | 最大20.14GB(コンテキスト32,768) | 9.21 トークン/秒 | 試験せず |
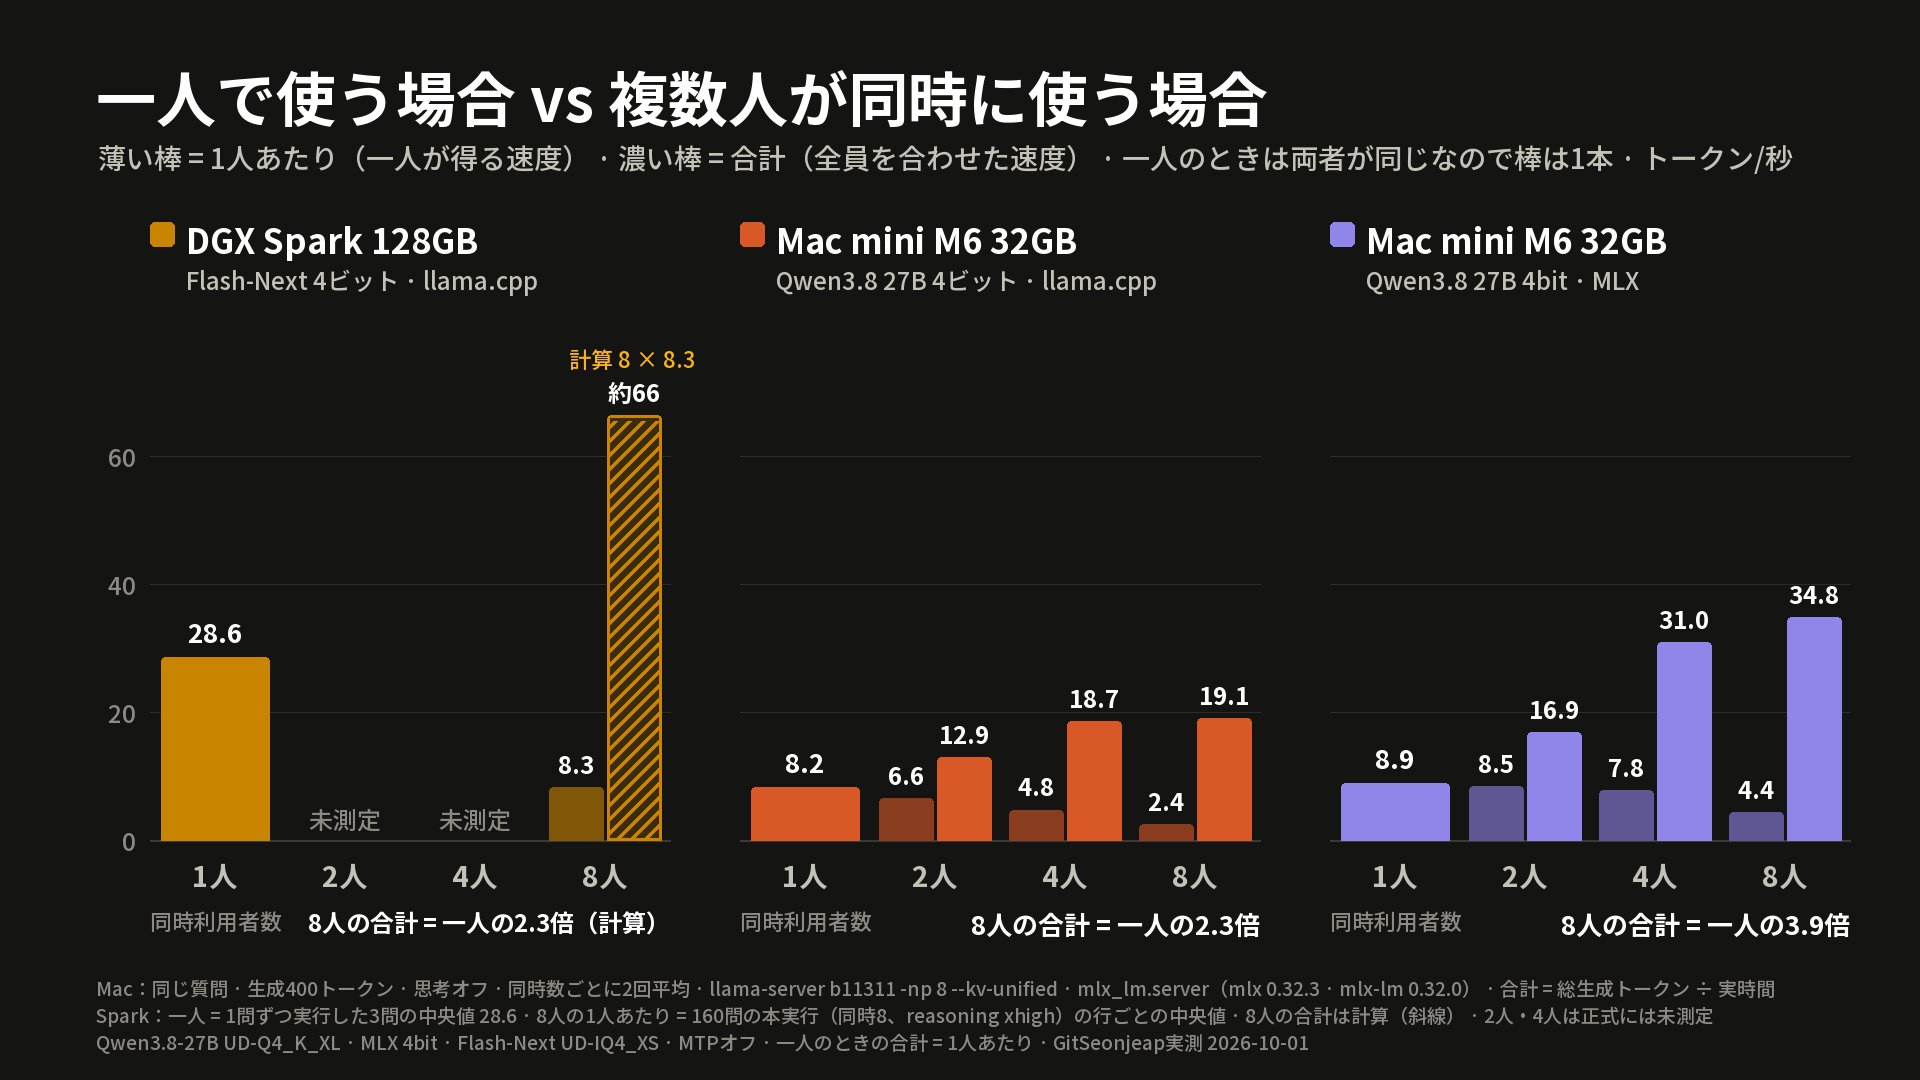
| 参考 DGX Spark 128GB | Flash-Next 4ビット | 67,067MiB(コンテキスト131,072) | 28.6 トークン/秒 | 韓国の事実 19/20 |
すべて自社実測です。速度は一人で使うときのコンテキスト深度0の値(3090は280W、5090は575Wの制限)で、投機的デコード(MTP)はオフにしています。メモリは括弧内のコンテキスト条件での値で、測り方が機種ごとに違うため、そのまま比べてはいけません。アドバイスはAI判定の10点満点です。
機種別の見方
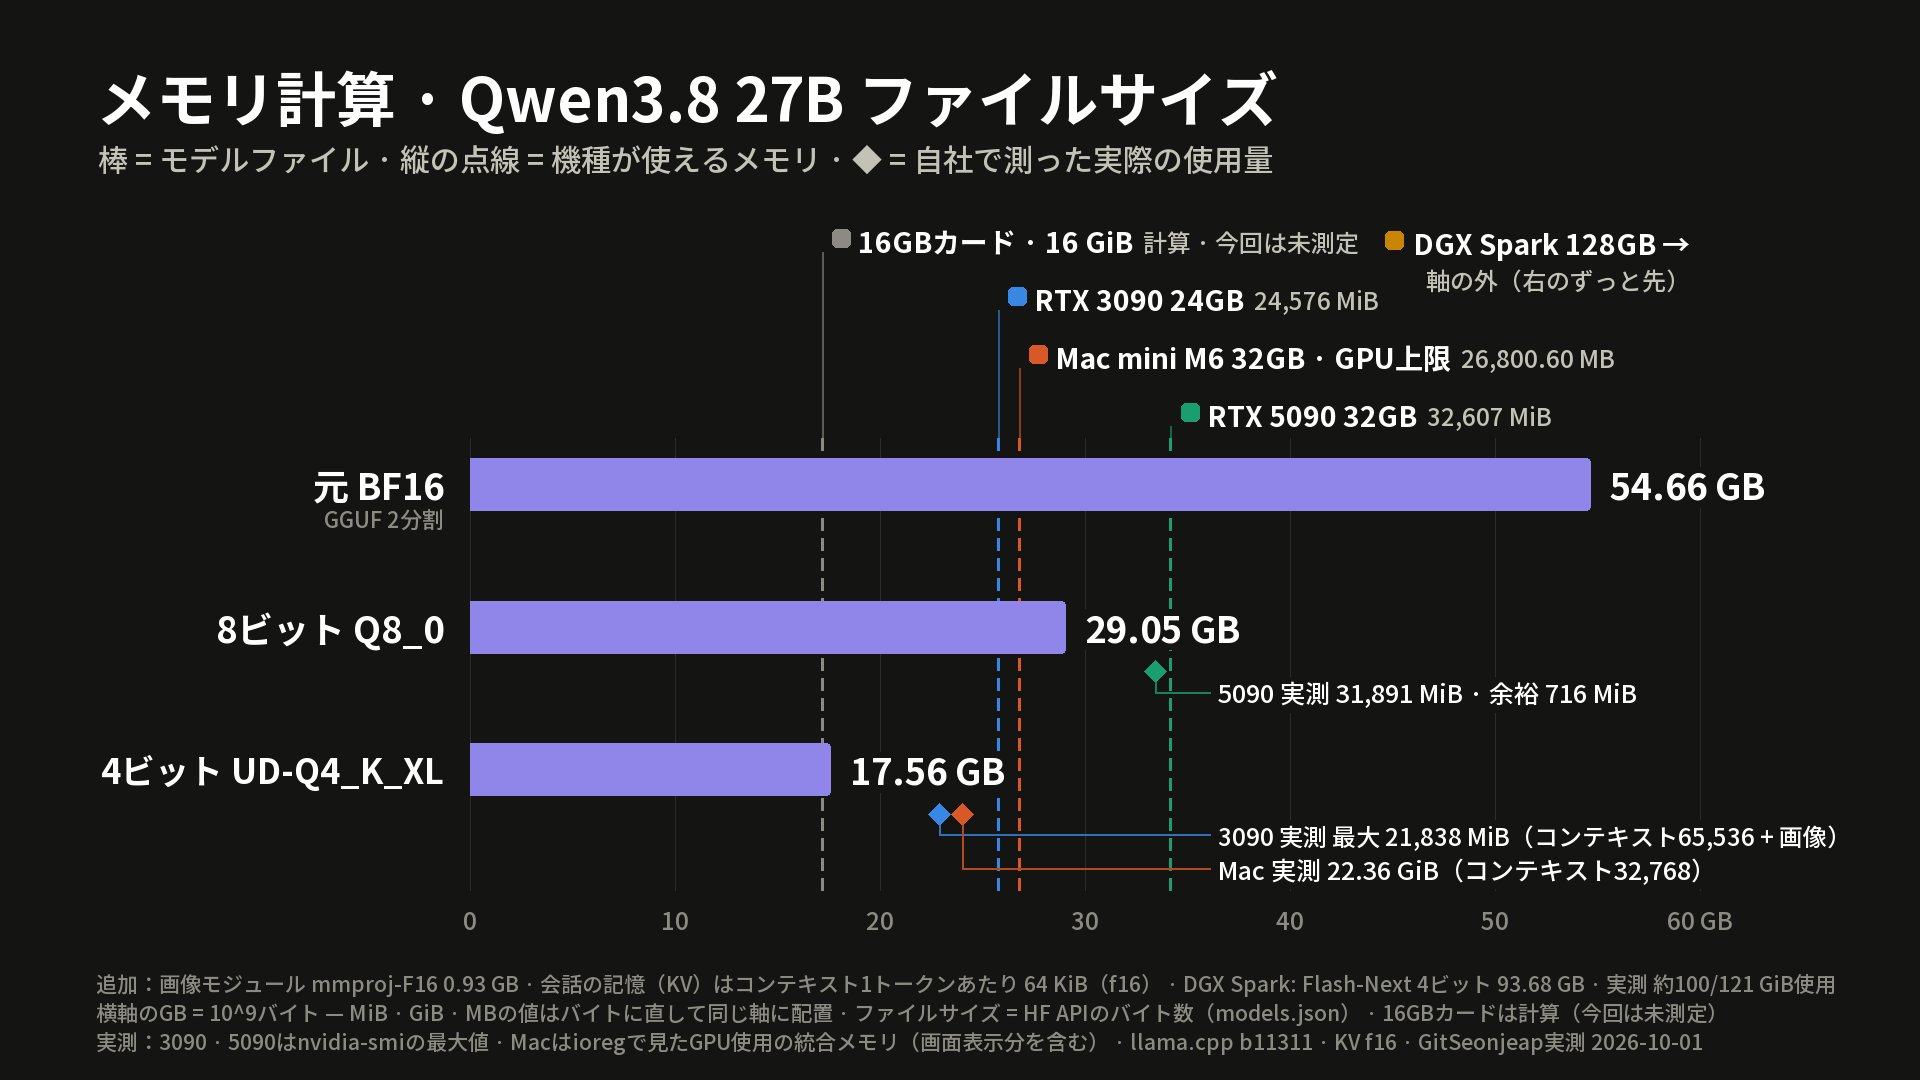
RTX 3090 24GB。 4ビットの17.56GBが、コンテキスト65,536と画像機能をオンにしたまま収まり、160問を最後まで解けました。メモリは最大で約89%で、コンテキスト超過やサーバーの再起動はありませんでした。コーディングは20問をすべて解き、問題ごとに隠しテストがあり、合計154個も全部通りました(表の20/20は問題数、154はテスト数)。
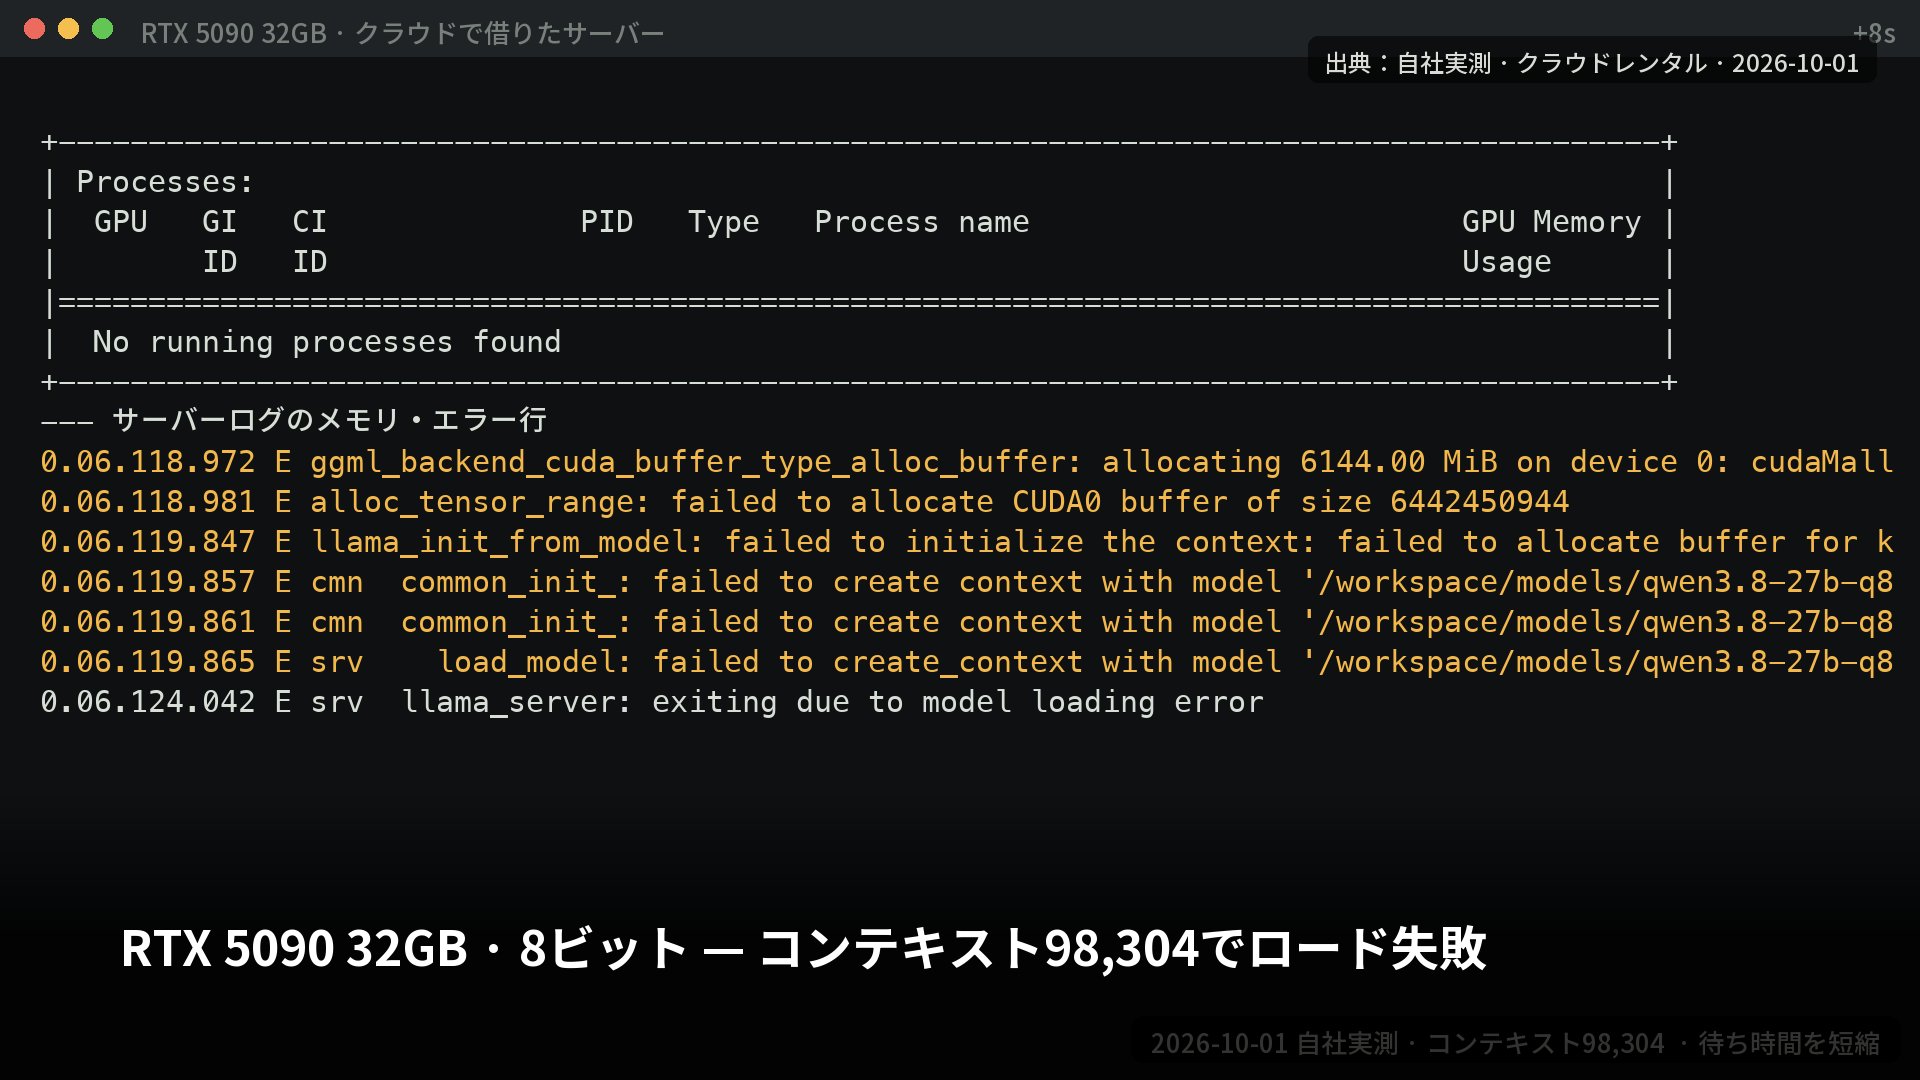
RTX 5090 32GB。 8ビットはぎりぎりで載ります。テキスト55問を解いている途中、画像の問題が入った瞬間にサーバーが落ち、コンテキストを57,344に減らすと画像20問が正常に動きました。画像機能なしでコンテキスト98,304にすると、ロード自体に失敗しました。速度だけを測った4ビットは77.0 トークン/秒で、8ビットより約46%速くなりました(計算)。
Mac mini M6 32GB。 4ビットはGPU上限の26.8GBに収まりました。生成速度は3090の22%ほどで、モデルを起動している間にスワップが9GBまで増えました。3090での実行を基準にすると1問あたり平均2,479トークンなので、Macでは1問に5分ほどかかる計算です(計算)。
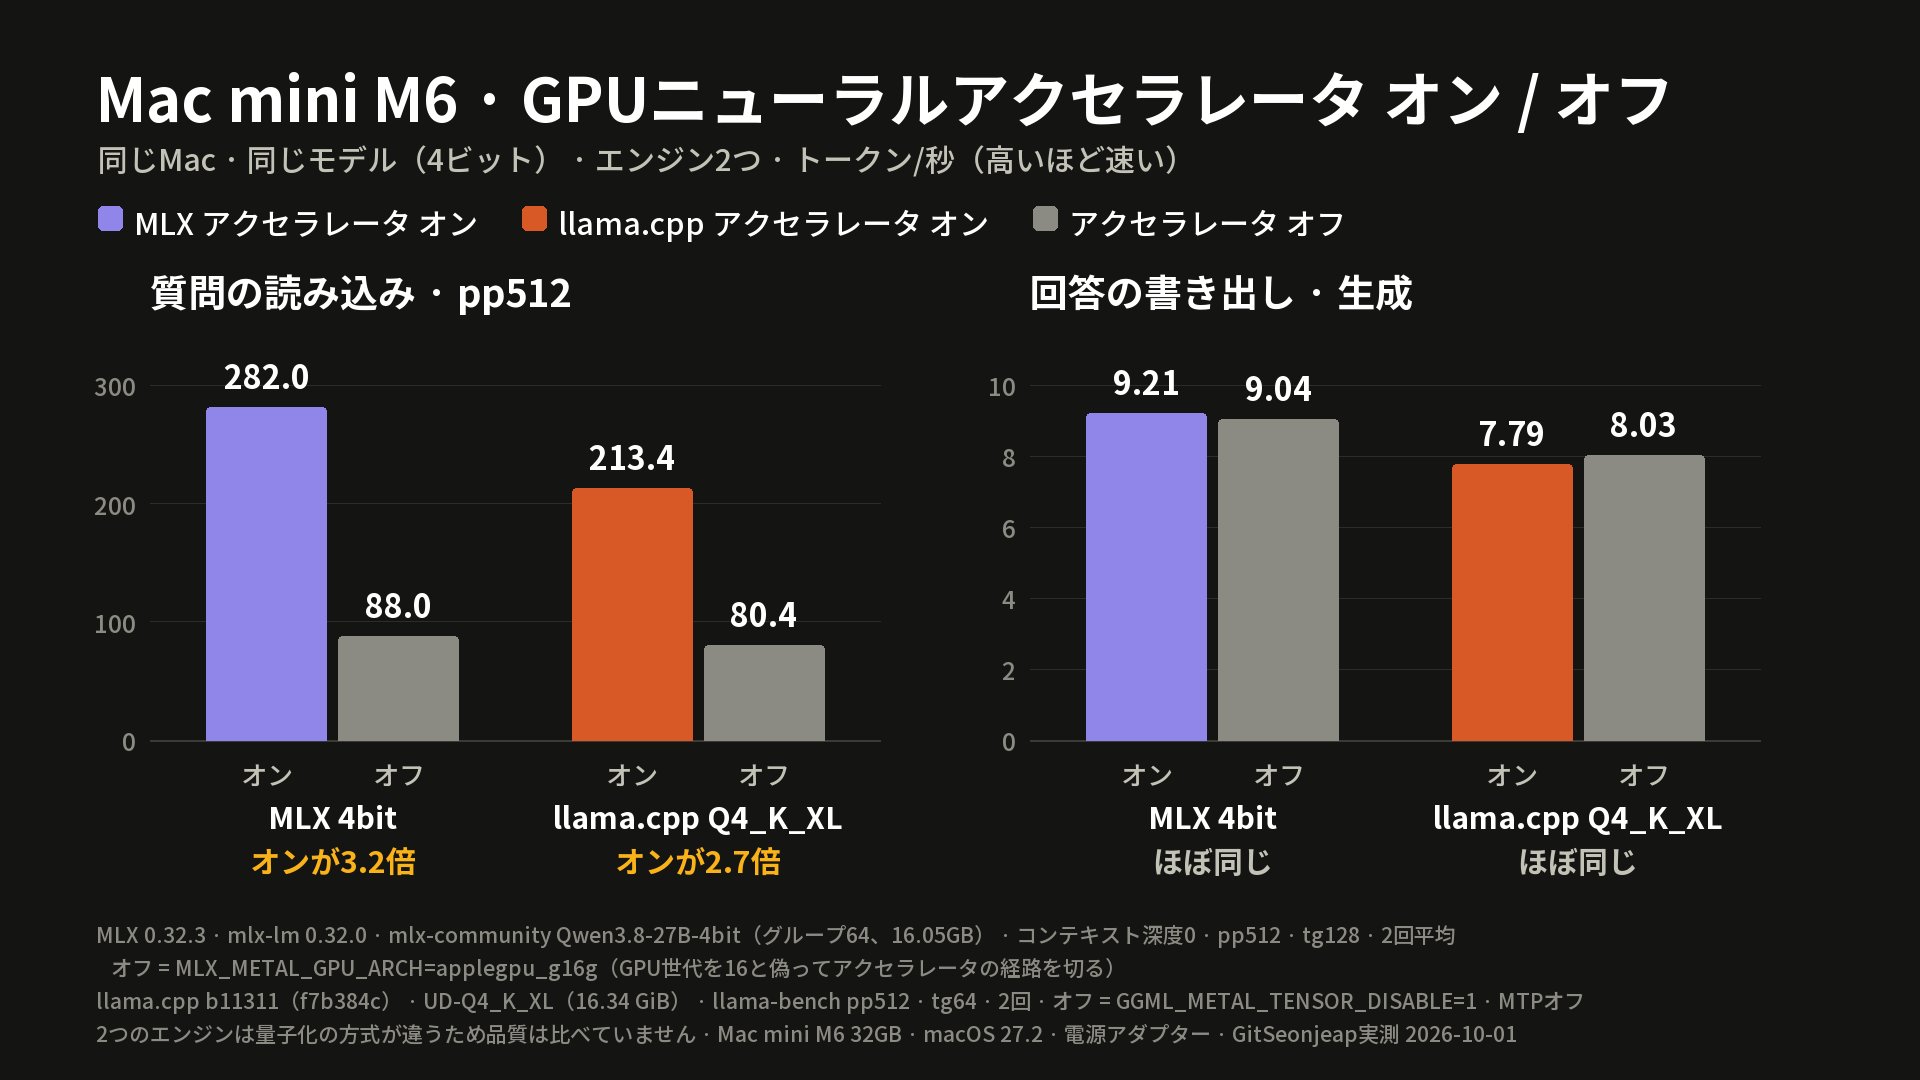
M6のGPUニューラルアクセラレータをオフにすると、質問の読み込みだけが遅くなります。MLXは282対88トークン/秒(約3.2倍)で、回答の書き出しは9.21対9.04と同じでした。8人が同時に使った場合の合計は、llama.cppが19.1、MLXが34.8 トークン/秒です。
同じ40問での比較
8課題のうち画像の課題は、ChatGPTでは3問だけだったため、いちばん下に別の1行として置きました。アドバイスの点数は、上の3機種の表(3090が5.67、5090が5.53)と下の表(7.6、6.0)で異なります。上の表は160問のうちアドバイス20問の平均で、下の表は同じアドバイス5問だけをChatGPTの回答と一緒にモデル名を伏せて判定し直した値のため、問題と判定の回が異なり、互いに比べることはできません。
| 課題(5問) | ChatGPT 思考オン | ChatGPT 思考オフ | 3090 4ビット | 5090 8ビット |
|---|---|---|---|---|
| 韓国の事実 | 5/5 | 5/5 | 4/5 | 4/5 |
| アドバイス(10点) | 6.6 | 6.3 | 7.6 | 6.0 |
| 文章作成(10点) | 6.7 | 6.5 | 8.4 | 7.9 |
| ハルシネーション(寛容/厳格) | 5/5 | 5/5 | 3/1 | 3/2 |
| コーディング(問題数) | 5/5 | 5/5 | 5/5 | 5/5 |
| 計算・推論 | 5/5 | 4/5 | 5/5 | 4/5 |
| 長文ドキュメント | 4/5 | 5/5 | 5/5 | 5/5 |
| 画像 | 3/3(3問のみ) | 送らず(上限) | 5/5 | 5/5(コンテキスト57,344) |
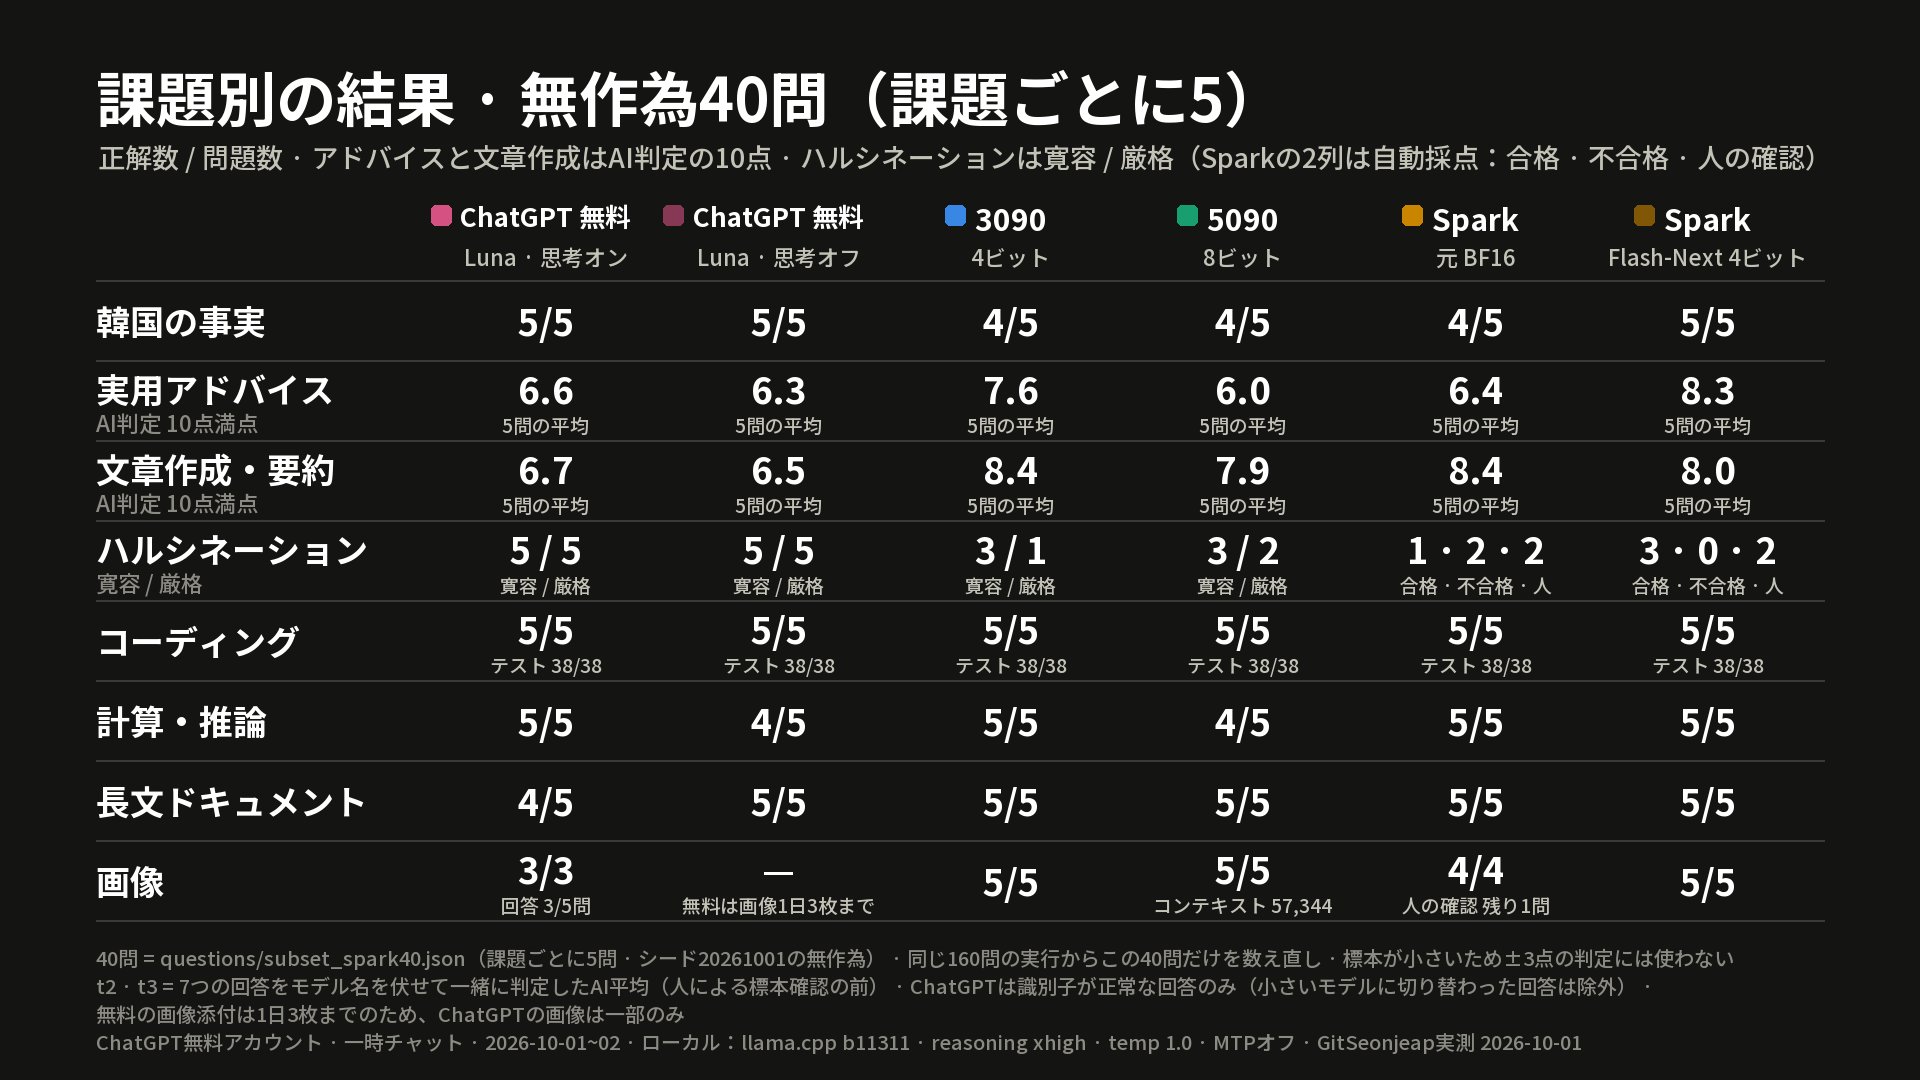
ローカルが負けるのは3点です。韓国の事実(5,000ウォン札(韓国)の人物の正解は李珥(이이)ですが、4ビットは実在しない名前、8ビットは申師任堂(신사임당)と答えました)、作り話の細部、待ち時間です。3090でのアドバイス1問は中央値280秒、無料ChatGPTは中央値4秒(最大31秒)でした。ただしChatGPTは必要に応じてインターネットを検索して出典を付けたのに対し、ローカルはインターネットなしで答えました。
勝っているのは、アドバイスと文章作成のAI判定の点数(詳しく書いた)と、利用上限なしで自分のマシンの中で完結する点です。
無料ChatGPT級のローカルAIの選択肢と限界
- 24GB以上のグラフィックカード:4ビットが載ります。韓国に関する事実・法律・番号は、別途確認してください。
- 32GBのMac:載りますが、毎秒8トークン台なので、一人で短く使う用途までです。
- 16GB以下:4ビットの17.56GBに会話の記憶用の領域がさらに加わるため、難しいです(計算、未測定)。
- 128GB級:より大きなFlash-Next 4ビットが載ります(DGX Sparkのクラウドレンタルで測定)。
無料ChatGPT級のローカルAIが同じ土俵に立てるのは、「性格が違う」という前提のもとでだけです。速度と正確さのどちらを譲るかが基準になります。
出典・基準日・限界
- 実測:2026-10-01~02。グラフィックカードとDGX Sparkはクラウドレンタル、Mac miniは自前の機器。llama.cpp 11311、MLX 0.32.3、reasoning xhigh
- 公式:ChatGPTの料金プランページ。引用:Artificial Analysis v4.3.2・Arena韓国語・benchlm。計算:比率・所要時間・必要メモリ量
- 動画の公開日(2026-10-02)基準で、モデル・料金プラン・利用上限はその後変わる可能性があります。
ナレーションはAI音声で、執筆にもAIの補助を使っています。購入を勧めるものではありません。