GLM-5.3 FlashとQwen 3.8 Flash-Nextを実測、Mac mini 32GBとRTX PRO 6000で比較
投稿日 動画公開
GLM-5.3 FlashとQwen 3.8 Flash-Nextを同じ4ビットで、Mac mini 32GBとサーバー2台で測りました。自分の機器で動くか、速度、韓国語40問の結果を、測定・他者の測定・推定に分けています。
GLM-5.3 FlashとQwen 3.8 Flash-Nextのどちらが優れているかより先に、「自分のMacやPCで動くか」を見ました。Mac mini M6 32GBには93.7GBのFlash-NextをSSDから必要な部分を読み込む方式で載せ、毎秒5.7トークンが出ました。クラウドで借りたサーバー2台では、同じ4ビットで両モデルの速度と韓国語40問を測りました。この記事はYouTube動画の内容を、当チャンネルの測定・他者の測定・計算や推定に分けて整理し直したものです。
結論から
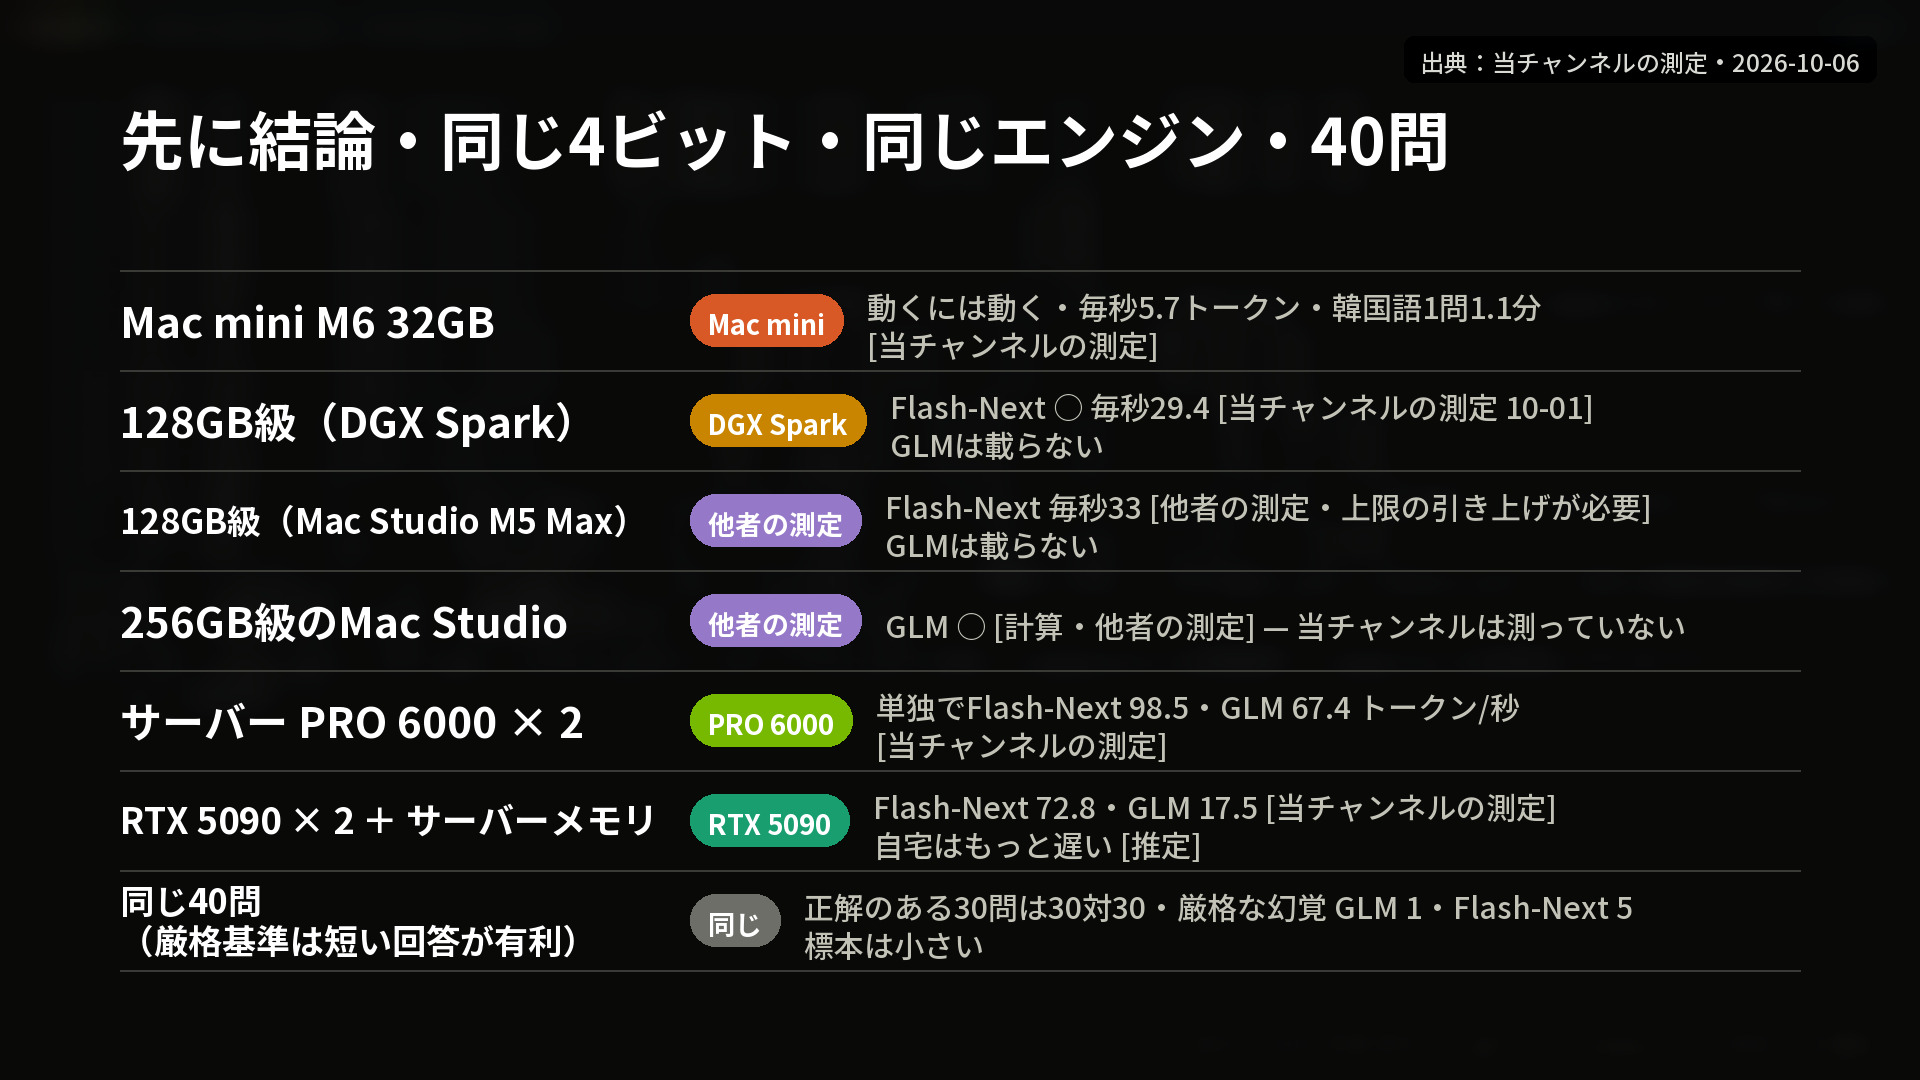
- 32GBのMac miniではFlash-Nextは動くには動きますが、短い韓国語1問に中央値で1.1分かかります。GLMは156.8GBのためダウンロードしていません。
- 動画の読み方:Flash-NextはDGX SparkやMac Studio 128GB級、GLMは256GB級があると楽です。
- 正解のある30問は、両モデルとも30問すべて正解しました。正解のあとに付け足した余計な事実まで数える厳しい基準で幻覚5問のうち合格したのは、GLMが1問、Flash-Nextが5問で、短く答える側に有利な基準です。
- サーバーで1人で使うと、Flash-Nextは毎秒98.5トークン、GLMは毎秒67.4トークンです。RTX 5090 2枚にサーバーメモリを組み合わせると72.8トークン対17.5トークンです。
この記事の数字の種類
| 表記 | 意味 |
|---|---|
| 当チャンネルの測定 | Mac mini M6 32GB、レンタルサーバー2台、DGX Spark(2026-10-01)で直接測った値 |
| 他者の測定 | heretik.io、sleepingrobotsなどの公開資料。当チャンネルの条件と直接比較しないこと |
| 計算・推定 | ファイルサイズに会話記憶領域を足した適合表、自宅PCはもっと遅いはずという推定 |
| 価格 | 動画に表示された2026-10-01時点の値。確認できなかったものは未確認 |
なぜこの順番で見たか
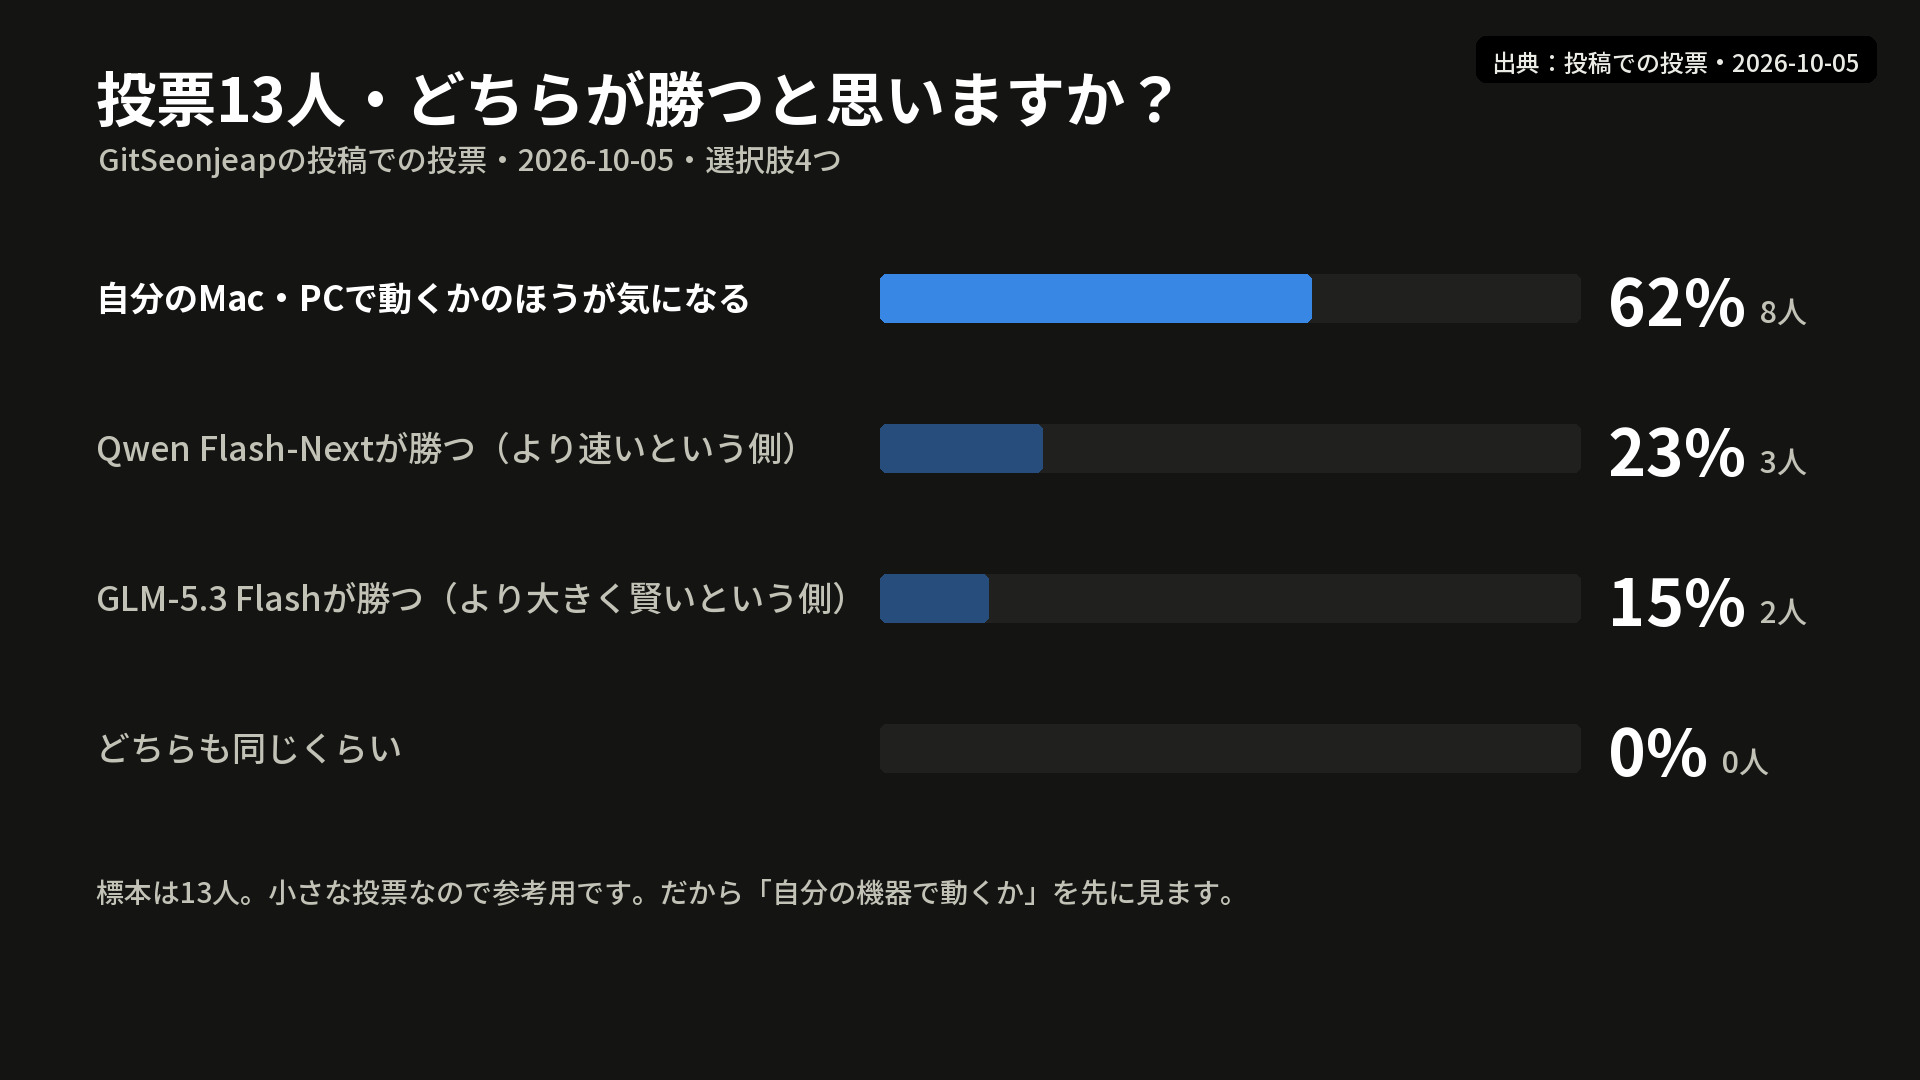
動画は投票から生まれました。13人中8人(62%)が「自分のMac・PCで動くかのほうが気になる」を、3人が「Qwenが勝つ」を、2人が「GLMが勝つ」を選びました。サンプルが小さく参考程度ですが、だからこそ誰が勝つかよりも先に、自分の機器で動くかを見ました。
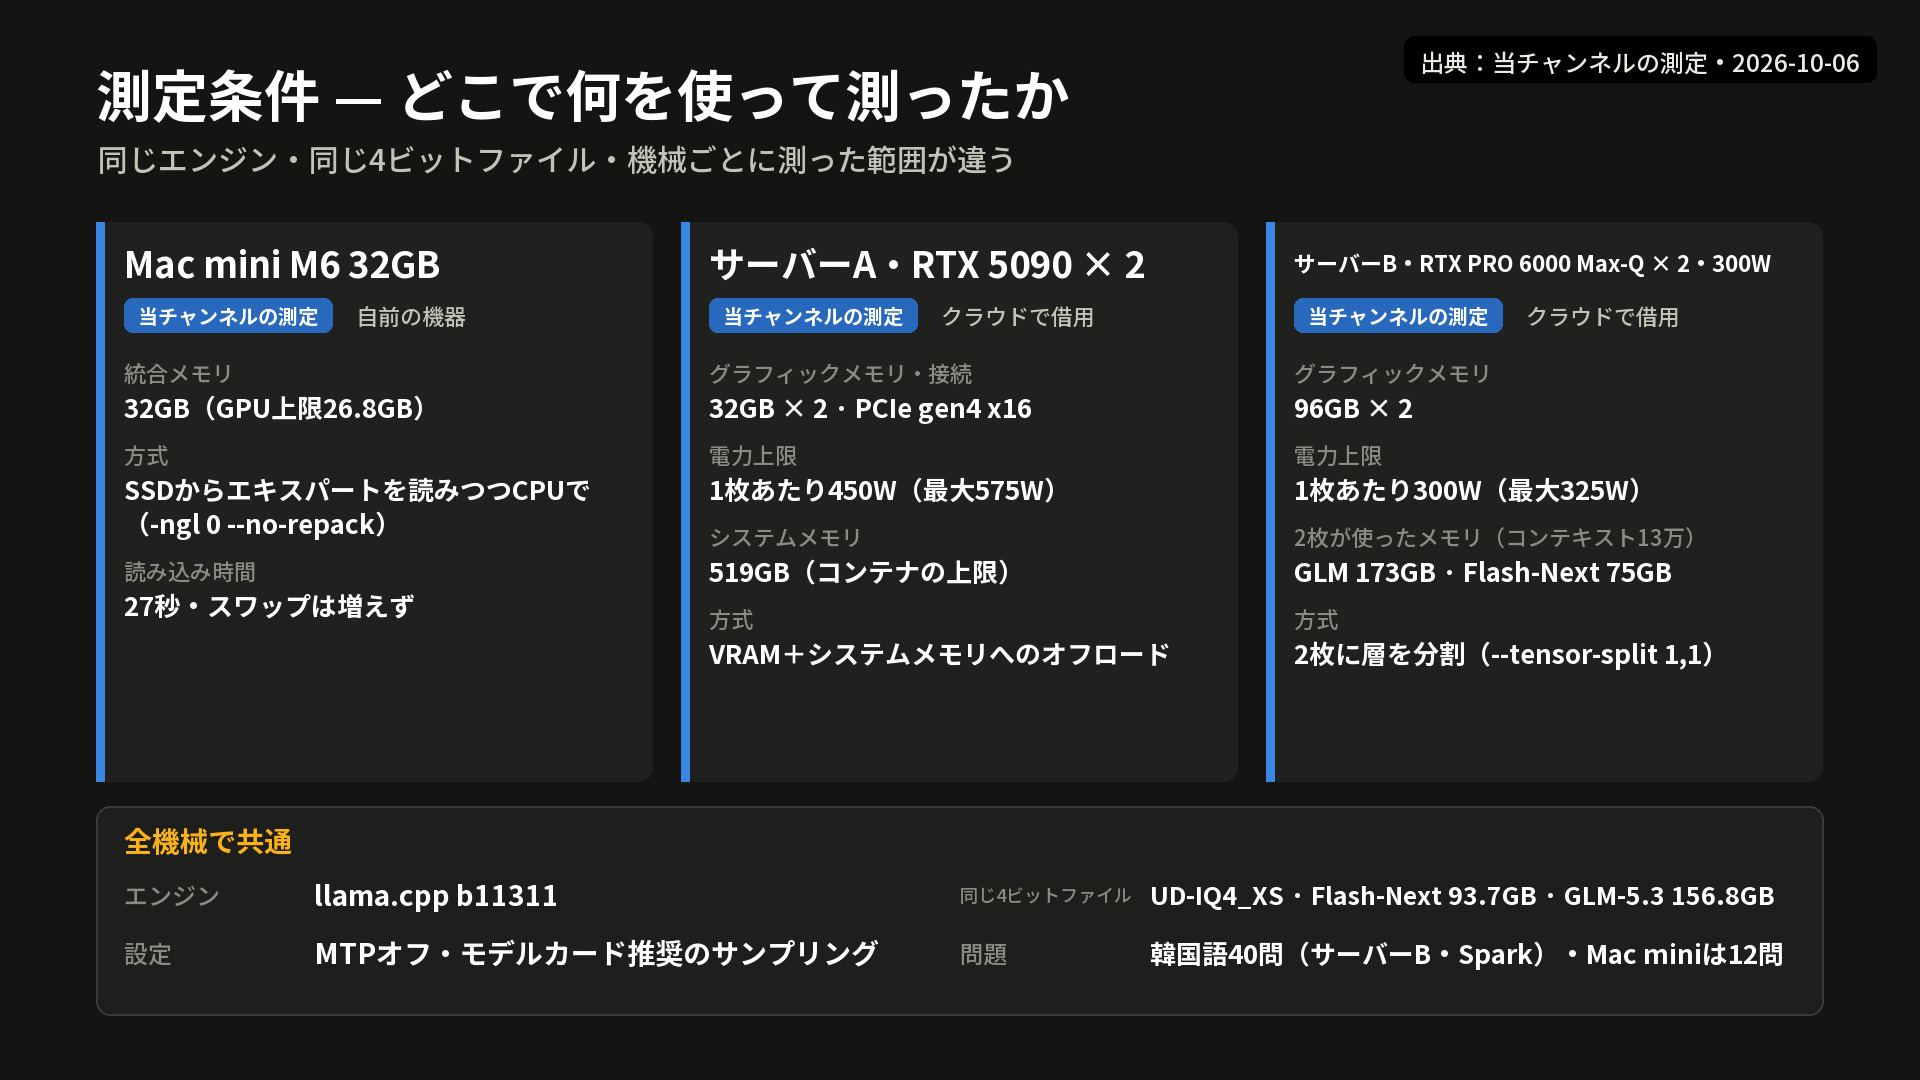
測定は3か所です。Mac miniは自前の機械で、サーバー2台はクラウドで借りました。最初の投稿ではRTX 5090を8枚使って測ると言いましたが、レンタル料金と構成を見直してRTX PRO 6000 Max-Qを2枚に変更しました。同じBlackwellチップで、ファイル、エンジン、問題は変わりません。5090 2枚にシステムメモリを組み合わせた構成も別に測りました。
2つのモデルと測定条件
GLM-5.3 Flashは全体3,200億個のうち180億個が稼働し、4ビットファイルは156.8GBです。Qwen 3.8 Flash-Nextは1,250億個のうち60億個、93.7GBで、実験的なプレビューです。どちらも同じ4ビット(UD-IQ4_XS、unsloth)に揃え、llama.cppビルド11311、MTPオフ、サンプリングは各モデルカードの推奨値、思考はGLMがmax、Flash-Nextがxhighです。
自分の機器で動くか(計算)
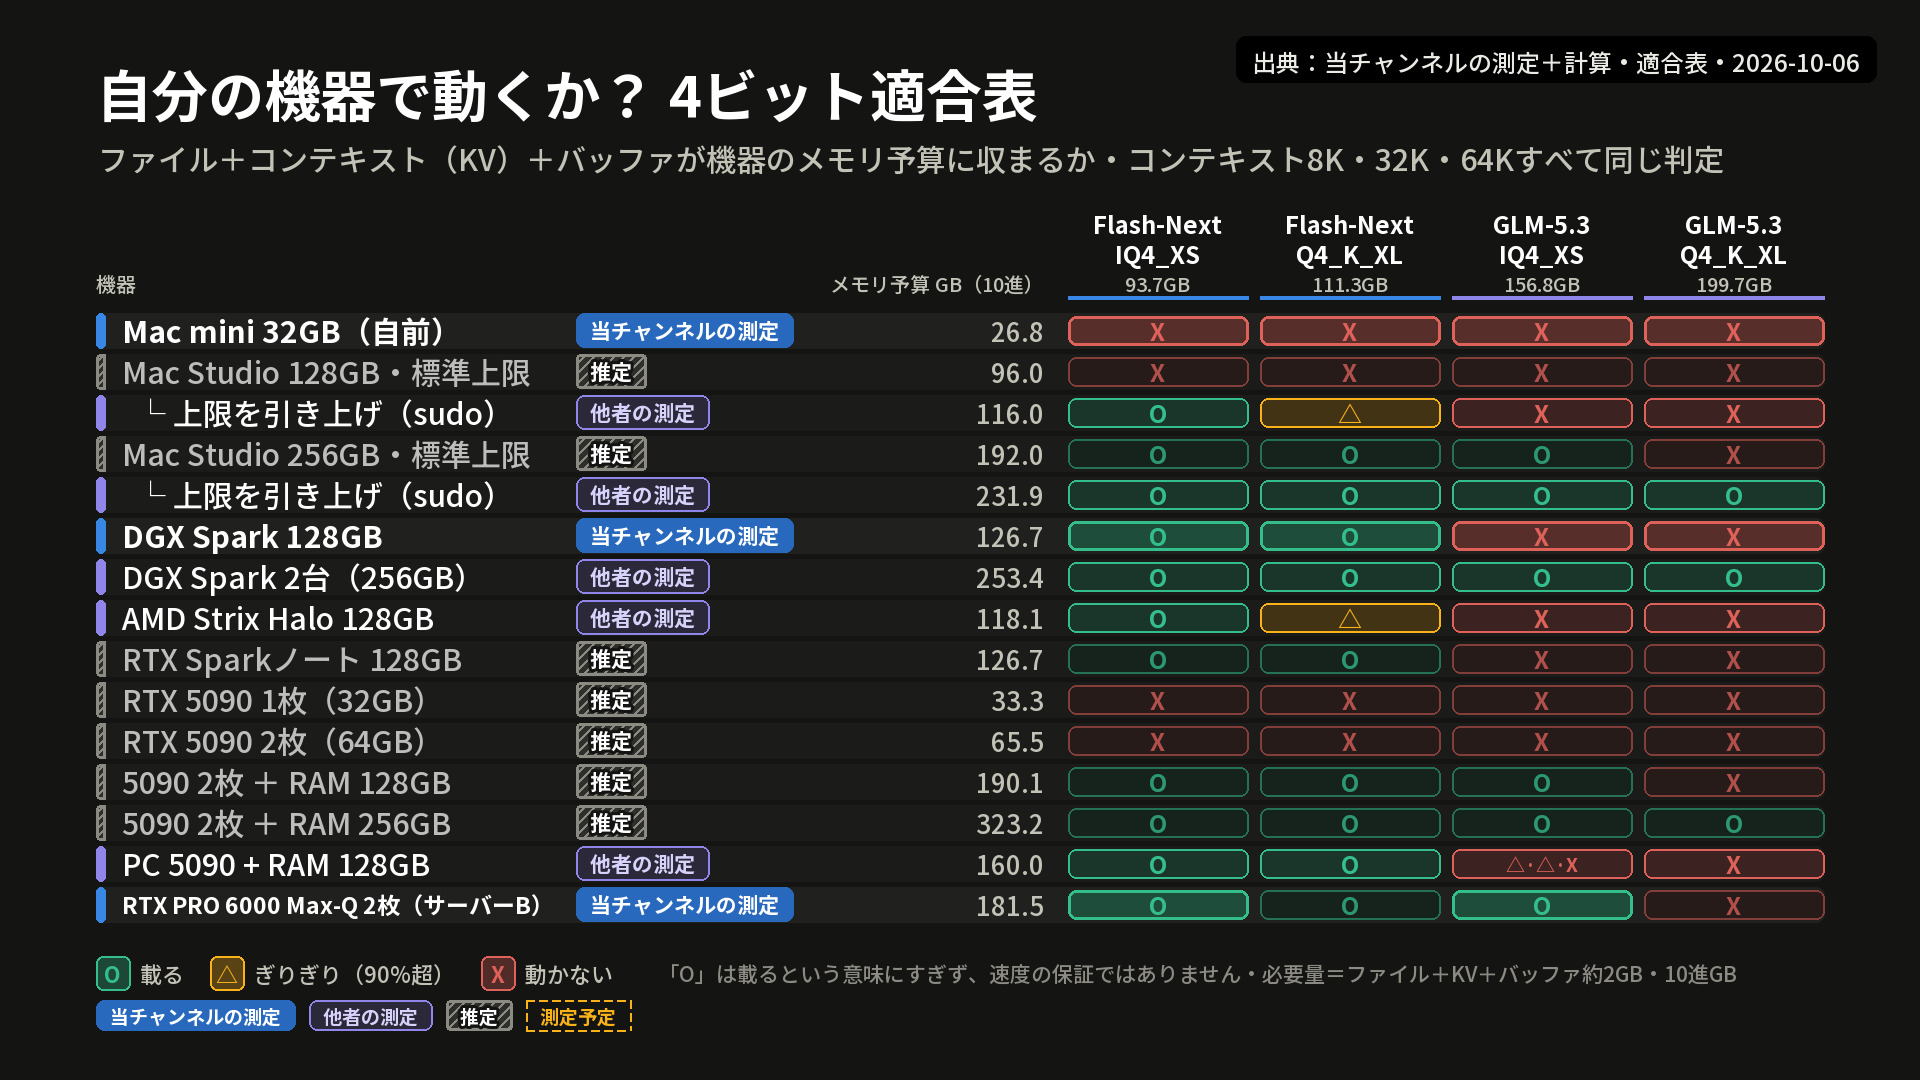
ファイルサイズに会話記憶領域(KV)とバッファを足した計算で、濃いセルは実際に載せたもの、薄いセルは計算や他者の測定です。Mac miniは16GB、24GB、32GBのいずれも両モデルが動きません。128GB級のうち、DGX SparkはFlash-Nextが載り、Mac Studio 128GBはメモリ上限を引き上げる必要があります。GLMは256GB級からで、5090は1〜2枚だとシステムメモリがさらに必要で、64GBの機械はどちらも動きません。表のOは載るという意味にすぎず、速度を保証するものではありません。
Mac mini 32GBでの実測
GPU上限は26.8GB、ファイルは93.7GBです。最初の方式はスワップが12.4GBを超えて自動停止し、CPUがSSD上のファイルを直接読む方式に変えると27秒で起動し、スワップは増えませんでした。回答を書く速度は毎秒5.7トークン、質問を読む速度は毎秒14.8トークンです。短い韓国語12問は1問あたり中央値1.1分かかり、思考を減らした設定のため、サーバーのスコアとは比べていません。GLMも同じ方式ならもっと遅いと見ていますが、測った値ではありません。
サーバーB:RTX PRO 6000 Max-Q 2枚(300W)
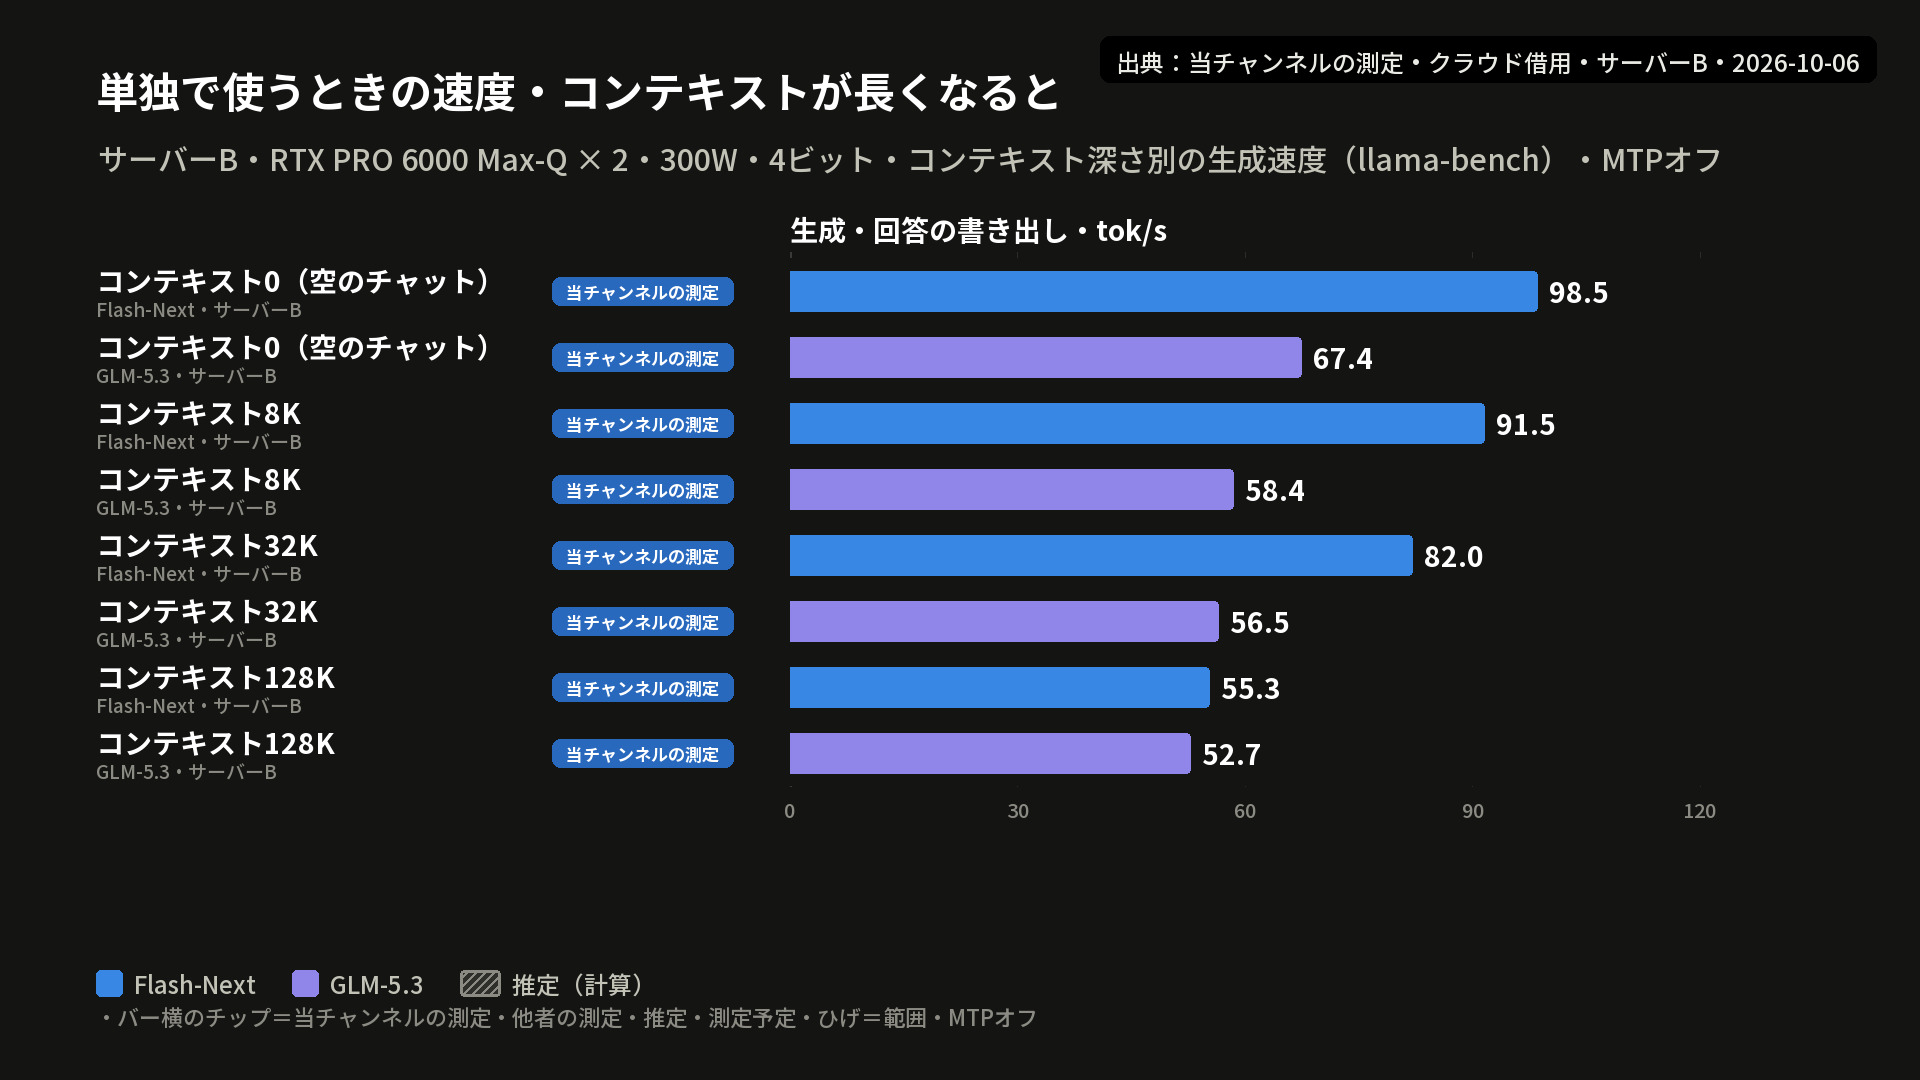
コンテキスト13万トークン、8人同時の設定で、2枚はGLMで173GB、Flash-Nextで75GBを使いました。
| 条件 | Flash-Next | GLM-5.3 |
|---|---|---|
| 1人、空のコンテキスト (tok/s) | 98.5 | 67.4 |
| コンテキスト8K | 91.5 | 58.4 |
| コンテキスト32K | 82.0 | 56.5 |
| コンテキスト128K | 55.3 | 52.7 |
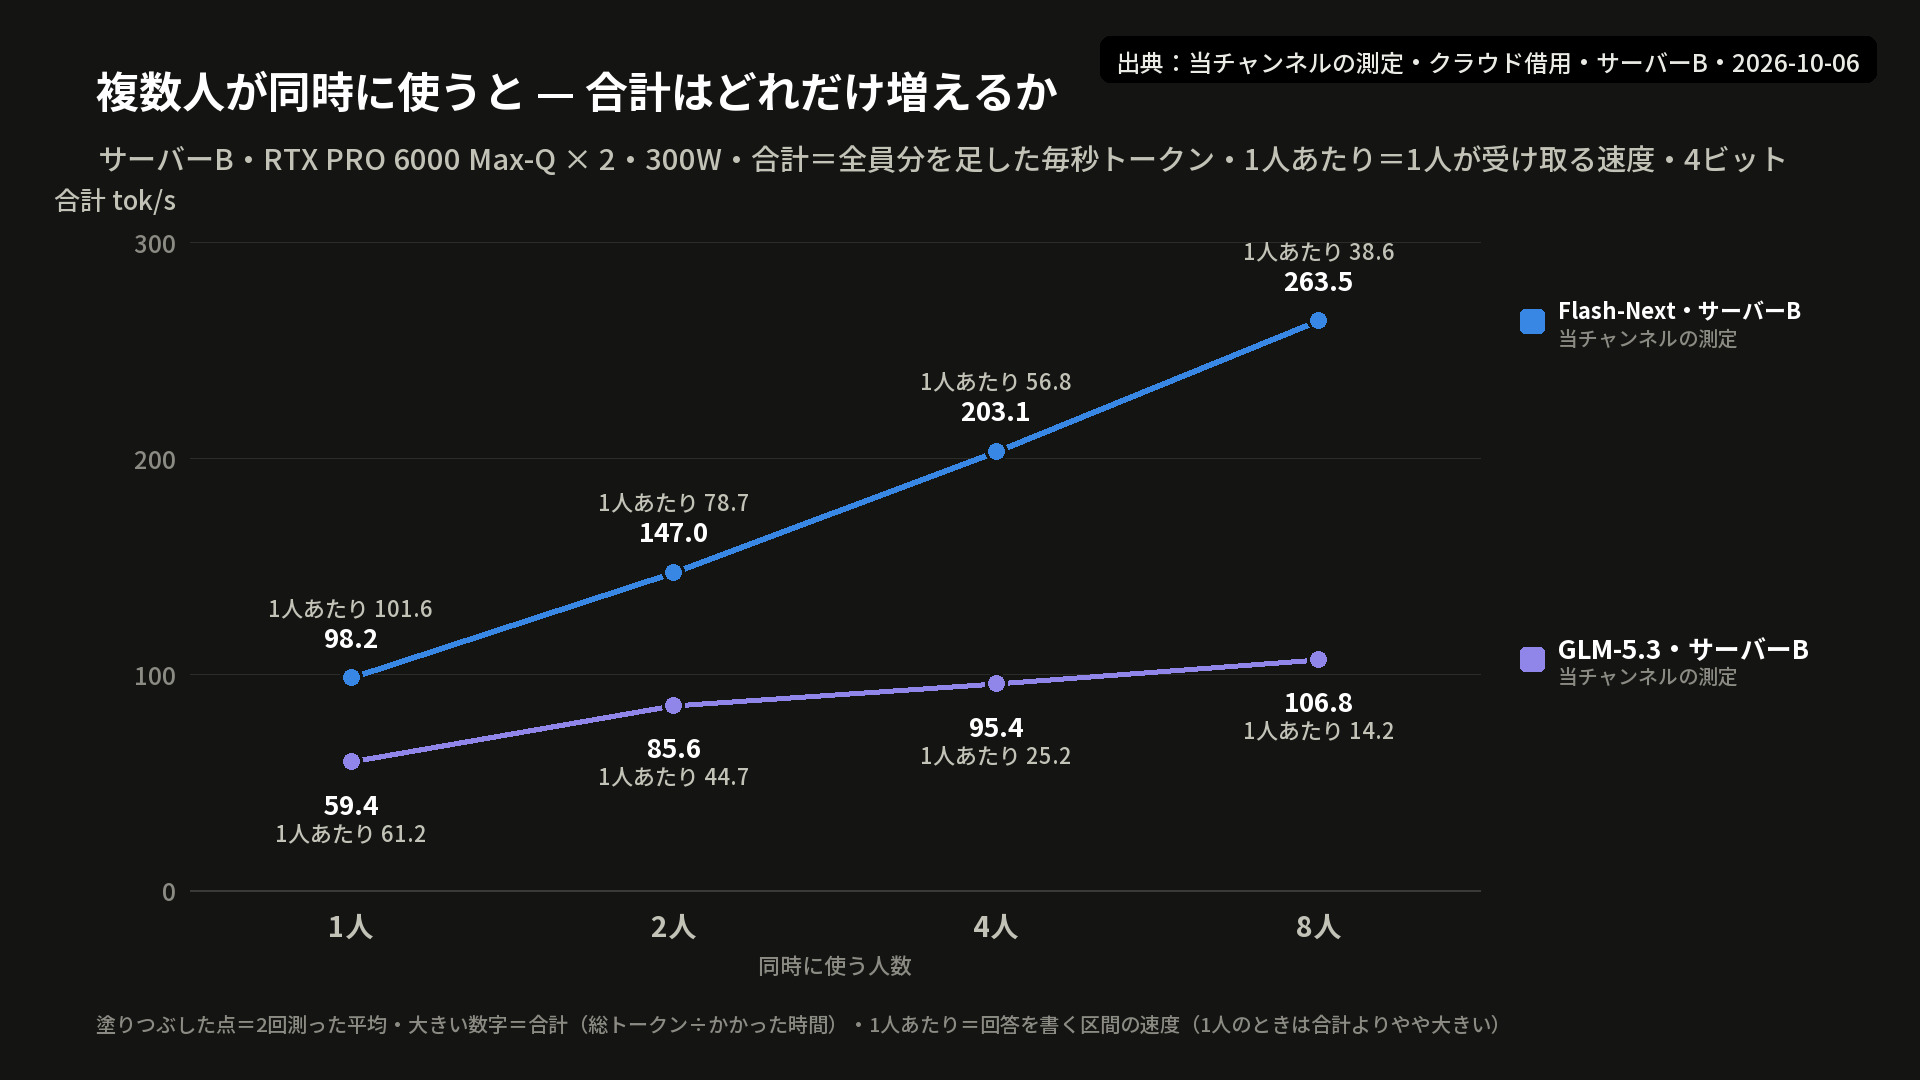
| 8人同時 合計 / 1人あたり | 263.5 / 38.6 | 106.8 / 14.2 |
同時に使う人数を増やすと、合計は1人、2人、4人、8人でFlash-Nextが毎秒98.2、147.0、203.1、263.5トークン、GLMが59.4、85.6、95.4、106.8トークンになりました(2回測った平均)。
同じ40問(当チャンネルの測定+AI判定)
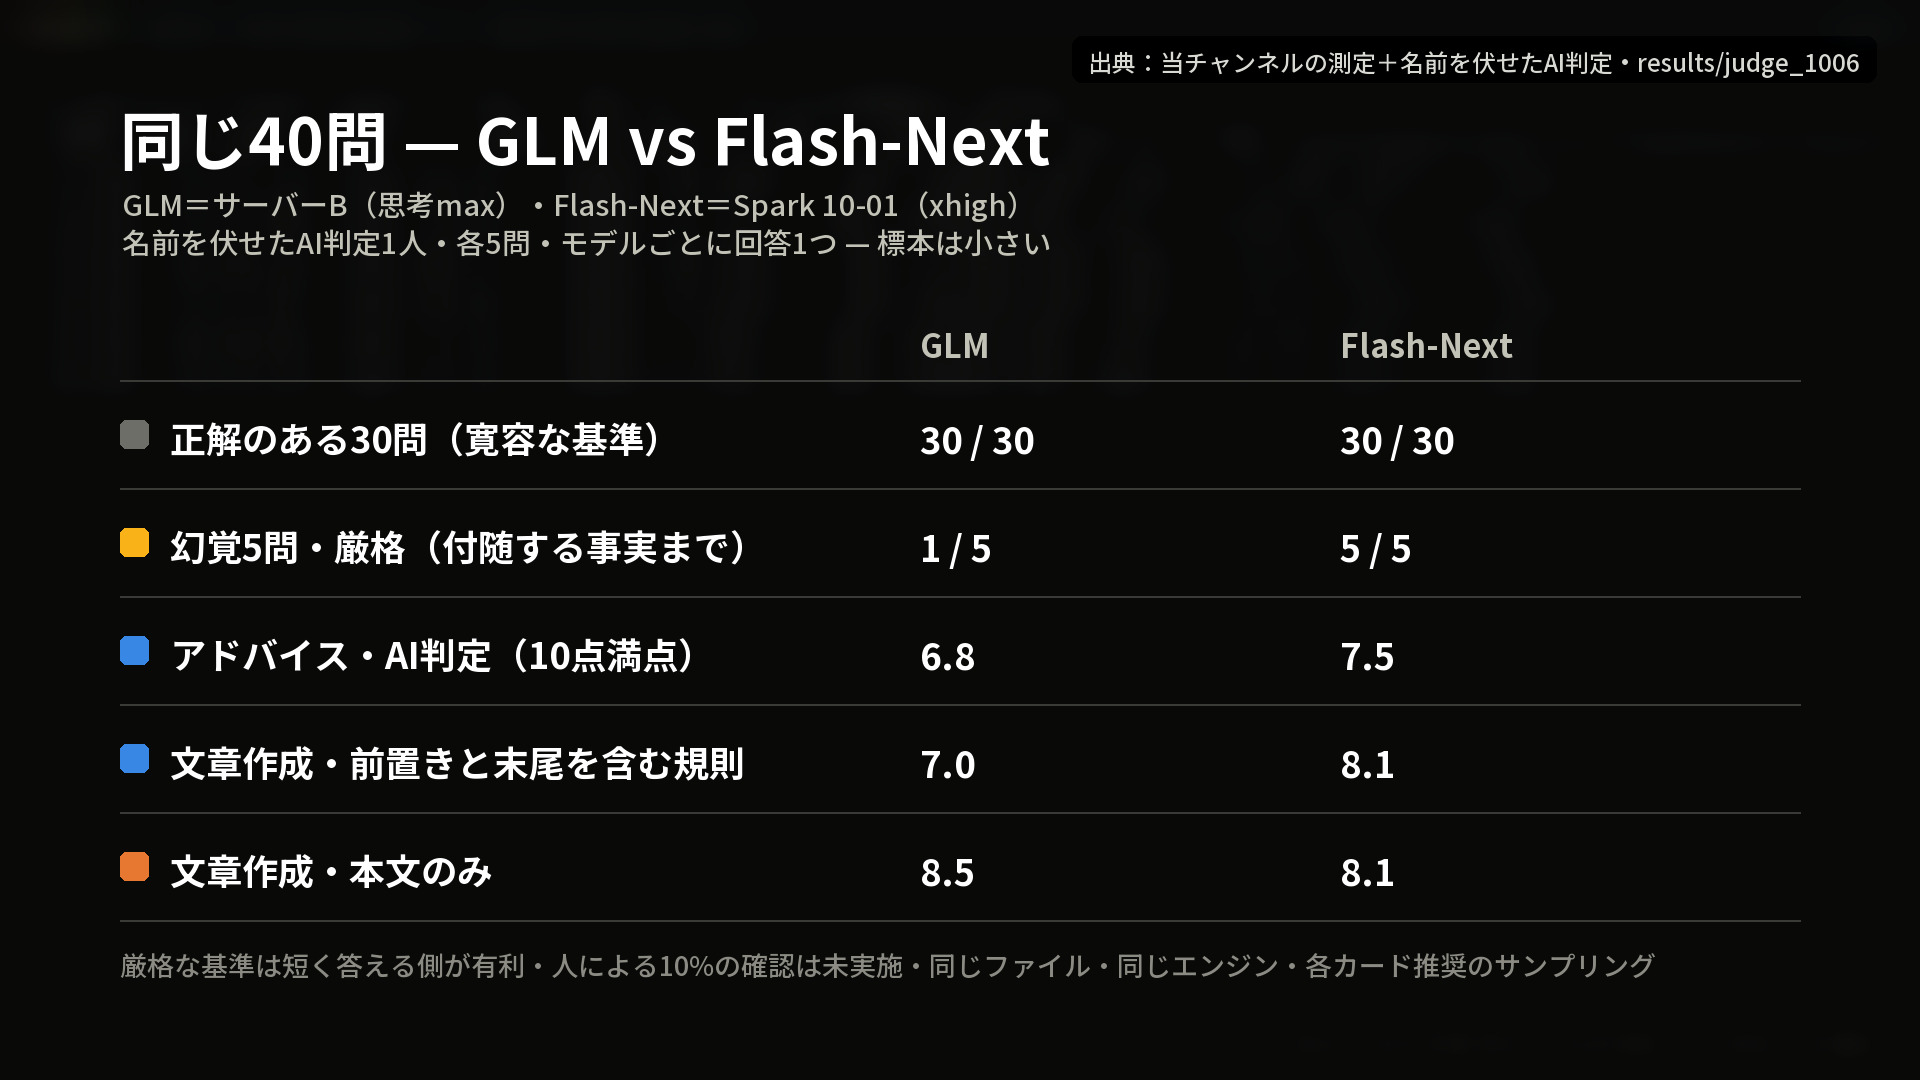
GLMはサーバーBで、Flash-Nextは10月1日にDGX Sparkで解き、課題ごとに5問です。機械が違っても同じ点数になるという前提は、サーバーで解き直して確認できていません。たとえばt4_18では、GLMが正解のあとに「鉄原邑ドルモリ」と付け足しましたが、公式の住所は東松邑です。Flash-Nextは短く答えて付け足した主張がほとんどなく、そのため厳しい基準は短く答える側に有利です。
| 項目 | GLM | Flash-Next |
|---|---|---|
| 正解のある30問(寛容な基準) | 30 / 30 | 30 / 30 |
| 幻覚5問のうち合格、厳格(余計な事実まで) | 1 / 5 | 5 / 5 |
| アドバイス(名前を伏せたAI判定10点、2回平均) | 6.8 | 7.5 |
| 文章作成(前書き・後書きを含む規則) | 7.0 | 8.1 |
| 文章作成(本文のみ) | 8.5 | 8.1 |
| 思考トークンの中央値 | 439 | 680 |
判定者は1人、各5問、モデルあたり回答1つで、人による確認はしていないため、サンプルは小さいです。
RTX 5090 2枚+システムメモリ、そのほかの機器
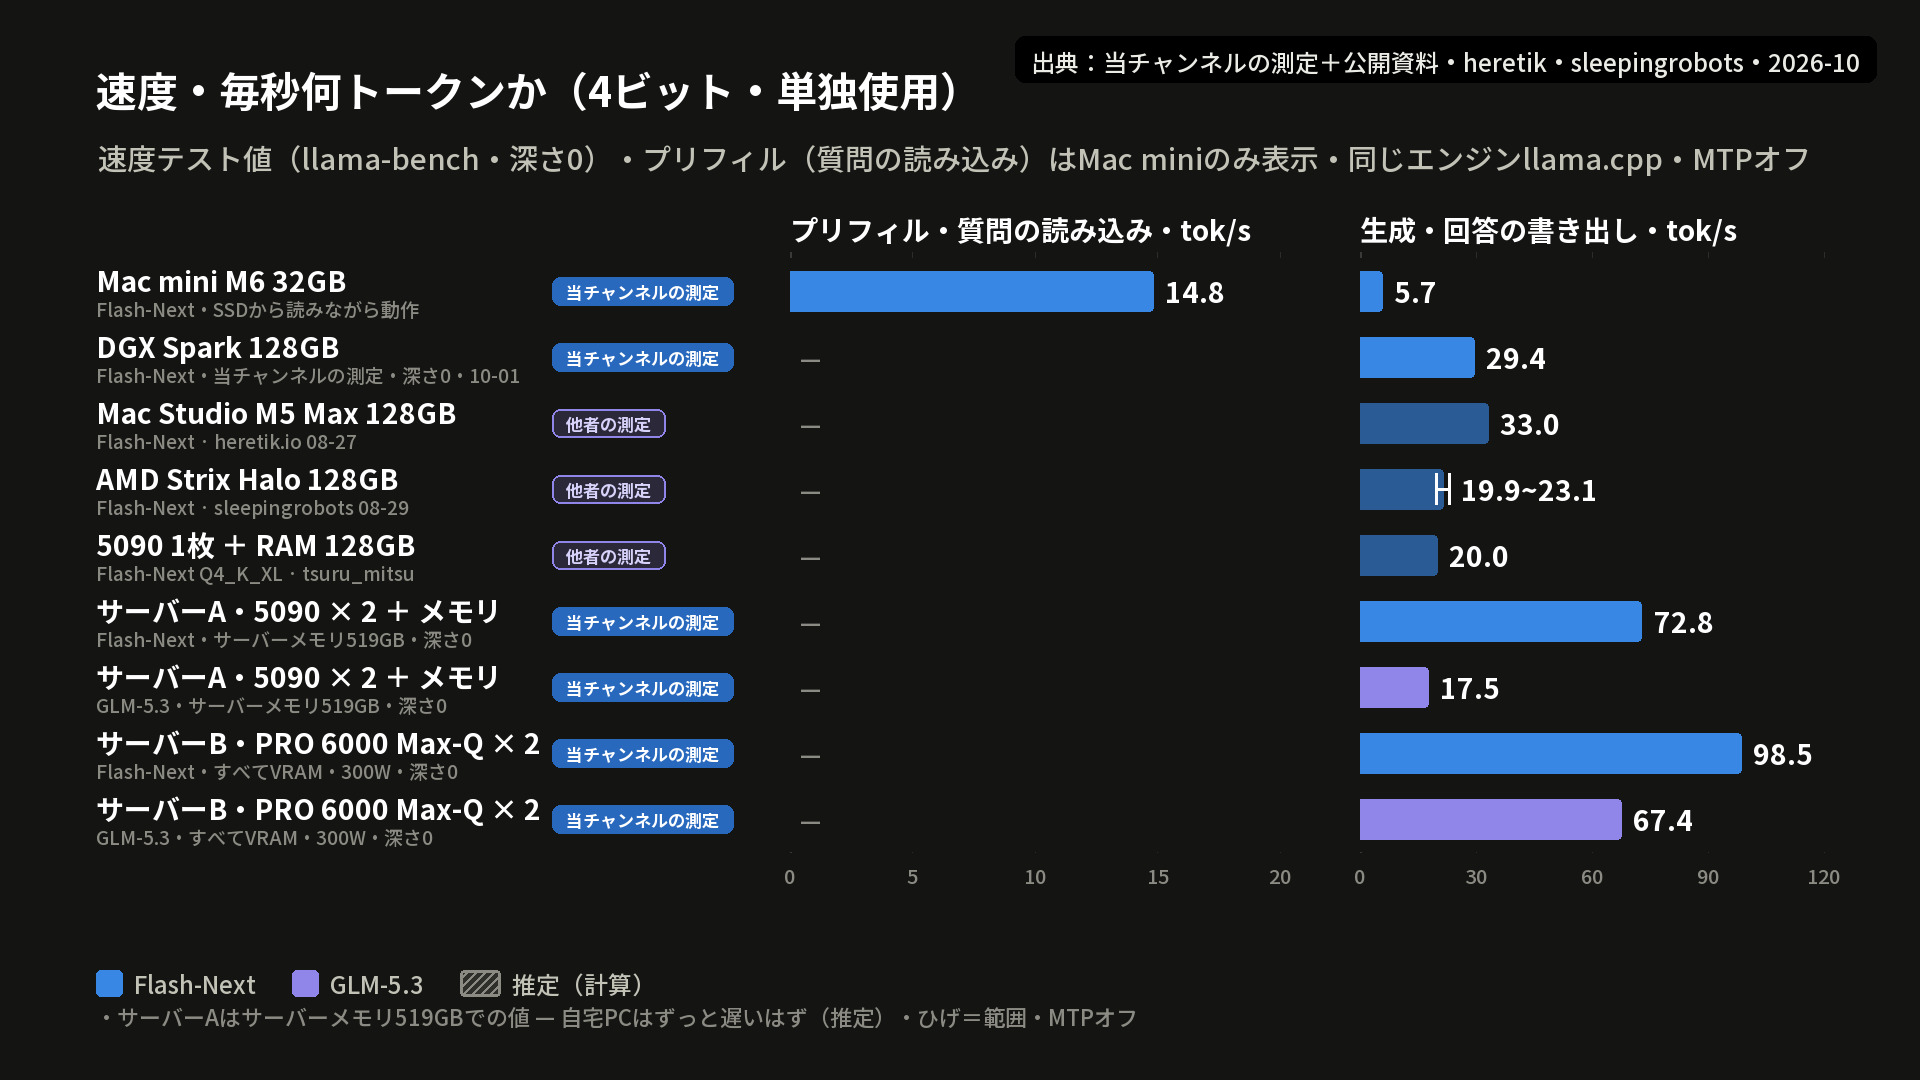
借りたサーバーAはコンテナが使えるシステムメモリの上限が519GBあり、自宅向けに買う構成よりずっと大きいです。エキスパートの一部をメモリで動かし、Flash-Nextは毎秒72.8トークン、GLMは17.5トークンです。このサーバーのメモリ読み出し帯域は毎秒610GBで、自宅のコンピューターは8〜10分の1程度のため、ずっと遅くなると見られますが、測った値ではなく推定です。
| 機器(1人、回答を書く tok/s) | Flash-Next | GLM-5.3 | 区分 |
|---|---|---|---|
| Mac mini M6 32GB(SSDから読みながら) | 5.7 | ダウンロードせず | 当チャンネルの測定 |
| DGX Spark 128GB(10-01) | 29.4 | 載らない | 当チャンネルの測定 |
| サーバーA:5090 2枚+メモリ519GB | 72.8 | 17.5 | 当チャンネルの測定 |
| サーバーB:PRO 6000 Max-Q 2枚 | 98.5 | 67.4 | 当チャンネルの測定 |
| Mac Studio M5 Max 128GB | 33.0 | 載らない | 他者の測定(heretik.io、08-27) |
| AMD Strix Halo 128GB | 約20〜23 | - | 他者の測定(sleepingrobots、08-29) |
DGX Sparkの値は速度テストの値で、8人の合計は約66トークンです。256GBのMacでのGLM 59〜91トークンは投機的デコーディングをオンにした値で比較できず、RTX Sparkはまだ発売されていないと動画は述べています。
価格と動画のまとめ(2026-10-01時点)
動画に示された価格は、DGX Spark 128GBが950万ウォン(韓国のDanawa)、RTX 5090カードが825万ウォンから(2枚なら1,650万ウォン以上)、Mac Studio 256GBが1,629万ウォン(Apple Koreaの構成から計算)で、いずれも韓国での価格です。メモリ128GB、マザーボード、電源の価格は確認できませんでした。この価格を前提に、動画は次のように区分しています。Mac mini 32GBでは2モデルとも載らず、27B級が現実的な範囲です。950万ウォン前後の予算では、Flash-Nextだけを載せるDGX SparkやMac Studio 128GB、GLMまで載せる256GB級のMac Studioが該当します。ゲームや画像生成を兼ねるPCは、5090にメモリを足してFlash-Nextだけを遅く動かせます。300万ウォン前後なら中古の3090で27B級です。この記事は購入や機器選びを勧めるものではありません。
限界・基準日
- 韓国語40問は、判定者1人、各5問、モデルあたり回答1つで、人による確認はありません。GLMとFlash-Nextは異なる機械で解きました。
- Mac miniにはGLMの値がなく、5090 2枚の値はメモリがずっと速いサーバーで出たため、自宅PCはもっと遅いと推定しています。
- 他者の測定は条件が異なるため、直接比較しません。Qwen側は実験的なプレビューです。
- 基準日:測定2026-10-06、動画公開2026-10-07、価格2026-10-01(動画公開日時点の値で、その後変わっている可能性があります)。