Flint(フリント)Mac mini 32GB実測、5エンジン毎秒52.4〜76.0トークンとQwen比較
投稿日 動画公開
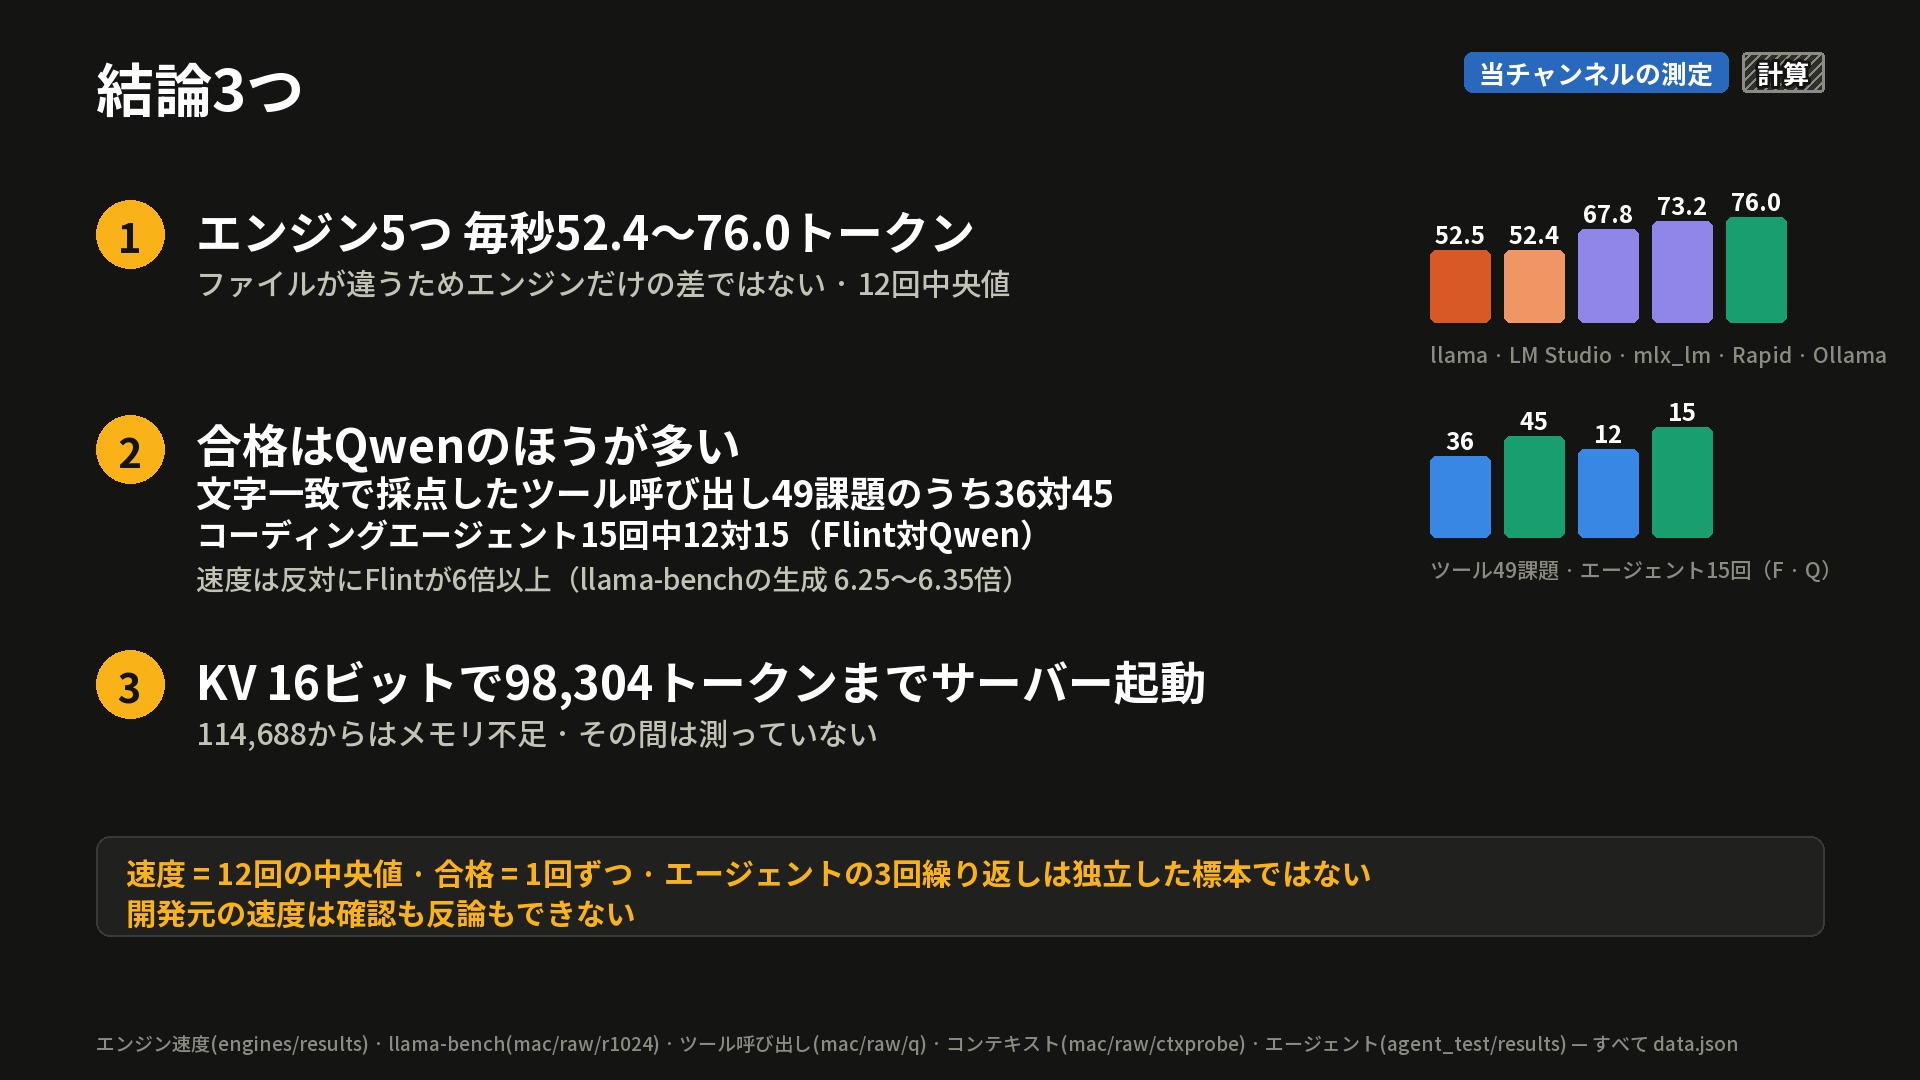
FlintをMac mini M6 32GBで5つのエンジンで測ると毎秒52.4〜76.0トークン。ファイルが違うためエンジンだけの差ではなく、コーディングエージェントの合格はQwen 15対Flint 12でした。
Flint(フリント)をMac mini M6 32GBで5つのエンジンを使って実際に動かして測ったところ、生成速度の中央値は毎秒52.4〜76.0トークンでした。ただしエンジンごとに使ったファイルが違うため、この幅はエンジンだけの差ではありません。同じファイルで比べられる組み合わせはRapid-MLXとmlx_lmの2つだけです。同じコーディングエージェントの課題をQwen 3.8 27Bにも解かせたところ、合格は15回中でQwenが15回、Flintが12回でした。
結論を先に
- 5つのエンジンの速度:毎秒52.4〜76.0トークン(12回の中央値、思考をオンにした状態)。ファイルが違うため、エンジンだけの差ではありません。
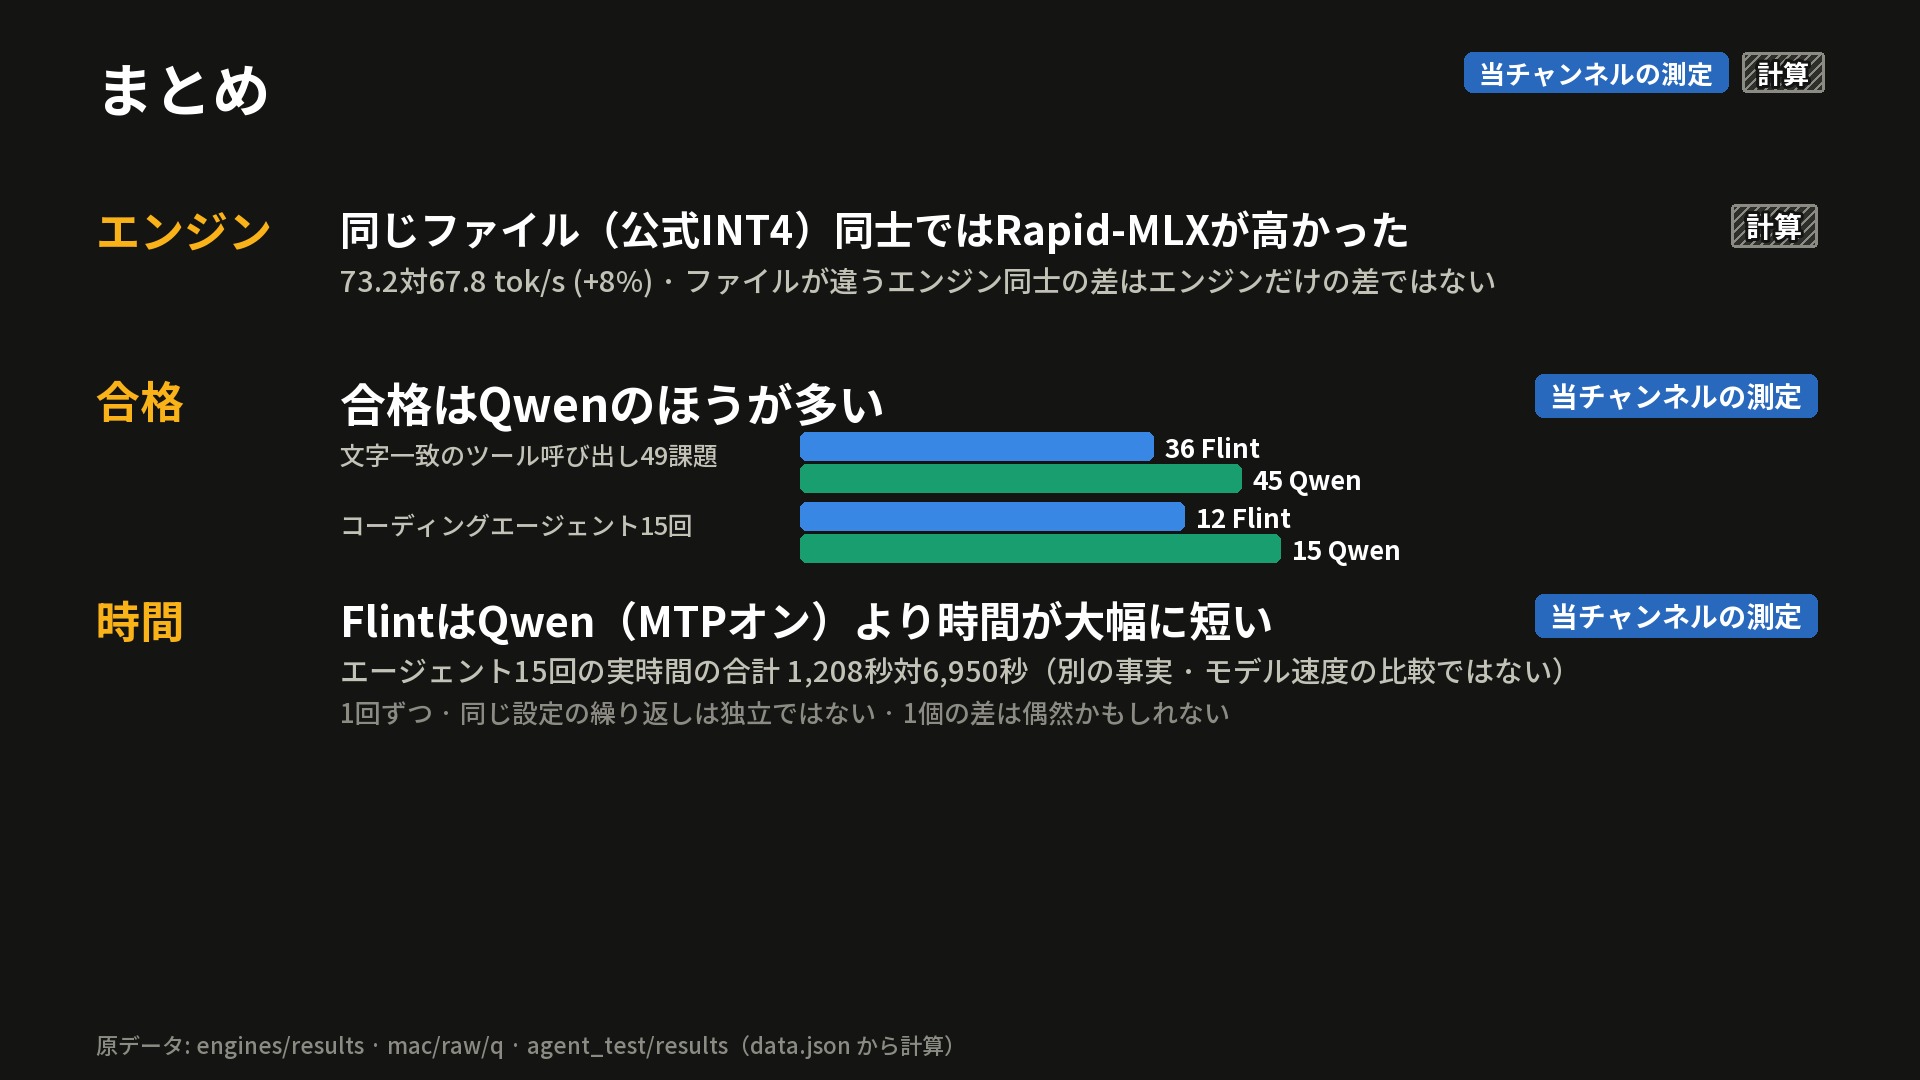
- 合格はQwenのほうが多かった:文字一致で採点したツール呼び出し49課題は36対45(Flint対Qwen)、コーディングエージェントは15回中12対15です。速度は反対で、llama-benchの生成ではFlintがQwenの6倍以上速くなりました。
- コンテキスト:KV 16ビットでは98,304トークンまでサーバーが起動し、114,688トークンでメモリ不足になりました。
この記事の数値の種類
- 当チャンネルの測定:Mac mini M6 32GBで自分たちで測った値です。速度は質問4種を3回ずつ、12回の中央値です。
- 計算・推定:当チャンネルの値を使った算数です(例:約8パーセントの差、6倍以上、フィッシャー検定)。
- 開発元の主張:開発元が示した値で、確認できていません。
- 第三者の報告:ほかの人が書いた値です。
基準日は動画公開日の2026-10-25です。測定は2026-10-24〜25に行いました。
Flintとはどんなモデルか
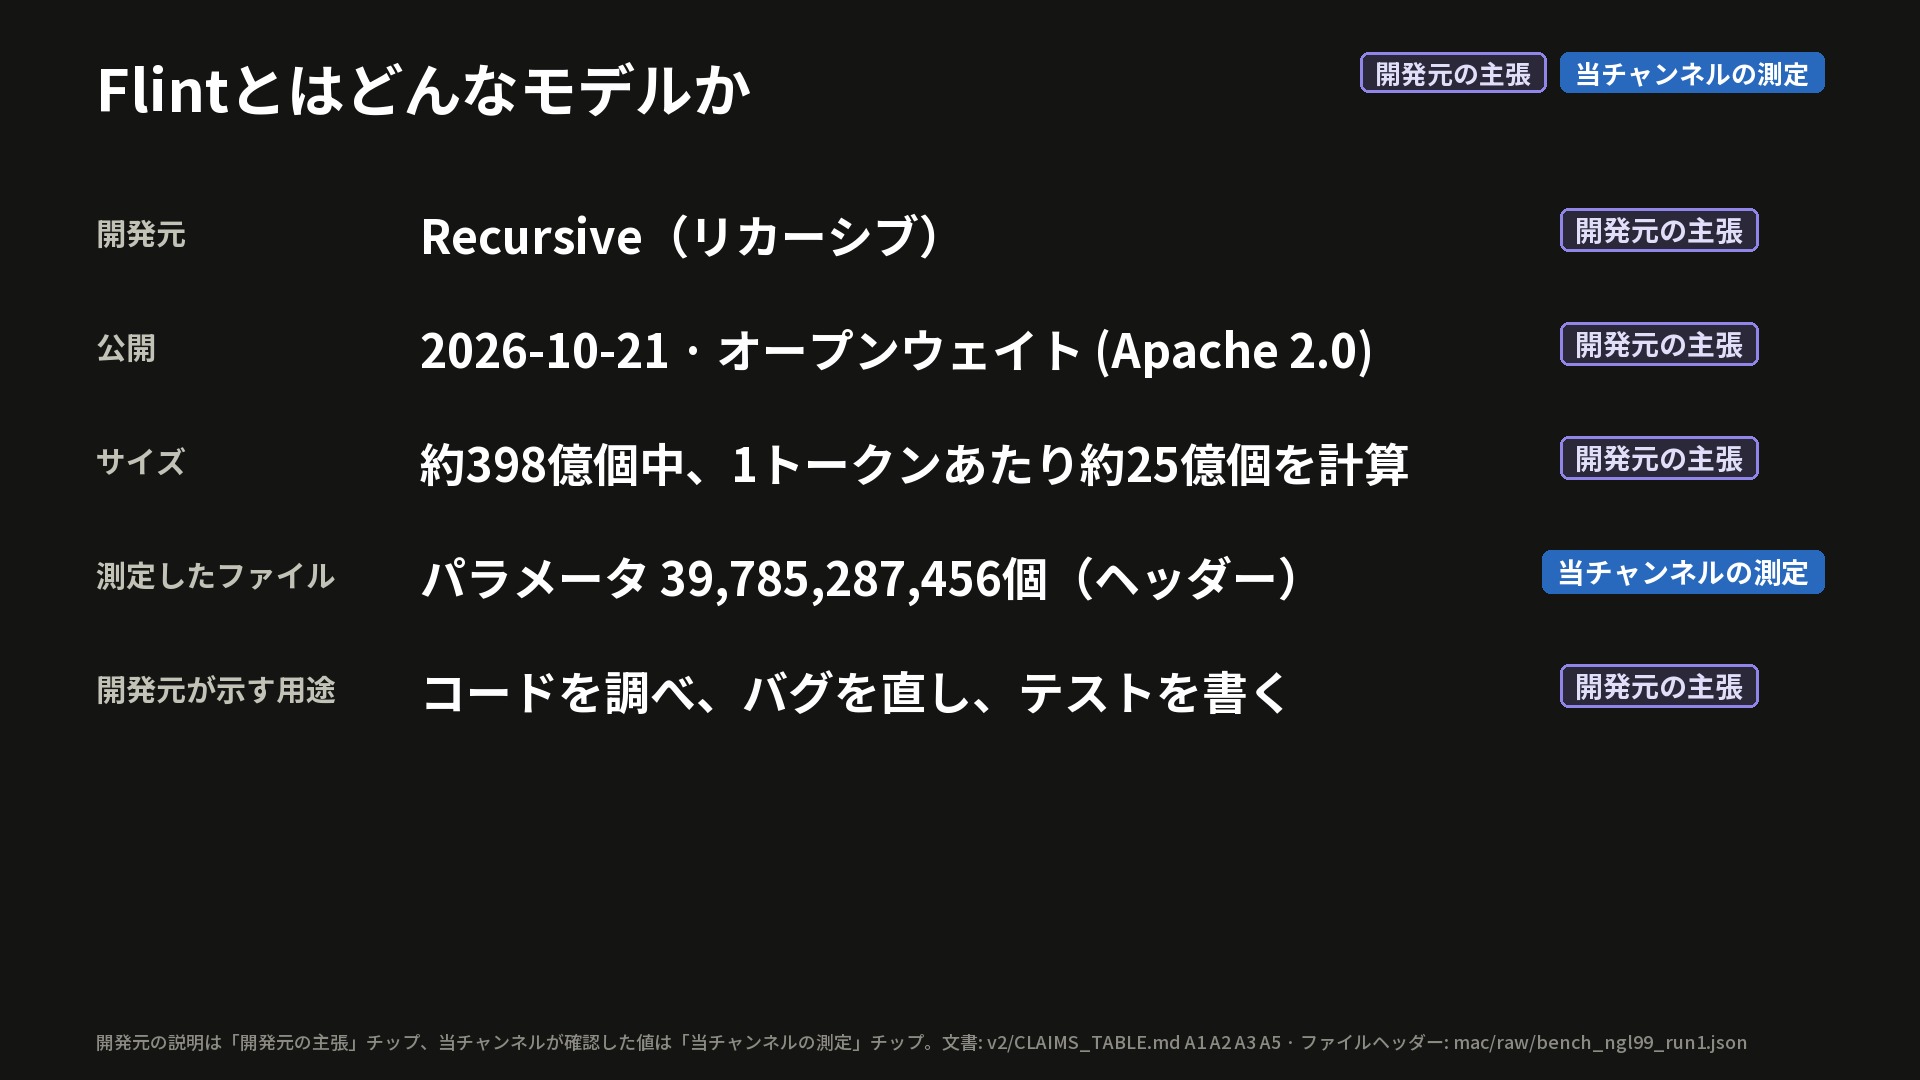
FlintはRecursive(リカーシブ)が2026年10月21日に公開したオープンウェイトのモデルです。開発元の説明によると、全体で約398億個のパラメータのうち、トークンごとに約25億個だけを計算するMoE構造で、コードを調べ、バグを直し、テストを書くコーディングエージェント向けとされています(開発元の主張)。当チャンネルが使ったGGUFファイルのヘッダーにはパラメータ数39,785,287,456個と記載されており、ファイルサイズは23,387,911,136バイトでした(当チャンネルの測定)。
開発元のカードによると、47層のMoE層で、256個の専門家のうち6個と共有専門家1個だけを使います。ただし当チャンネルのGGUFヘッダーでは共有専門家の数が2と記載されていて表記が一致せず、原因は切り分けられませんでした。25億は1トークンを作るときに計算する量にすぎず、メモリには全体が必要なので、2.5Bモデル程度の性能という意味ではありません。
測定条件と限界
- Mac mini M6 32GB、リクエストは1回に1つ、グリーディ(temperature 0、seed 1)、最大256トークン。
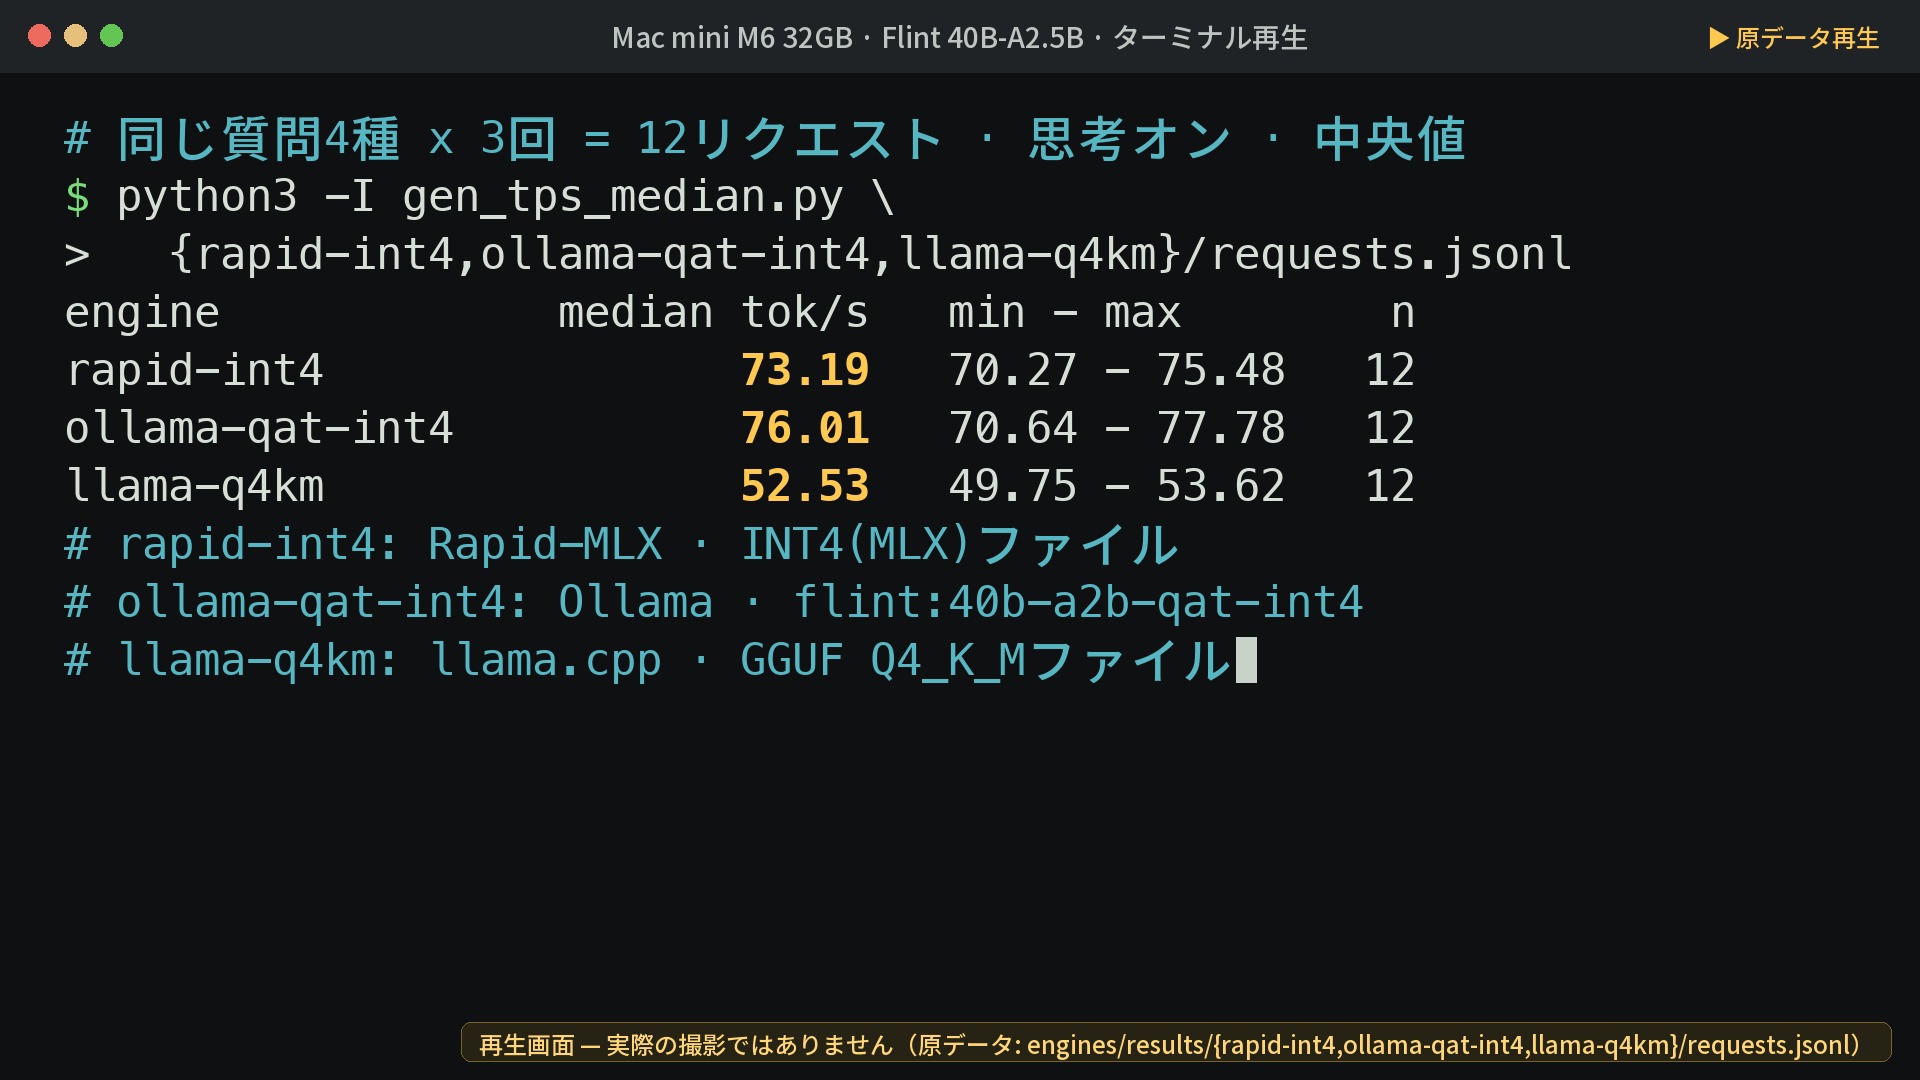
- 質問4種(入力26〜443トークン)を3回ずつ、計12回で、中央値を使いました。
- Flintは思考を長く使うモデルなので思考をオンにしたまま測っており、速度には思考トークンが含まれます。12回すべてで256トークンが思考だけで埋まりました。
- 思考のオフはエンジンによって違いました。Ollamaはオフにでき、オフにすると毎秒79.9トークンで12回すべてで回答が始まりました。Rapid-MLX、mlx_lm、llama.cppはオフにする方法を確認できませんでした。
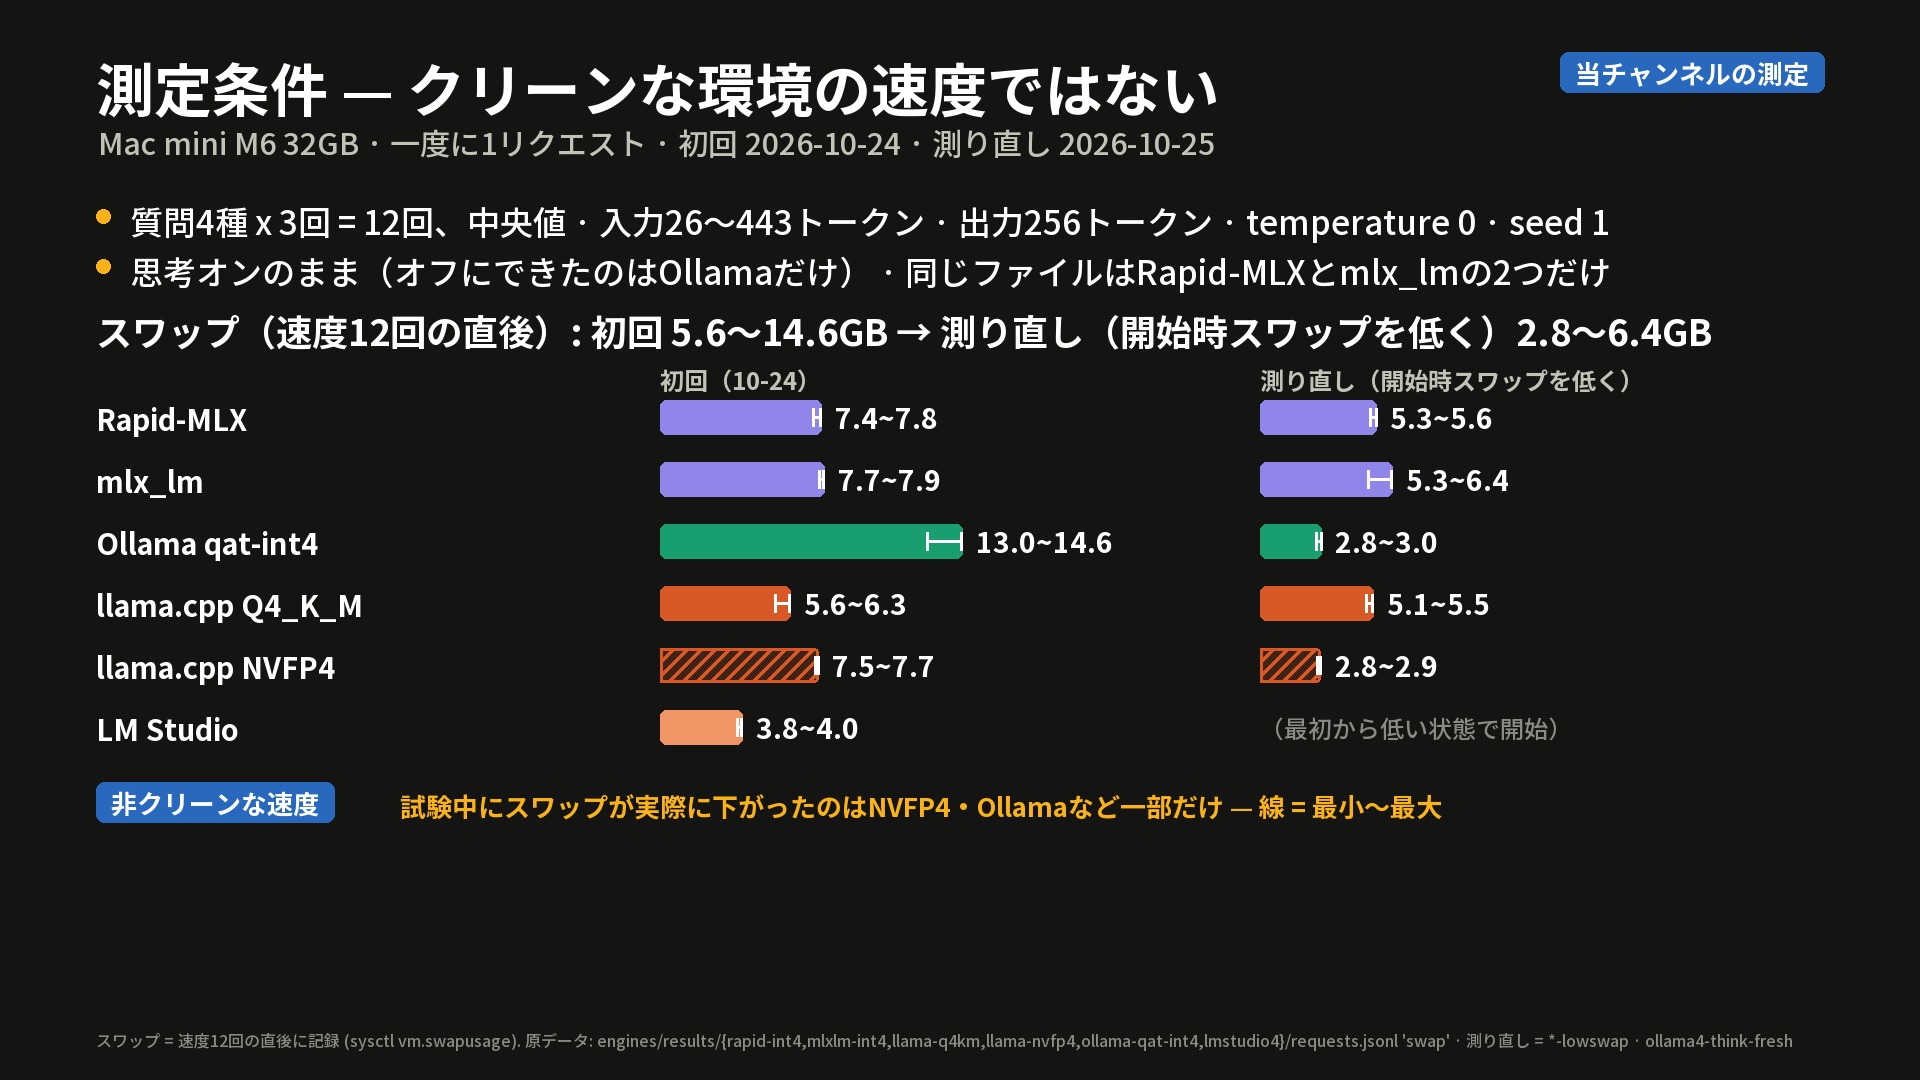
- 速度を測ったときのスワップは最初が5.6〜14.6GiB、開始時のスワップを下げて測り直したときは2.8〜6.4GiBでした。クリーンな環境での速度ではありません(動画の画面ではGBと表記)。
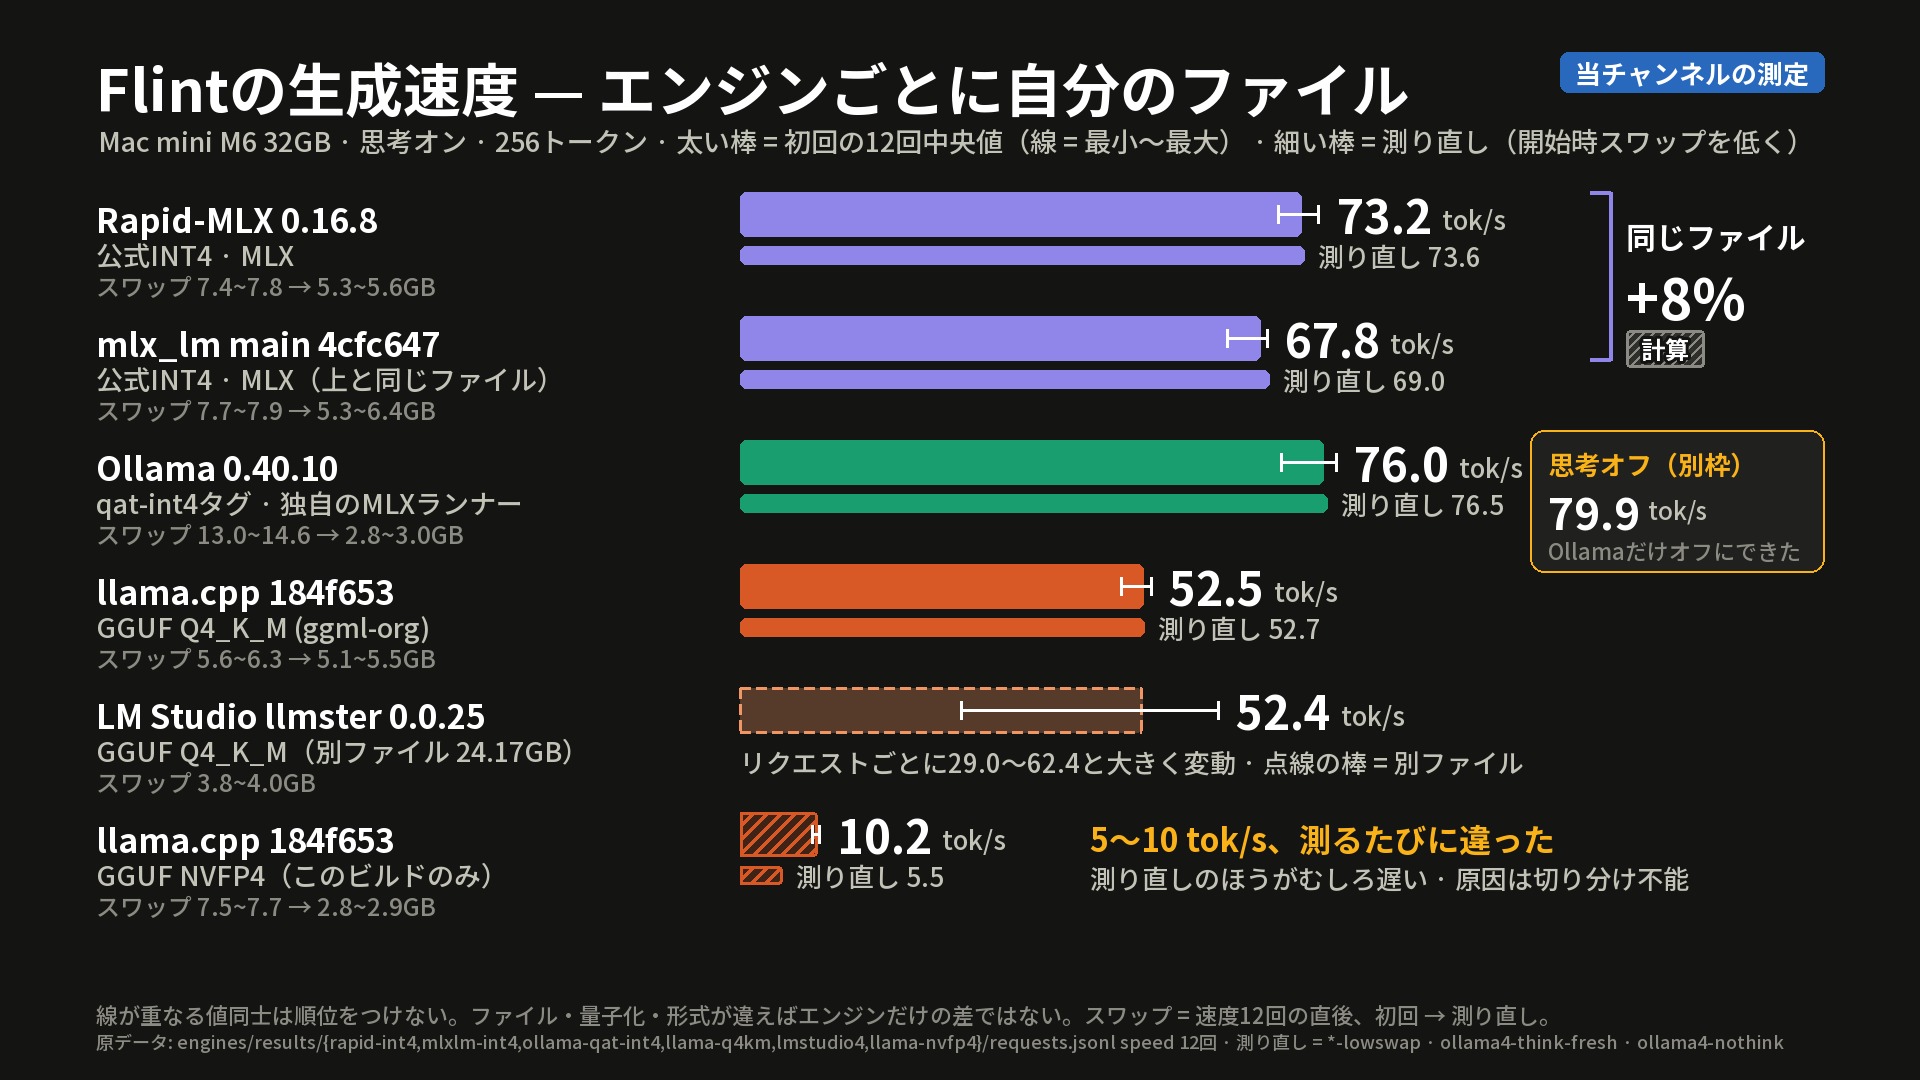
エンジン別の生成速度
当チャンネルの測定です(思考オン、12回の中央値、カッコ内は範囲)。
| エンジン | ファイル | 毎秒トークン |
|---|---|---|
| llama.cpp 184f653 | Q4_K_M GGUF | 52.5(49.8〜53.6) |
| LM Studio(ランタイム llama.cpp 2.64.0) | 別のGGUF | 52.4(29.0〜62.4) |
| mlx_lm main 4cfc647 | 公式INT4 | 67.8(63.6〜68.8) |
| Rapid-MLX 0.16.8 | 同じ公式INT4 | 73.2(70.3〜75.5) |
| Ollama v0.40.10 | flint:40b-a2b-qat-int4 タグ | 76.0(70.6〜77.8) |
- 同じファイルを使ったのはRapid-MLXとmlx_lmだけで、73.2対67.8、約8パーセントの差です(計算)。範囲は重なりませんでした。
- Ollamaはqat-int4タグだけを測っており、このタグが同じ重みかどうかは確認できていません。デフォルトのタグは測っていません。中央値は最も高いですが、範囲はほかのエンジンと重なります。
- LM Studioは別のファイル(24.17GB)で、リクエストごとに29.0〜62.4と大きくばらつきました。
- スワップを下げて測り直しても、Rapid-MLX、mlx_lm、llama.cpp、Ollamaは最初の値と2パーセント以内で近い値でした(Ollamaは76.5)。
- NVFP4のGGUFは最初が10.2、測り直しで5.5と異なったため(原因は切り分けられず)、52.4〜76.0の範囲から除きました。
- 最初のトークンまでの時間(入力約3万3千トークン)は、ファイルが違うので順位はつけず値だけを書くと、Ollama 27.6秒、Rapid-MLX 27.4秒、mlx_lm 27.3秒、llama.cpp 48.2秒、LM Studio 50.5秒です。最初に測ったOllamaの194.5秒は測り直しでは再現せず、原因は切り分けられませんでした。
エンジンの対応状況は、2026-10-24時点のドキュメント上でllama.cpp、Rapid-MLX、Ollama、Unsloth、開発元のエンジンrecが対応とされ、LM Studioはモデル一覧に載っており、mlx_lmはmainバージョンにだけありました。当チャンネルのMacでは5つが動きました。LM Studioはランタイム2.41.0でFlintのチャットテンプレートエラーにより失敗し、2.64.0で読み込めました。
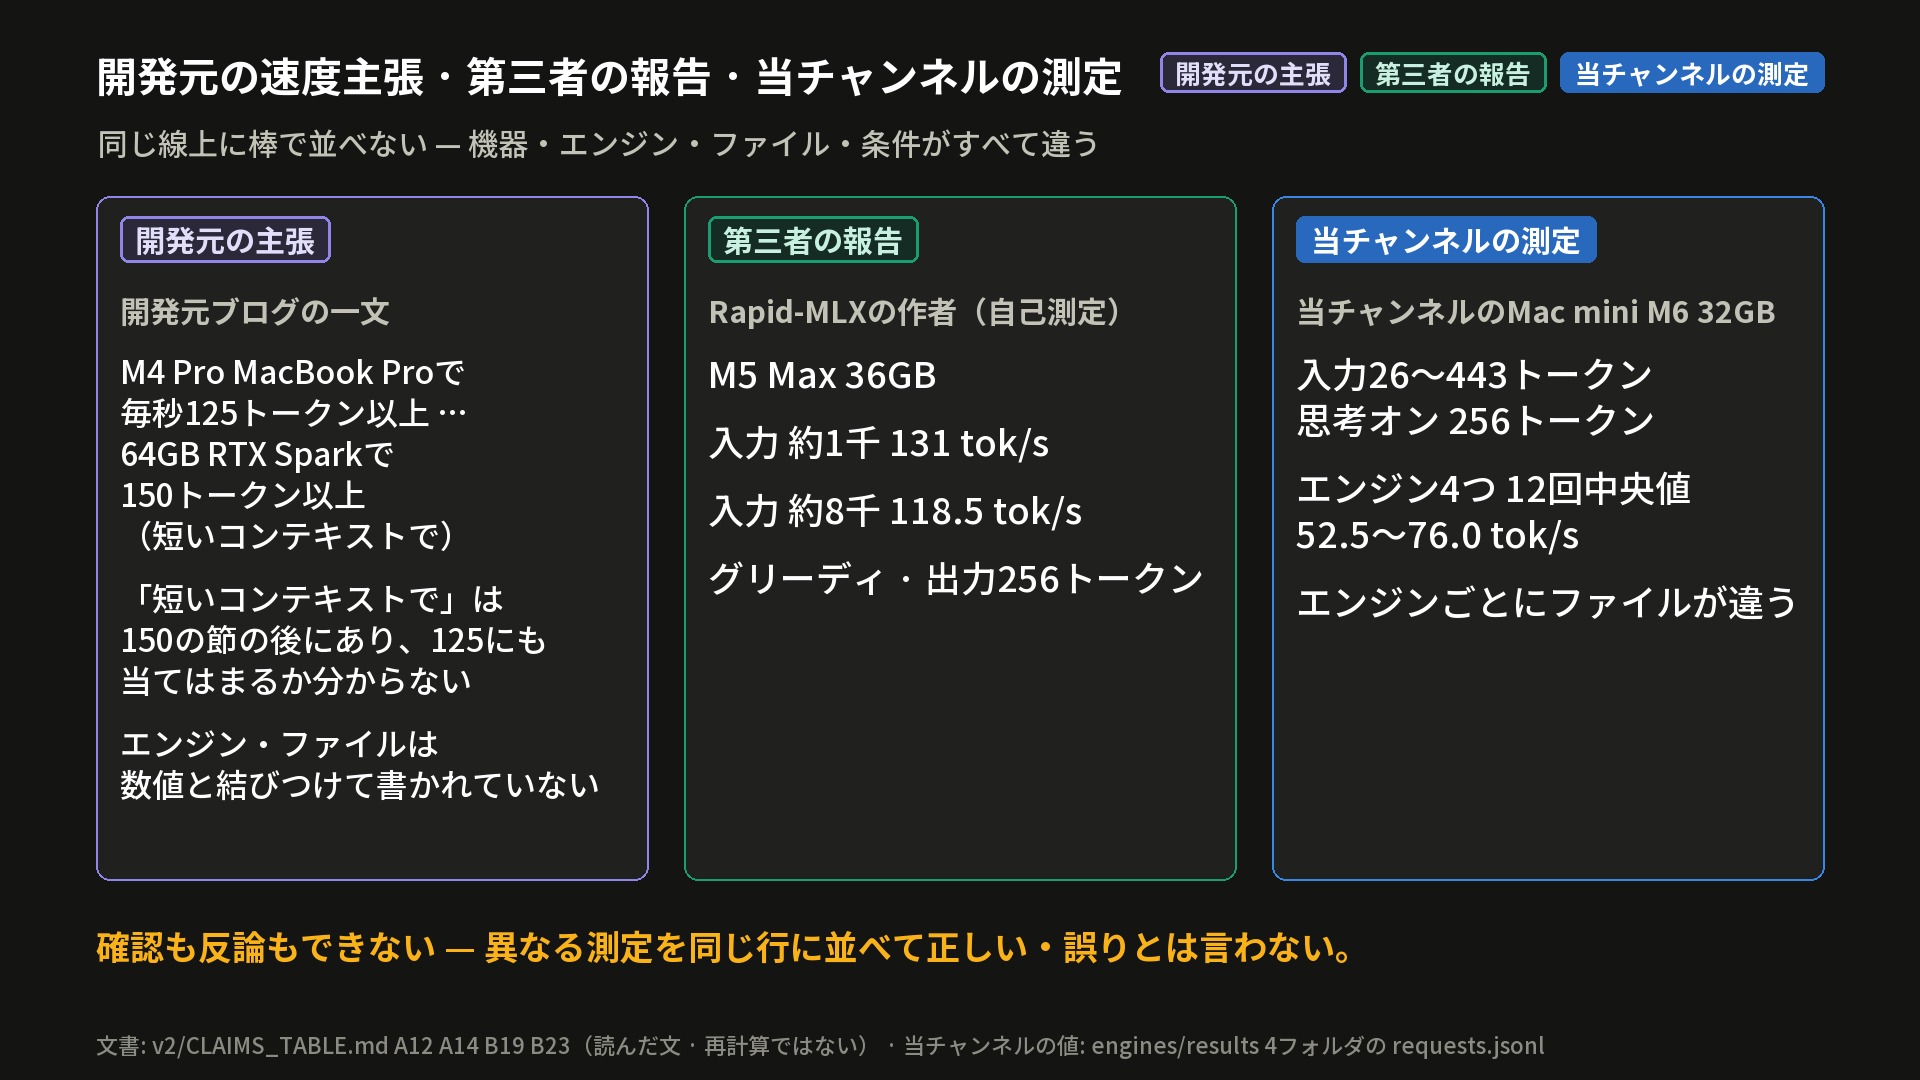
開発元の速度の主張は確認も反論もできませんでした
開発元のブログは、M4 ProのMacBook Proで125トークン以上と64GBのRTX Sparkで150トークン以上を1つの文に書き、最後に「短いコンテキストで」と付けています。この但し書きが125にも当てはまるのかは分からず、どのエンジンとファイルで測ったかは数値と結びつけて書かれていません(開発元の主張)。Rapid-MLXの作者は、M5 Max 36GBで入力約1千トークンのとき131トークン、約8千トークンのとき118.5トークンと書いています(第三者の報告、グリーディ、出力256トークン)。
当チャンネルの質問は入力が26〜443トークンと短いものの、機器がM6 32GBで異なり、エンジンとファイルも違うため、どちらの数値も確認も反論もできません。
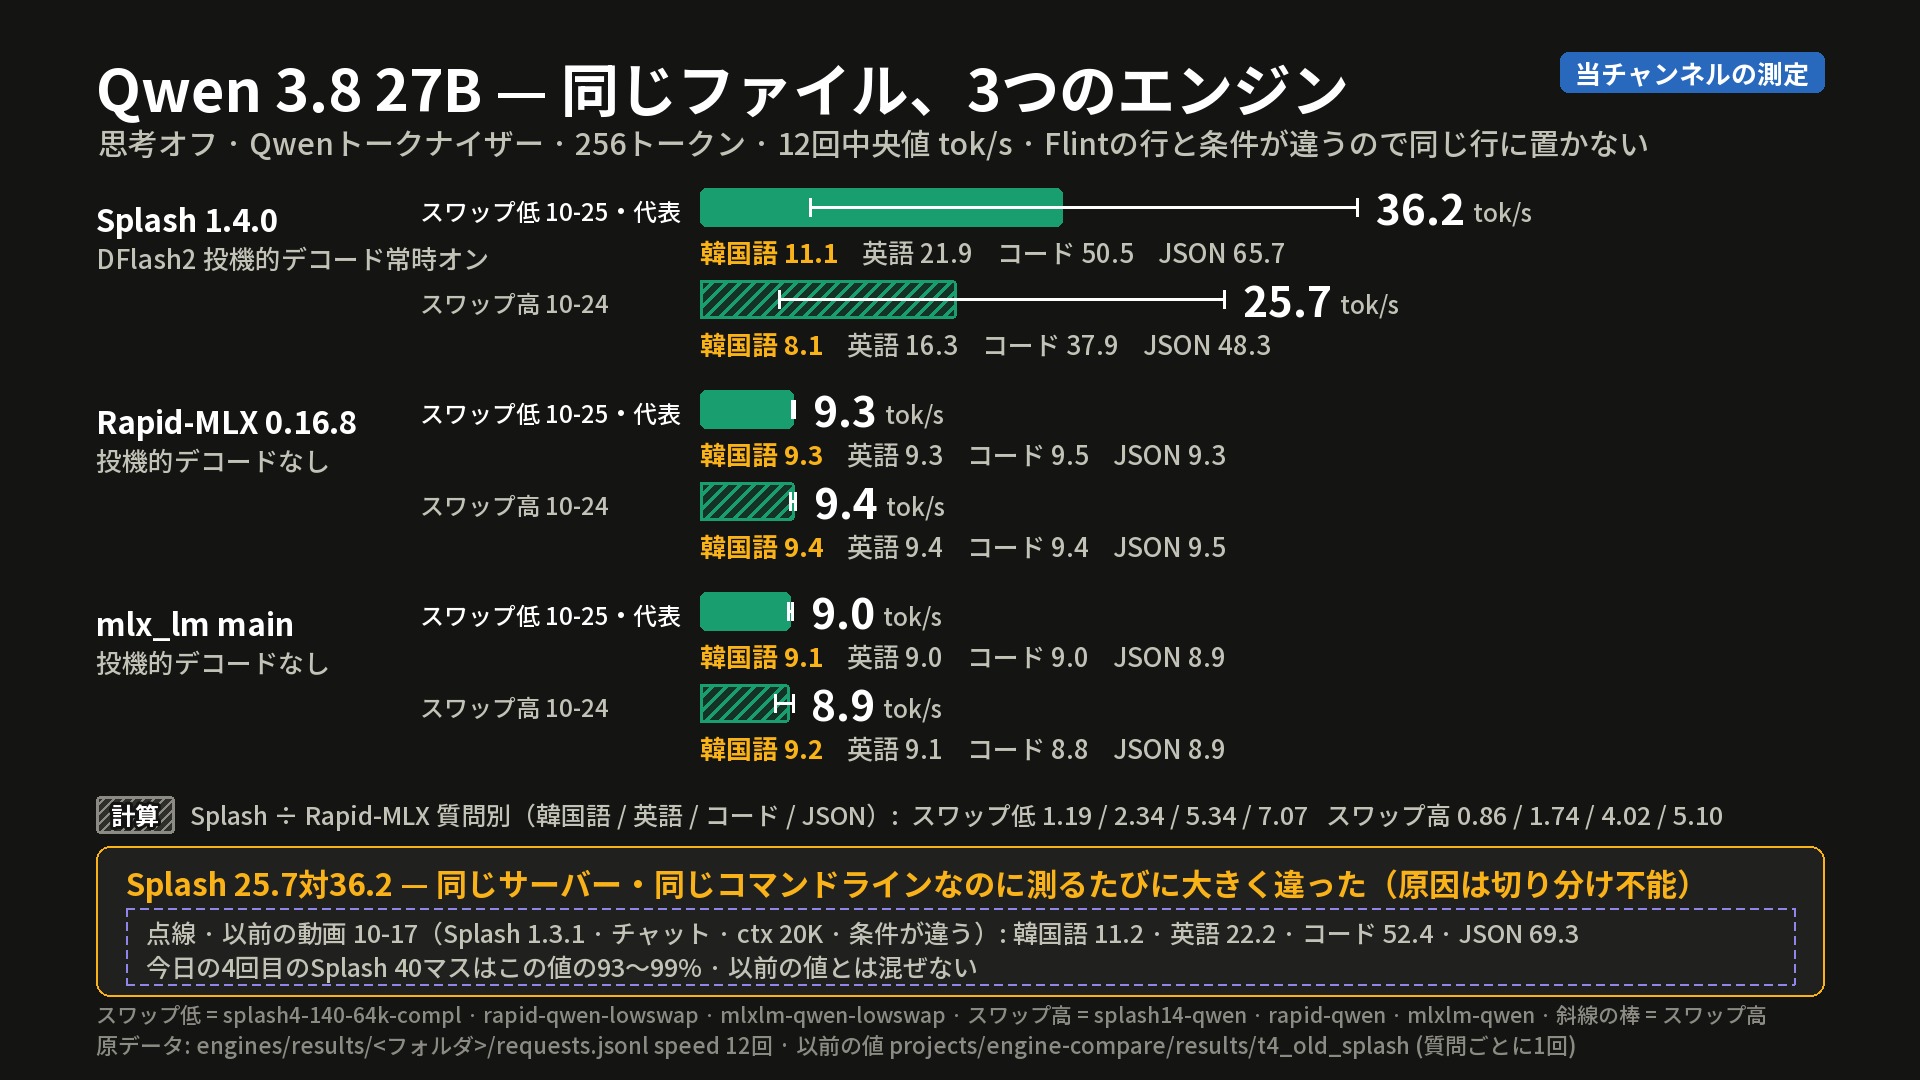
Qwen 3.8 27Bとの比較
Qwen側の速度は思考をオフにした条件なので、Flint(思考オン)と同じ行には置きません。同じQwenファイルでスワップ約2〜3GBのとき、Splash 1.4は毎秒36.2トークン、Rapid-MLXは9.35、mlx_lmは9.03で、韓国語の質問だけを見るとSplash 11.1、Rapid-MLX 9.35、mlx_lm 9.12でした(当チャンネルの測定)。Splashは同じサーバー・同じ引数なのに、最初は25.7、測り直しでは36.2と大きく異なり、原因は切り分けられませんでした。
同じllama-bench(深さ0、生成128トークン)で同じ日に2回測ると、FlintはQwenの6.25〜6.35倍でした(計算)。前夜に測ったQwenの値7.04を使うと7倍台になり、原因は分かりません。ファイルはそれぞれの4ビットです。
コーディングエージェント
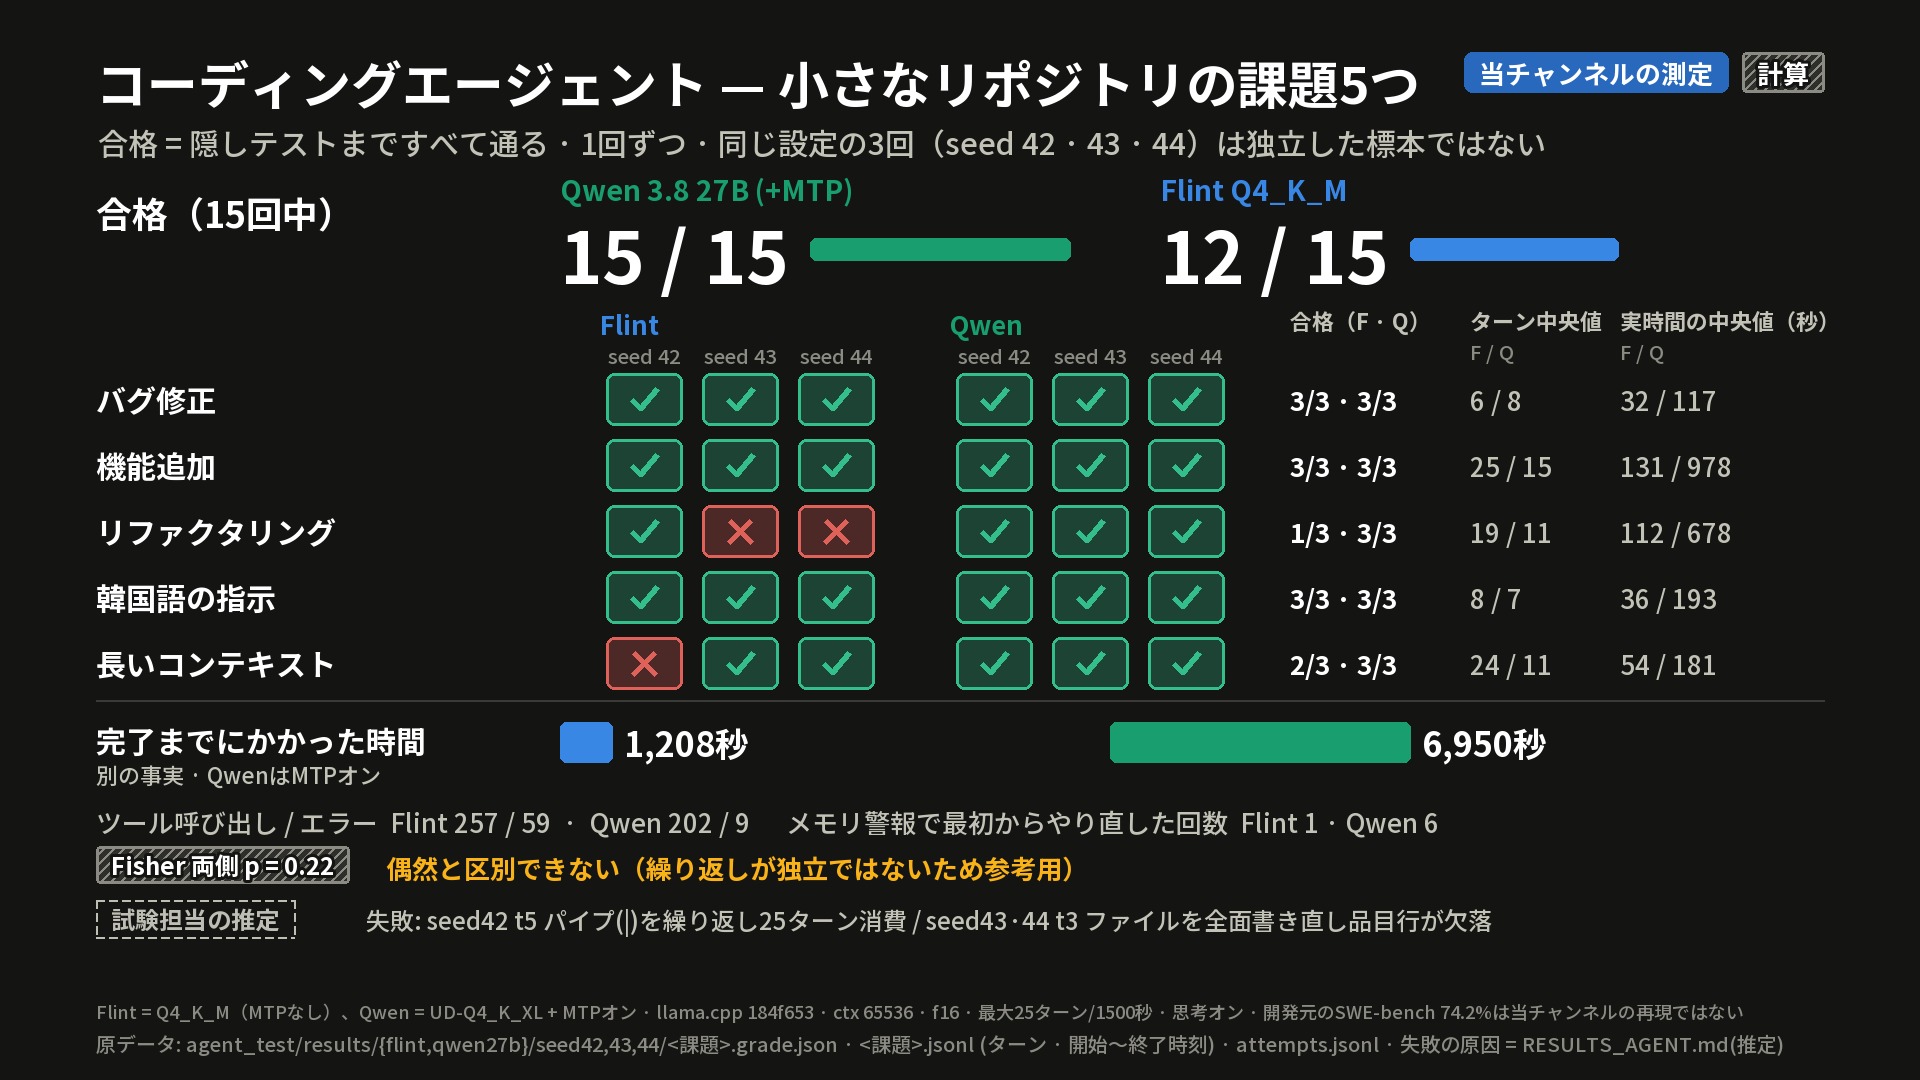
当チャンネルのコーディング52問とツール呼び出し49課題はエージェントのテストではありません。そこで、小さなリポジトリの課題5つ(バグ修正、機能追加、リファクタリング、韓国語の指示、長いコンテキスト)をエージェントループで解かせました。合格は隠しテストまですべて通ることで、シード42・43・44の3つで3回ずつ、計15回実行しました(QwenはMTPをオンにした状態)。
- 15回のうち合格はQwenが15回、Flintが12回です。Flintは長いコンテキストの課題で1回、リファクタリングで2回失敗し、韓国語の指示の課題は3回とも合格しました。
- 3回の繰り返しは独立した標本ではないため、この差は偶然と区別できません(計算。フィッシャーの正確確率検定 p=0.22は参考値)。
- 失敗の原因はテスト担当の推定です。長いコンテキストの課題は禁止されたパイプコマンドを繰り返してターンを使い切り、リファクタリングはファイルを丸ごと書き直して1行を落としたと見ています。
- メモリ警告で最初からやり直した実行が7回含まれています(Flint 1、Qwen 6)。
- 15回を完了するまでにかかった実時間の合計は、Flintが1,208秒、Qwen(MTPオン)が6,950秒でした。モデルの速度比較ではなく、別の事実です。
- ツール呼び出し49課題は1回ずつの実行で、採点が文字一致を要求するため、意味が合っていても不合格になった例があります。そのため36対45はこの採点器での合格数です。
長いコンテキストと機器の大きさ
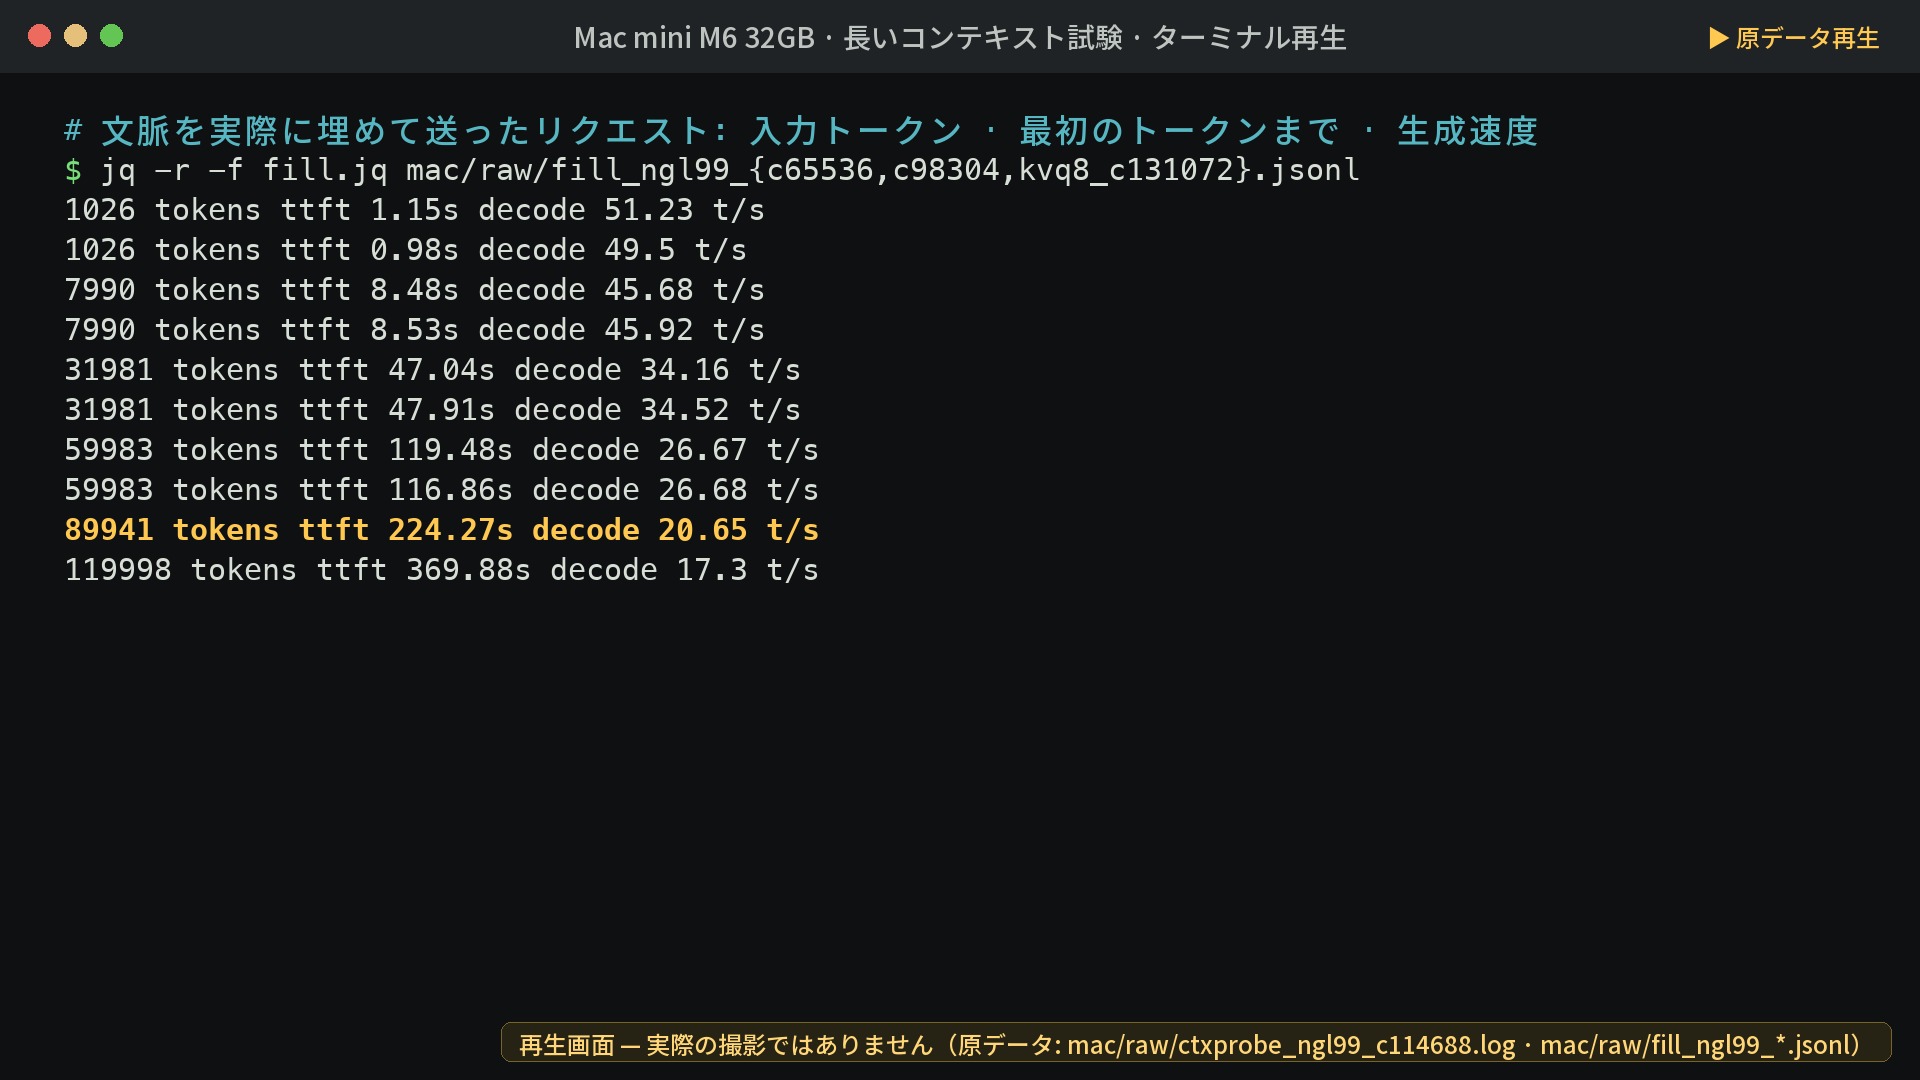
開発元のカードにあるコンテキストは262,144トークンです(開発元の主張)。当チャンネルのMac miniのKV 16ビットでは98,304トークンまでサーバーが起動し、114,688トークンでメモリ不足になり、その間は測っていません。サーバーが起動することと、その長さを埋めて応答することは別です。実際に入力を埋めて応答まで確認できた最大は、KV 16ビットで約9万トークン(89,941トークン)で、最初のトークンまで224.3秒、生成は毎秒20.65トークンでした。KV 8ビットでは入力119,998トークンで最初のトークンまで369.88秒でした。
24GBのMacと48GBのMacは持っていないため測っていません。上限の比率が機器の大きさに関係しないと仮定すると、当チャンネルの23.39GBのファイルは24GBのMacには入らないという計算になります(計算)。48GBについては、Rapid-MLXの作者が36GBでも動くと書いています(第三者の報告)。
測れなかったことと限界
- 開発元の速度の主張、24GBのMac、48GBのMac、Windowsでの実行、Ollamaのデフォルトタグは測れていません。
- クリーンな環境での速度ではありません。測定中にスワップがありました。
- ツール呼び出しは1回ずつなので標本が小さく、エージェントのテストの3回の繰り返しは独立した標本ではありません。
- Qwenのコーディング52問とKMMLUの完走、OpenCodeのような実際のコーディングツールでのテストは行っていません。入力長ごとの生成速度も動画に入れられませんでした。
- 動画内のターミナル画面は測定記録ファイルを再生したもので、撮影した画面ではありません。
まとめると、合格数はQwenのほうが多く(ツール呼び出し36対45、コーディングエージェント12対15)、かかった時間はFlintがQwen(MTPオン)よりずっと短いという結果でした。