Mac mini 32GBのローカルAIエンジン8つ比較、Splash JSON 69.3 vs 基準線8.5トークン
投稿日 動画公開
Mac mini M6 32GBでローカルAIエンジン8つを同じ質問で測りました。英語・コード・JSONは大きく速くなり、韓国語は伸びが小さい結果でした。速度だけの表で、ファイルが違うためエンジンだけの効果ではありません。
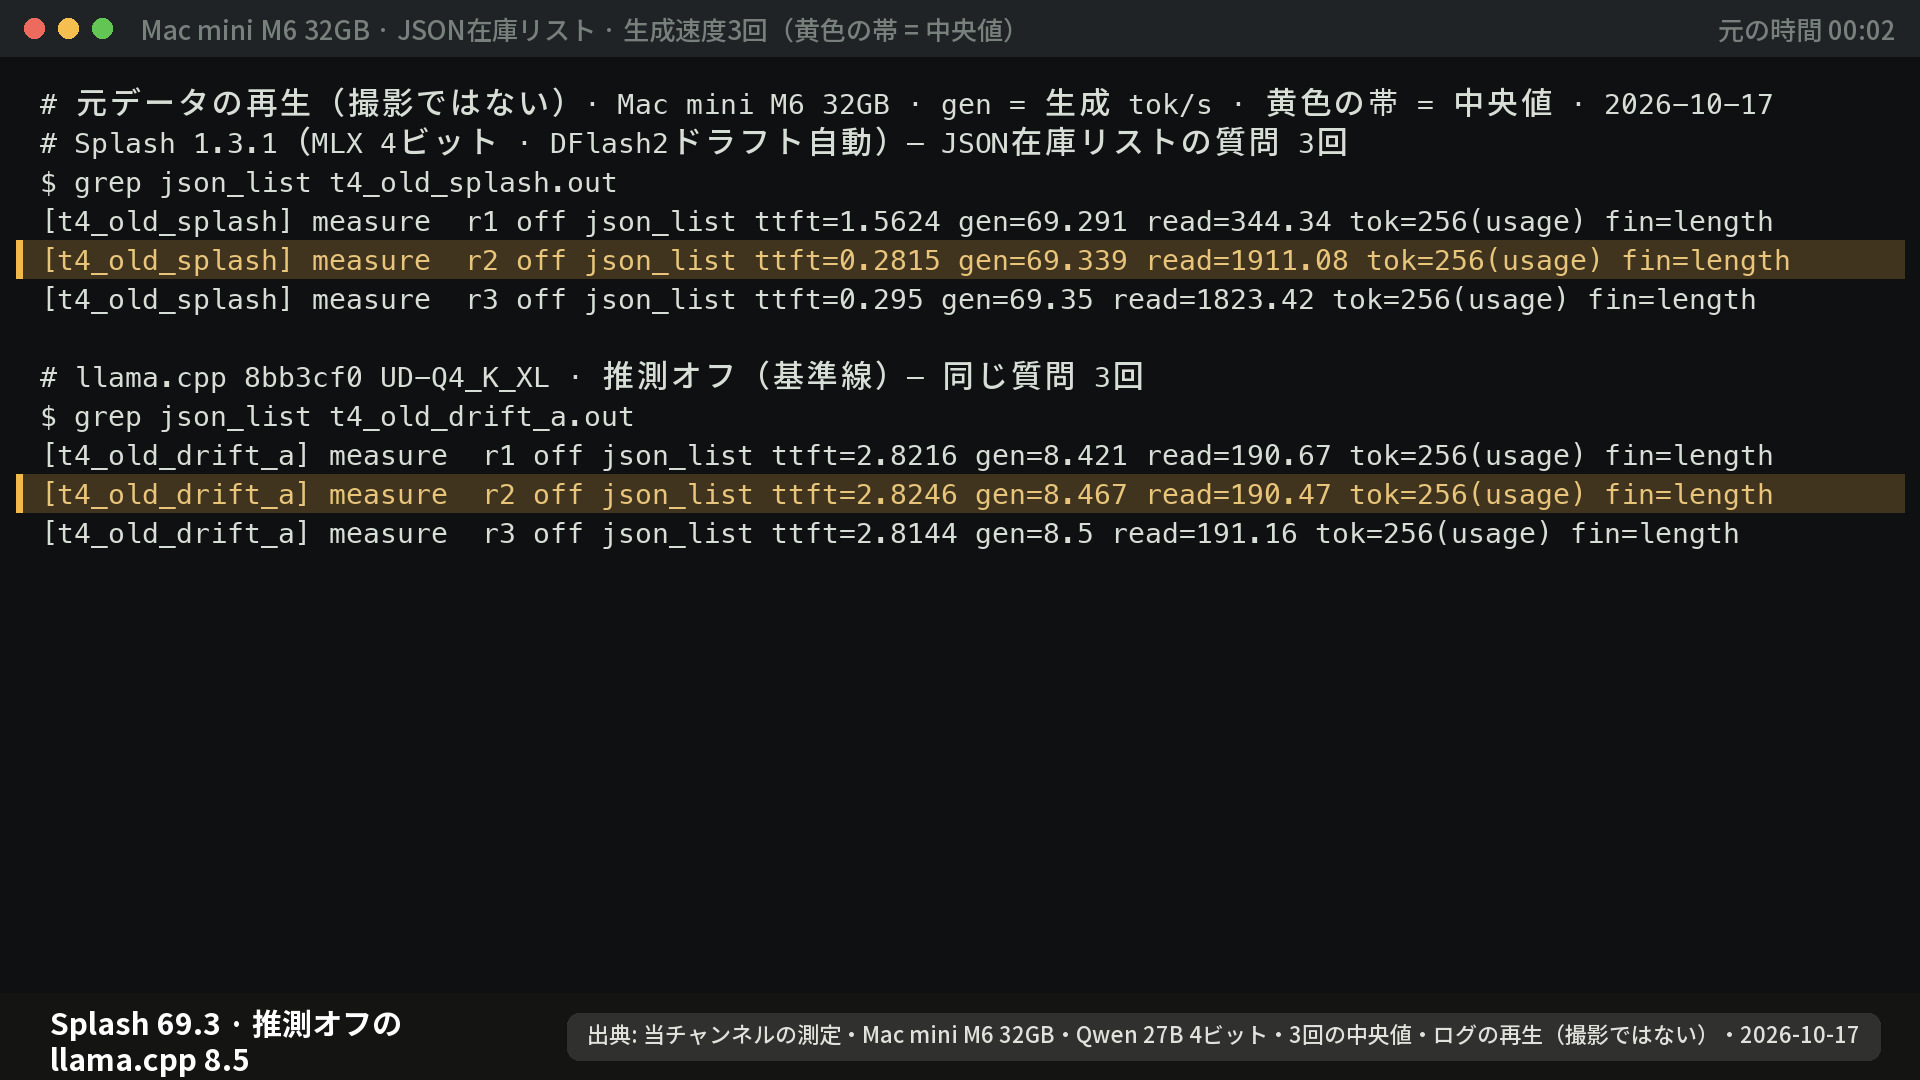
同じMac mini M6 32GB、同じQwen 27B、同じJSONの質問で、推測をオフにしたllama.cppは毎秒8.5トークン、Splashは69.3トークンでした。ローカルAIエンジン8つ(llama.cpp・mlx_lm・MTPLX・Rapid-MLX・Splash・LM Studio・Strata・Sushi)を、Mac mini 1台で同じ質問を使って測った記録です。すべて速度だけを測った表で、ファイルがエンジンごとに違うため、差はエンジンだけの効果ではありません。基準日は動画の公開日である2026-10-17です。
結論を先に
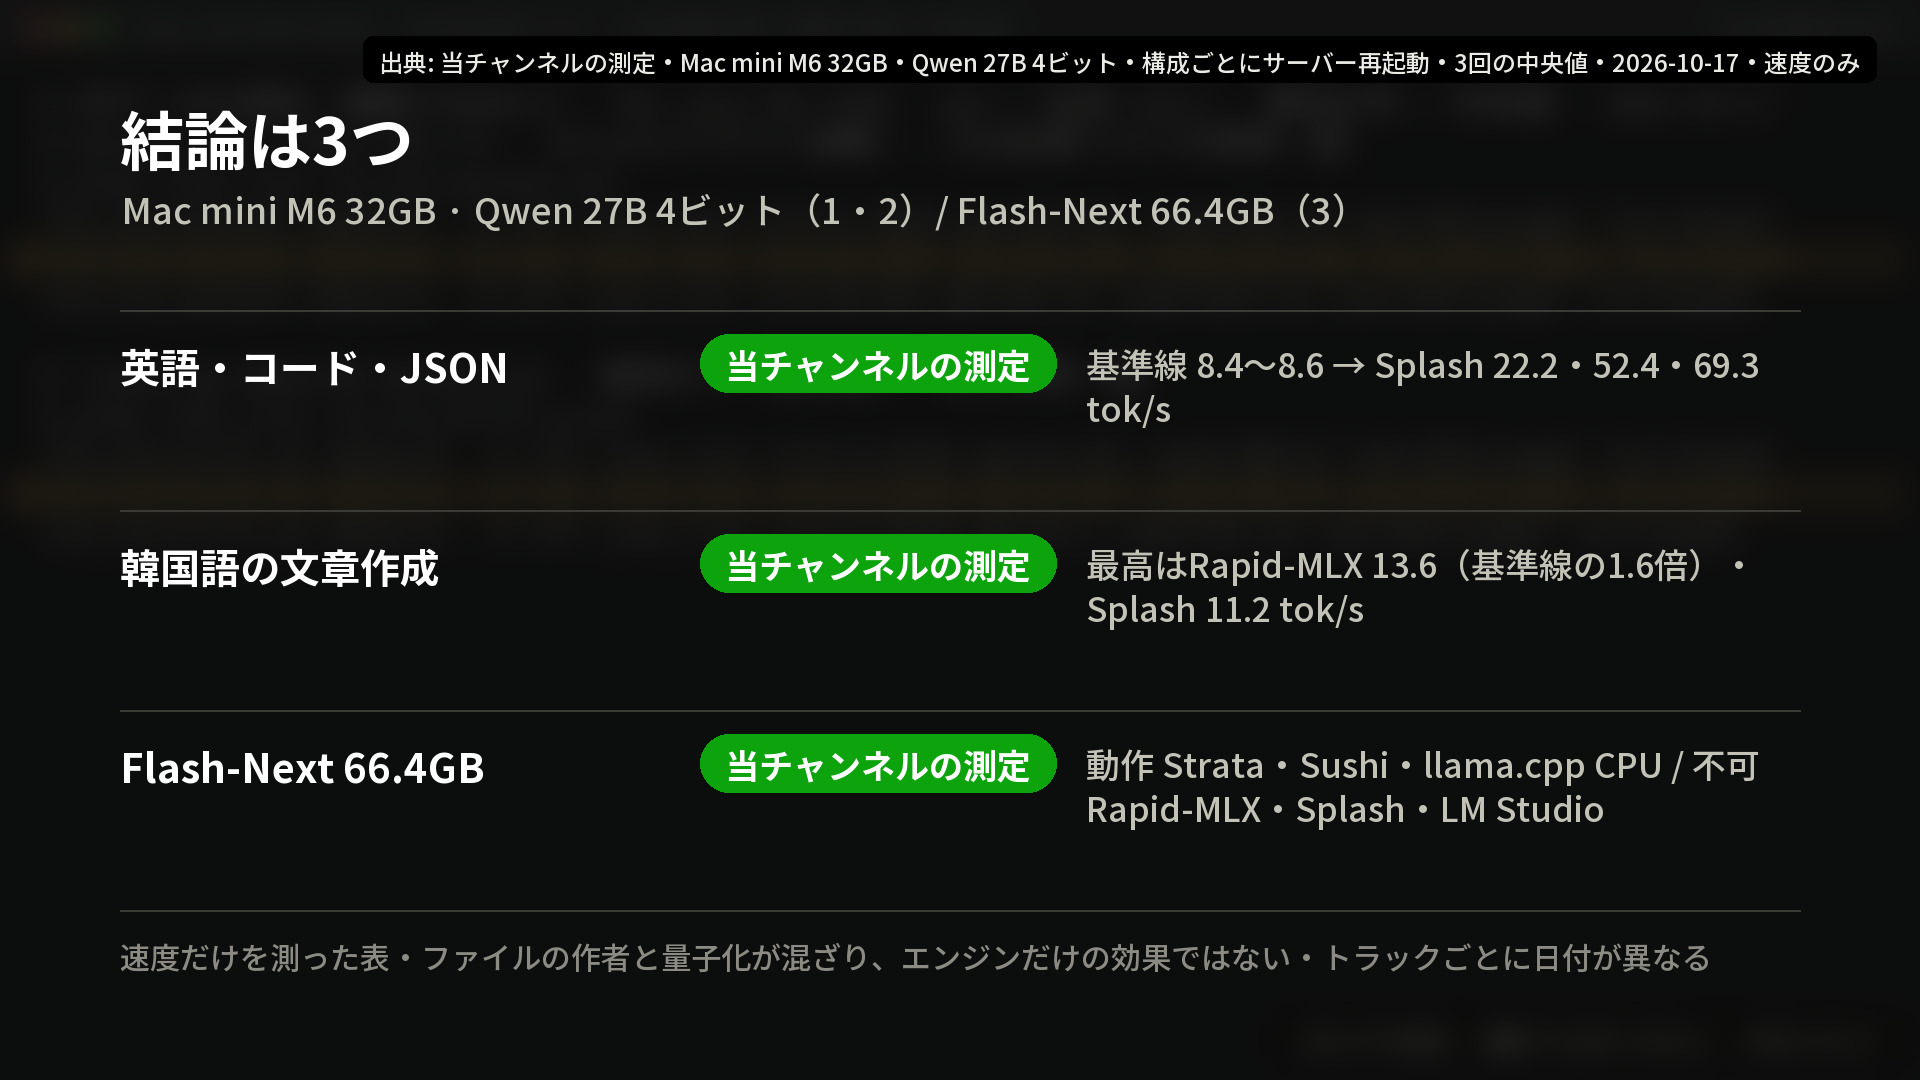
- 英語・コード・JSONは大きく速くなりました。 推測をオフにした基準線は8.4〜8.6トークンですが、Splashは英語22.2・コード52.4・JSON 69.3トークンでした[当チャンネルの測定]。
- 韓国語の文章作成は伸びが小さい結果でした。 最も良かったのはRapid-MLXの13.6トークンで基準線の1.6倍[計算・推定]、Splashは11.2トークンでした[当チャンネルの測定]。
- 66.4GBのFlash-Nextはエンジンの選択肢が狭くなりました。 32GBのMac miniではStrata・Sushi・llama.cppのCPUだけが動き、Rapid-MLX・Splash・LM Studioは動かせませんでした[当チャンネルの測定]。モデルが違うため、Qwen 27Bの速度とは順位を付けていません。
数字の種類
- 当チャンネルの測定:Apple M6・32GBのMac mini 1台、macOS 27.2。構成ごとにサーバーを起動し直し、3回の中央値、チャット方式、思考オフ、温度0、最大256トークン。
- 計算・推定:当チャンネルの測定値どうしで割った倍率やパーセント差。
- メーカーの文書:Rapid-MLXのパックサイズやSplashの最小メモリなど(当チャンネルでは測っていません)。
- 10-11の動画の値を引用:量子化の品質(KL)。今回は測り直していません。
質問は韓国語の文章作成・英語の文章作成・コード・JSON在庫リストの4つで、10月11日の動画と同じです。その動画の「最速の組み合わせ」にはSplashが入っていなかったため、今回同じ質問で測りました。
Qwen 27B 4ビット:質問ごとに1位が違いました
基準線はllama.cpp UD-Q4_K_XLで推測(speculative)デコーディングをオフにした構成で、4つの質問すべてで8.4〜8.6トークンです。推測デコーディングは次のトークンをいくつか先に予想してまとめて確認する方式で、MTPとDFlash2がこれに当たります。SplashはDFlash2のドラフトが自動で付く構成です。
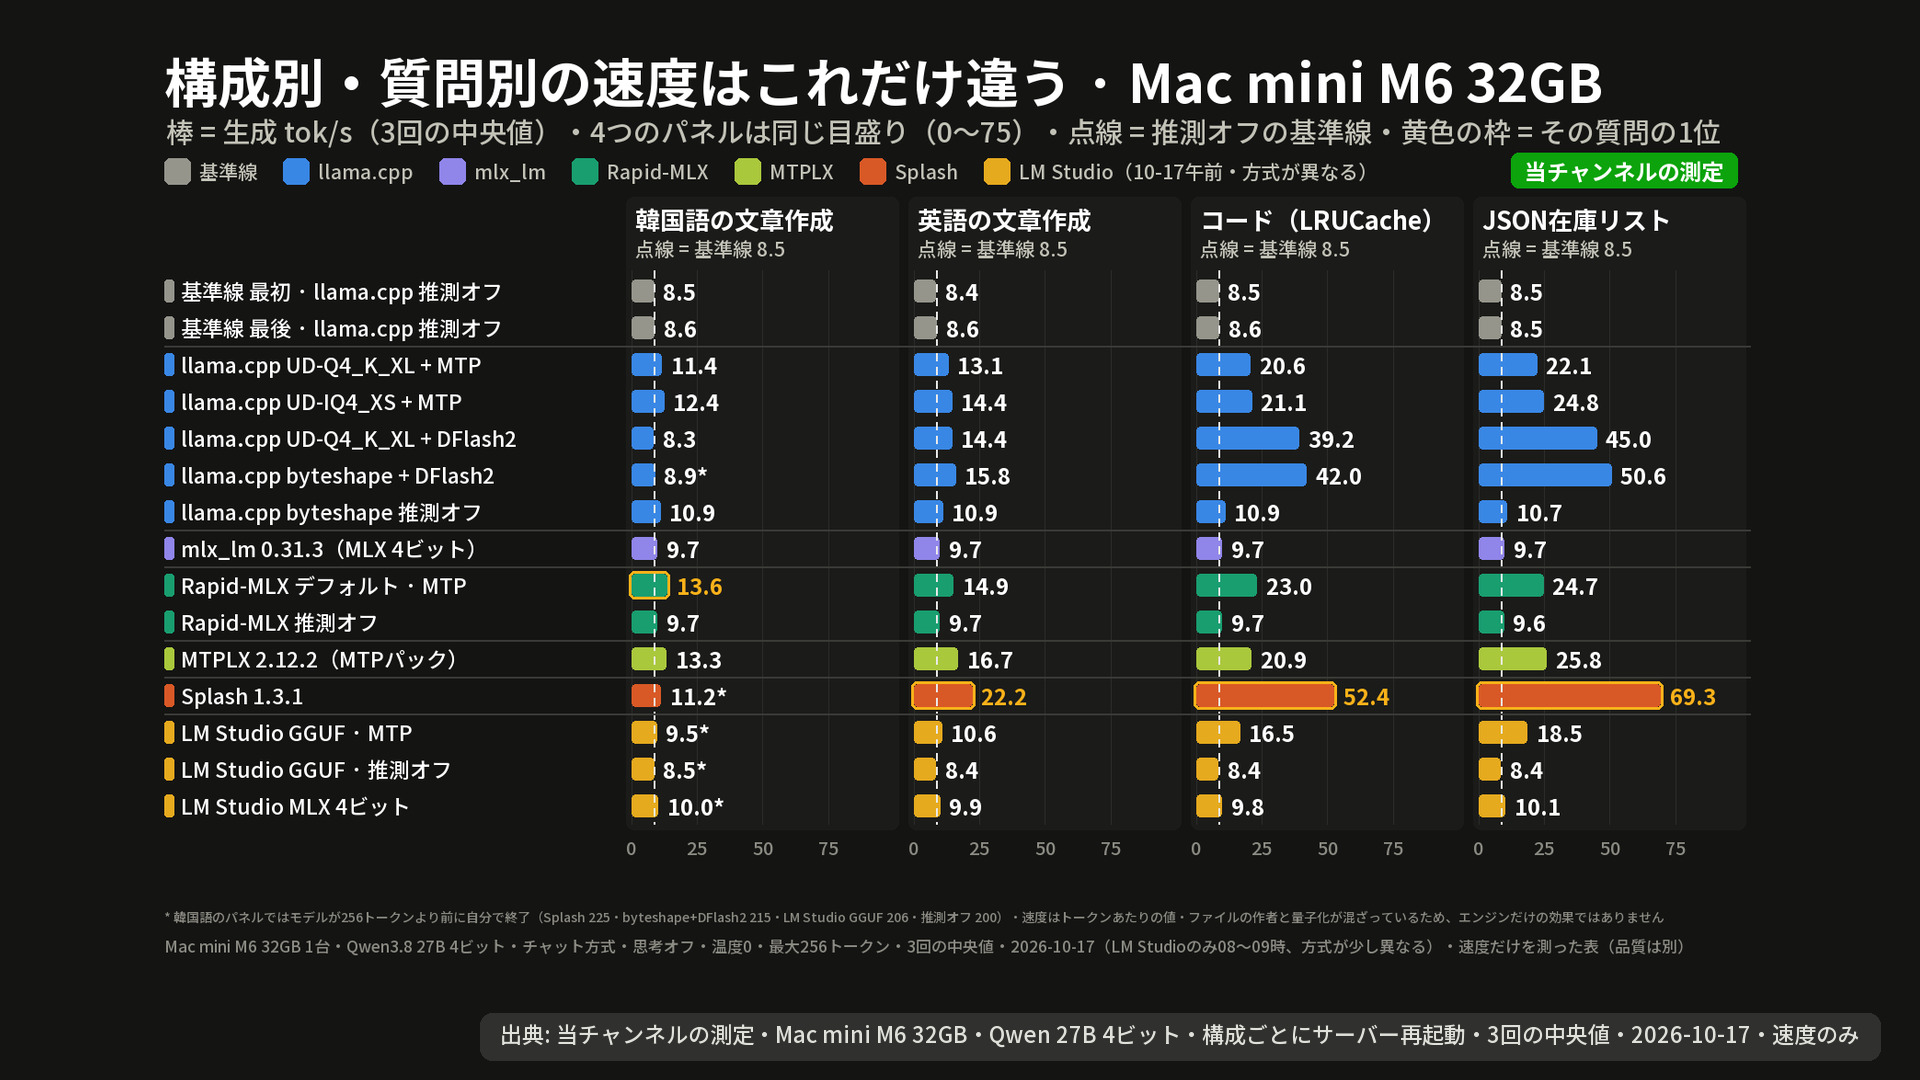
生成速度(tok/s、3回の中央値、2026-10-17、当チャンネルの測定):
| 構成 | 韓国語 | 英語 | コード | JSON |
|---|---|---|---|---|
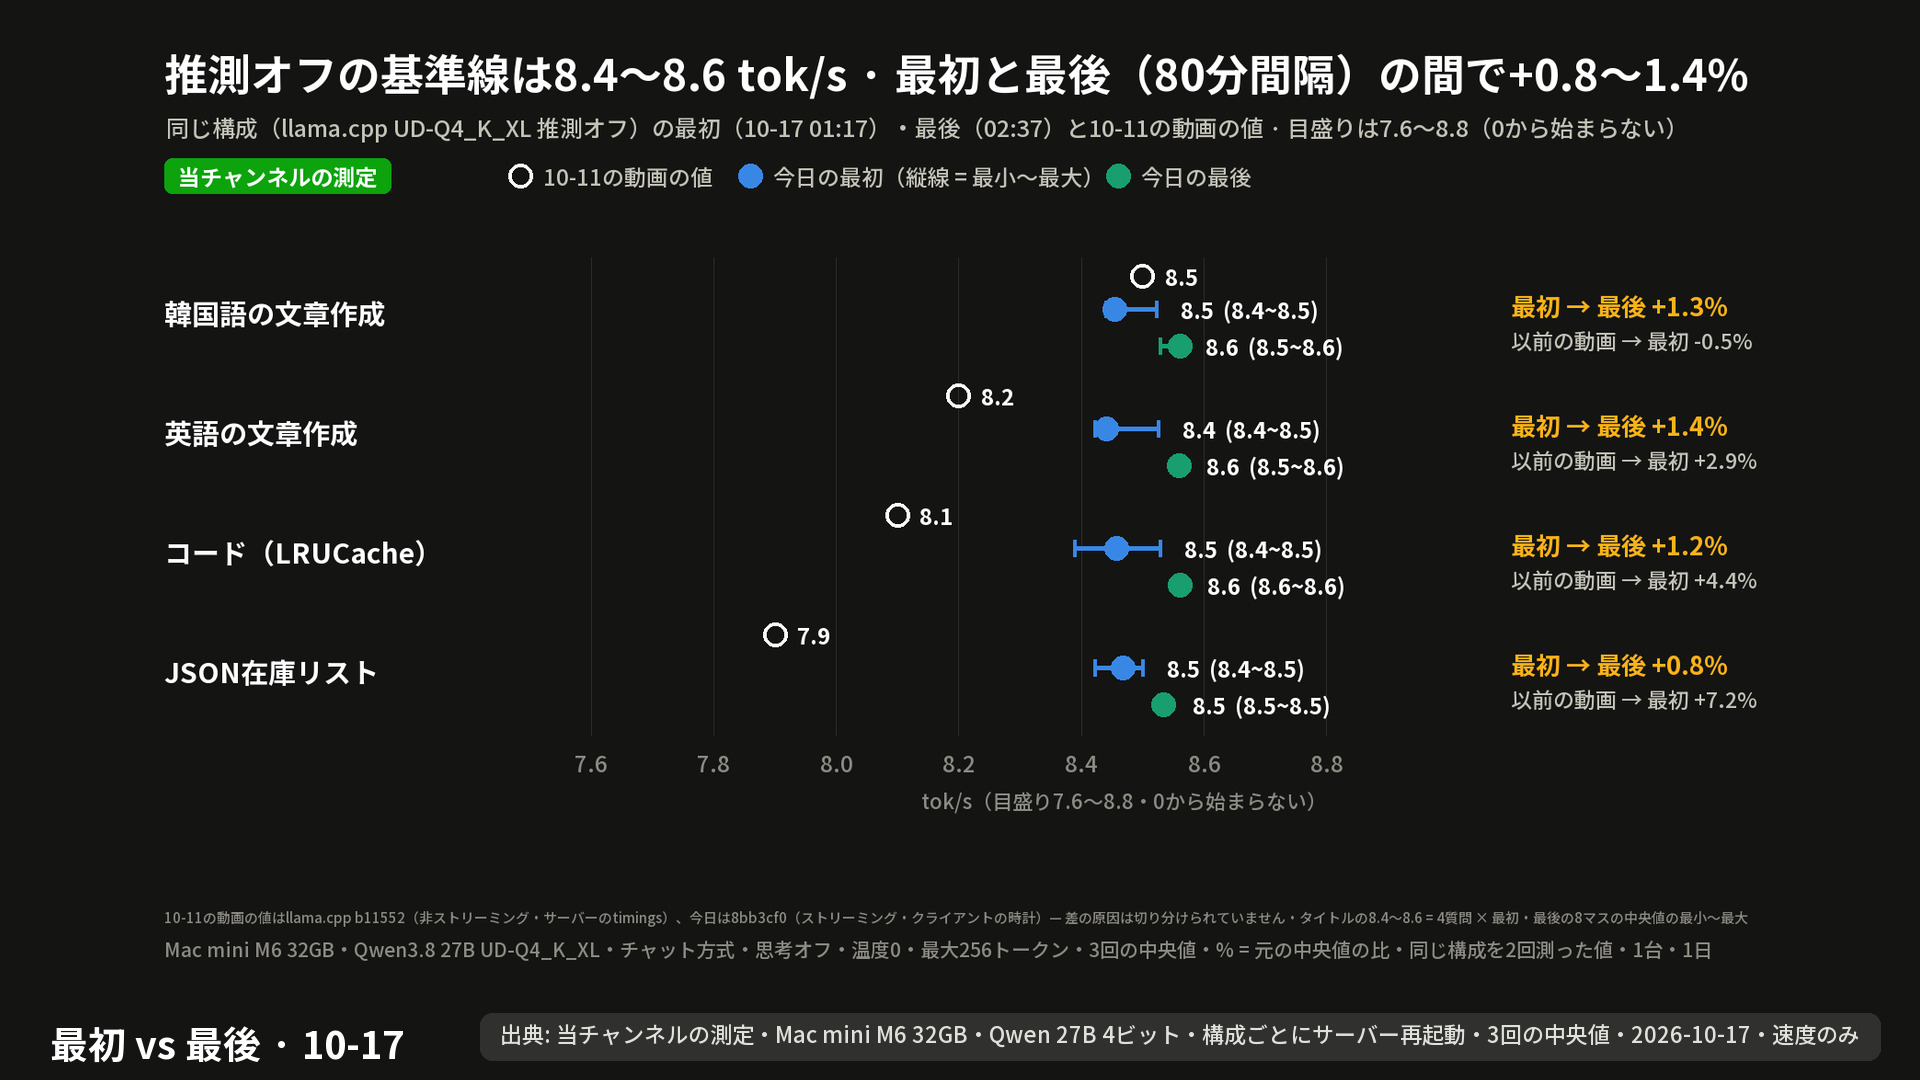
| 基準線 llama.cpp UD-Q4_K_XL 推測オフ(最初/最後) | 8.5/8.6 | 8.4/8.6 | 8.5/8.6 | 8.5/8.5 |
| Splash 1.3.1(MLX 4ビット・DFlash2自動) | 11.2 | 22.2 | 52.4 | 69.3 |
| Rapid-MLX 0.16.1 デフォルト(MTP) | 13.6 | 14.9 | 23.0 | 24.7 |
| Rapid-MLX 推測オフ | 9.7 | 9.7 | 9.7 | 9.6 |
| MTPLX 2.12.2 | 13.3 | 16.7 | 20.9 | 25.8 |
| mlx_lm 0.31.3 | 9.7 | 9.7 | 9.7 | 9.7 |
| llama.cpp UD-Q4_K_XL + MTP | 11.4 | 13.1 | 20.6 | 22.1 |
| llama.cpp UD-Q4_K_XL + DFlash2 | 8.3 | 14.4 | 39.2 | 45.0 |
| llama.cpp UD-IQ4_XS + MTP | 12.4 | 14.4 | 21.1 | 24.8 |
| llama.cpp byteshape + DFlash2 | 8.9 | 15.8 | 42.0 | 50.6 |
| llama.cpp byteshape 推測オフ | 10.9 | 10.9 | 10.9 | 10.7 |
| LM Studio GGUF MTP(デフォルト) | 9.5 | 10.6 | 16.5 | 18.5 |
| LM Studio GGUF 推測オフ | 8.5 | 8.4 | 8.4 | 8.4 |
| LM Studio MLX 4ビット | 10.0 | 9.9 | 9.8 | 10.1 |
- 英語・コード・JSONの1位はSplashでした。韓国語はRapid-MLX 13.6・MTPLX 13.3・UD-IQ4_XSでMTPをオンにしたllama.cpp 12.4トークンの順でした。
- 質問ごとの1位の構成が基準線より速くなった倍率は、韓国語1.6・英語2.6・コード6.2・JSON 8.2倍です[計算・推定]。基準線はファイルが違うため、エンジンだけの効果ではありません。
- 同じMLX 4ビットの重みを使うエンジンどうしでJSONを見ると、推測オフのmlx_lmが9.7、MTPをオンにしたRapid-MLXが24.7、DFlash2が付いたSplashが69.3トークンです。
- llama.cppではDFlash2が韓国語にはほとんど効きませんでした。byteshapeのファイルは推測オフで10.9なのに、DFlash2をオンにすると8.9でした。DFlash2が当てた割合は、UD-Q4_K_XLで韓国語6.7%、コード86.2%でした。これが理由かどうかは切り分けられませんでした。
コードとJSONで2位のbyteshapeのファイルはllama.cppのファイルの中で最も小さいものですが、10月11日の動画でUD-Q6_Kと比べたKL(韓国語/英語)はUD-Q4_K_XL 0.0068/0.0236・UD-IQ4_XS 0.0226/0.0621・byteshape 0.0507/0.1146と、より大きい値でした(大きいほどUD-Q6_Kの分布から離れます)。MLXとMTPLXのファイルの品質は測っていません。
LM Studioは同じファイルを直接動かしたllama.cppより遅い結果でした
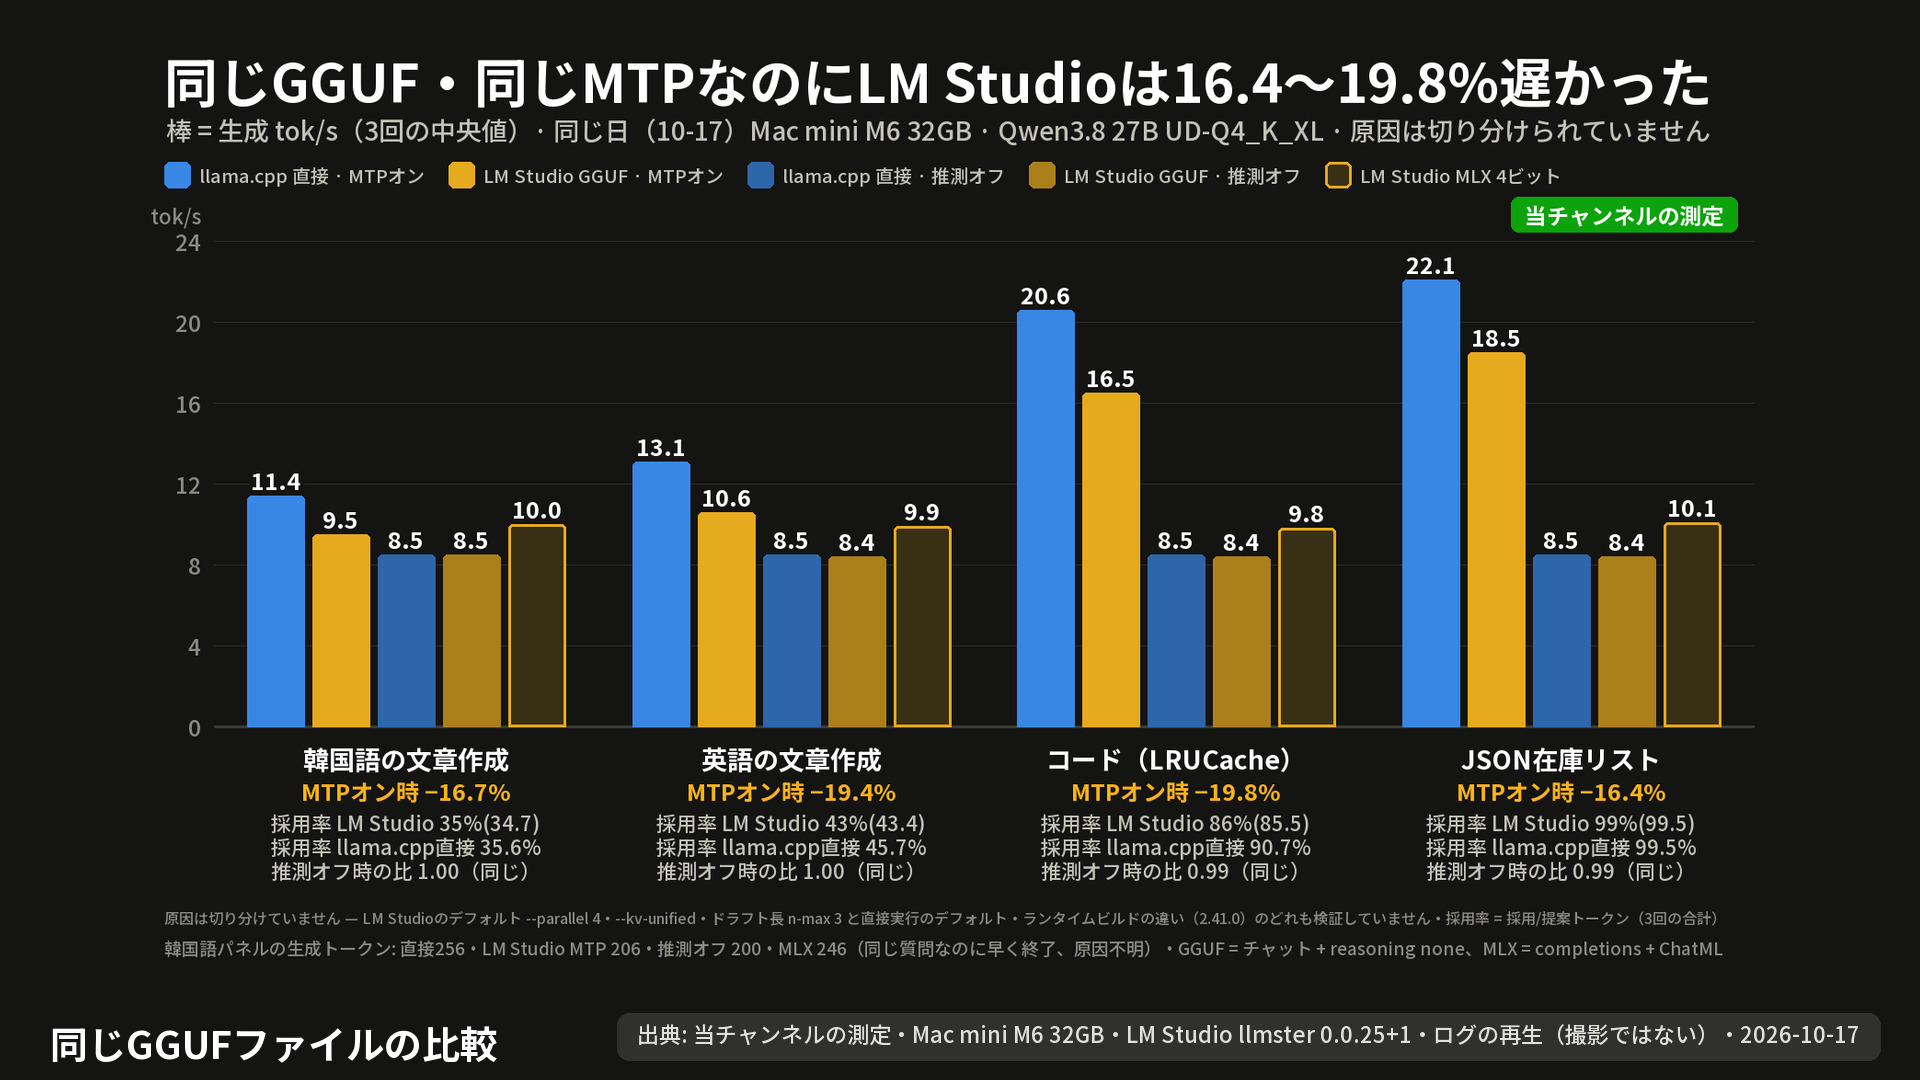
画面のない版のllmsterで同じGGUFファイルを動かしました。デフォルト設定でMTPがオンでした。韓国語9.5・英語10.6・コード16.5・JSON 18.5トークンで、同じファイルを直接動かしたllama.cppのMTPより16.4〜19.8%遅い結果でした[計算・推定]。推測をオフにすると基準線と同じでした。原因は切り分けられませんでした。LM StudioのログのMTP採用率は韓国語35・英語43・コード86・JSON 99%で、DFlash2のドラフトはオンにできませんでした。
エンジンを1行ずつ
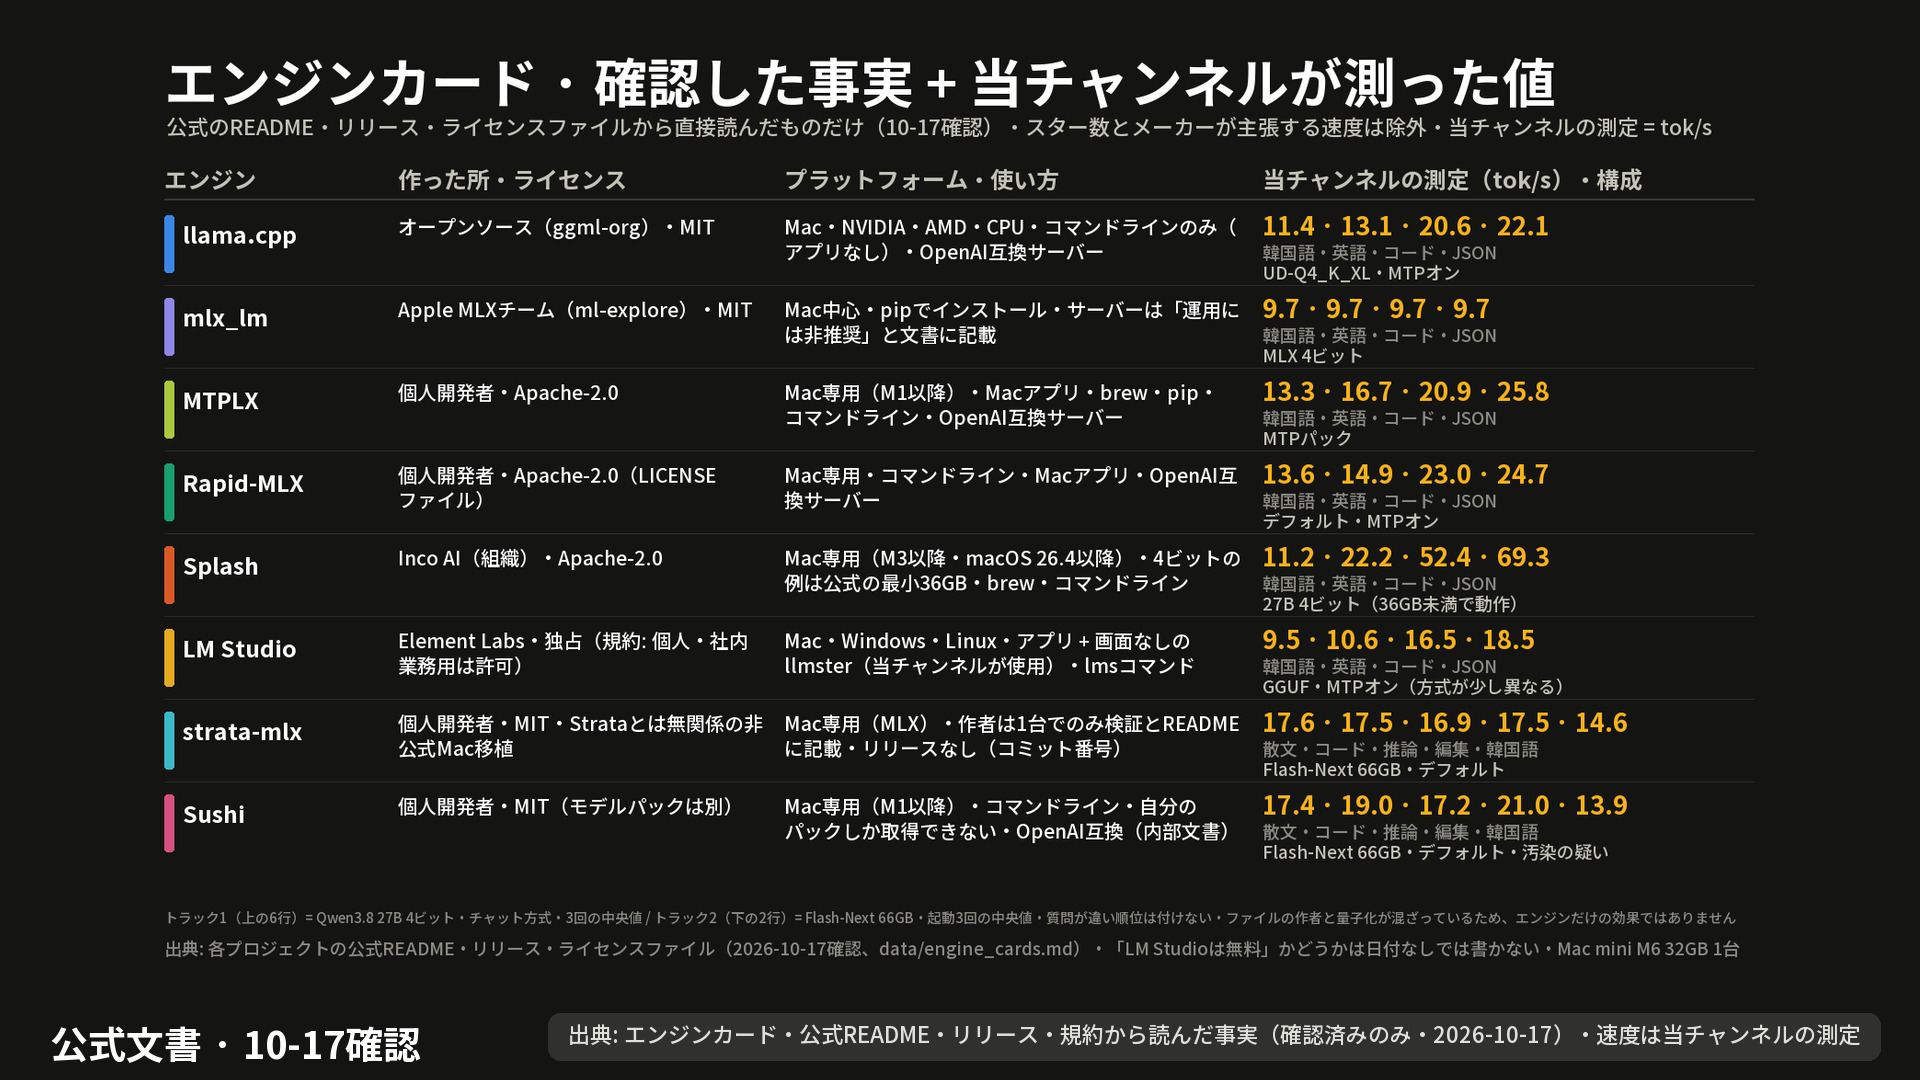
- 専用アプリがあり、コマンドラインなしで始められるのはLM Studio・MTPLX・Rapid-MLXです。残りはコマンドラインでインストールしてサーバーを起動します。
- MTPLX・Rapid-MLX・Splash・Sushi・strata-mlxはMac専用です。LM Studioはソース非公開、llama.cppはMITのオープンソースです。
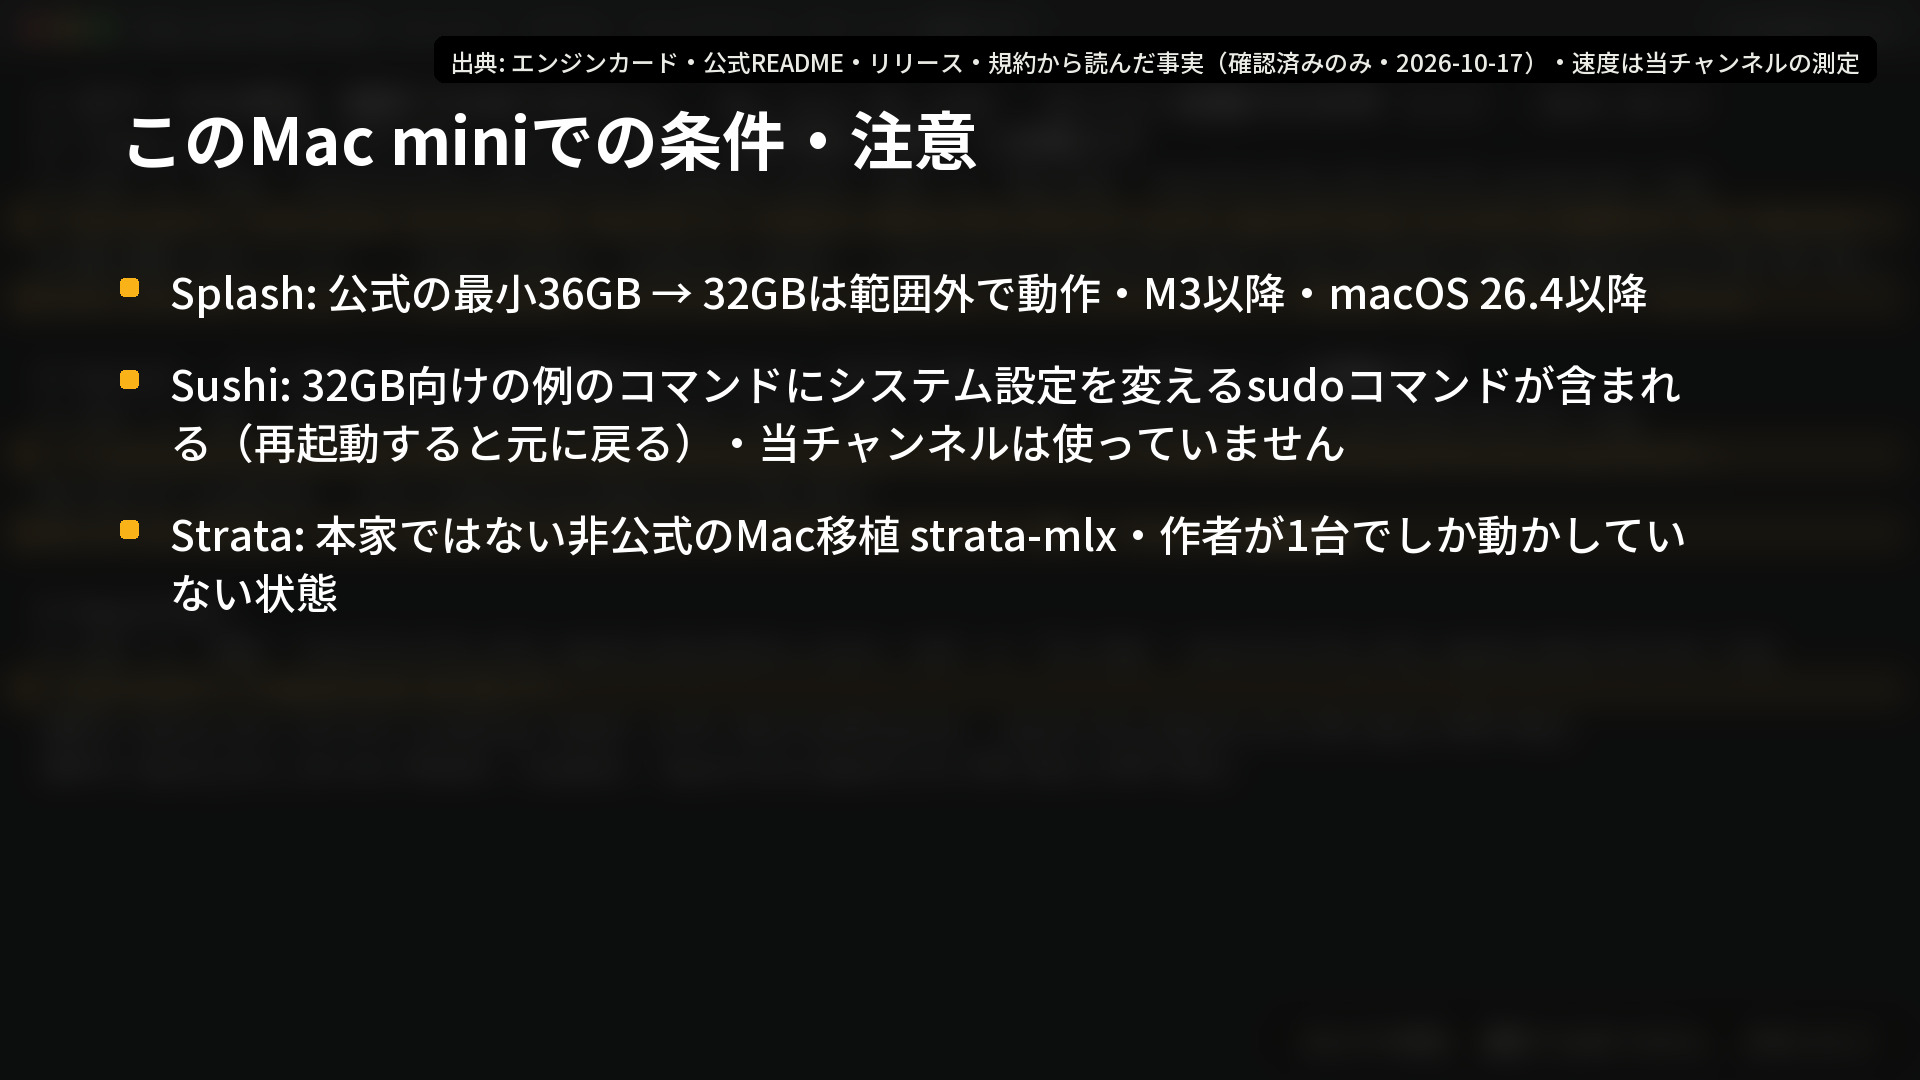
- Splashは公式の最小が36GBのため、この32GBのMac miniは範囲外で、Qwen 27Bを非公式に動かしました[メーカーの文書]。
- Sushiの32GB向けの例のコマンドにはシステム設定を変えるsudoコマンドがあるため使いませんでした。ここでのStrataは本家ではなく、非公式のMacへの移植版strata-mlxです。
大きなモデルFlash-Next 66.4GB
Flash-Next Q2_0は66.4GBで32GBのメモリに入らないため、SSDから読みながら動かします。質問は散文・コード・推論・編集・韓国語の5つで、起動3回の中央値です。測定日が構成ごとに違うため、互いに順位は付けていません。
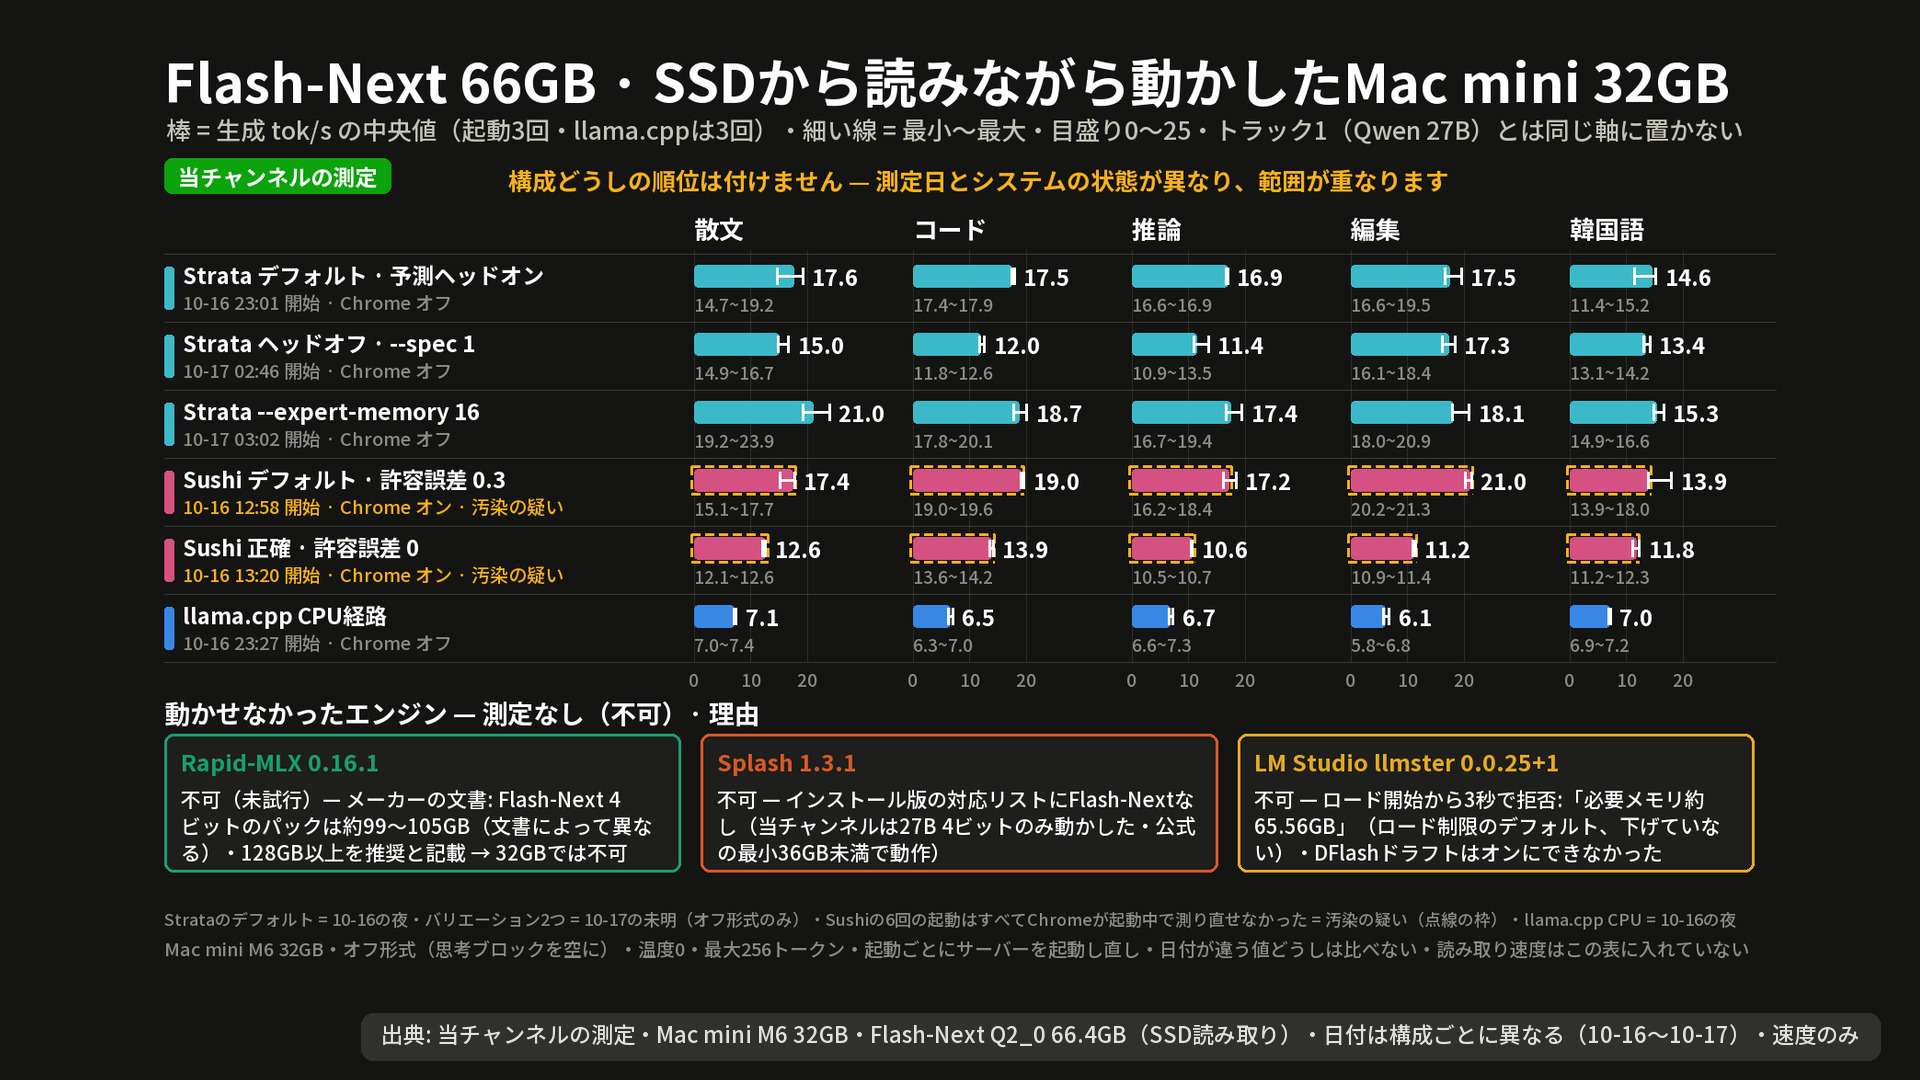
生成速度(tok/s、当チャンネルの測定):
| 構成 | 散文 | コード | 推論 | 編集 | 韓国語 |
|---|---|---|---|---|---|
| Strata デフォルト・10-16 夜 | 17.6 | 17.5 | 16.9 | 17.5 | 14.6 |
| Strata ヘッドオフ・10-17 明け方 | 15.0 | 12.0 | 11.4 | 17.3 | 13.4 |
| Strata expert-memory 16・10-17 明け方 | 21.0 | 18.7 | 17.4 | 18.1 | 15.3 |
| Sushi 1.2.3 デフォルト・10-16 午後 | 17.4 | 19.0 | 17.2 | 21.0 | 13.9 |
| Sushi 1.2.3 厳密・10-16 午後 | 12.6 | 13.9 | 10.6 | 11.2 | 11.8 |
| llama.cpp CPU・10-16 夜 | 7.1 | 6.5 | 6.7 | 6.1 | 7.0 |
- SushiはChromeが起動していた日に測り、測り直せなかったため汚染の疑いがある値です。以前の動画の値より5〜25%低く、理由は切り分けられませんでした。
- 動かせなかったもの:Rapid-MLXはメーカーの文書にパックが約99〜105GB(文書によって異なる)とあるため、32GBでは試しませんでした[メーカーの文書]。Splashはインストールされた版の対応リストにFlash-Nextがありませんでした。LM Studioは必要メモリ65.56GBとして3秒でロードを拒否し、ガードレールは外していません。
用途別に見ると(勝敗ではなく、この条件での方向)
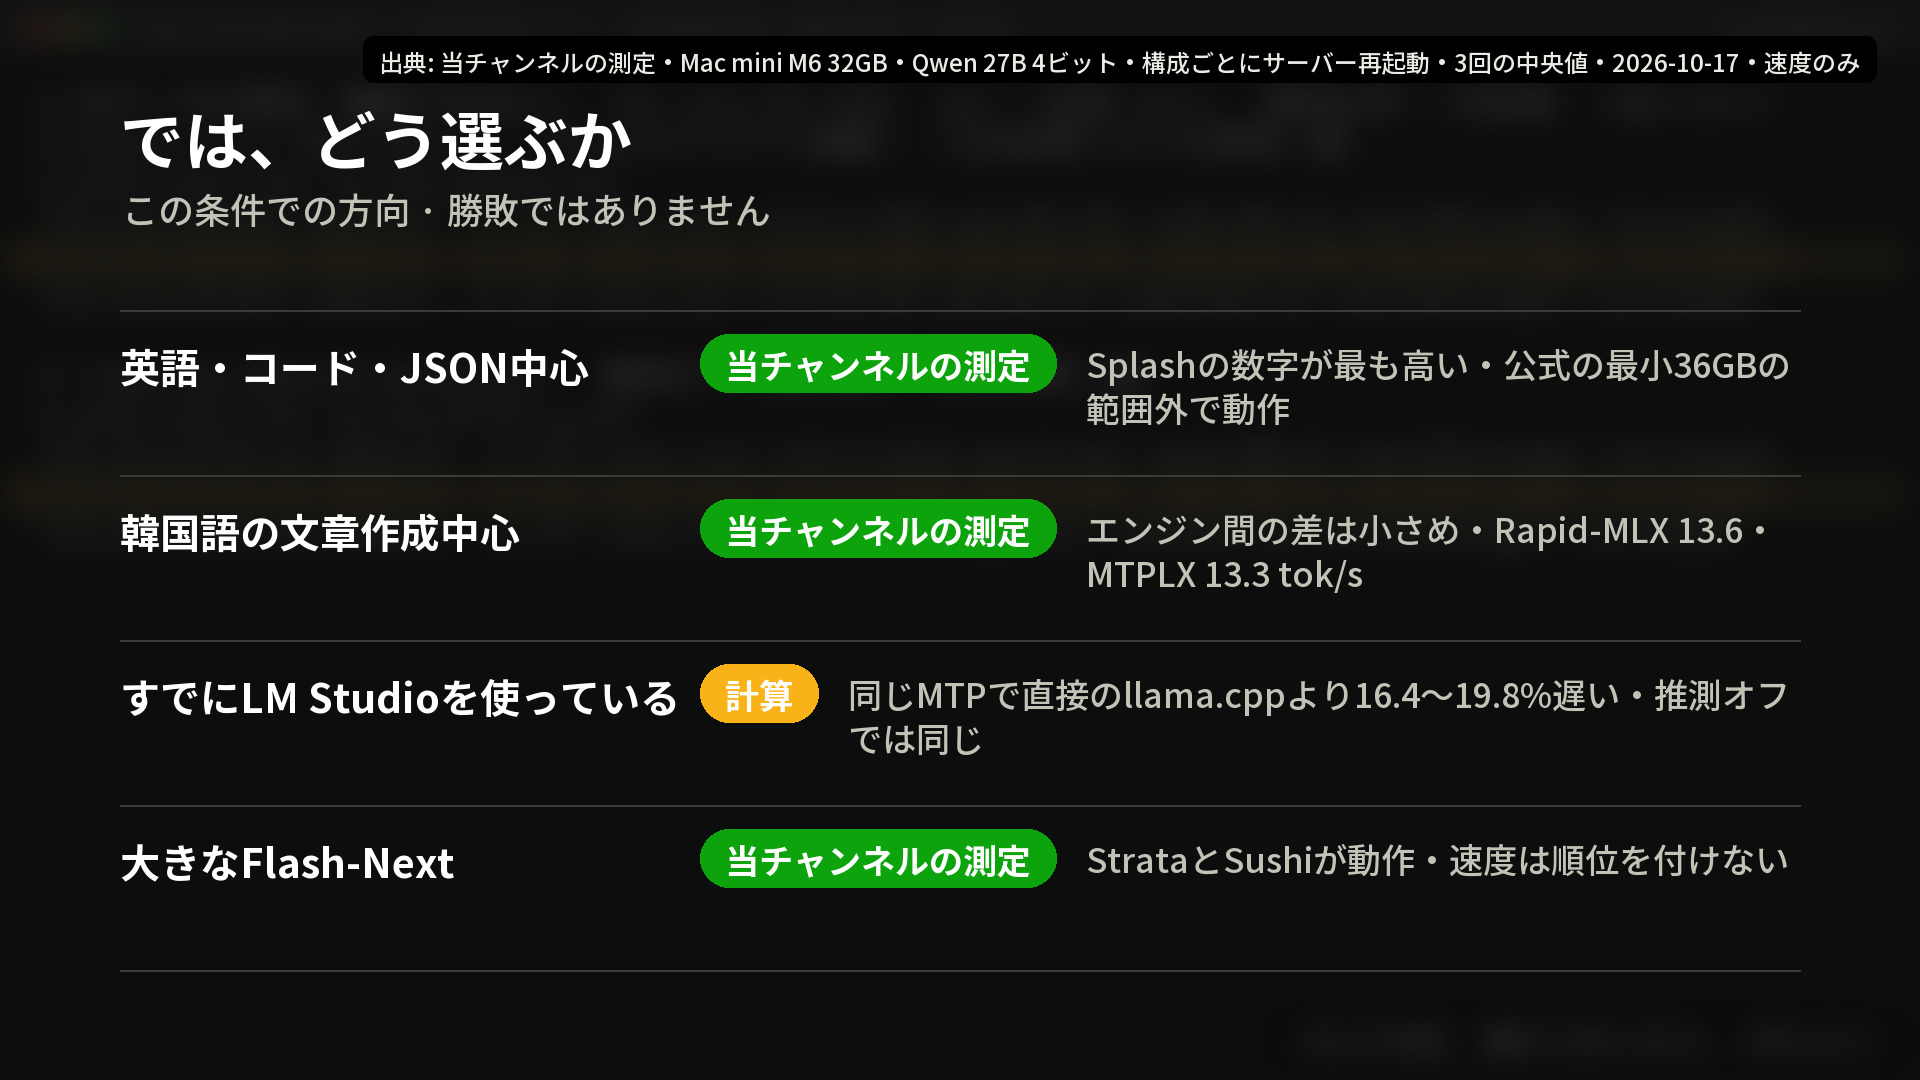
- 英語・コード・JSON中心なら、Splashの数字が最も高かったものの、公式の最小36GBの範囲外で動かした値です[当チャンネルの測定]。
- 韓国語の文章作成中心なら、エンジンを変えても伸びが最も小さく、Rapid-MLXとMTPLXが13トークン台でリードしました[当チャンネルの測定]。
- すでにLM Studioを使っているなら、同じMTPで直接のllama.cppより16〜20%遅く、推測をオフにすると同じでした[計算・推定]。
- 大きなFlash-Nextは、StrataとSushiが動きました。
限界と確認できなかったこと
- 速度だけを測った表です。ファイルの作者と量子化(UD-Q4_K_XL・UD-IQ4_XS・byteshape・MLX 4ビット)が混ざっているため、差はエンジンだけの効果ではありません。
- 基準線を最初と最後に2回測ると0.8〜1.4%揺れました。10月11日の動画の値とは、36マス中28マスが3%以内で、最大8%の差があり、原因は切り分けられませんでした。
- LM Studioが遅い理由、DFlash2が韓国語で弱い理由、Sushiの値が低かった理由は切り分けられませんでした。1台で3回測った値のため、別のMacやファイルでは変わる可能性があります。
基準日
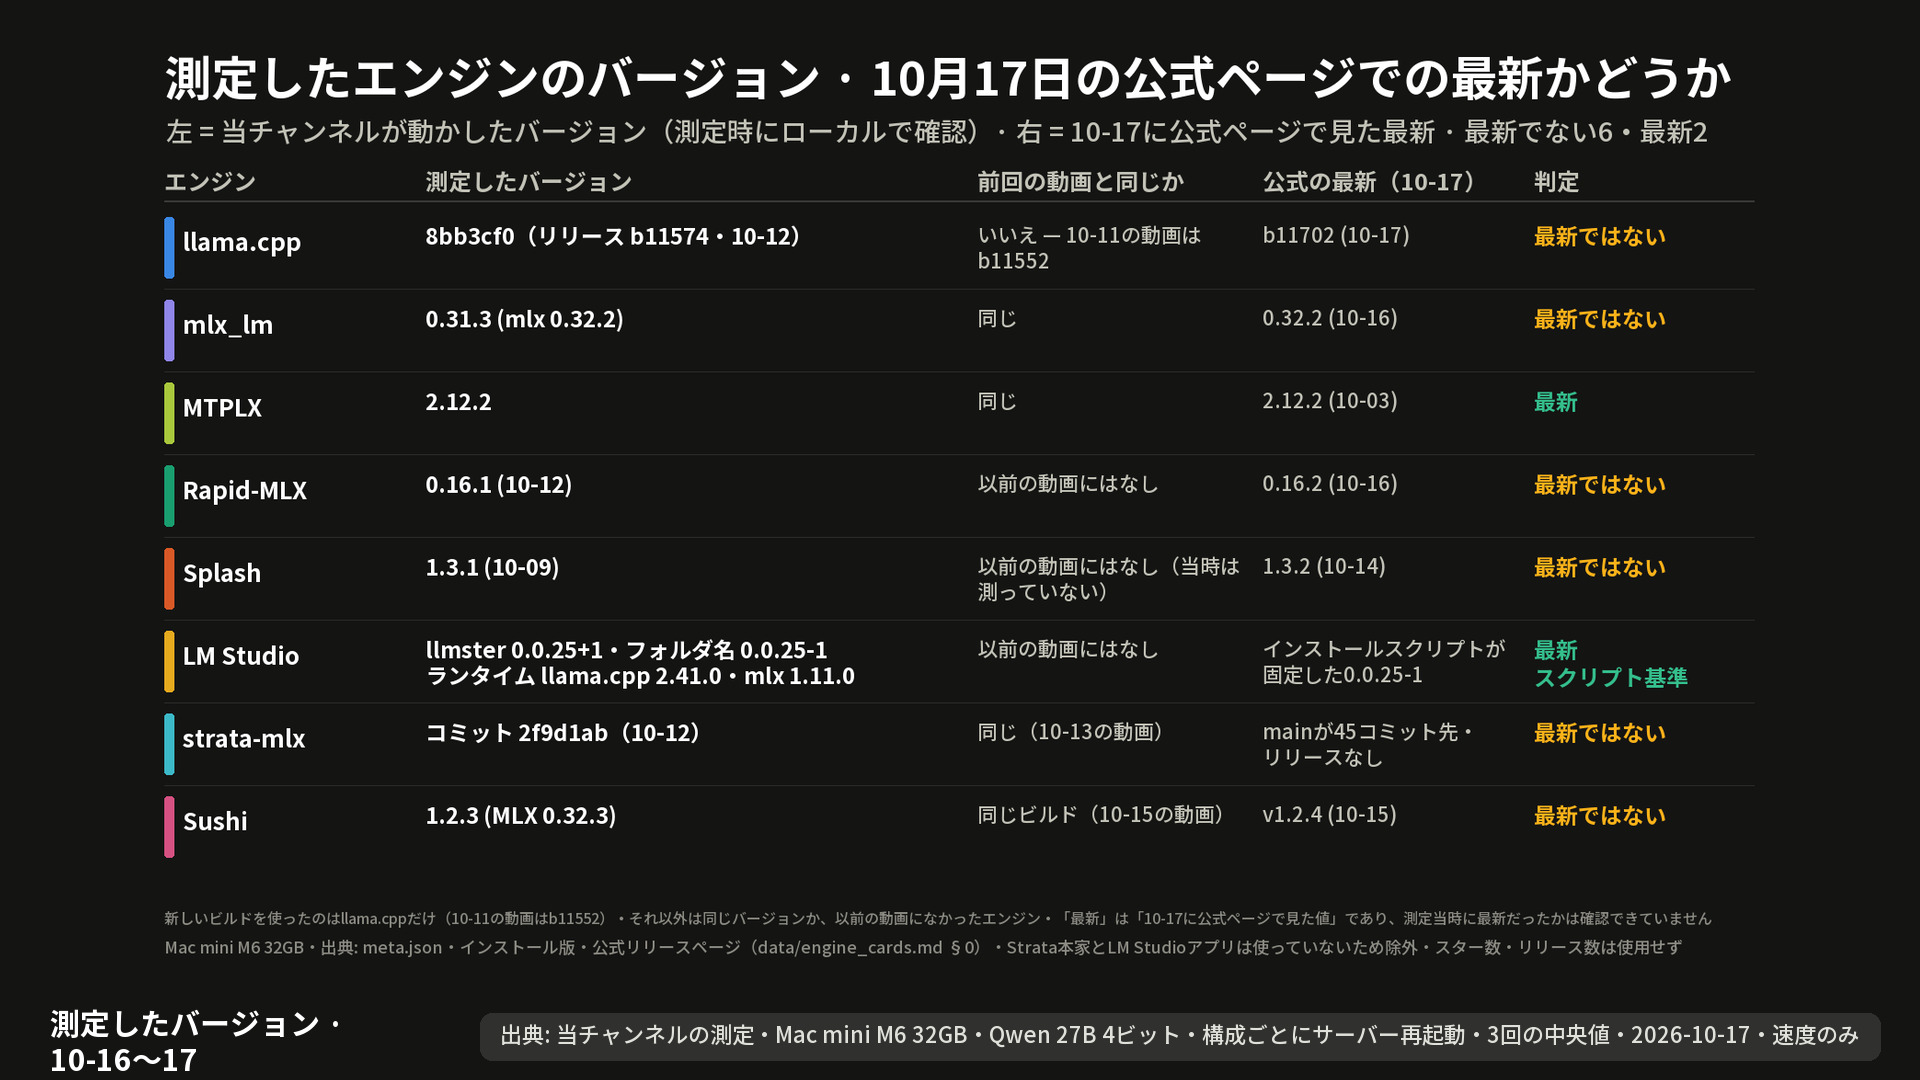
測定は2026-10-16〜17に行い、測ったバージョンはllama.cpp 8bb3cf0・mlx_lm 0.31.3・MTPLX 2.12.2・Rapid-MLX 0.16.1・Splash 1.3.1・Sushi 1.2.3・strata-mlx 2f9d1ab・LM Studio llmster 0.0.25+1です。動画の公開日時点で、公式ページにはMTPLXとLM Studio(インストールスクリプト基準)を除くエンジンに、より新しいバージョンがありました。測定当時に最新だったかは確認できていません。その後バージョンが変わっている可能性があり、現在の速度は確認していません。