RTX Spark対GeForceノート対Mac M5 Max、発売直後の測定とレビューまとめ
投稿日 動画公開
RTX Spark発売直後の整理。24GBに収まるなら5090ノートがSparkの2.3〜2.4倍、100B級は128GB構成。他者の報告に当チャンネルの測定と計算を加えた10-19時点の枠組みです。
発売直後のRTX Sparkノートと、メモリを多く積んだGeForceノート、Mac M5 Maxのどれを選ぶかを整理した記事です(2026-10-19時点)。当チャンネルはRTX Sparkを自分で測定できていません。そこで他の人のレビューや動画の測定値に、当チャンネルの測定と計算を加えて、条件別に判断するための枠組みにまとめました。勝ち負けを決める記事ではありません。
結論から:条件別の判断の枠組み3つ
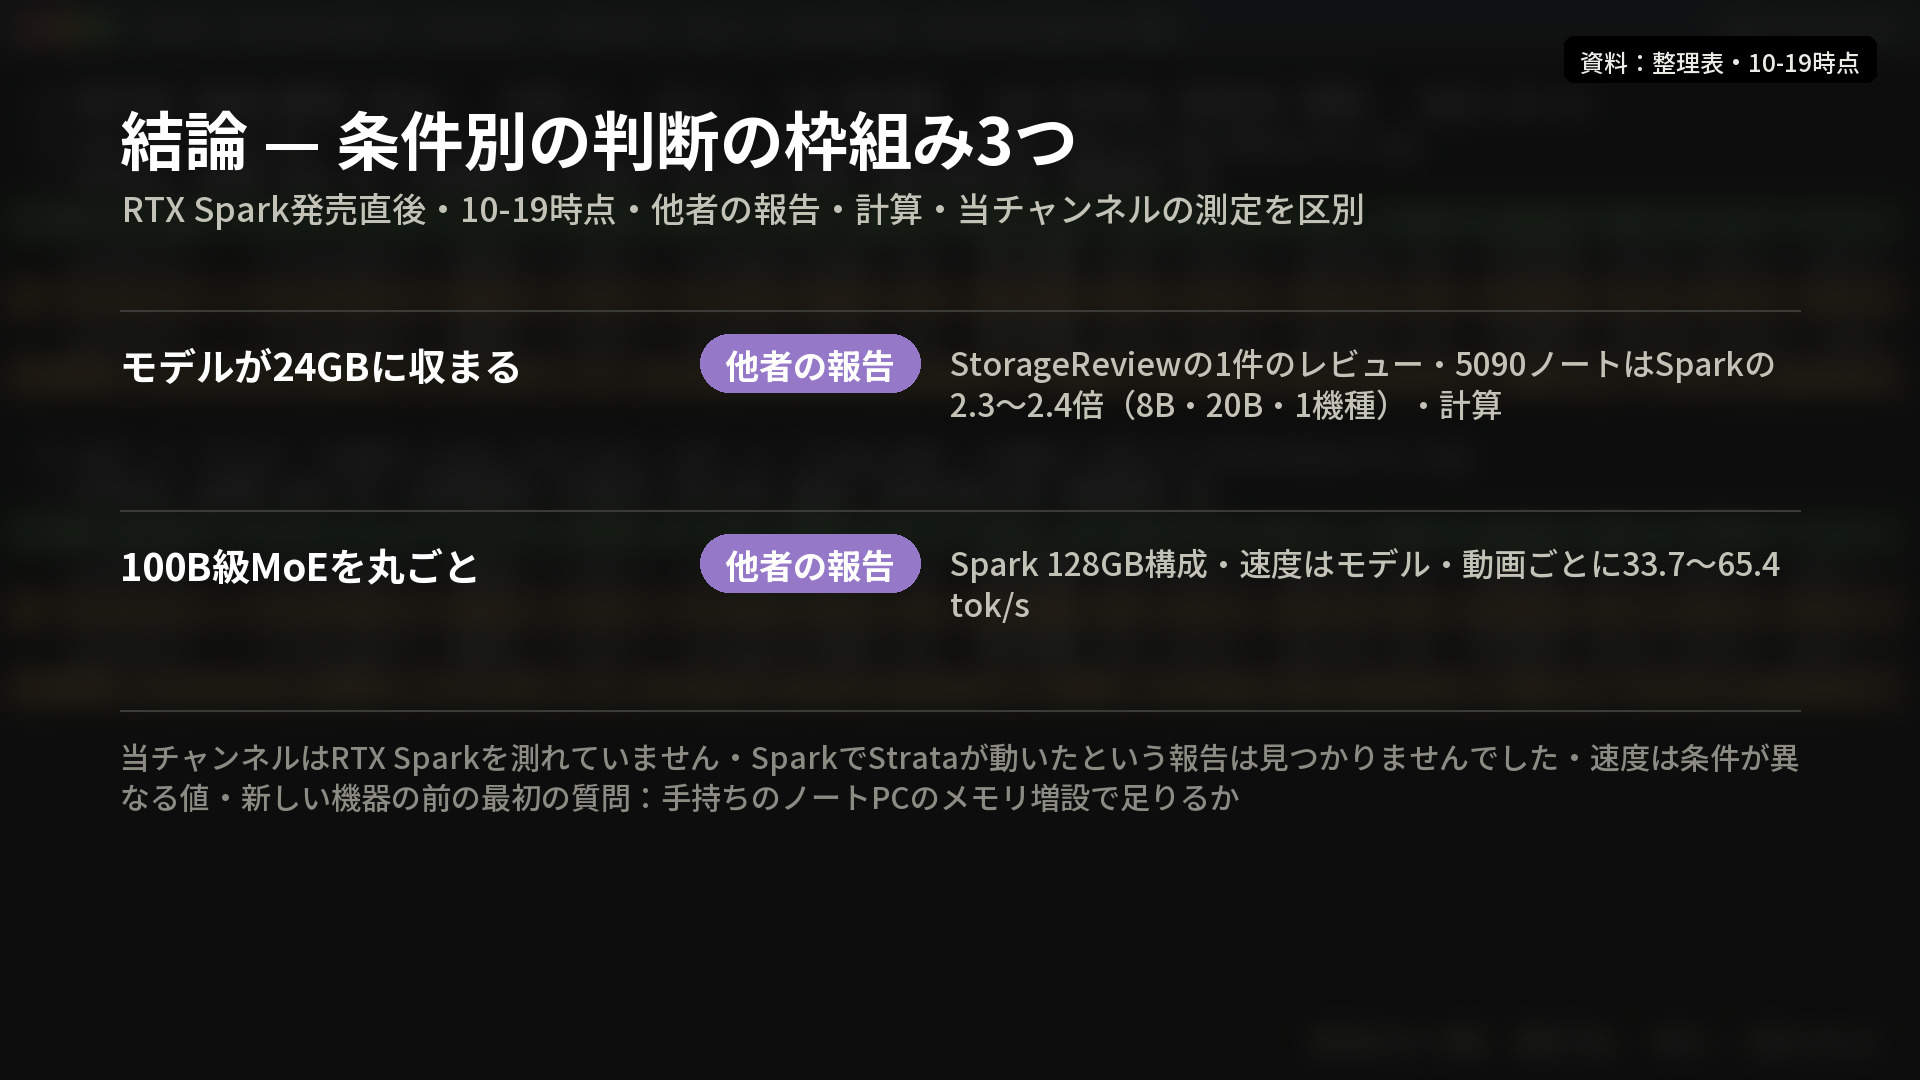
- モデルが24GBに収まる場合、StorageReviewの1件のレビューでは5090ノートがSparkの2.3〜2.4倍でした(Llama 8Bは128.8対56.5、gpt-oss 20Bは137.9対58.0 tok/s、各1台)。
- 100B級のMoEをまるごと載せる必要がある場合、Spark 128GB構成が選択肢です。速度はモデルや動画ごとに33.7〜65.4 tok/sとばらつきました。
- 総メモリはモデルが載るメモリではありません。 HP 128GBモデルはGPUの取り分を64GBに設定しており、使えるのは62.5GBでした。
StrataをRTX Sparkで動かした報告は見つからず、Redditの反応も確認できていません。
まず数字の種類を分けます
- 当チャンネルの測定:レンタルサーバーで自分たちが測った値。サーバーごとにCPU・メモリ上限・電力が違うため、互いに順位づけはしません。
- レビューでの実測(他者の報告):StorageReview、Tom's Hardware、Artificial Analysis、Alex ZiskindやMatthew Monizの動画など、他の人が測った値。ソフトウェアや量子化が異なる、または書かれていないことが多くあります。
- 公式・ドキュメント:NVIDIA開発者向けドキュメントやStrataドキュメントの要件。
- 計算・推定:帯域幅をモデルサイズで割った値など、測定ではないもの。別に表示します。
RTX Sparkはメモリを分け合うチップです
NVIDIA開発者向けドキュメントには、RTX SparkはCPUとGPUがメモリを分け合うチップで、最大128GBのLPDDR5、256ビット、300GB/sと書かれています。モデルが載るかどうかは、モデルのファイルサイズにKVキャッシュを足した値がGPUの使えるメモリに収まるかで判断します。
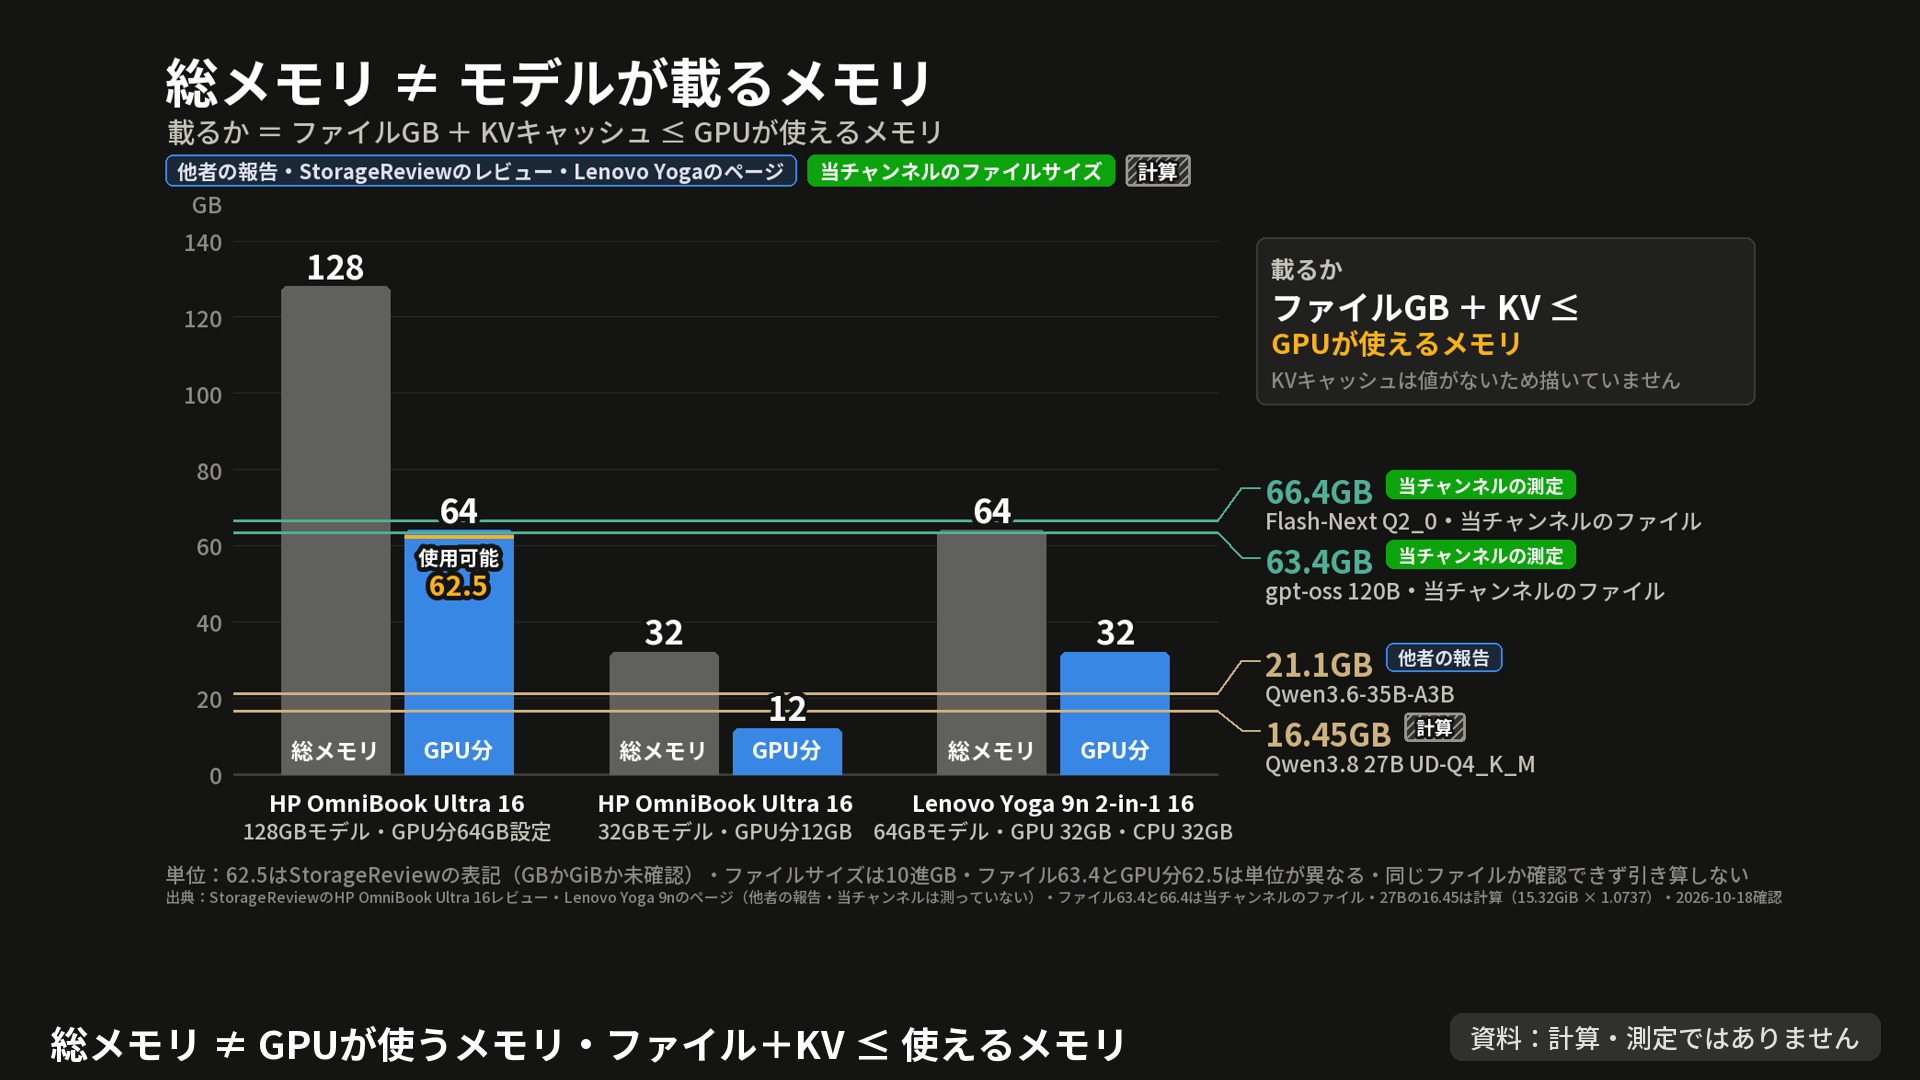
StorageReviewのHPは、GPUの取り分を128GBモデルで64GB、32GBモデルで12GBに設定しており、この比率はNVIDIAアプリで調整できるとのことです。グラフの63.4GB(gpt-oss 120B)と66.4GB(Flash-Next Q2_0)は当チャンネルが持つファイルのサイズで、62.5GBはStorageReviewの表記のため単位(GBかGiBか)は確認できていません。同じファイルかどうか確認できなかったため、互いに引き算して余裕を計算してはいません。
8B〜20B級:24GBに収まるなら5090ノートが先行しました
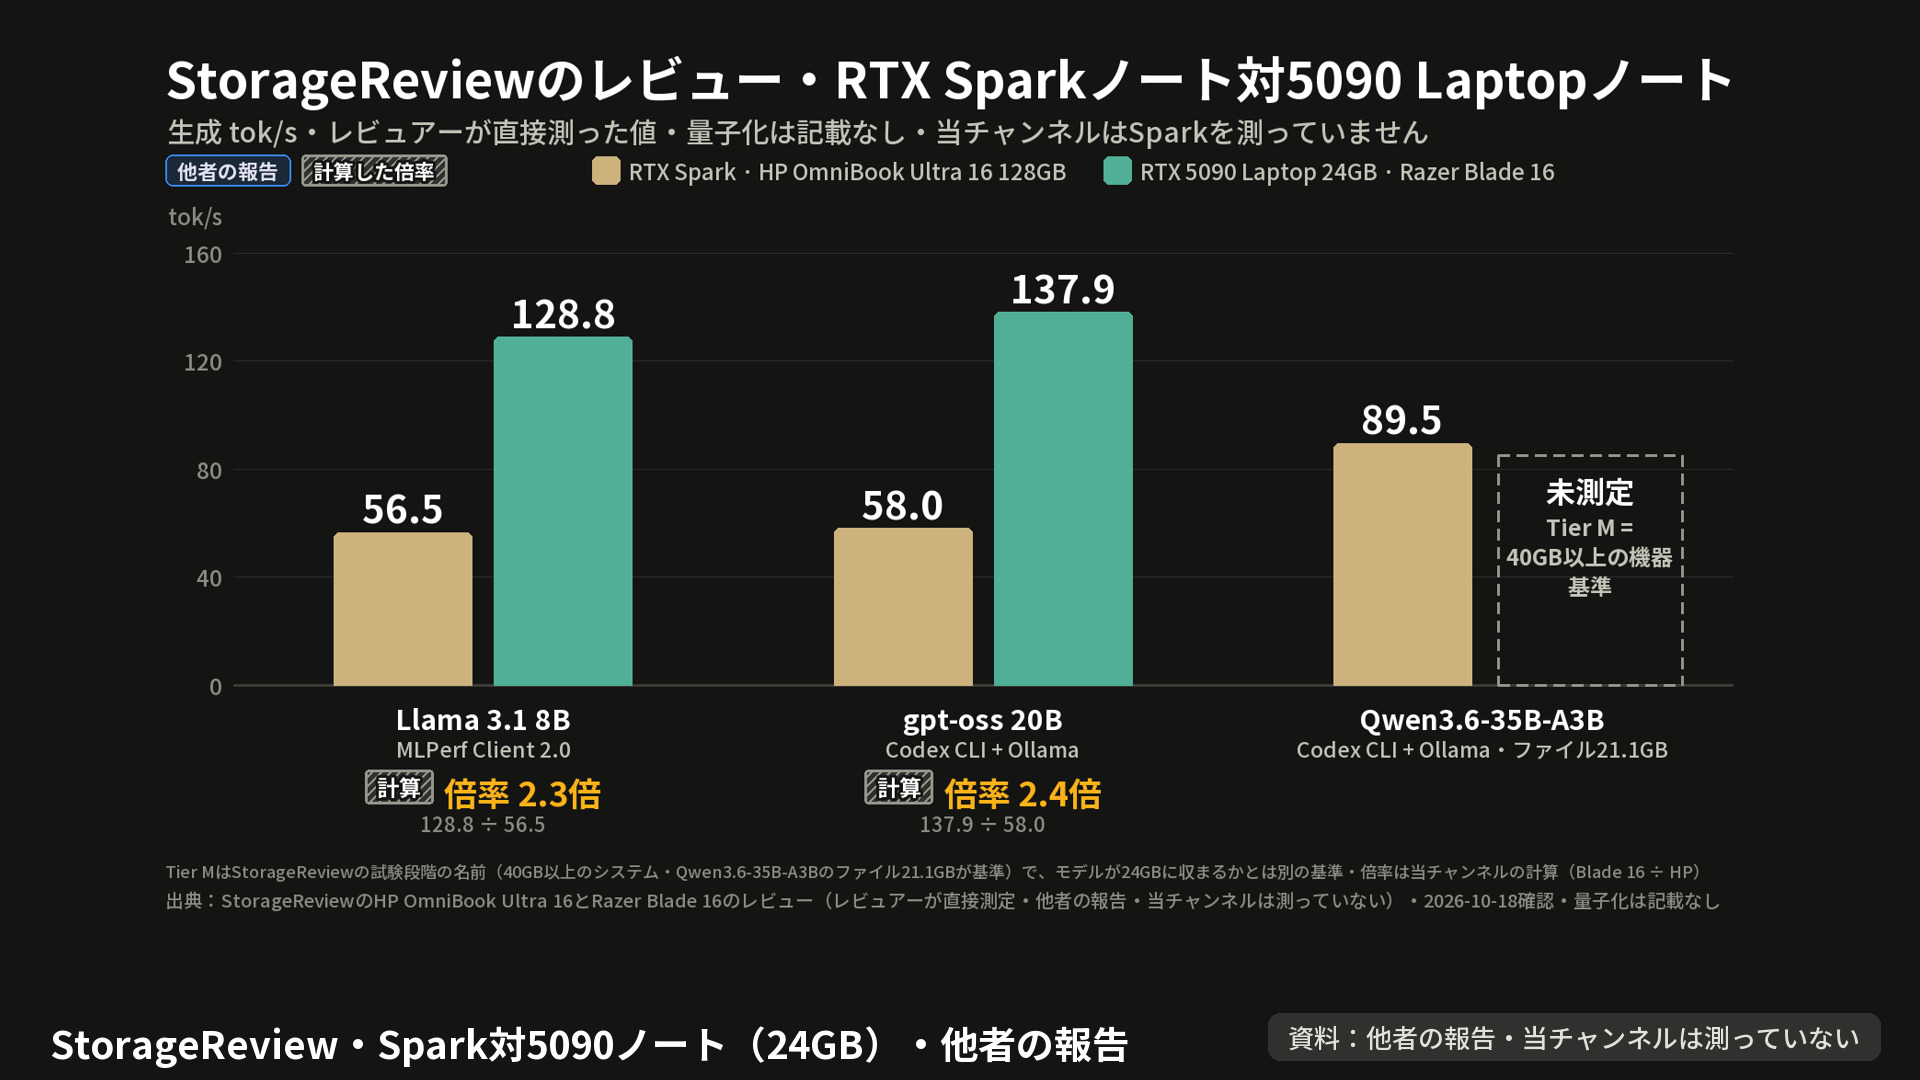
| モデル | RTX Spark(HP OmniBook Ultra 16 128GB) | RTX 5090 Laptop 24GB(Razer Blade 16) | 倍率(当チャンネルの計算) |
|---|---|---|---|
| Llama 3.1 8B(MLPerf Client 2.0) | 56.5 | 128.8 | 2.3倍 |
| gpt-oss 20B(Codex CLI + Ollama) | 58.0 | 137.9 | 2.4倍 |
| Qwen3.6-35B-A3B(ファイル21.1GB) | 89.5 | 未測定 | - |
いずれもStorageReviewのレビュアーが直接測った他者の報告で、量子化は書かれていません。レビューにある「24GBに収まるものは2.3倍」という文と、当チャンネルの計算2.3〜2.4倍は一致します。35Bモデルは、StorageReviewの試験段階(Tier M)が40GB以上のシステムを基準にしているため、Blade 16では行われていません。モデルが24GBに収まるかどうかとは別の基準です。
27B〜35B級:同じ27Bでも13.4から26.32まで
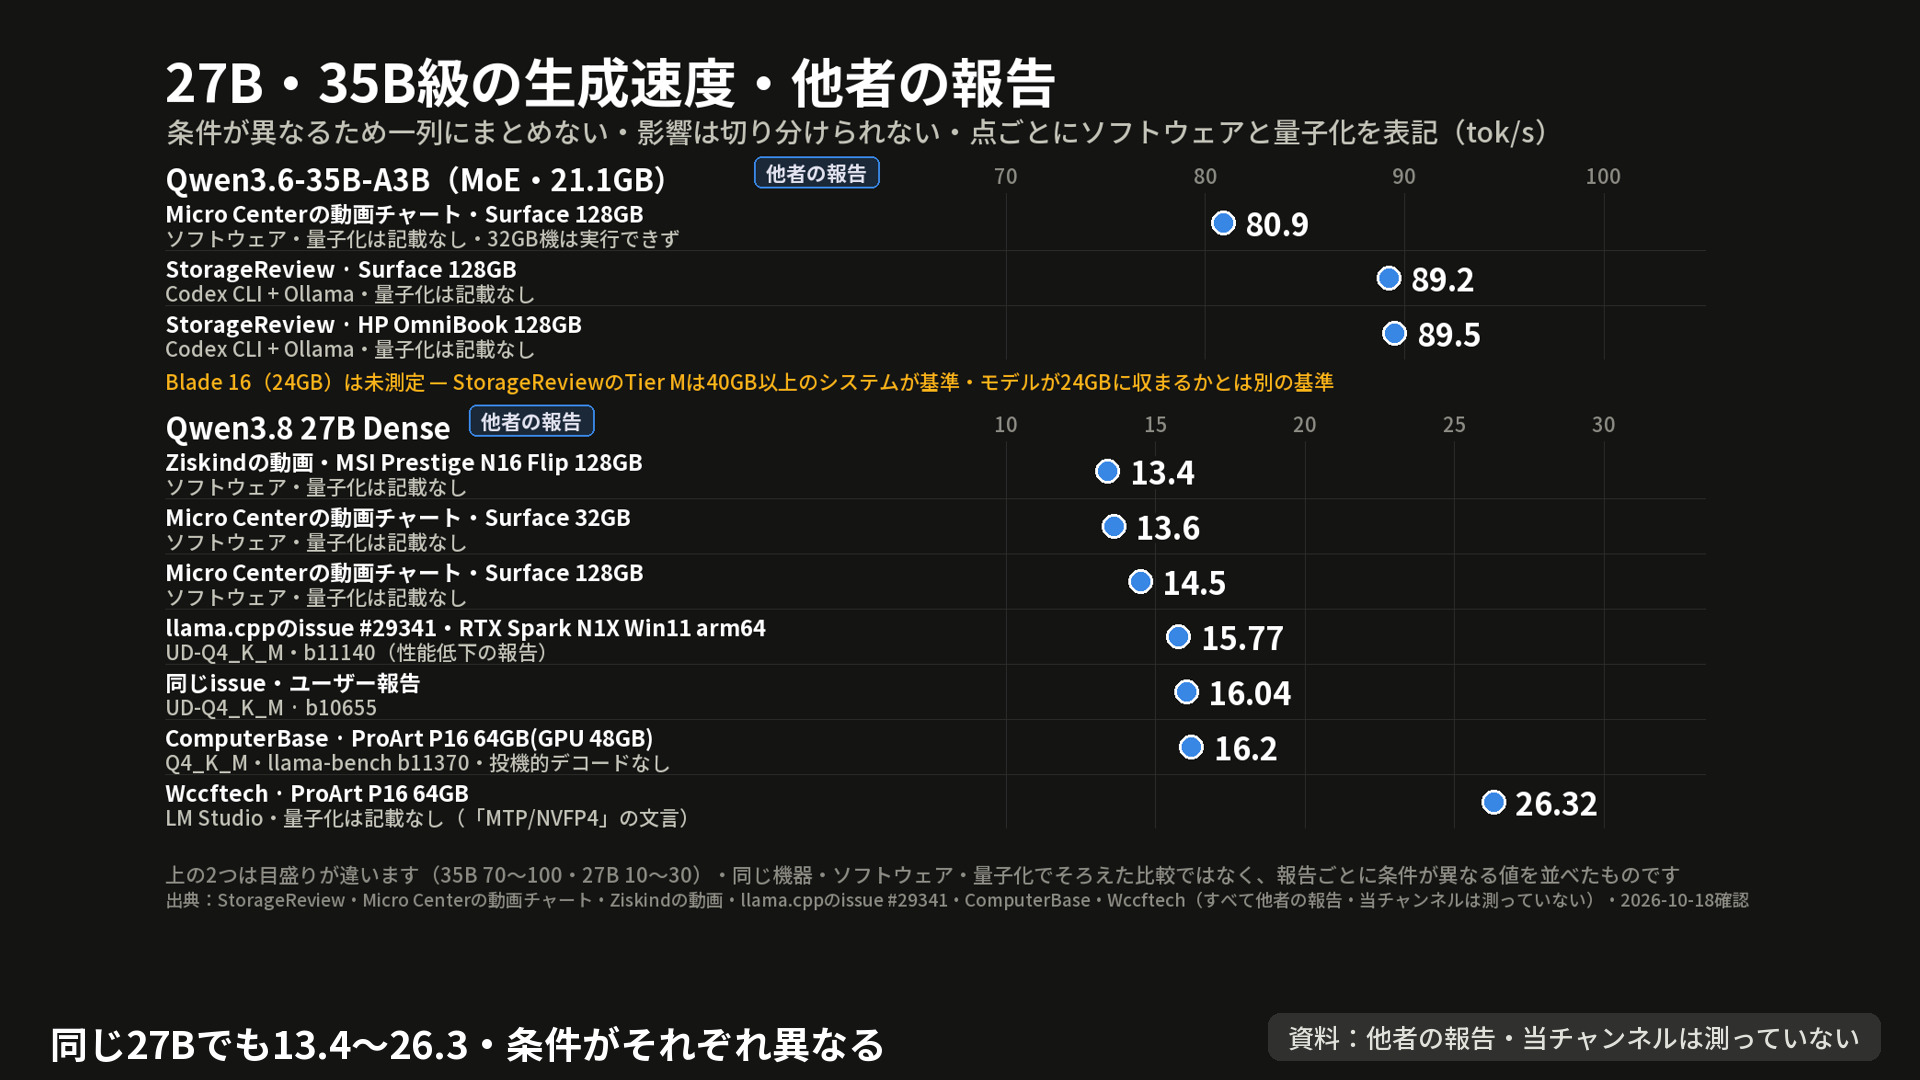
Qwen3.6 35B A3B(MoE)はHP Sparkで89.5 tok/sでした(StorageReview)。動画のチャートにはMicro Centerの80.9もあり、32GBのマシンでは動かなかったと書かれていました。Qwen 27B DenseはZiskindが13.4、Wccftech(LM Studio)が26.32 tok/sで、2倍近い差があります。ソフトウェア・量子化・MTPの記載が異なるため、この差の原因は切り分けられませんでした。このドットプロットは同じ条件での比較ではなく、報告ごとに条件が違う値を並べたものです。
Macと比べた報告:方向は試験ごとに分かれます
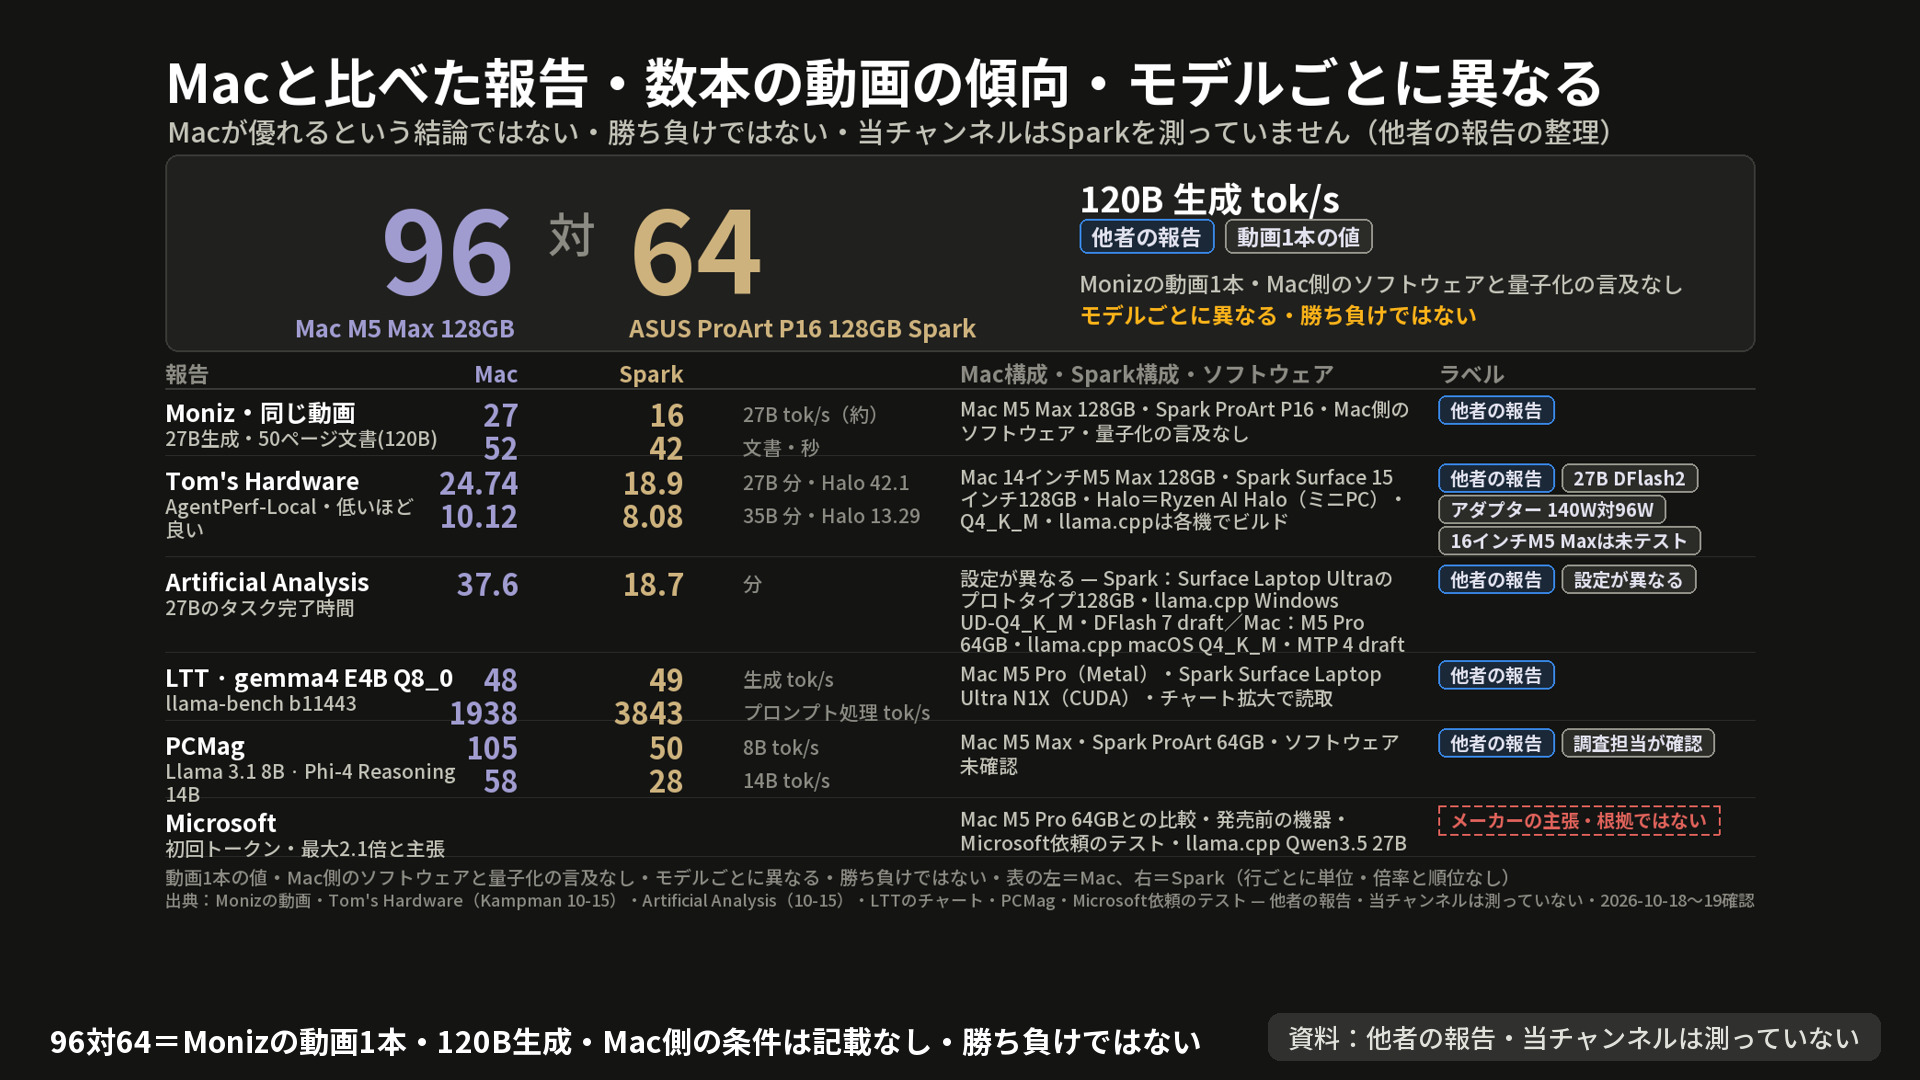
- Monizの動画1本:120Bの生成速度は、128GBのM5 Maxが96、ASUS ProArt P16(128GBのSpark)が64で、同じ動画の27B生成は27対16でした。その動画ではMac側のソフトウェアと量子化への言及はありませんでした。
- Tom's Hardwareの27Bエージェント作業(AgentPerf-Local)の完了時間は、Surface Laptop Ultra 128GBが18.9分、MacBook Pro 14インチM5 Max 128GBが24.74分でした(低いほど良い)。アダプターは140W対96Wと異なり、16インチM5 Maxは試験されていません。
- Artificial AnalysisのM5 Pro 64GBは37.6分です。Spark側は設定が異なるため、この値と並べて読むことはできません。
方向が試験ごとに分かれるため、どちらが優れているという結論ではありません。
100B級以上:128GB構成では33.7〜65.4
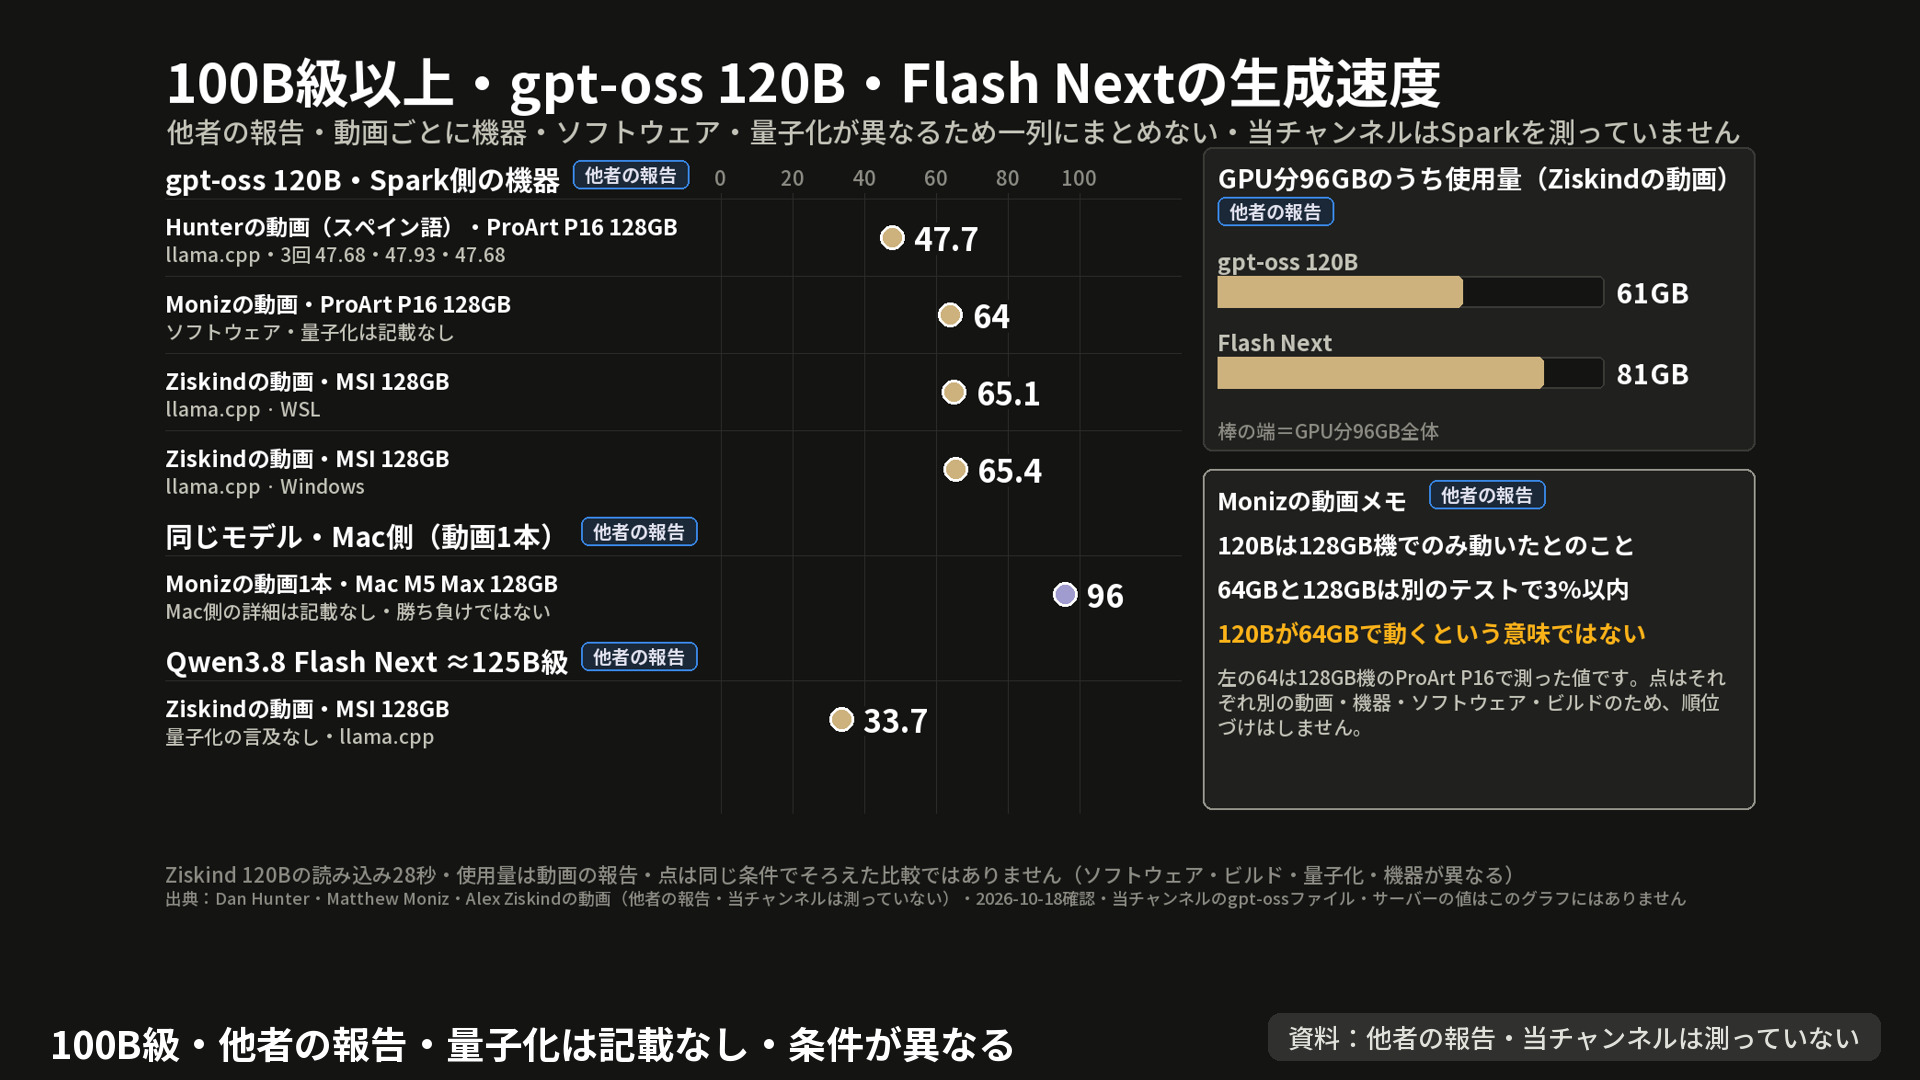
gpt-oss 120BはZiskindが65.4、Dan Hunterが47.7 tok/sでした。Flash Next(約125B級)はZiskindの動画で、量子化への言及なしに33.7 tok/sでした。Ziskindの動画の120Bは、GPU取り分96GBのうち61GBを使っています。Monizの動画は、120Bは128GBのマシンでしか動かなかったと述べていました。各点は動画・機器・ソフトウェア・ビルドが異なるため、順位づけはしません。
当チャンネルの測定:メモリが足りないと読み込み速度が落ちました
StrataでFlash Nextをレンタルサーバー上で測りました。Strataは、大きなMoEモデルのうちGPUに最も多く使う専門家を載せ、残りをメモリとプロセッサが処理する方式のエンジンで、メモリが足りないとSSDから読み込みます(ドキュメントによる)。StrataのドキュメントはVRAM 12GB以上、メモリ32GB以上を要求しています(64GBならすべてのサイズ)。
- RTX 3060 12GB(コンテナのメモリ上限42.6GiB):Q2_0の韓国語生成39.5 tok/s(範囲37.4〜40.1、10-13)
- RTX 3090 24GB(サーバーA):Q2_0の韓国語112.1、IQ3_S 98.9 tok/s(10-14)
- 同じ3090でメモリを32GiBに減らすと(占有プロセスによる再現値で、実際にそのメモリを持つ機械ではありません)、4,000トークンの読み込み速度はQ2_0が2277から1664、IQ3_Sが2045から207 tok/sに落ちました。
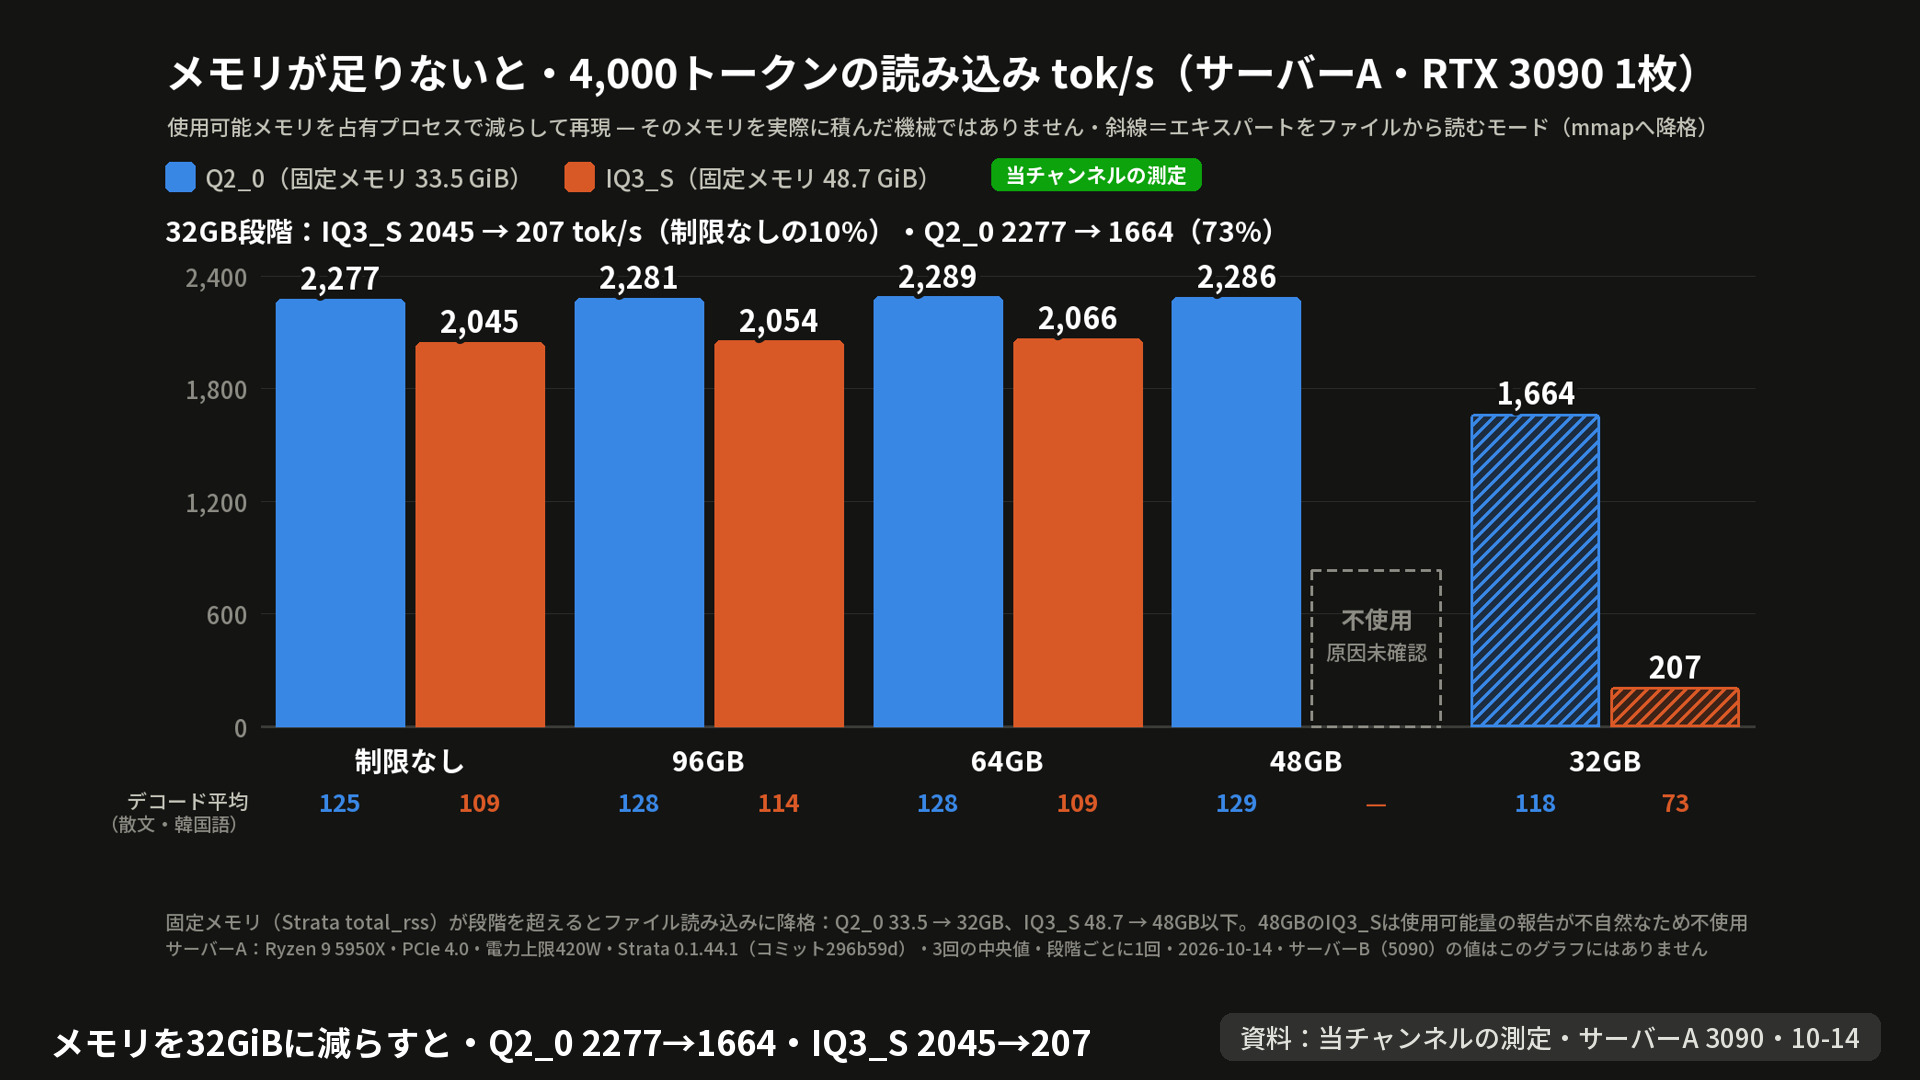
Mac mini側のStrata値は動画の画面カードにあり、チップが違うためSparkとは並べていません。帯域幅も、NVIDIAドキュメントの仕様とCPU側の実測では測った場所が違うため、合算していません。
計算:帯域幅から見た27Bの生成上限(測定ではありません)
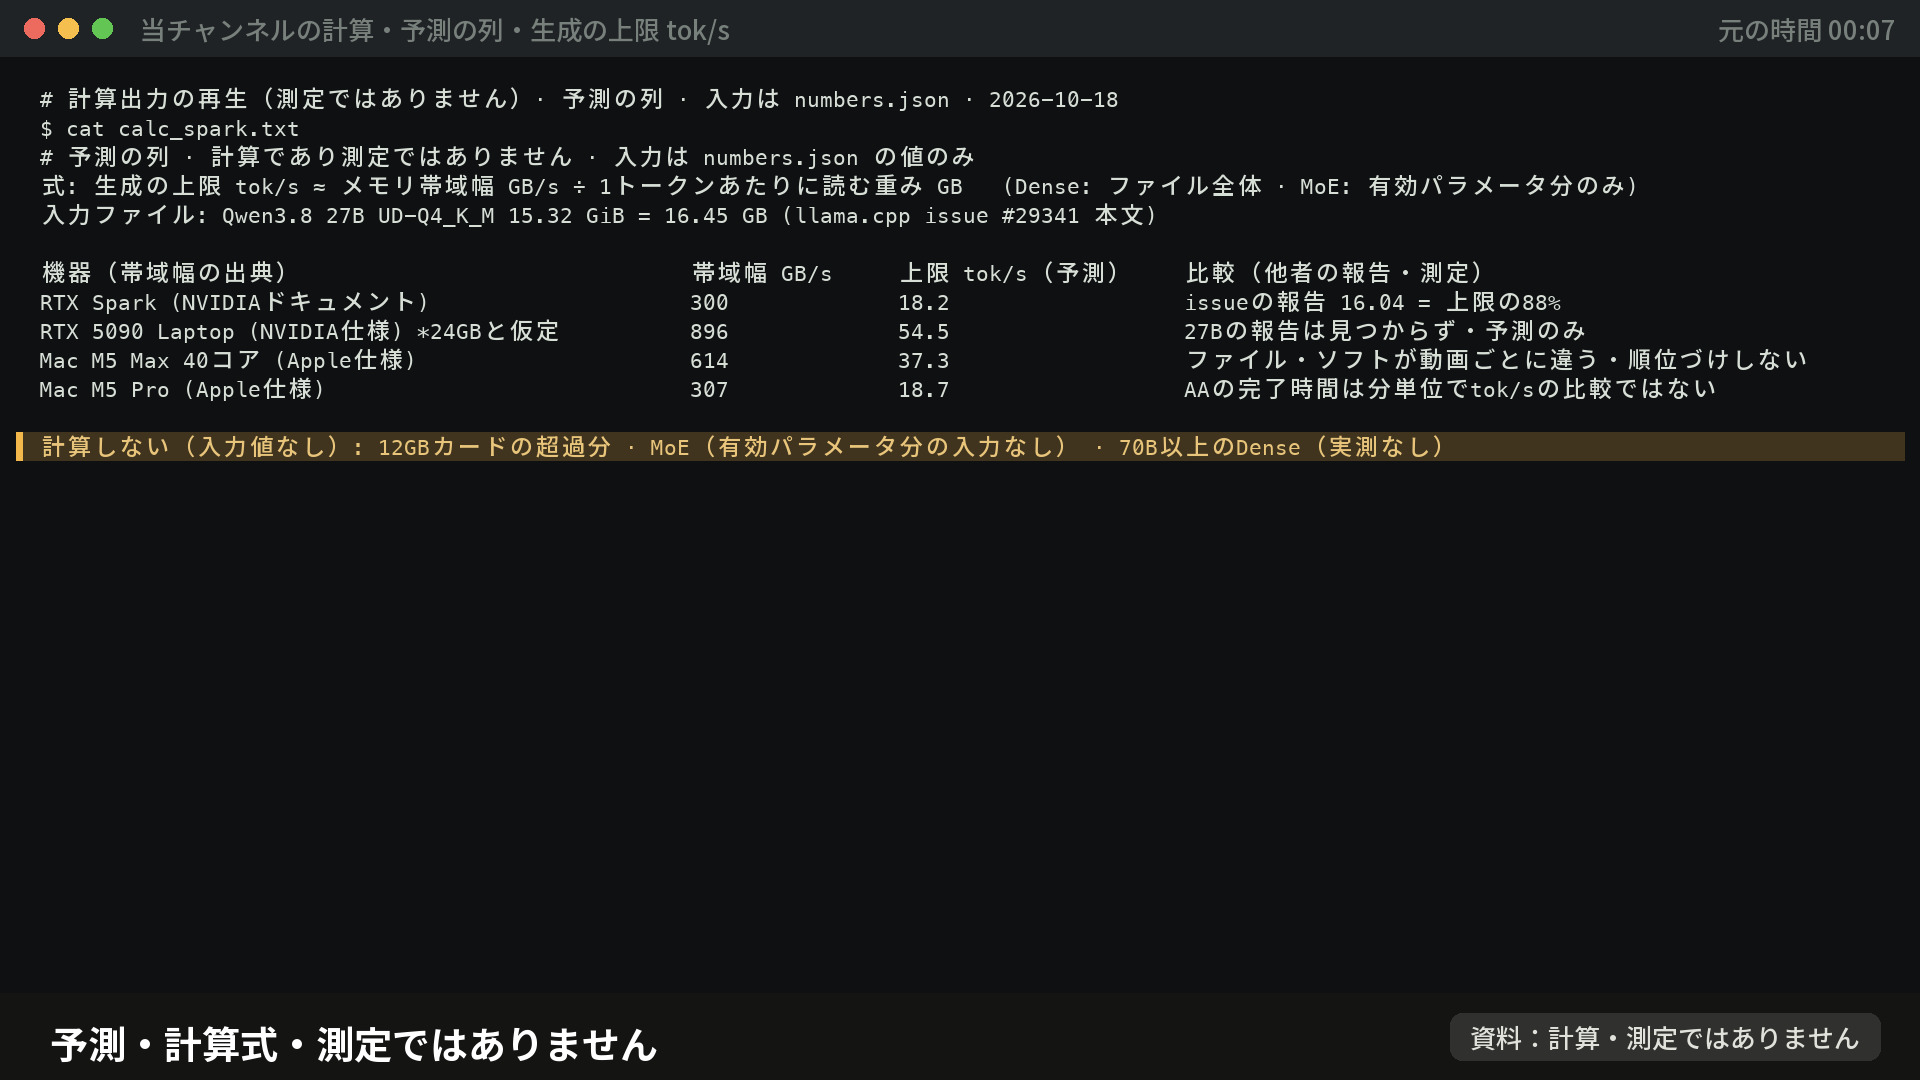
生成上限は、帯域幅を1トークンあたりに読む重みのサイズで割った値です。27Bのファイル16.45GBにSparkの300GB/sを当てはめると18.2 tok/sで、llama.cppのissueに投稿されたユーザー報告の16.04はその88%です。5090ノートは、このファイルが24GBのカードに収まると仮定して仕様の896GB/sを当てはめると54.5 tok/sですが、27Bの実測報告は見つかりませんでした。あくまで推定です。
モデル選びは「載るか、速度、品質」の順に
速度は他者の報告を使い、品質は当チャンネルが測ったものだけを使います。Qwen 27Bは当チャンネルのKMMLU 150問で、UD-Q4_K_XLが98、IQ3_XXSが96、IQ2_Mが93となり、区別できませんでした。Flash Nextは450問でQ2_0が303、UD-IQ4_XSが334でした。ほかのモデルには当チャンネルの品質測定がありません。
新しい機器の前に:手持ちのノートでできるか
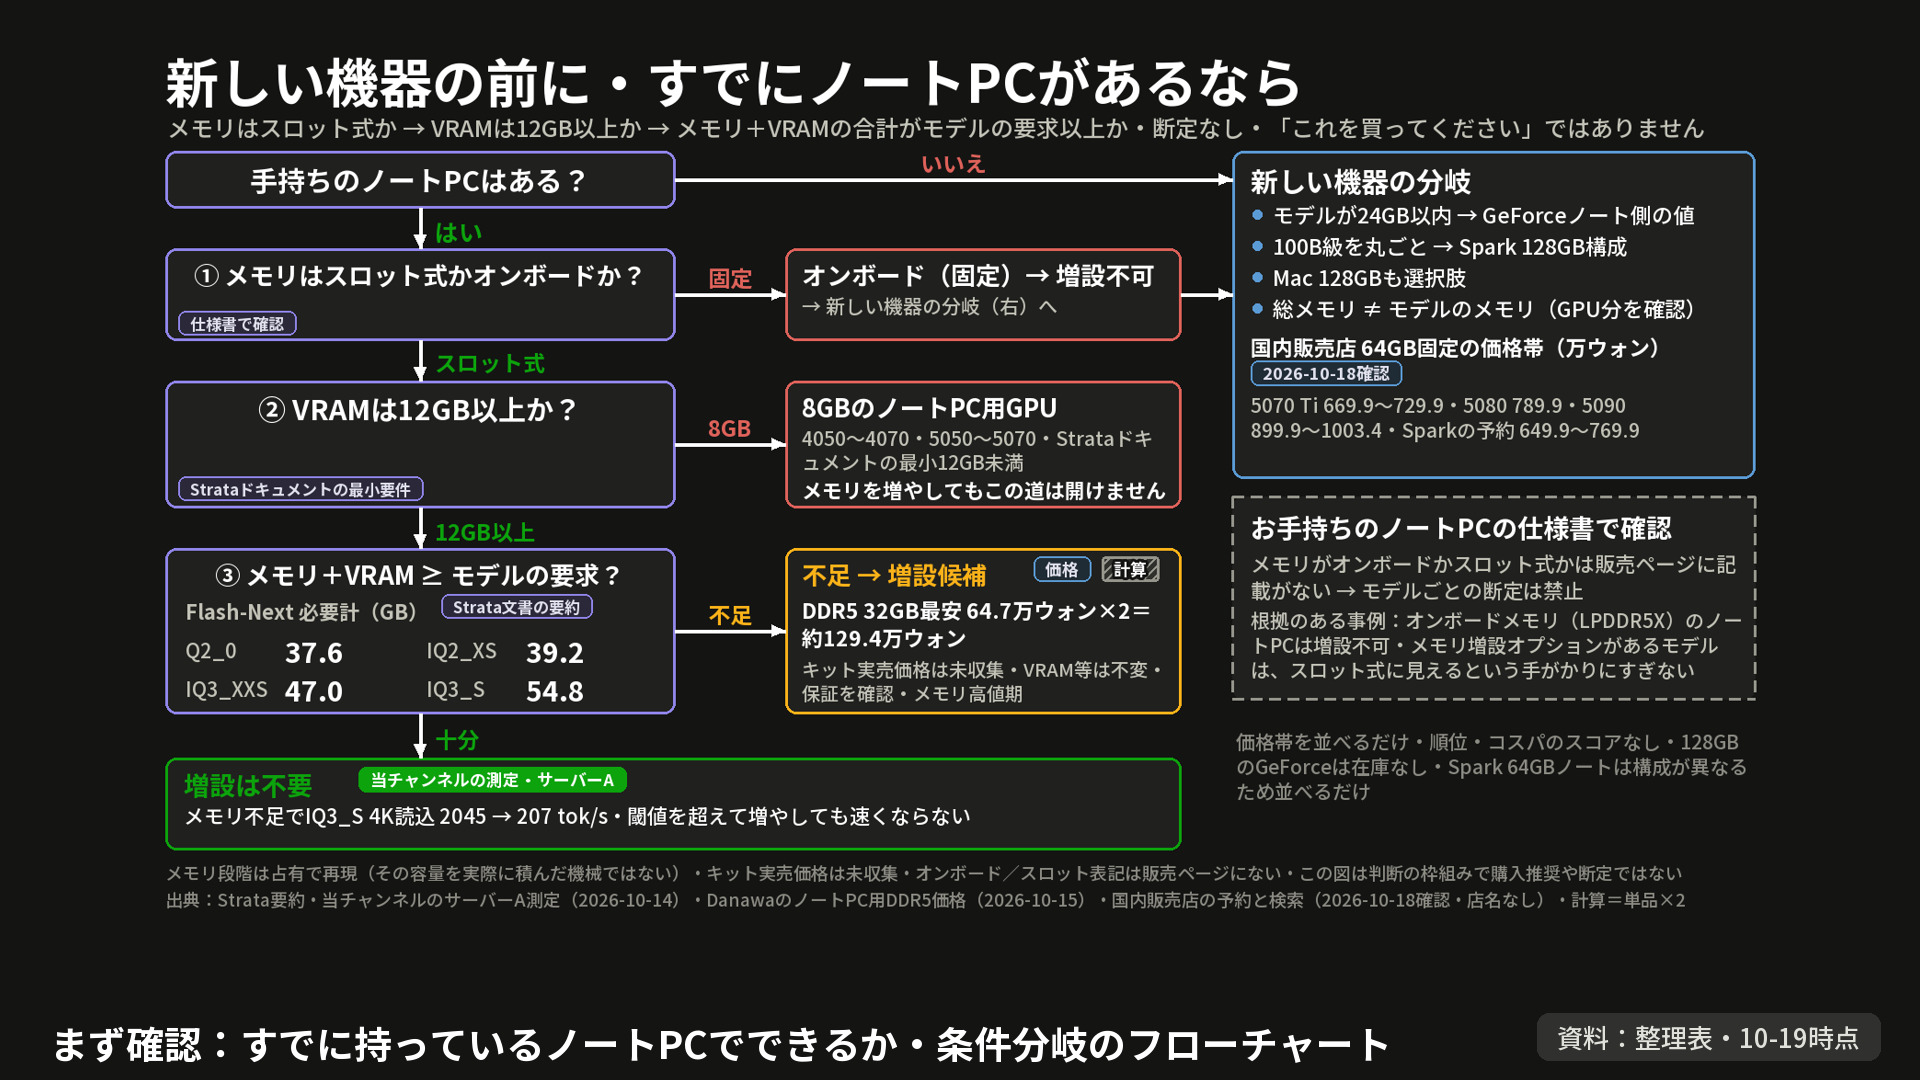
最初の質問は、手持ちのノートにメモリを足すだけで足りるかです。メモリがスロット式ではなくオンボードなら増設できず、次はVRAMが12GB以上かどうかです。VRAM 8GBのノートは、メモリを増やしてもStrataドキュメントの最小要件に届きません。メモリとVRAMの合計は、Flash Next Q2_0が37.6GB、IQ3_Sが54.8GBです。当チャンネルの占有による再現測定では、メモリが足りないと4,000トークンの読み込みが2045から207に落ちましたが、増やし続けても速くなり続けるわけではなく、SSD読み込みを避けられる閾値までです。ノート用DDR5 32GBの単品はDanawa(10-15)で最安約65万ウォン(韓国での価格)なので、2枚(64GB)は計算上約129万ウォンで、VRAMは増えません。
韓国での価格(国内の販売店で10月18日に確認)
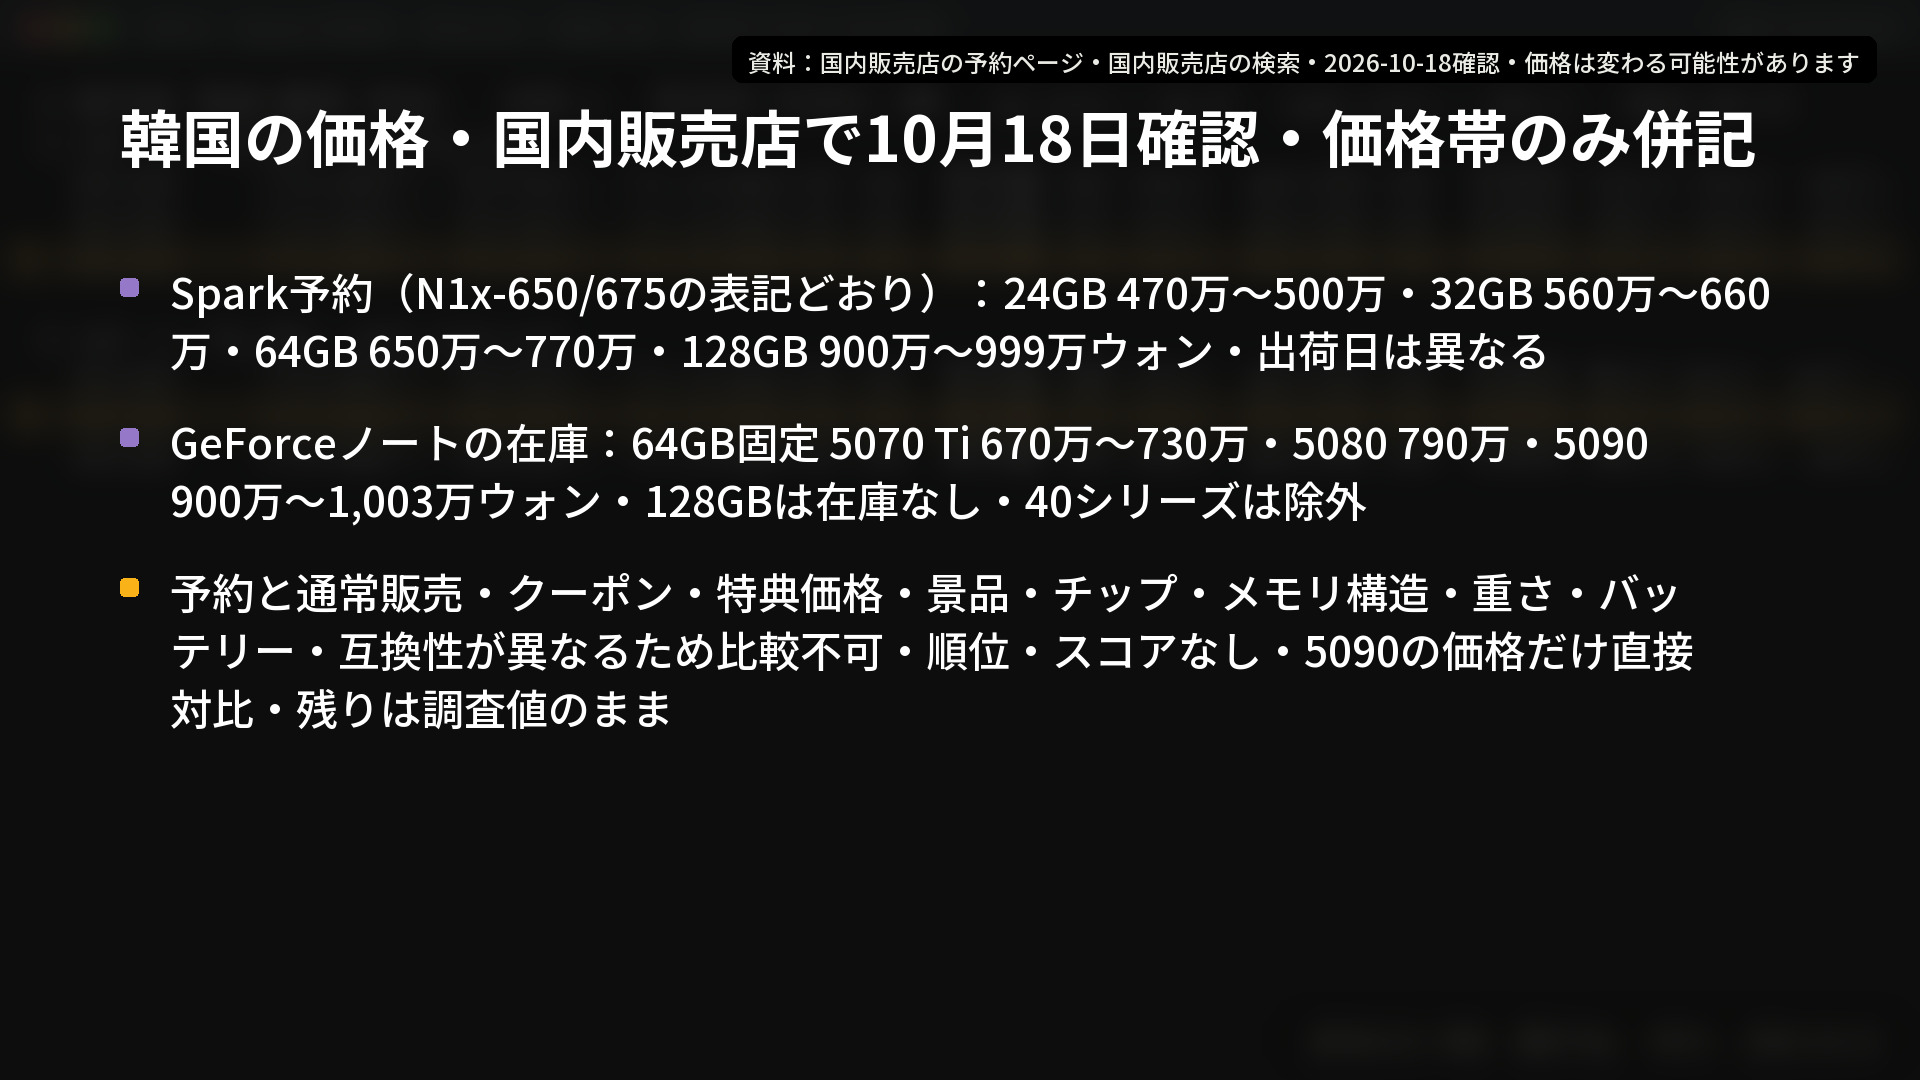
| 構成 | RTX Spark予約 | GeForceノート(在庫、メモリ固定構成) |
|---|---|---|
| 64GB | 650万〜770万ウォン | 5070 Ti 670万〜730万、5080 790万、5090 900万〜1,003万ウォン |
| 128GB | 900万〜999万ウォン | 在庫なし |
Spark 24GBは470万〜500万ウォン、32GBは560万〜660万ウォンでした。予約販売、クーポン、特典、チップ、メモリ構造、重さ、バッテリーが異なるため、順位やスコアはつけていません。MacBook Pro 14インチM5 Max(40コアGPU)の128GB・2TBは、Apple韓国ストアで1,141万ウォンでした。価格は変わる可能性があります。
互換性と安定性:別々の2件の報告
互換性は、llama.cpp、Ollama、LM Studioで動作報告があり、Strataにはありません。安定性は異なる2件です。StorageReviewではSurfaceが10月14日の夜、OpenBLASの数値計算負荷で3回電源が落ち、HPは同じ負荷を完走しました。The RegisterのHPでは、約1時間続いた推論でGPUが90°Cを超え、画面の乱れと断続的な停止が出ましたが、休ませると安定したとのことです。負荷も機器も異なるため、合わせて読むことはしません。
限界
- 当チャンネルはRTX Sparkを測定できておらず、測定したDGX Spark(GB10)の値はRTX Sparkではありません。
- 他者のレビューはソフトウェア・量子化・機器が異なるため、直接比較できません。発売直後の資料で、独立したレビューはまだ少なく、韓国は予約販売のため出荷日が製品ごとに異なりました。
- この記事は判定ではなく、選ぶための枠組みです。新しい資料が出たら動画の概要欄を直すとしていたため、最新の値はそちらをご確認ください。
基準日:2026-10-19(動画公開日は2026-10-20)。その後に変わった価格やレビューは反映していません。