딥시크(DeepSeek) V4.1 RTX 4090 27.9 tok/s, 쓸 수 있는 램을 64GiB로 줄이면 15.0
올린 날 영상 공개
딥시크(DeepSeek) V4.1 플래시를 RTX 4090 24GB 서버 한 대에서 스트라타(Strata)로 쟀더니 초당 27.9토큰, 엔진이 쓸 수 있는 램만 64GiB로 줄인 시험에서는 15.0토큰이었습니다. 한국어 객관식은 150문제 중 106개 정답.
딥시크(DeepSeek) V4.1 플래시(Flash)를 평균 2.25비트로 줄인 274GB 판을 스트라타(Strata) 0.2.13.1로, 클라우드로 빌린 서버 한 대(RTX 4090 24GB, 램 유효 180.6GiB)에서 돌려 쟀습니다. 짧은 질문의 생성 속도는 초당 27.9토큰(세 번 중앙값, 범위 24.0~30.5)이었고, 엔진이 쓸 수 있는 램을 64GiB로 줄이자 15.0토큰까지 내려갔지만 멈추지는 않았습니다. 한국어 객관식 150문제는 106개(70.7%)를 맞혔습니다.
모두 이 서버 한 대에서 한 번의 시험으로 잰 값입니다(속도는 3회 중앙값). 램 읽기 속도(이 서버의 최고값 초당 61.4GB)가 다른 컴퓨터에서는 같은 값이 나온다고 보장할 수 없습니다.
결론 먼저
- 속도: 입력을 약 3만 1천 토큰으로 늘려도 생성은 초당 25.3토큰이었지만 첫 글자까지 18.8초가 걸렸고, 약 11만 9천 토큰 입력은 60.6초였습니다.
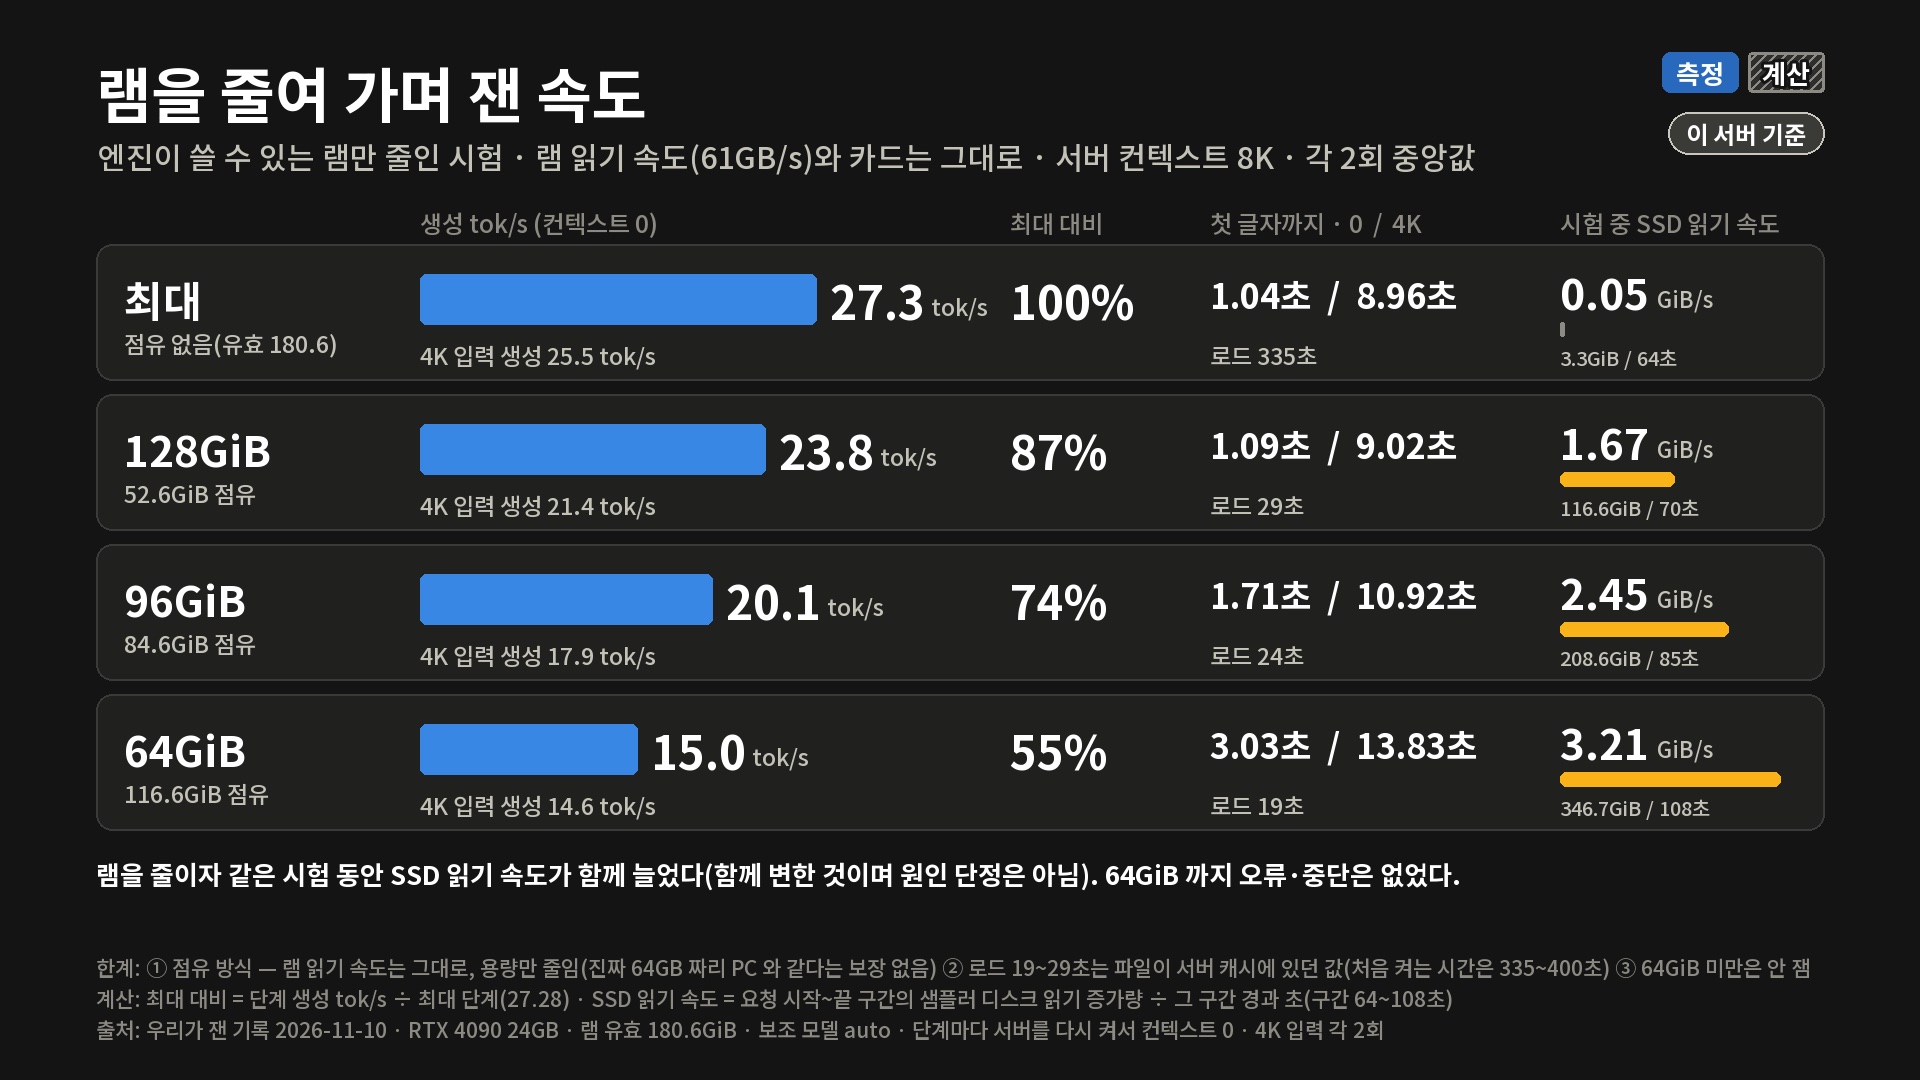
- 램: 엔진이 쓸 수 있는 램을 180.6GiB에서 128, 96, 64GiB로 줄이자 27.3, 23.8, 20.1, 15.0토큰으로 내려갔습니다(최대 대비 87, 74, 55%). 용량만 줄인 시험입니다.
- 한국어·코딩: KMMLU 150문제 중 106개(95% 구간 62.9~77.4%). 코딩은 전체 52문제 중 앞 20개만 풀려 16개, 도구 호출은 49과제 중 앞 15개에서 14개를 통과했습니다. 비교 모델이 없어 좋고 나쁨은 말하지 않습니다.
이 글의 숫자 종류
- 우리 측정: 이 서버에서 직접 잰 값입니다. 속도는 3회(긴 입력은 2회) 중앙값입니다.
- 계산: 우리 값으로 한 산수입니다(최대 대비 %, 채택률, 신뢰구간, 비용).
- 프로그램 출력: 스트라타가 서버에서 낸 계획과 지표입니다.
- 공식 문서·타인 보고: 스트라타 저장소 문서와 거기에 인용된 다른 사람의 값입니다. 우리 값과 같은 줄에 놓지 않습니다.
- 추정: 숫자로는 쓰지 않았습니다.
274GB 모델이 도는 방식
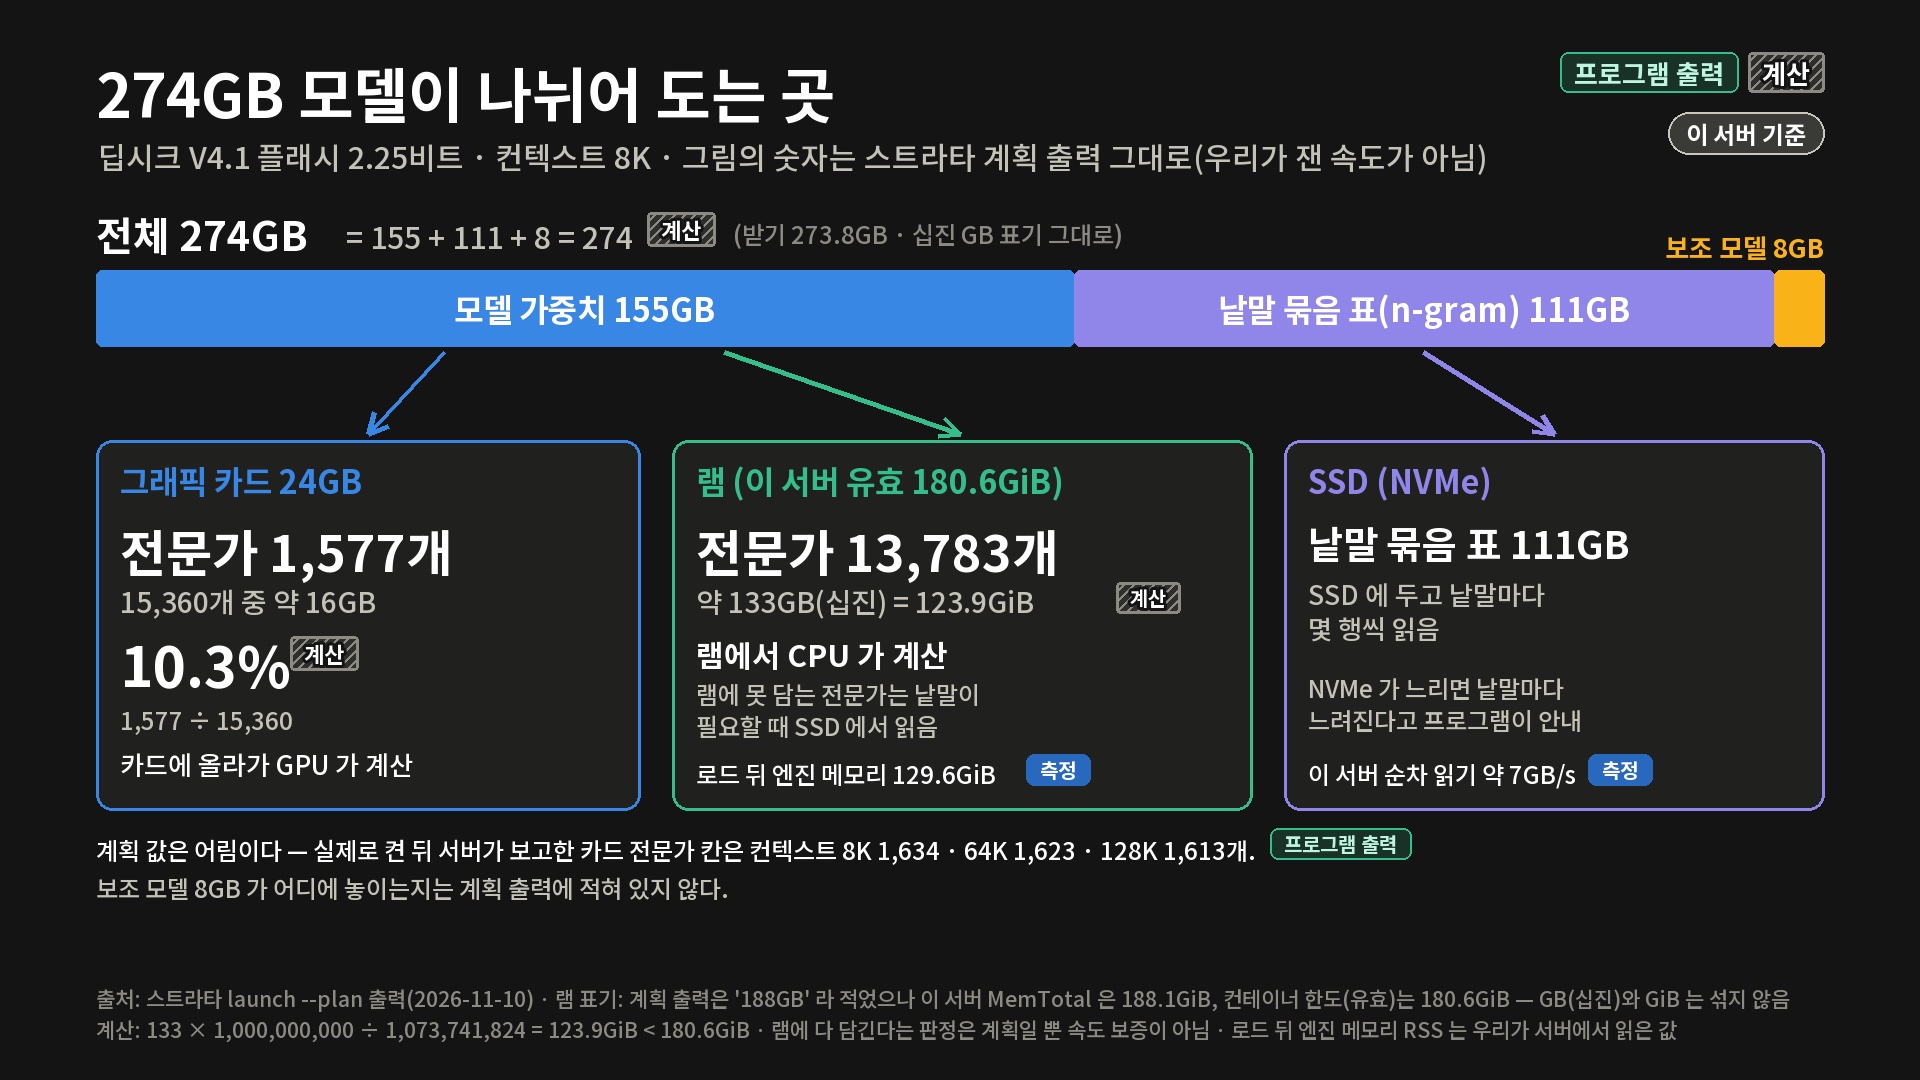
274GB는 본체 155GB, 낱말 묶음 표(n-gram) 111GB, 보조 모델(DSpark) 8GB를 더한 값입니다(프로그램 출력). 24GB 카드에는 통째로 들어가지 않습니다. 프로그램이 낸 계획은 전문가 15,360개 중 1,577개(약 16GB, 10.3%)만 카드에 올리고, 나머지 13,783개(약 133GB)는 CPU가 램에서 계산하며, 램에 못 담는 것과 n-gram 표는 SSD에서 읽는 것이었습니다. 1,577개는 계획값이고, 실제로 켠 서버가 보고한 카드 위 전문가 칸은 컨텍스트 8K에서 1,634개, 64K에서 1,623개, 128K에서 1,613개였습니다.
스트라타 문서에는 24GB 카드로 잰 딥시크 수치가 없고, 제작자도 RTX 40 시리즈로 직접 시험하지 못했다고 적혀 있습니다(공식 문서, 2026-11-10 조회).
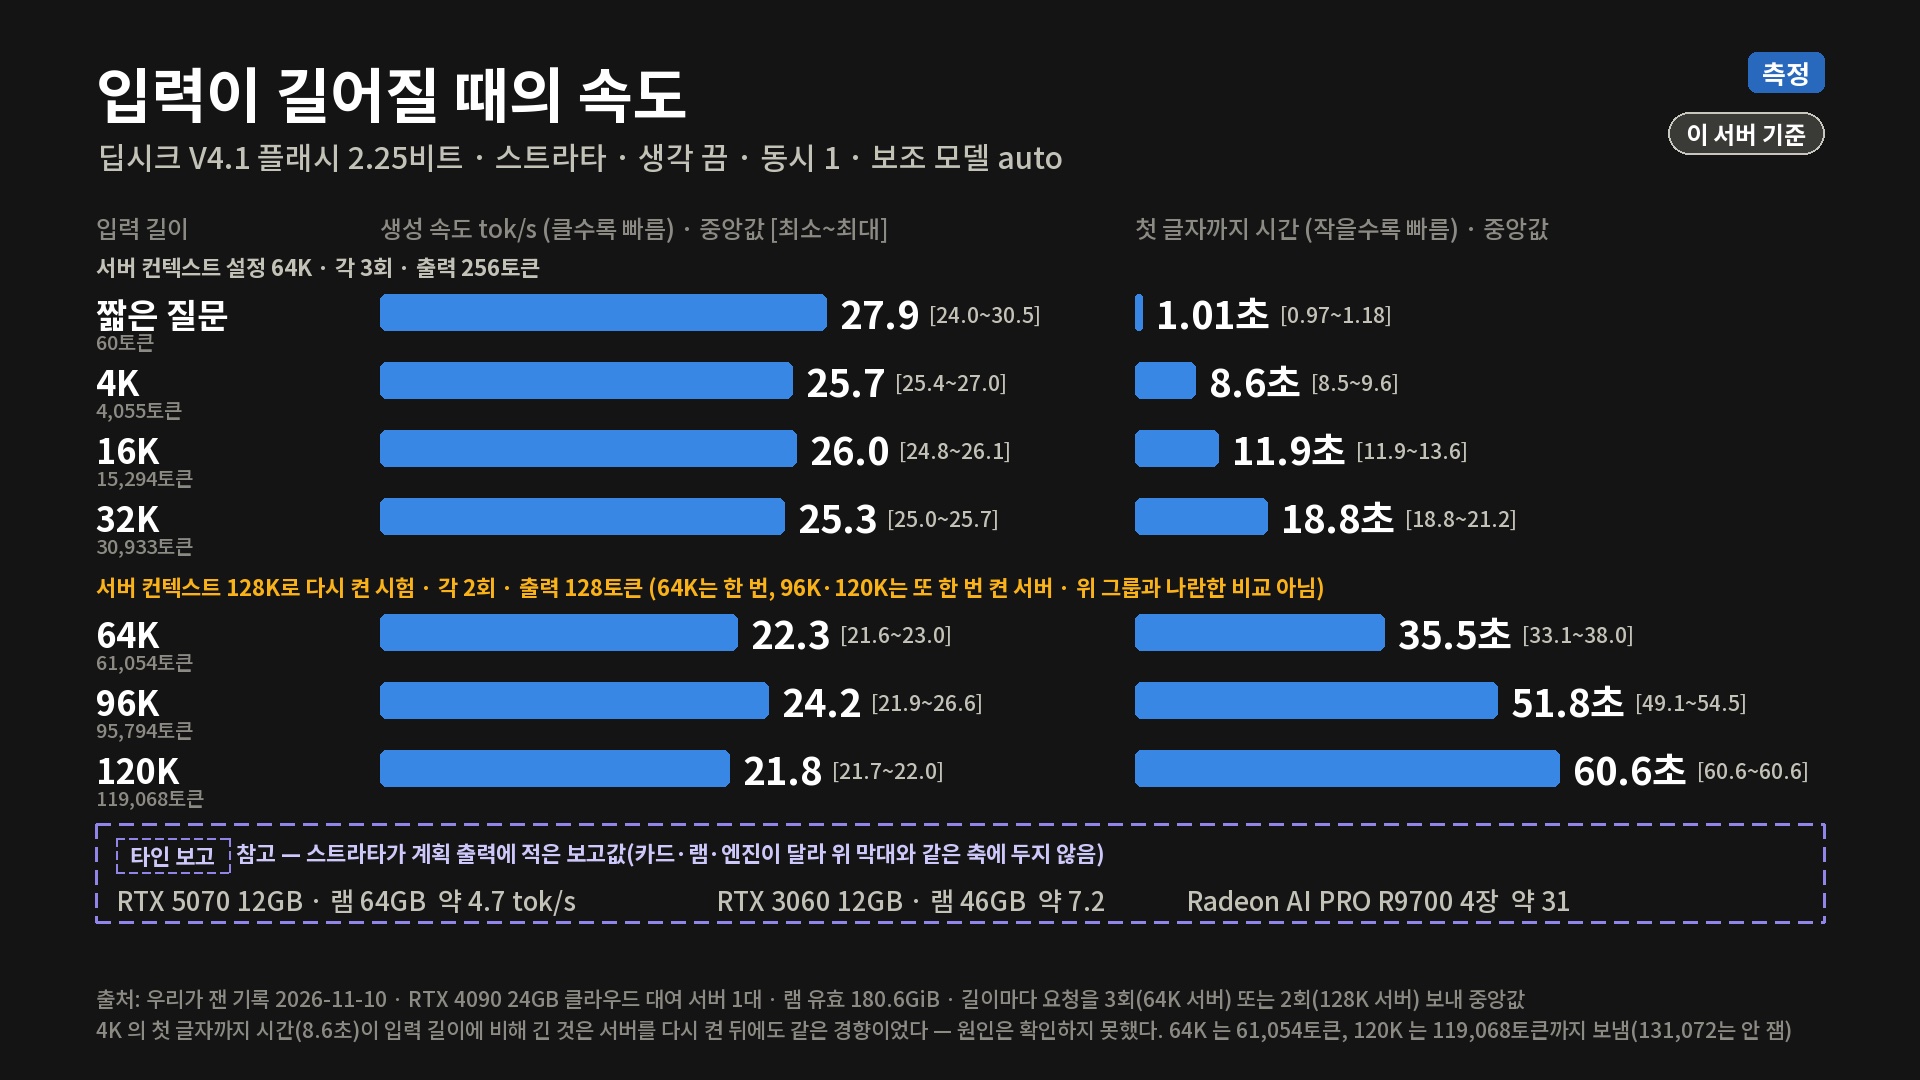
속도: 생성은 22~28토큰대, 첫 글자까지는 입력이 길수록 길어진다
생각 기능을 끄고 한 번에 한 요청씩 보냈고, 속도 시험은 temperature 1.0에 출력 256토큰입니다.
| 입력 | 생성 tok/s(중앙값) | 첫 글자까지 |
|---|---|---|
| 짧은 질문(60토큰) | 27.9 | 1.01초 |
| 4,055토큰 | 25.7 | 8.6초 |
| 15,294토큰 | 26.0 | 11.9초 |
| 30,933토큰 | 25.3 | 18.8초 |
| 61,054토큰* | 22.3 | 35.5초 |
| 95,794토큰* | 24.2 | 51.8초 |
| 119,068토큰* | 21.8 | 60.6초 |
*컨텍스트 한도 131,072토큰으로 켠 서버에서 각 2회, 출력 128토큰으로 쟀습니다. 61,054토큰과 나머지 둘은 서버를 따로 켠 값이라 위쪽 4줄과 나란한 비교가 아닙니다. 가장 긴 입력은 119,069토큰이었고 131,072토큰짜리는 재지 못했습니다. 4K 입력의 첫 글자 시간(8.6초)이 입력 길이에 비해 긴 것은 서버를 다시 켠 뒤에도 같았지만 이유는 확인하지 못했습니다. 그림 아래 점선 상자의 RTX 5070·3060·Radeon 값은 스트라타 계획 출력이 인용한 타인 보고라 우리 막대와 같은 축이 아닙니다.
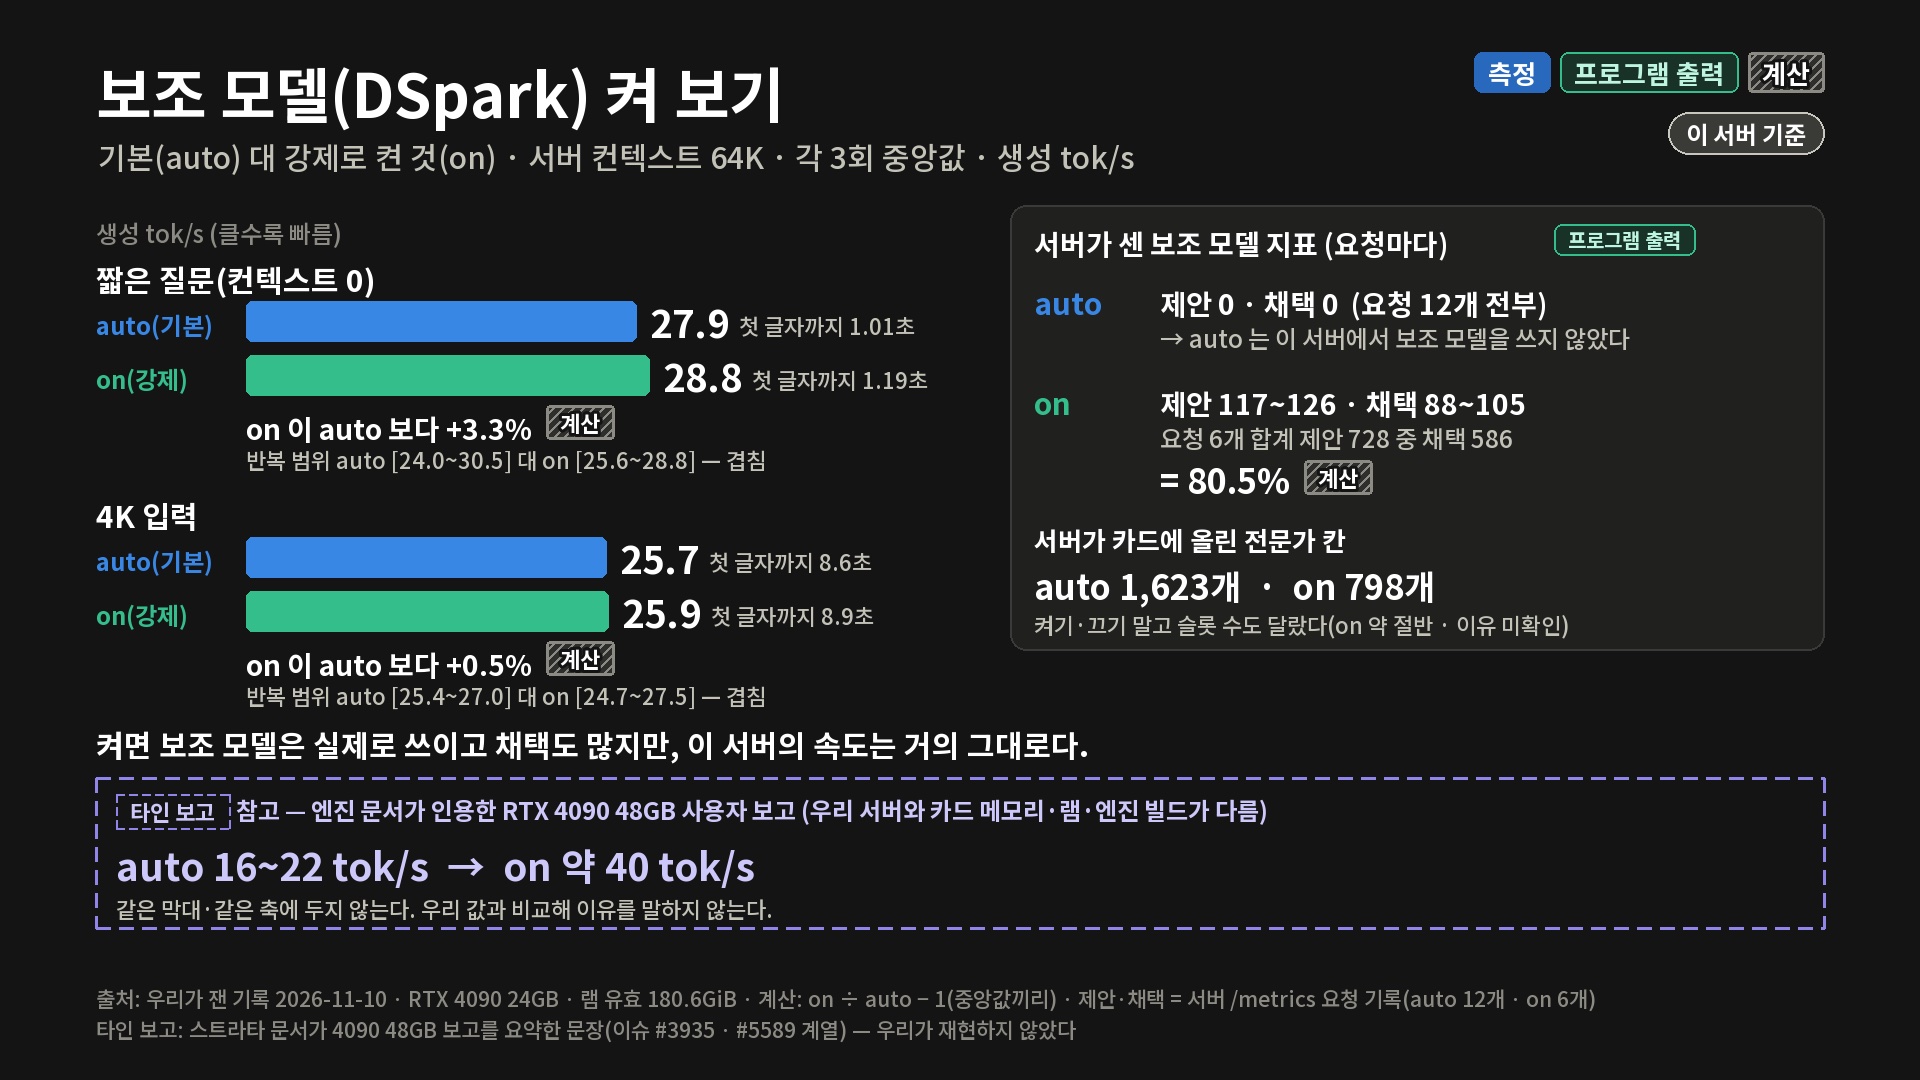
보조 모델 DSpark는 기본(auto) 설정에서 이 서버가 쓰지 않았습니다(요청 12개 모두 제안 0, 채택 0). 억지로 켜면 제안 728개 중 586개(80.5%)가 채택됐지만 속도는 28.8과 25.9토큰으로 각각 3.3%, 0.5% 높은 데 그쳤고 세 번의 범위가 겹칩니다. 켠 서버는 카드 위 전문가 칸이 798개(기본 1,623개)여서 한 가지만 바뀐 비교도 아닙니다. 점선 상자의 RTX 4090 48GB 보고값은 카드 메모리가 달라 우리 값과 줄 세우지 않았습니다(타인 보고).
램을 줄이면
같은 서버에서 램을 점유해 엔진이 쓸 수 있는 램만 줄였습니다. 램 읽기 속도와 카드는 그대로입니다. 서버 컨텍스트는 8K, 단계마다 2회 중앙값, 컨텍스트 0(짧은 질문) 기준입니다.
| 엔진이 쓸 수 있는 램 | 생성 tok/s | 최대 대비 | 첫 글자까지 | 시험 중 SSD 읽기 |
|---|---|---|---|---|
| 180.6GiB(최대) | 27.3 | 100% | 1.04초 | 0.05GiB/s |
| 128GiB | 23.8 | 87% | 1.09초 | 1.67GiB/s |
| 96GiB | 20.1 | 74% | 1.71초 | 2.45GiB/s |
| 64GiB | 15.0 | 55% | 3.03초 | 3.21GiB/s |
64GiB에서도 오류나 중단은 없었습니다. 최대 대비 %는 계산이고, SSD 읽기는 시험 구간 동안 늘어난 읽기량을 시간으로 나눈 계산값입니다. 램이 줄수록 SSD 읽기가 함께 늘었지만 상관만 확인했을 뿐 원인으로 단정하지 않습니다. 최대 단계의 27.3은 서버 설정(컨텍스트 8K)이 달라 속도 표의 27.9와 다른 값입니다. 64GiB보다 작은 램은 재지 않았고, 점유 방식이라 실제 램이 64GB인 컴퓨터와 같다는 보장도 없습니다.
한국어, 코딩, 도구 호출
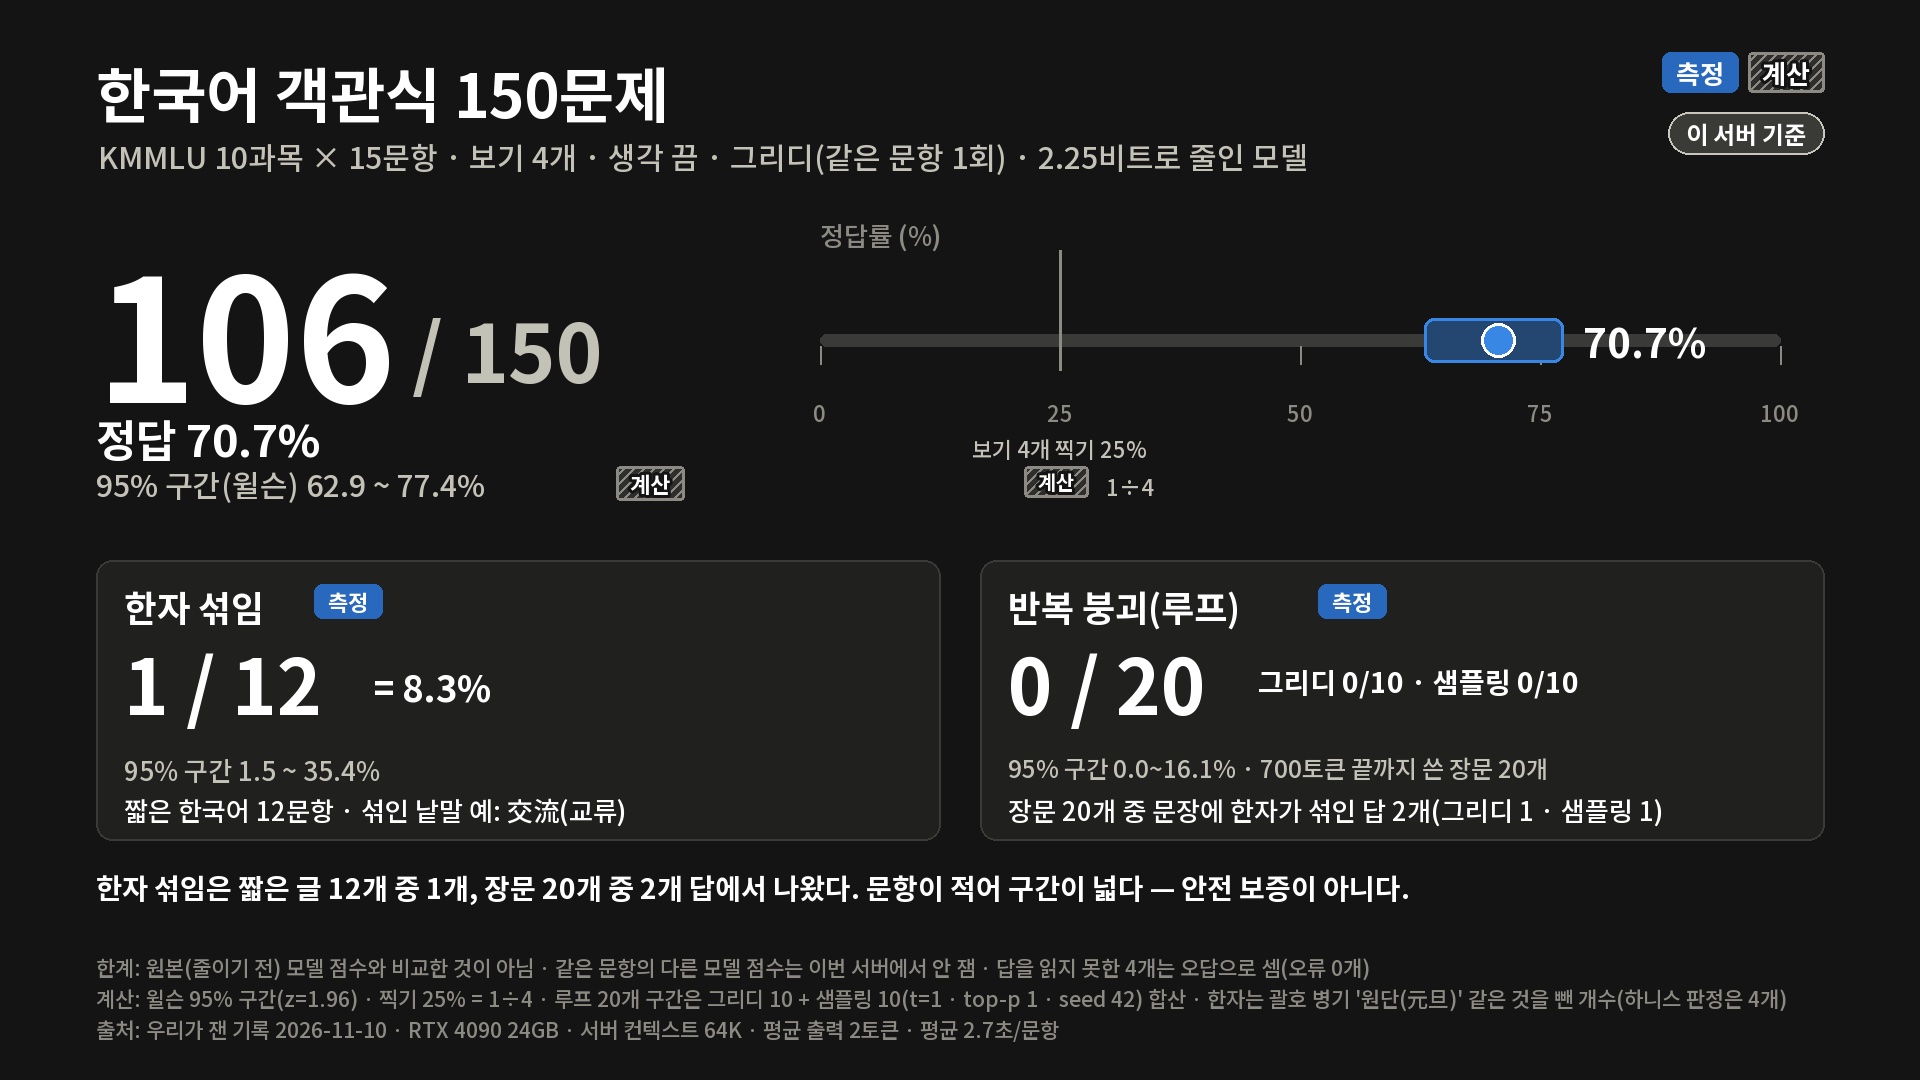
모두 생각을 끄고 그리디(같은 문항 1회)로 쟀습니다. KMMLU 객관식(10과목 × 15문항, 보기 4개)은 150문제 중 106개 정답으로 70.7%이고 95% 구간은 62.9~77.4%입니다. 찍으면 25%가 나옵니다. 답을 읽지 못한 4개는 오답으로 셌습니다. 같은 문제를 푼 다른 모델 점수가 없어 좋다 나쁘다는 말은 하지 않습니다.
한자 섞임은 짧은 한국어 요청 12개 중 1개('교류'가 '交流'로 출력)였습니다. 700토큰까지 쓰게 한 긴 글 20개에서는 같은 말을 되풀이하며 무너진 답으로 판정된 것이 0건이었습니다. 한자·중국어가 섞인 답은 그리디 10개 중 1개, 샘플링 10개 중 1개로, 원문을 읽고 괄호 병기를 뺀 개수입니다.
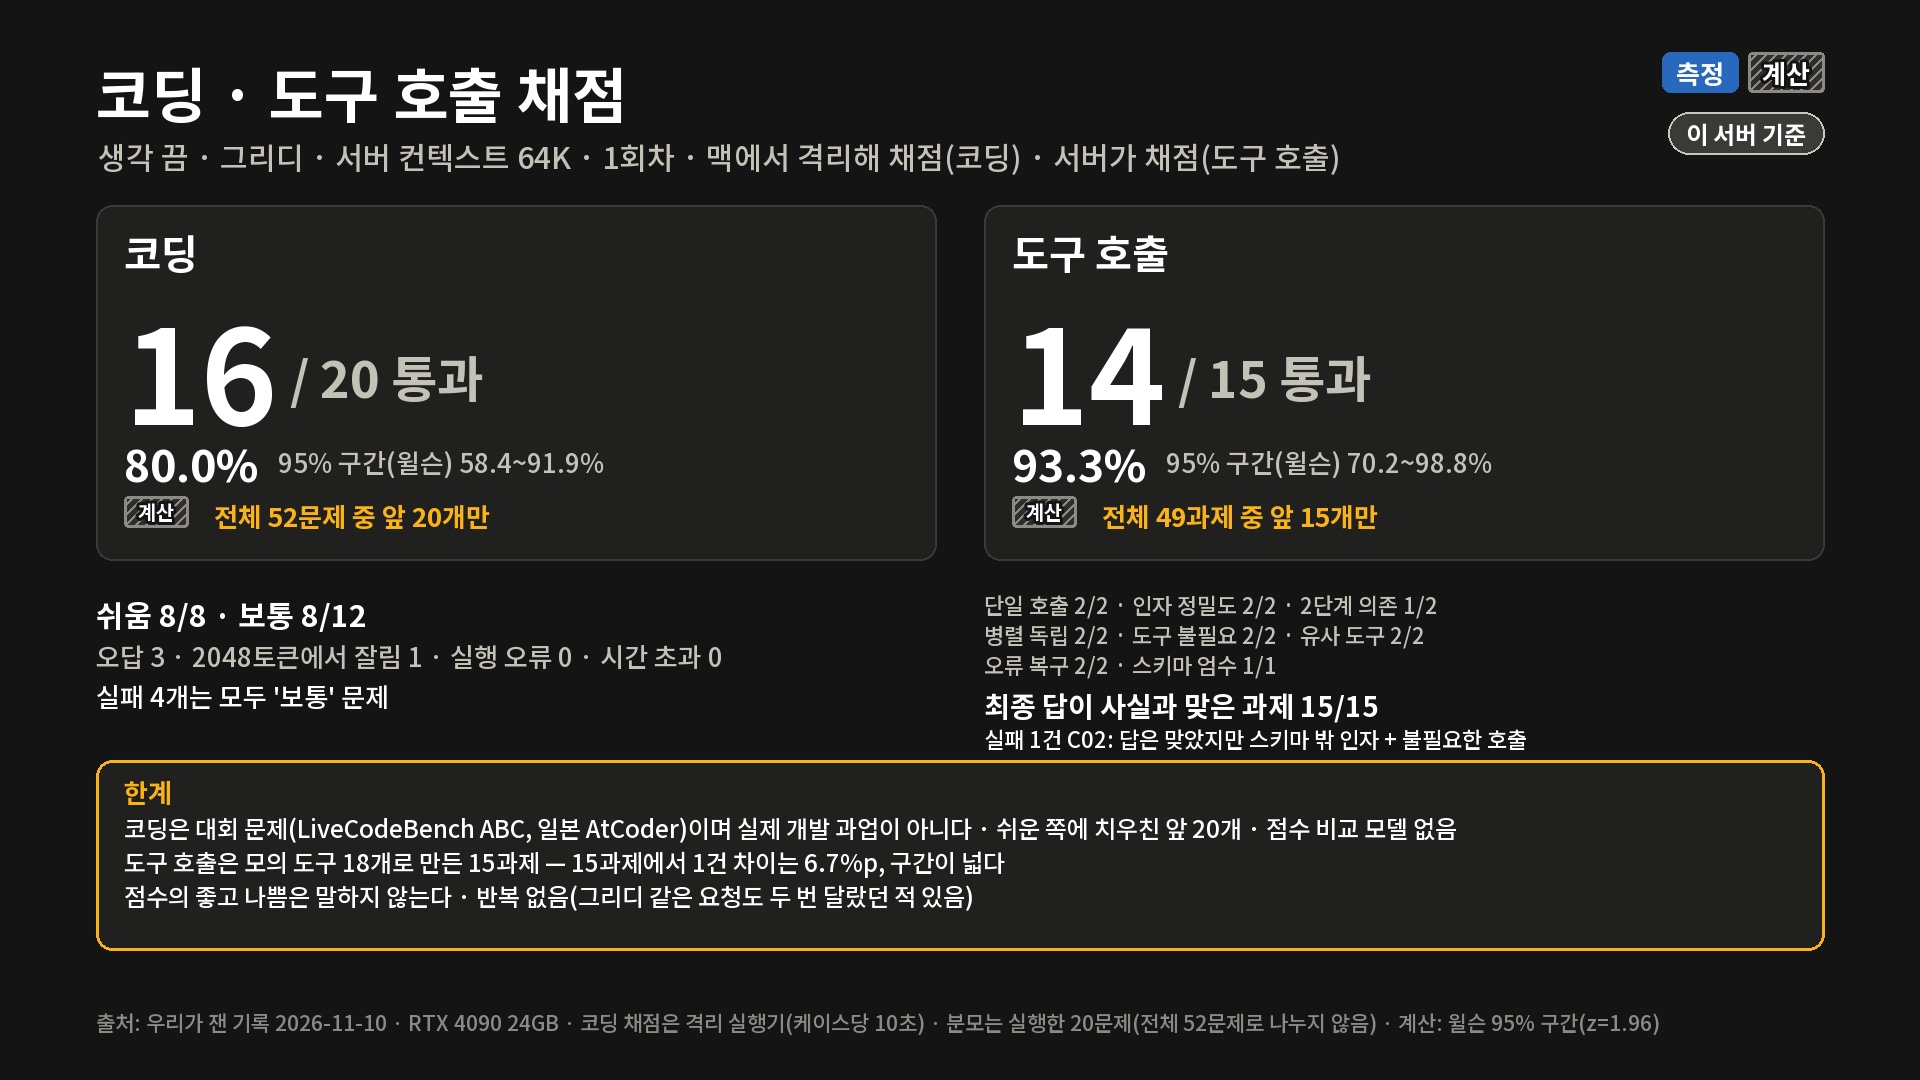
코딩은 전체 52문제(대회 문제 27개와 직접 만든 실전형 25개) 중 앞 20개만 풀렸고, 그 20개는 모두 대회 문제(일본 AtCoder 기반 LiveCodeBench)입니다. 16개를 통과했고(80.0%, 95% 구간 58.4~91.9%) 쉬움 8/8, 보통 8/12입니다. 직접 만든 실전형 25문제는 한 문제도 돌리지 않았습니다. 도구 호출은 49과제 중 앞 15개에서 14개(93.3%, 70.2~98.8%)를 통과했습니다. 실패 1건은 허용되지 않은 인자와 불필요한 도구 호출 한 번이 이유였고 최종 답은 맞았습니다. 둘 다 앞부분만 고른 한 번씩의 결과여서 실제 개발 과업의 점수가 아닙니다.
비용 계산
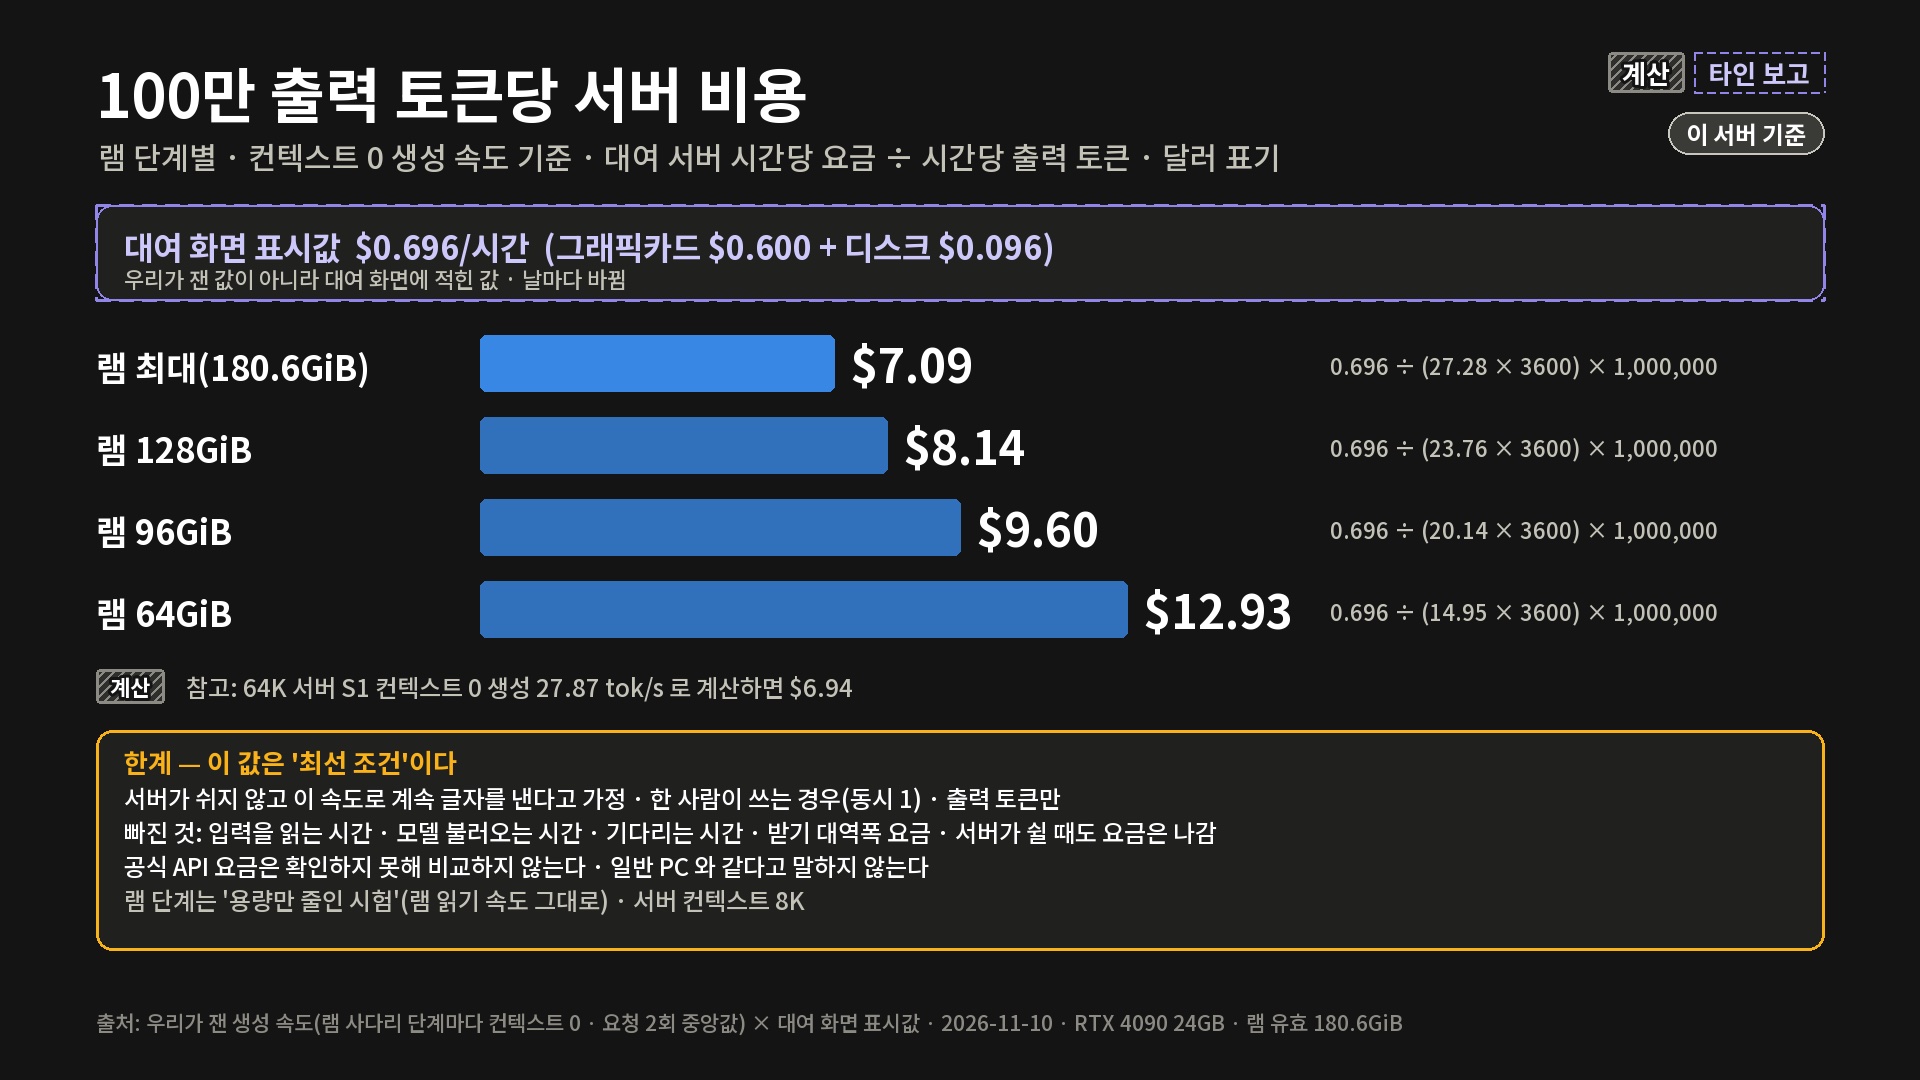
대여 화면에 표시된 서버 요금은 시간당 0.696달러(그래픽카드 0.600 + 디스크 0.096)입니다. 서버가 쉬지 않고 한 요청씩 글자만 만든다고 가정하면 출력 100만 토큰당 비용은 0.696 ÷ (생성 속도 × 3,600) × 1,000,000으로 램 최대 7.09달러, 128GiB 8.14달러, 96GiB 9.60달러, 64GiB 12.93달러입니다(계산, 요금은 대여 화면 표시값). 입력을 읽는 시간, 모델을 불러오는 시간, 노는 시간, 받기 대역폭 요금(약 2.61달러)은 뺀 가장 유리한 조건입니다. 공식 API 요금은 확인하지 못해 비교하지 않았습니다.
한계와 확인하지 못한 것
- 서버 한 대, 1회차입니다. 같은 시험을 다른 서버에서 다시 하지 않았습니다.
- 램 읽기 61.4GB/s는 엔진을 끈 상태에서 24스레드로 읽은 순차 읽기 최고값이고, 엔진의 실제 접근은 더 낮을 것으로 보이나 측정하지 않았습니다. 램 종류·속도·모듈 구성은 컨테이너에서 막혀 확인하지 못했습니다.
- 카드 전력은 최대 450W 중 350W로 제한돼 있었습니다(영상과 같은 표기이며, 450W는 서버 세션에서 확인한 값입니다). 한도를 바꿔 다시 재지 않아 속도에 영향을 줬는지는 모릅니다.
- 비교 모델(같은 문항을 다른 모델이나 원본 정밀도로 푼 점수)이 없습니다.
- 헤드라인 속도는 속도 시험(온도 1.0, 출력 256토큰)의 값입니다. 한국어·코딩 시험 중 엔진이 보고한 생성 속도는 출력 100토큰 이상 요청 기준 초당 31~42토큰이었고 차이의 이유는 확인하지 못했습니다.
- 같은 요청을 그리디로 두 번 보냈더니 답이 달랐던 적이 있어, 점수를 다시 돌려도 같다고 말할 수 없습니다.
- 카드 메모리 줄이기, 벽 전력, 동시 요청, 다른 엔진과의 비교는 하지 않았습니다.
- 일 시키기 시험(온도 0.7, 각 1회)에서 생각을 켜면 사과 메일이 8.2초에서 19.0초로 늘고 스네이크 게임은 3,500토큰 상한에서 잘렸습니다. 결과물이 동작하는지는 채점하지 않았습니다.
기준일
측정은 2026-11-10에 했고 이 글은 영상 공개일(2026-11-10) 기준입니다. 스트라타 0.2.13.1(엔진 0.1.59.1), 모델은 평균 2.25비트 판입니다. 대여 요금과 문서 내용은 바뀔 수 있습니다.