스트라타(Strata) 맥 미니 32GB 실측 생각 켠 10.3~22.1토큰, 27B와 비교
올린 날 영상 공개
맥 미니 M6 32GB에서 Qwen3.8 Flash-Next Q2_0(66.4GB)를 스트라타로 쟀습니다. 속도 10.3~22.1토큰(생각 켠 형식), 150문항·코딩 52문제 정답은 27B 4비트와 차이 확인 못 함. 개발자 값은 따로 표기.
맥 미니 M6 32GB에서 66.4GB짜리 Qwen3.8 Flash-Next(2비트 Q2_0) 파일은 스트라타(Strata) 엔진으로 돌아갔고, 속도는 질문에 따라 초당 10.3~22.1토큰(생각 켠 형식 기준, 생각 끈 형식은 17.2~24.0토큰)이었습니다. 같은 맥의 Qwen3.8 27B 4비트와 비교하면 150문항 정답률도 코딩 52문제도 차이를 확인하지 못했고, 갈린 것은 파일 크기 · 메모리 여유 · 한국어 답에 섞이는 한자였습니다.
스트라타는 1,250억 개짜리 전문가 혼합 모델을 12GB 그래픽카드에서 돌리는 엔진이고, 원 개발자는 맥을 범위 밖으로 밝혔습니다. 이번에 쓴 strata-mlx는 같은 모델 파일을 읽어 맥에서 돌리는 비공식 독립 프로젝트입니다. 이 글은 10분 18초 영상(공개 2026-10-13)의 측정을 글로 다시 정리한 것이고, 모든 값은 2026-10-13 맥 미니 한 대에서 크롬을 닫고 잰 것입니다.
측정 조건: 같은 파일, 두 가지 질문 형식
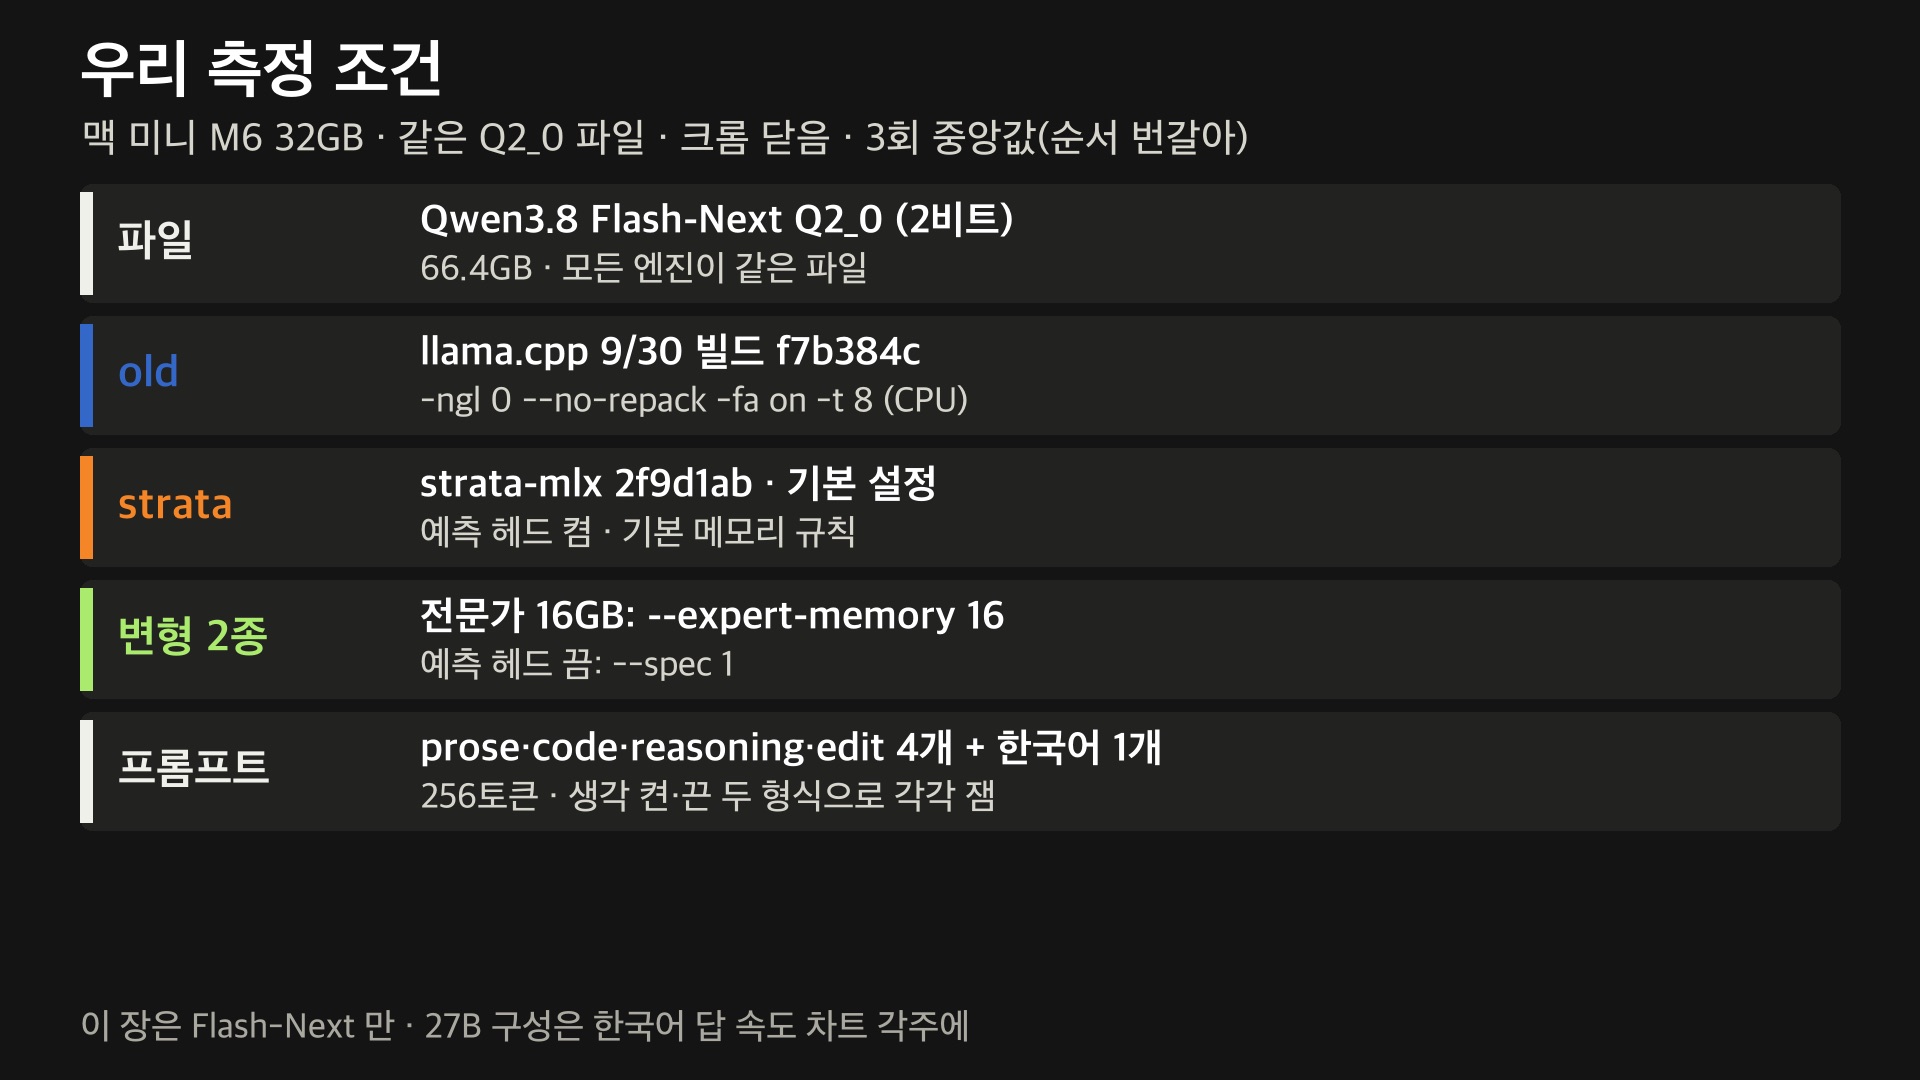
같은 파일 · 같은 질문 · 256토큰 생성을 질문 5종(글쓰기 · 코드 · 추론 · 수정 · 한국어)으로 3번 재고 중앙값을 썼습니다. 질문 형식은 둘로 나눴습니다. 생각 켠 형식은 개발자 설명서와 같은 방식이고 모델이 영어로 먼저 생각하는 일이 많습니다. 생각 끈 형식은 빈 생각 블록을 붙여 한국어로 바로 답하게 한 것입니다. 비교는 같은 형식끼리만 합니다.
남의 값은 우리 표에 섞지 않는다
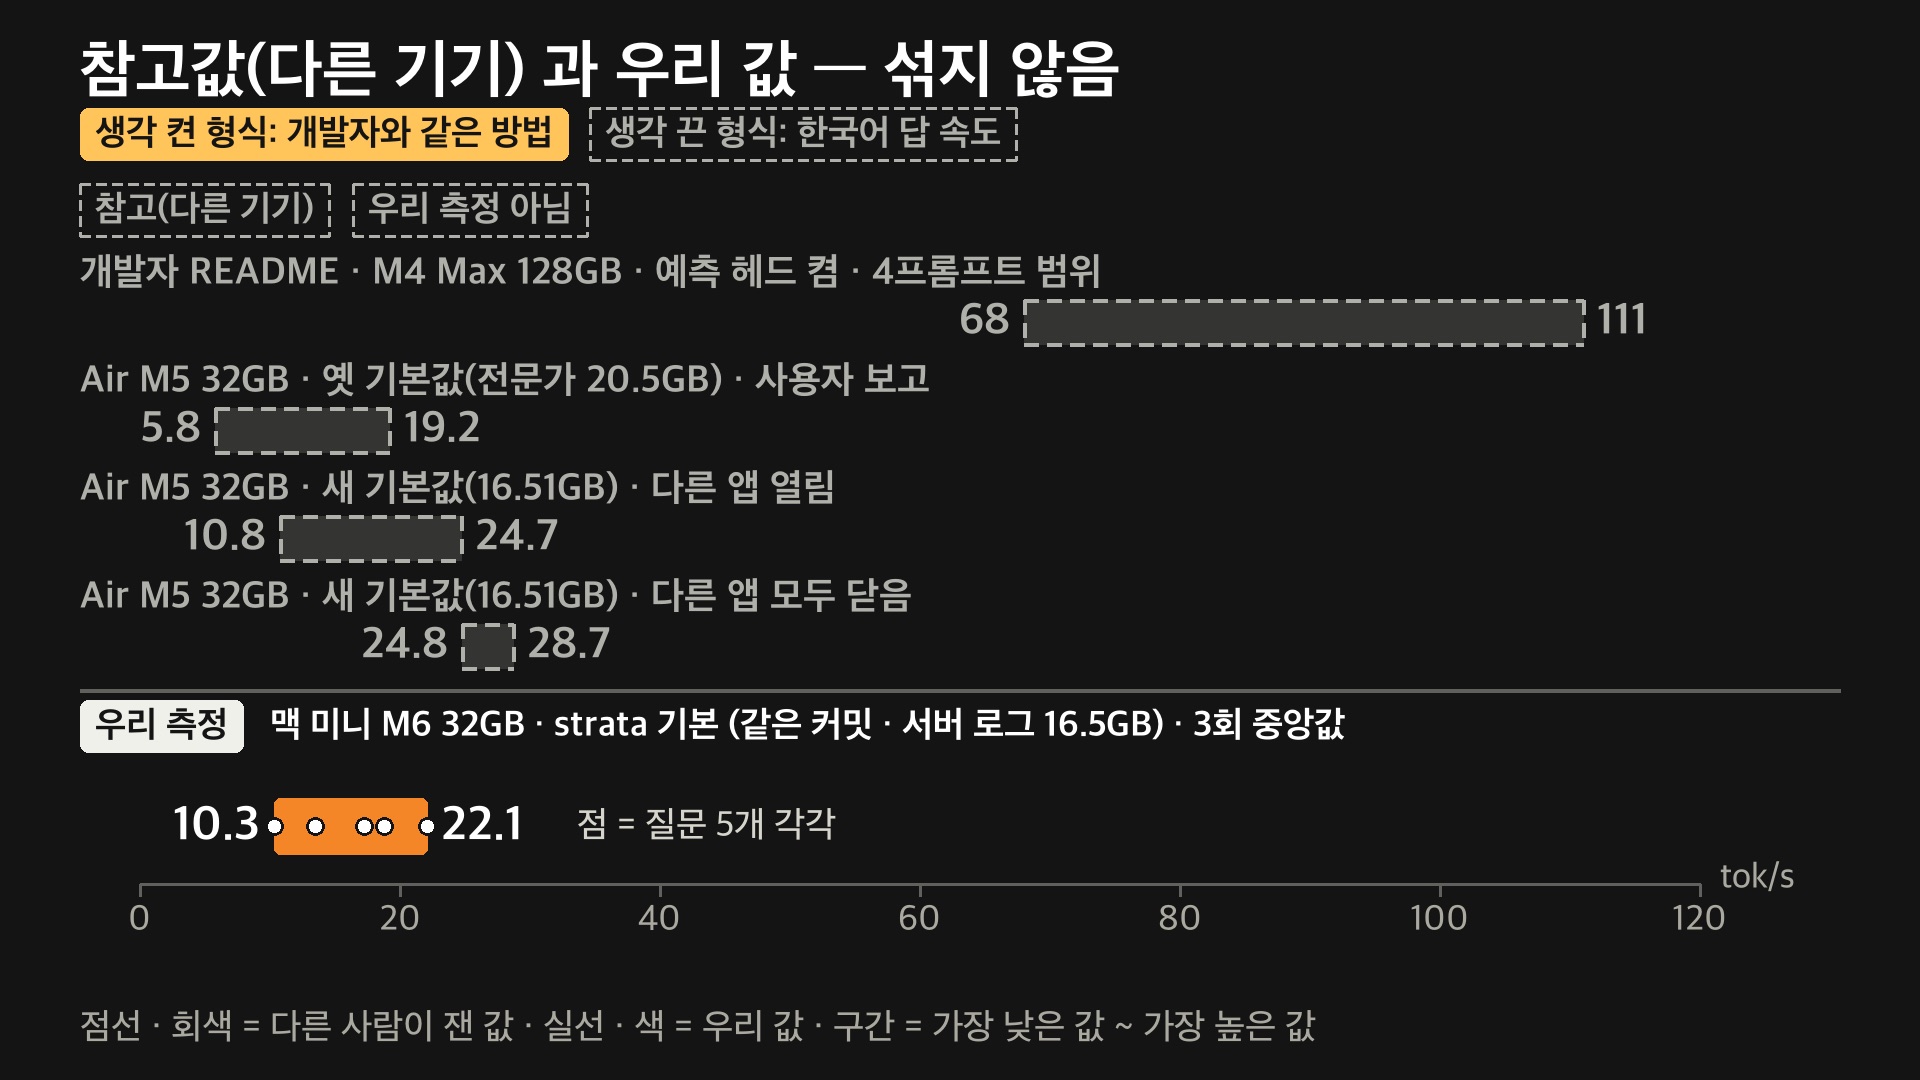
| 값 | 초당 토큰 | 구분 |
|---|---|---|
| 개발자 M4 Max 128GB, 예측 헤드 켬 | 68~111 | 인용(우리 측정 아님) |
| MacBook Air M5 32GB 사용자, 새 기본값, 앱 열림 · 닫음 | 10.8~24.7 · 24.8~28.7 | 인용 |
| 우리 맥 미니 M6 32GB, 생각 켠 형식 | 10.3~22.1 | 측정 |
기계와 조건이 달라 이유는 알 수 없고 우열 비교로 쓰지 않습니다. 옛 기본값의 5.8~19.2는 지금과 다른 설정입니다.
속도: 같은 파일, 엔진만 바꾸면
생각 켠 형식에서 llama.cpp 옛 빌드(CPU)는 5개 질문 모두 7.1~7.9토큰입니다. strata 기본은 수정 10.3 · 한국어 13.5 · 코드 17.3 · 글쓰기 18.8 · 추론 22.1토큰입니다. 생각 끈 형식에서는 llama.cpp가 7.2~7.8, strata 기본이 한국어 17.2 · 추론 17.5 · 코드 18.8 · 수정 20.8 · 글쓰기 24.0토큰입니다.
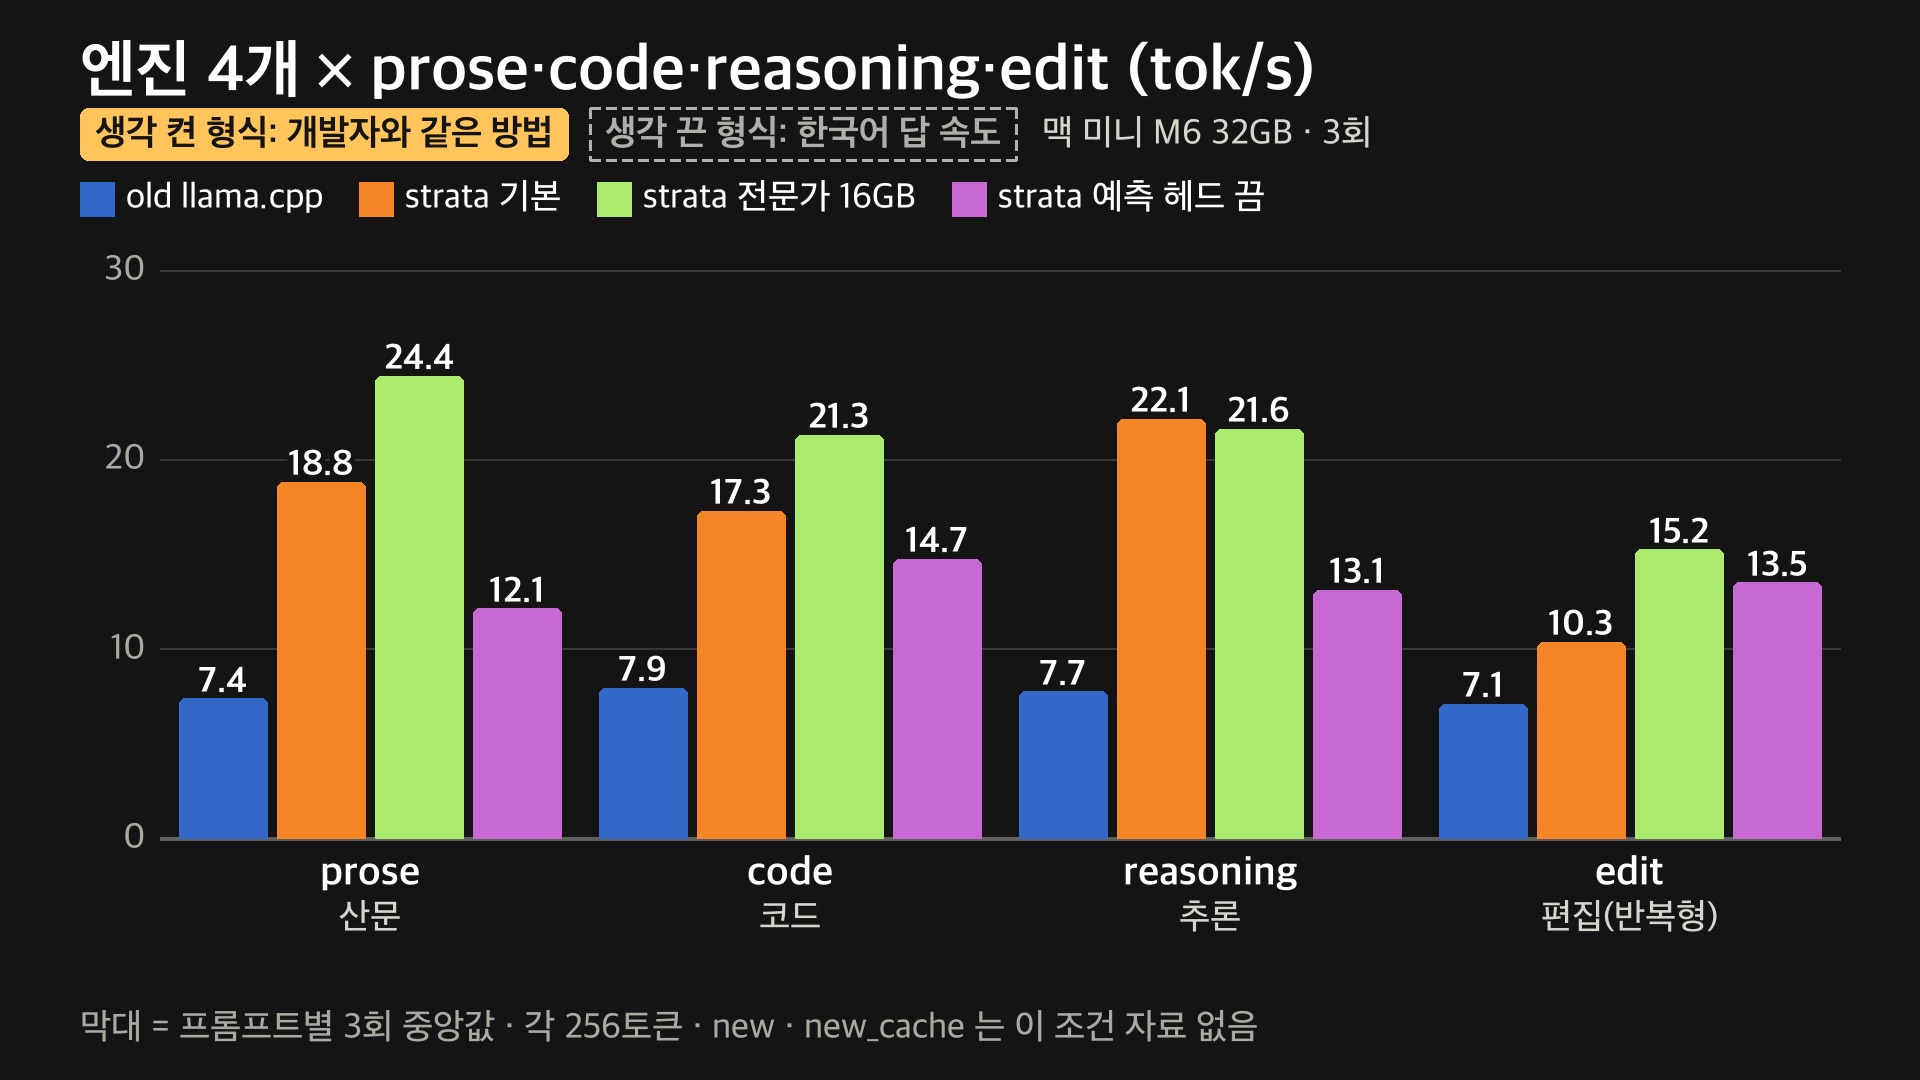
다만 strata 기본은 회차마다 흔들렸습니다. 생각 켠 글쓰기는 15.9~22.5토큰이었습니다. 스왑 · 발열 · 순서 중 원인은 이 데이터로 가르지 못했습니다.
한국어 답 속도와 27B 비교
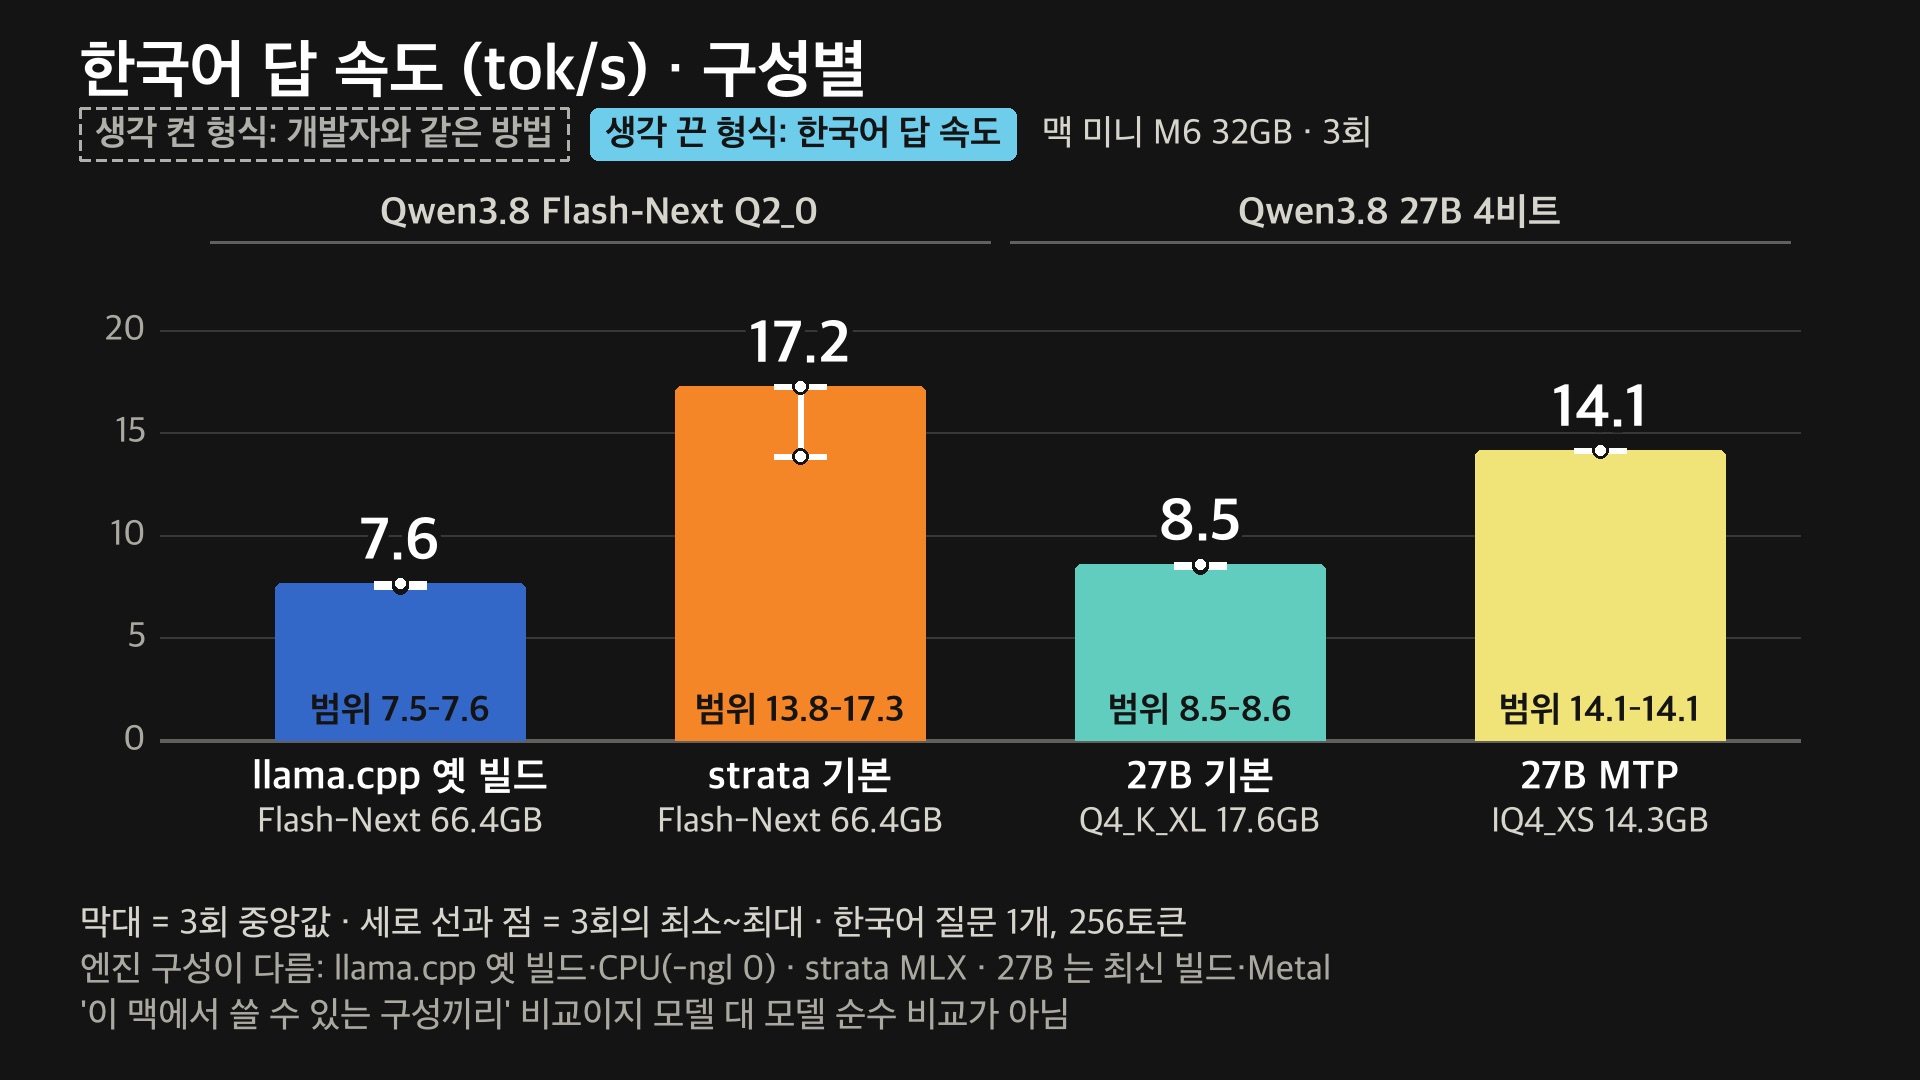
27B 4비트는 최신 llama.cpp(Metal), Flash-Next는 옛 빌드(CPU)라 모델 대 모델이 아니라 "이 맥에서 쓸 수 있는 구성끼리"의 비교입니다. 생각 끈 형식, 한국어 질문 기준입니다(측정).
| 구성 | 파일 | 초당 토큰 | 최대 스왑 | 여유 최저 |
|---|---|---|---|---|
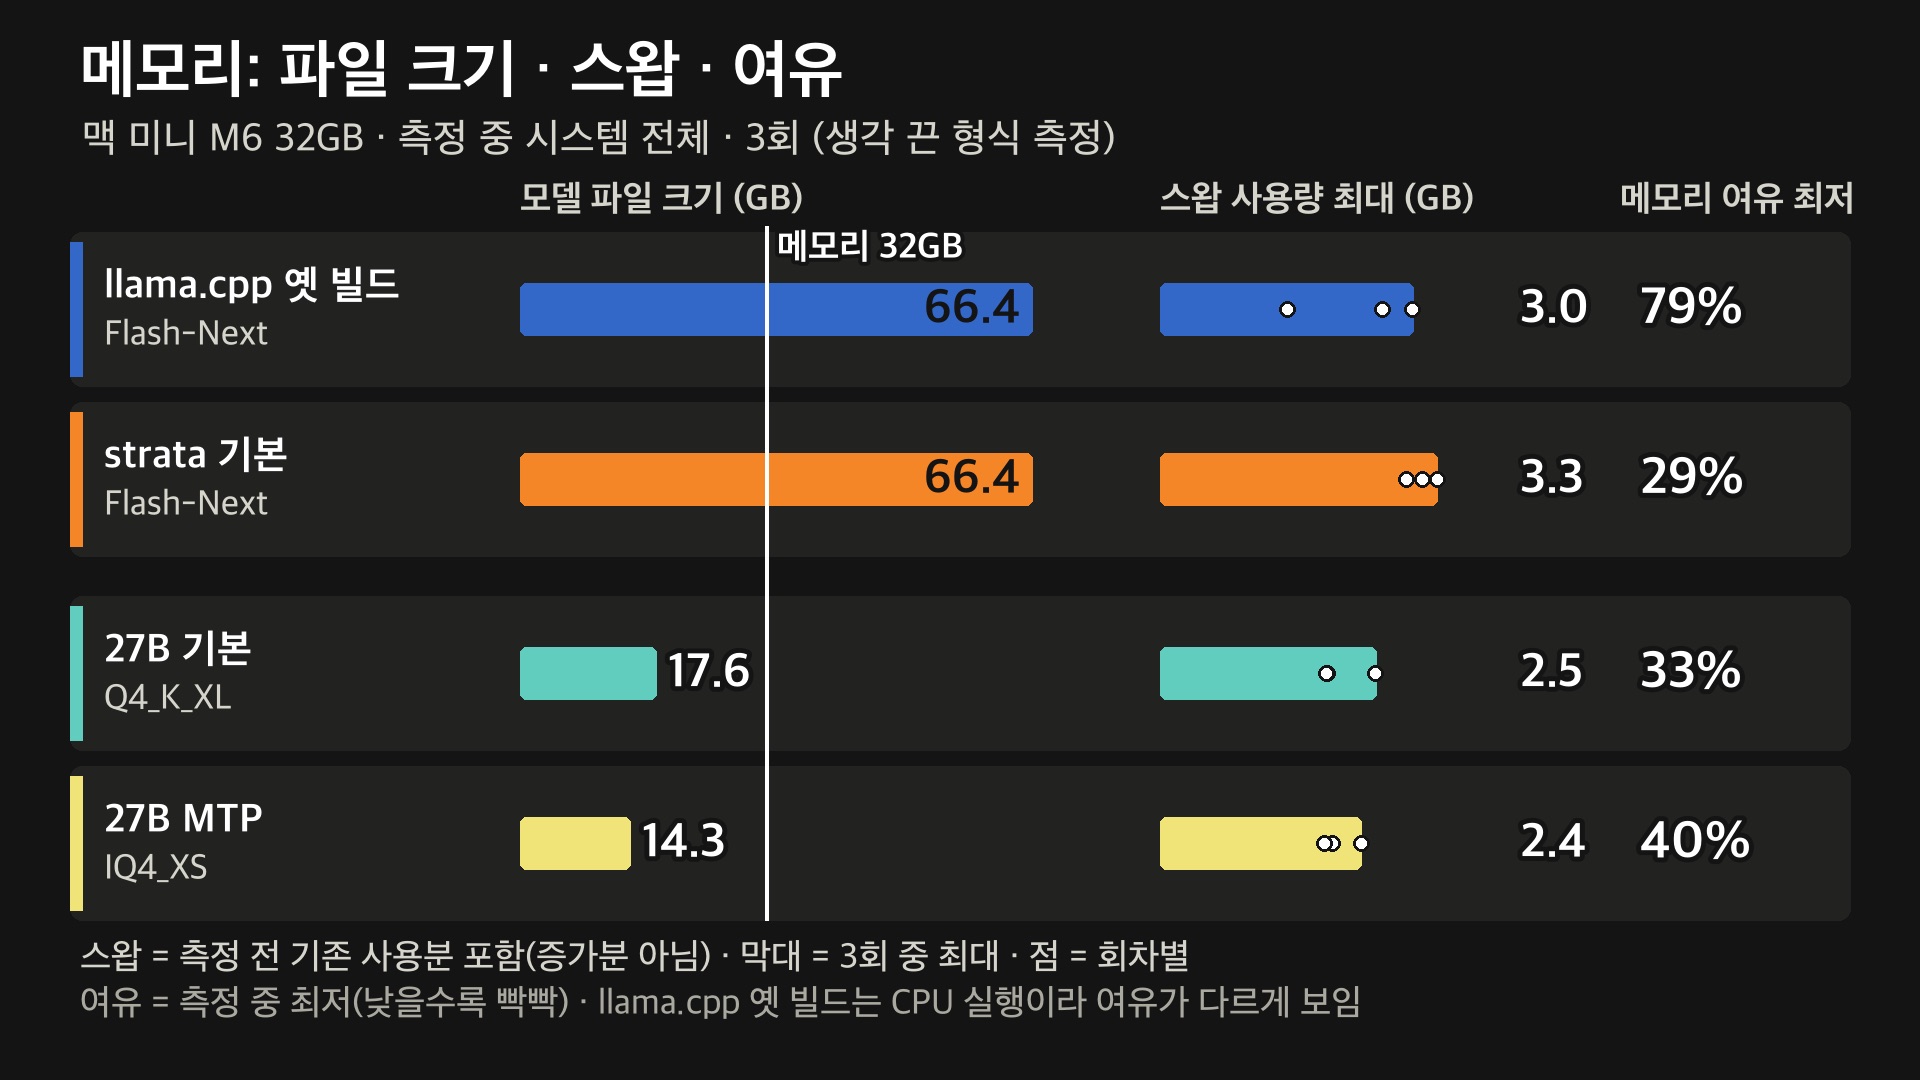
| Flash-Next llama.cpp | 66.4GB | 7.6 | 약 3.0GB | 79% |
| Flash-Next strata 기본 | 66.4GB | 17.2 | 3.3GB | 29% |
| 27B 기본 Q4_K_XL | 17.6GB | 8.5 | 2.5GB | 33% |
| 27B MTP UD-IQ4_XS | 14.3GB | 14.1 | 2.4GB | 40% |
strata 기본의 한국어는 3회 값이 13.8 · 17.2 · 17.3토큰(중앙값 17.2)이었고, 그중 최솟값 13.8이 27B MTP의 14.1보다 낮아 "비슷하거나 조금 빠르다"까지만 말할 수 있습니다. 스왑은 측정 전 사용분을 포함하므로 속도의 원인이라고 단정하지 않습니다.
정확도 · 코딩 · 한자: 2비트의 대가
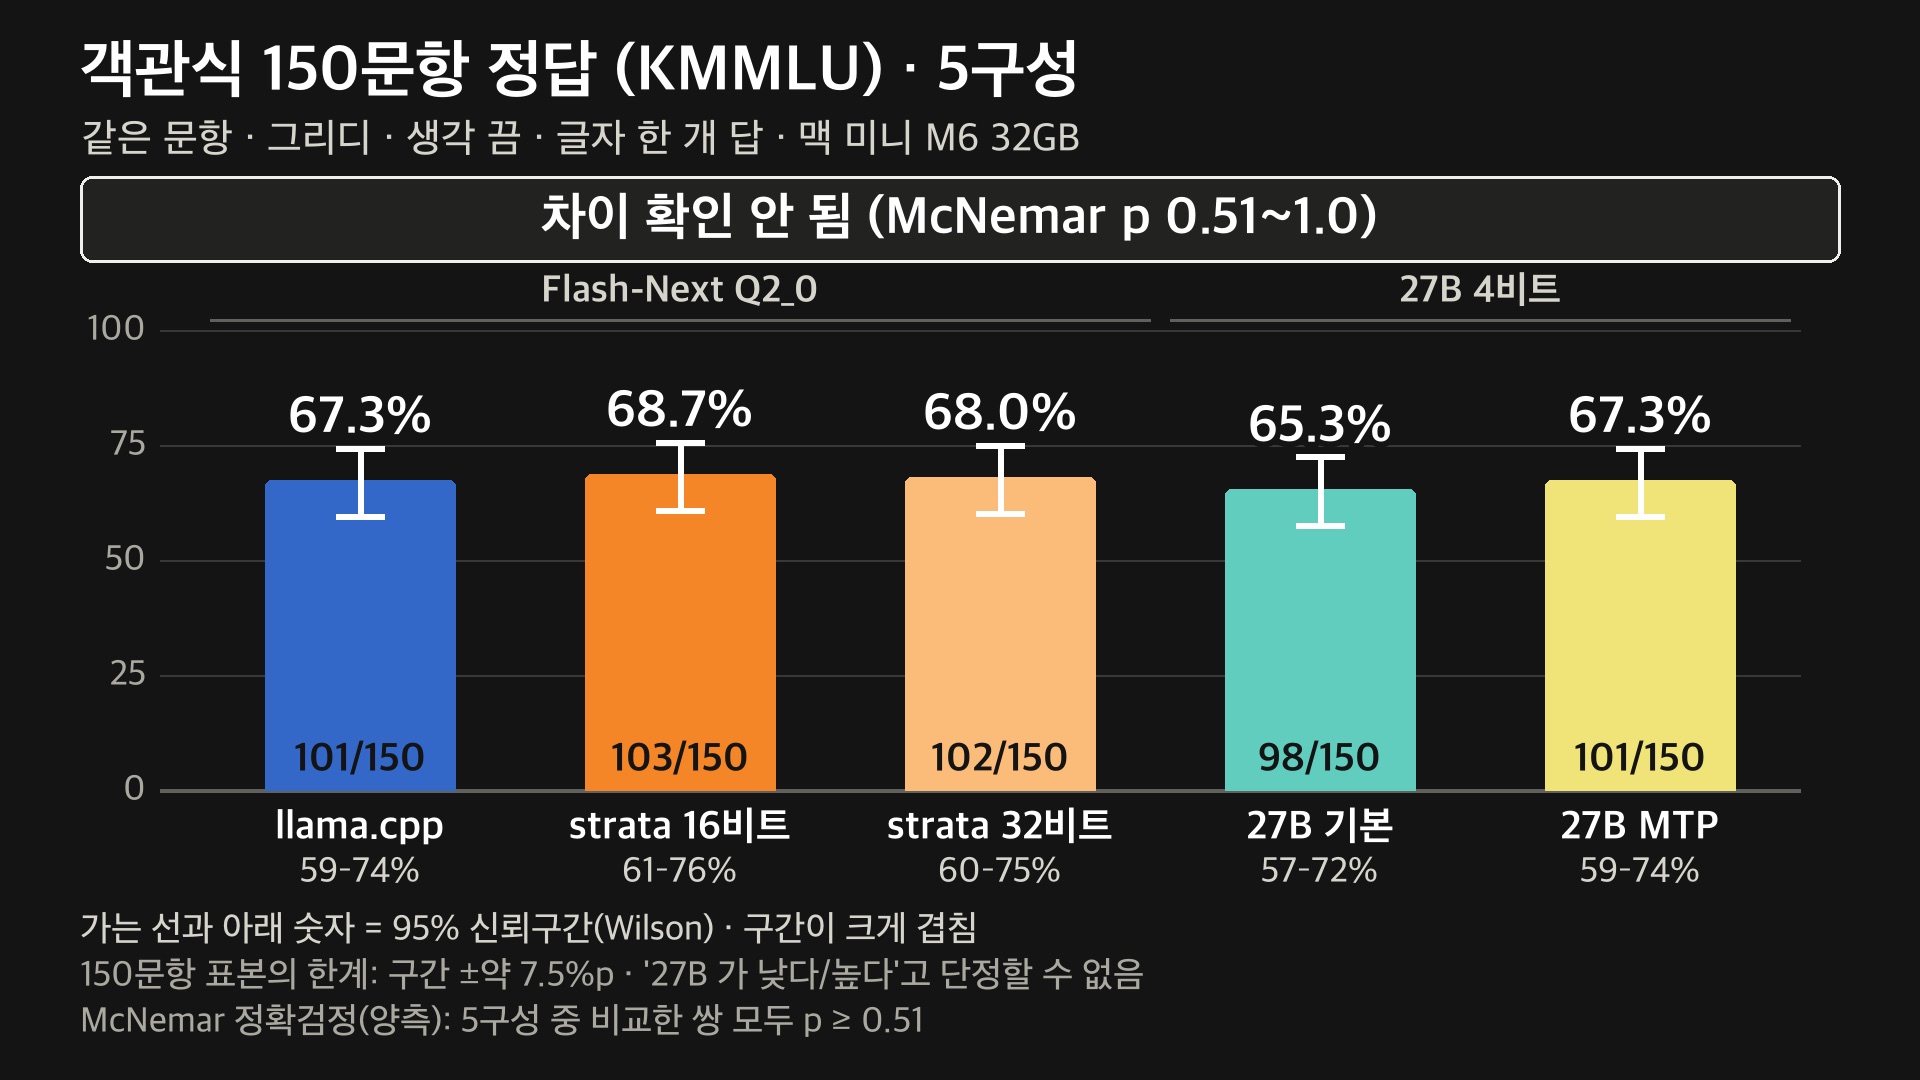
한국어 객관식(KMMLU) 150문항 정답은 llama.cpp 101 · strata fp16 103 · fp32 102 · 27B 기본 98 · 27B MTP 101개로, 통계 검정에서 차이가 확인되지 않았습니다. 150문항은 구간 폭이 약 ±7.5%p라 작은 차이는 보이지 않습니다.
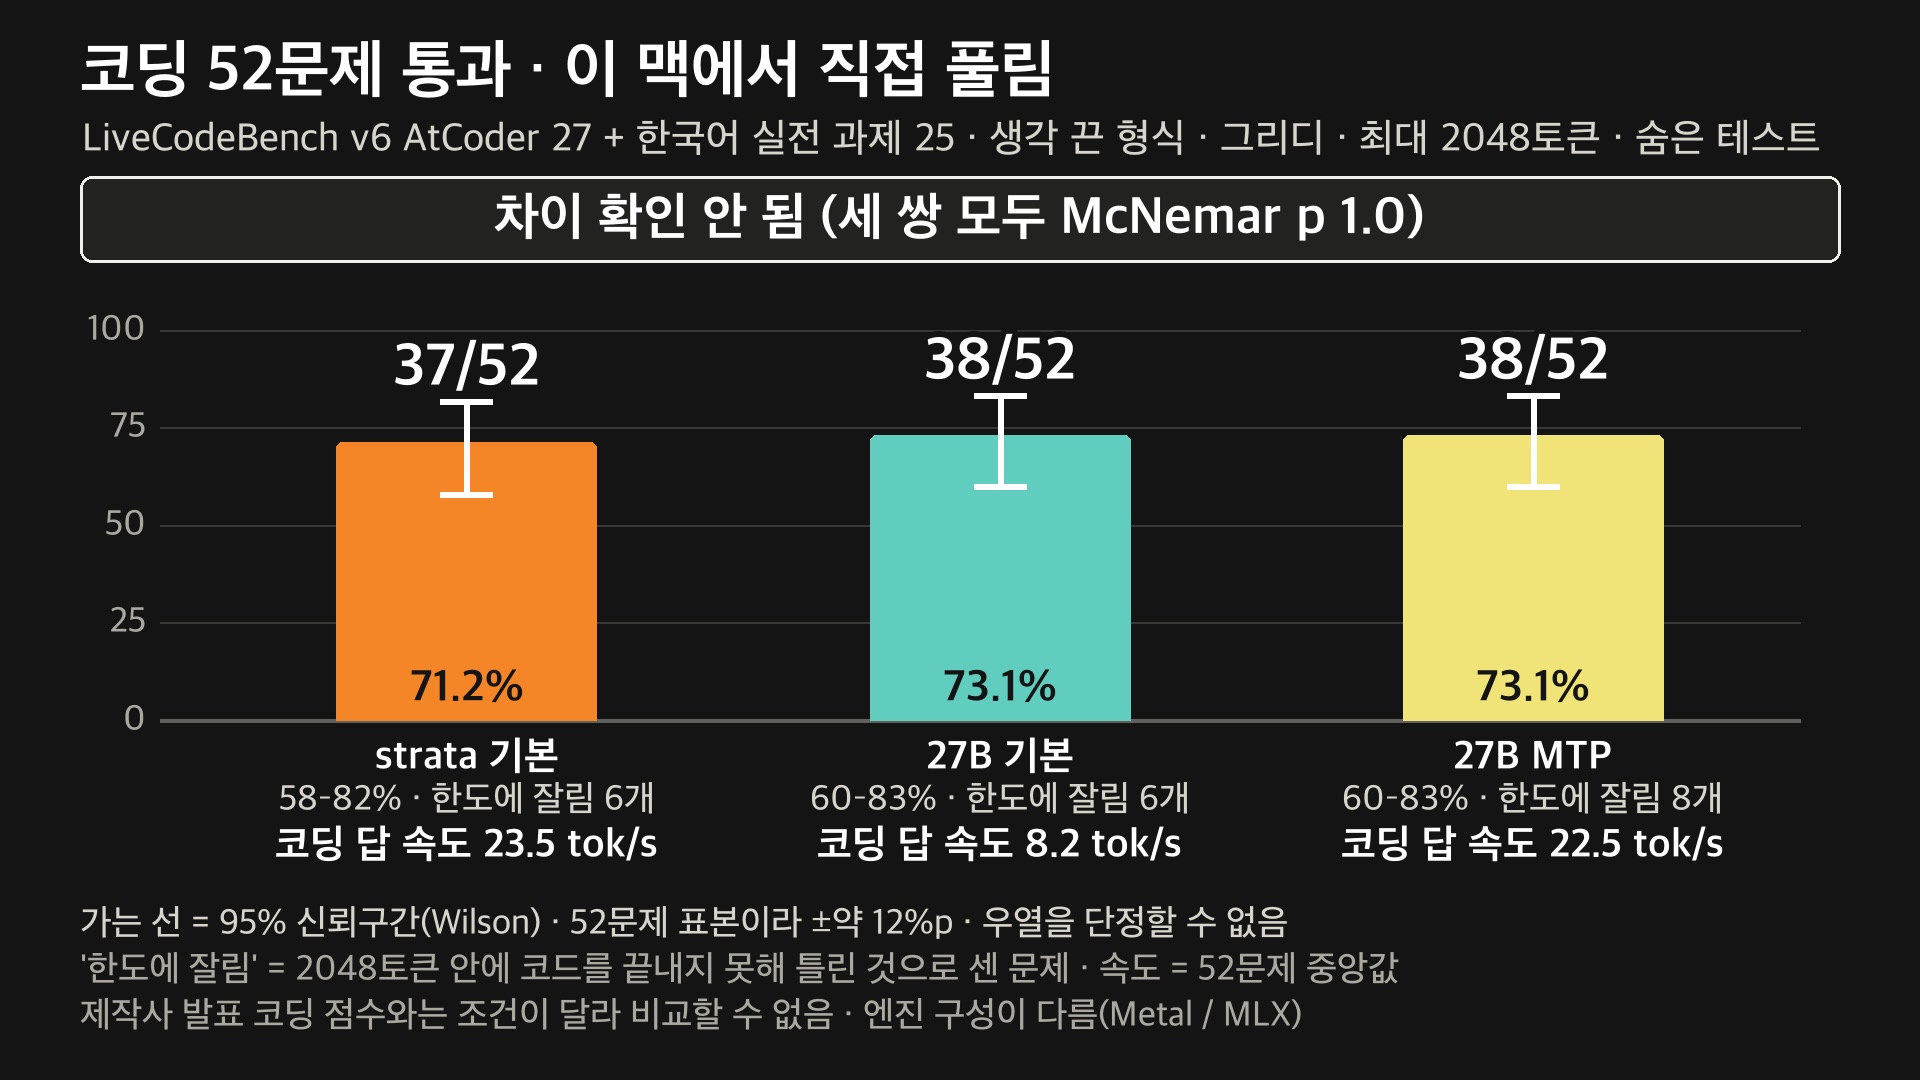
코딩은 LiveCodeBench v6 27문제와 한국어 실전 과제 25문제, 총 52문제를 숨은 테스트로 채점했습니다(생각 끈 형식, 최대 2,048토큰).
| 구성 | 통과 | 코딩 답 속도 중앙값 |
|---|---|---|
| strata 기본 | 37/52 (71.2%) | 23.5토큰 |
| 27B 기본 | 38/52 (73.1%) | 8.2토큰 |
| 27B MTP | 38/52 (73.1%) | 22.5토큰 |
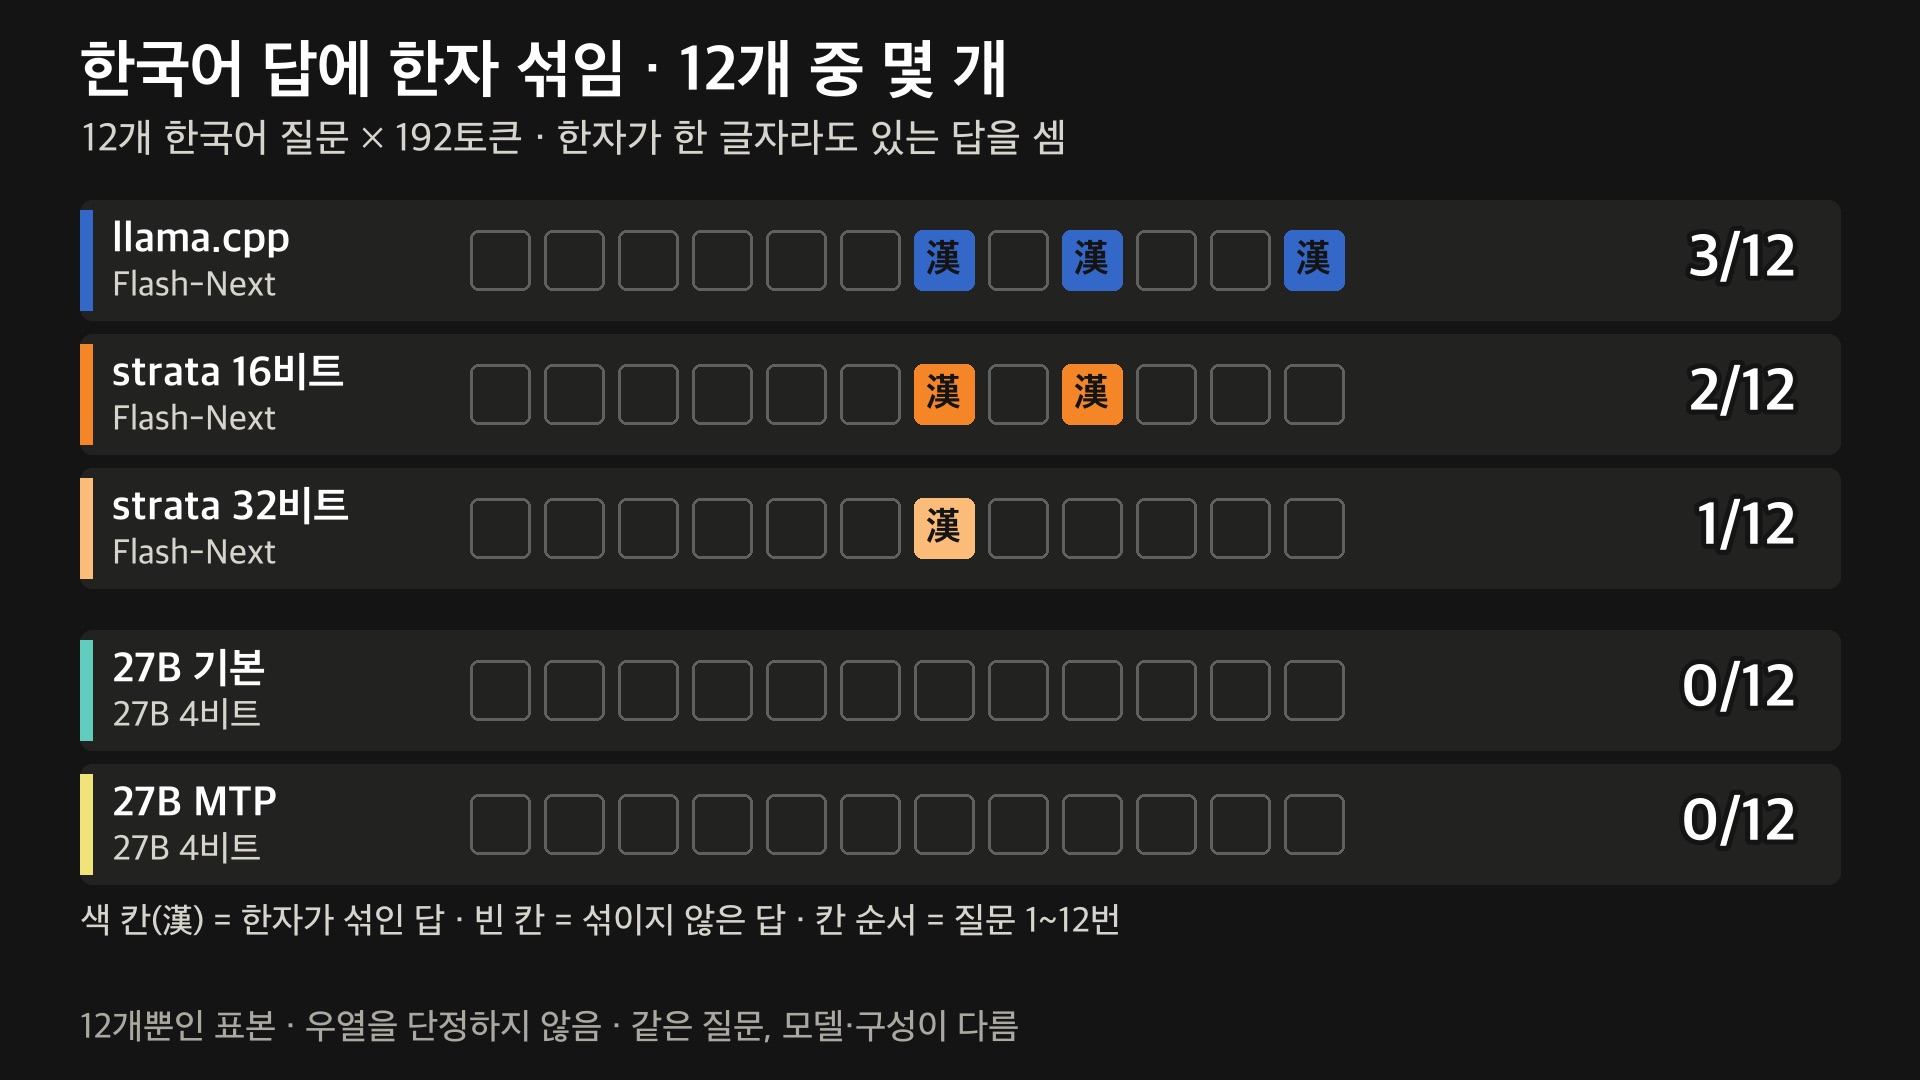
세 쌍 모두 차이를 확인하지 못했습니다(McNemar p=1.0). 한국어 12개 질문에서 한자가 섞인 답은 Flash-Next 1~3개, 27B 0개였지만 12개 표본이라 참고만 하세요.
공식 모델 카드 점수(제작사 보고, 원본 정밀도)는 Flash-Next가 높습니다. DeepSWE 58.7 대 42.2, SWE-bench Pro 62.5 대 61.7, LiveCodeBench v6 91.9 대 90.3입니다. 그러나 Q2_0 파일은 줄인 것이어서, 파일 저자의 영어 측정에서 LiveCodeBench가 87.43에서 81.14로 내려갔습니다(인용). 두 파일의 코딩 점수를 같은 조건으로 잰 값은 없습니다.
고르는 기준
- 파일 크기 · 메모리 여유 · 한자 없는 한국어 답을 먼저 보면 27B 쪽입니다.
- 공식 점수를 먼저 보고 66GB 파일의 대가를 감수하겠다면 Flash-Next입니다.
- 속도는 27B MTP와 strata 기본이 비슷하고, 코딩 정답률로 고를 근거는 이 측정에 없습니다.
한계와 출처
맥 미니 한 대 · 한 날, 속도 3회, 정확도 150문항, 코딩 52문제 표본입니다. strata-mlx는 비공식 엔진이고 이 모델 전용입니다.
출처 · 기준일. 측정 2026-10-13. strata-mlx 저장소와 이슈 6번, 공식 모델 카드(Qwen/Qwen3.8-Flash-Next, Qwen3.8-27B).
본 글은 AI 음성이 쓰인 영상을 바탕으로 AI 작성 보조를 받아 정리했습니다. 정보 제공 목적이며 구매 권유가 아닙니다.