DGX Spark 직접 재 봤다: 128GB 박스 4종 vs 맥 미니 (2026-09 기준)
올린 날 영상 공개
DGX Spark를 클라우드에서 빌려 맥 미니 M6 32GB와 같은 모델로 쟀습니다. 혼자 쓰면 맥 미니(64 대 40토큰), 동시 16명 합계는 DGX(319 대 166). 128GB 박스 4종 판단 순서. 가격은 2026-09 기준.
DGX Spark를 클라우드에서 빌려 직접 재 보니, 혼자 쓰는 속도는 맥 미니 M6 32GB가 앞섰고(같은 35B-A3B 4비트 모델, 초당 64 대 40토큰) 여럿이 동시에 쓰는 합계는 DGX Spark가 앞섰습니다(동시 16명 합계 319 대 166토큰). 128GB를 CPU와 GPU가 나눠 쓰는 상자 4종은 "혼자냐 여럿이냐, CUDA가 필요하냐, 값이 먼저냐"로 갈렸습니다.
기준일 안내. 이 글의 가격 · 제품 정보는 영상 공개일(2026-09-28), 가격 열람일 2026-09-27 기준입니다. 그 뒤 값과 제품 구성이 바뀌었을 수 있고, 영상 당시 미출시였던 RTX Spark는 이후 출시 소식이 나왔지만(채널의 2026-10-20 영상 참고) 이 글에는 반영하지 않았습니다. 구매 전에는 최신 가격을 따로 확인하세요. 이 글은 5분 30초 영상의 내용을 글로 다시 정리한 것입니다.
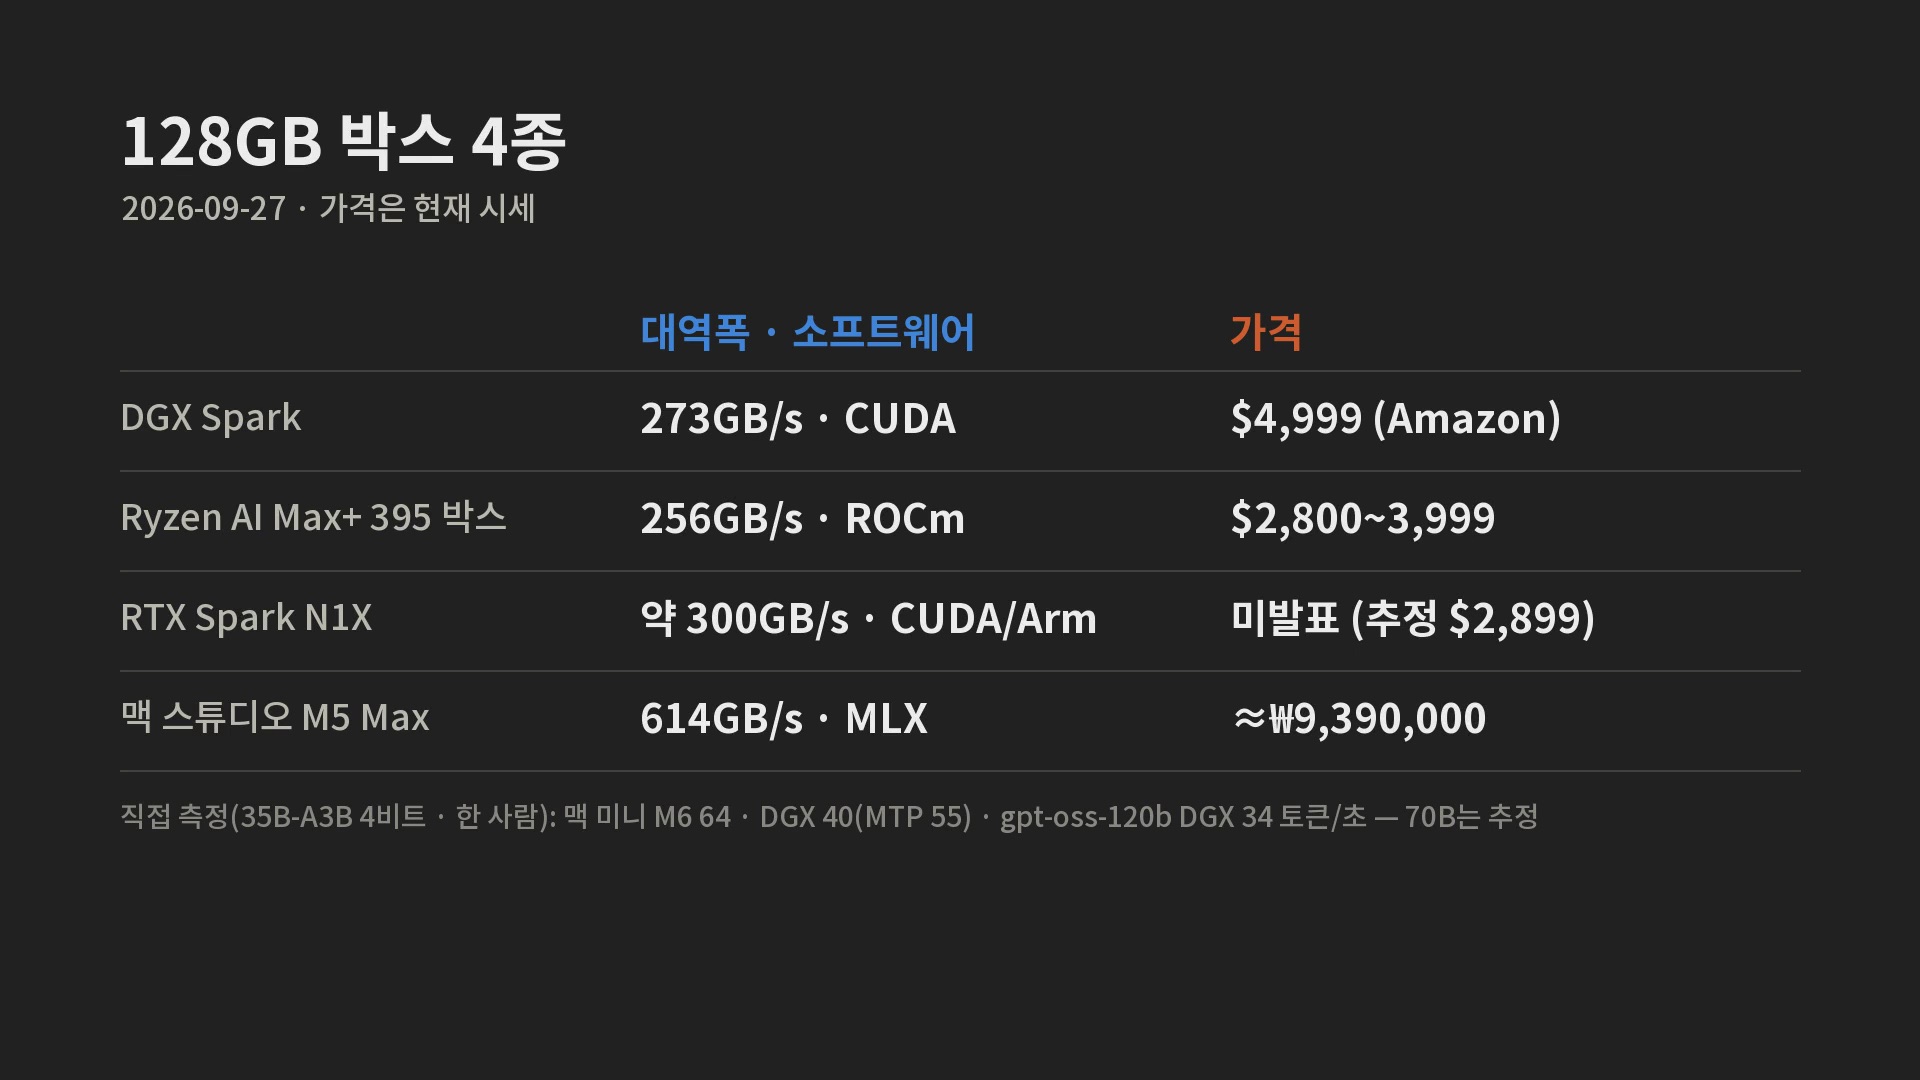
128GB 박스 4종, 한 표로 (2026-09-27 기준)
| 상자 | 메모리 대역폭 | 소프트웨어 | 값 (영상 공개일 기준) |
|---|---|---|---|
| NVIDIA DGX Spark | 273GB/s | CUDA | $4,999 (아마존) |
| Ryzen AI Max+ 395 박스 | 256GB/s | ROCm | $2,800~3,999 |
| RTX Spark N1X | 약 300GB/s | CUDA · Arm | 미발표 (모건스탠리 추정 $2,899) |
| 맥 스튜디오 M5 Max 128GB | 614GB/s | MLX | 약 939만 원 (영상 표기) |
대역폭은 제조사 공식(RTX Spark는 발표 사양)이고, 값은 영상에 적힌 값입니다. 이 가운데 우리가 직접 잰 것은 DGX Spark뿐입니다. 나머지 셋은 사양 · 추정 · 인용입니다.
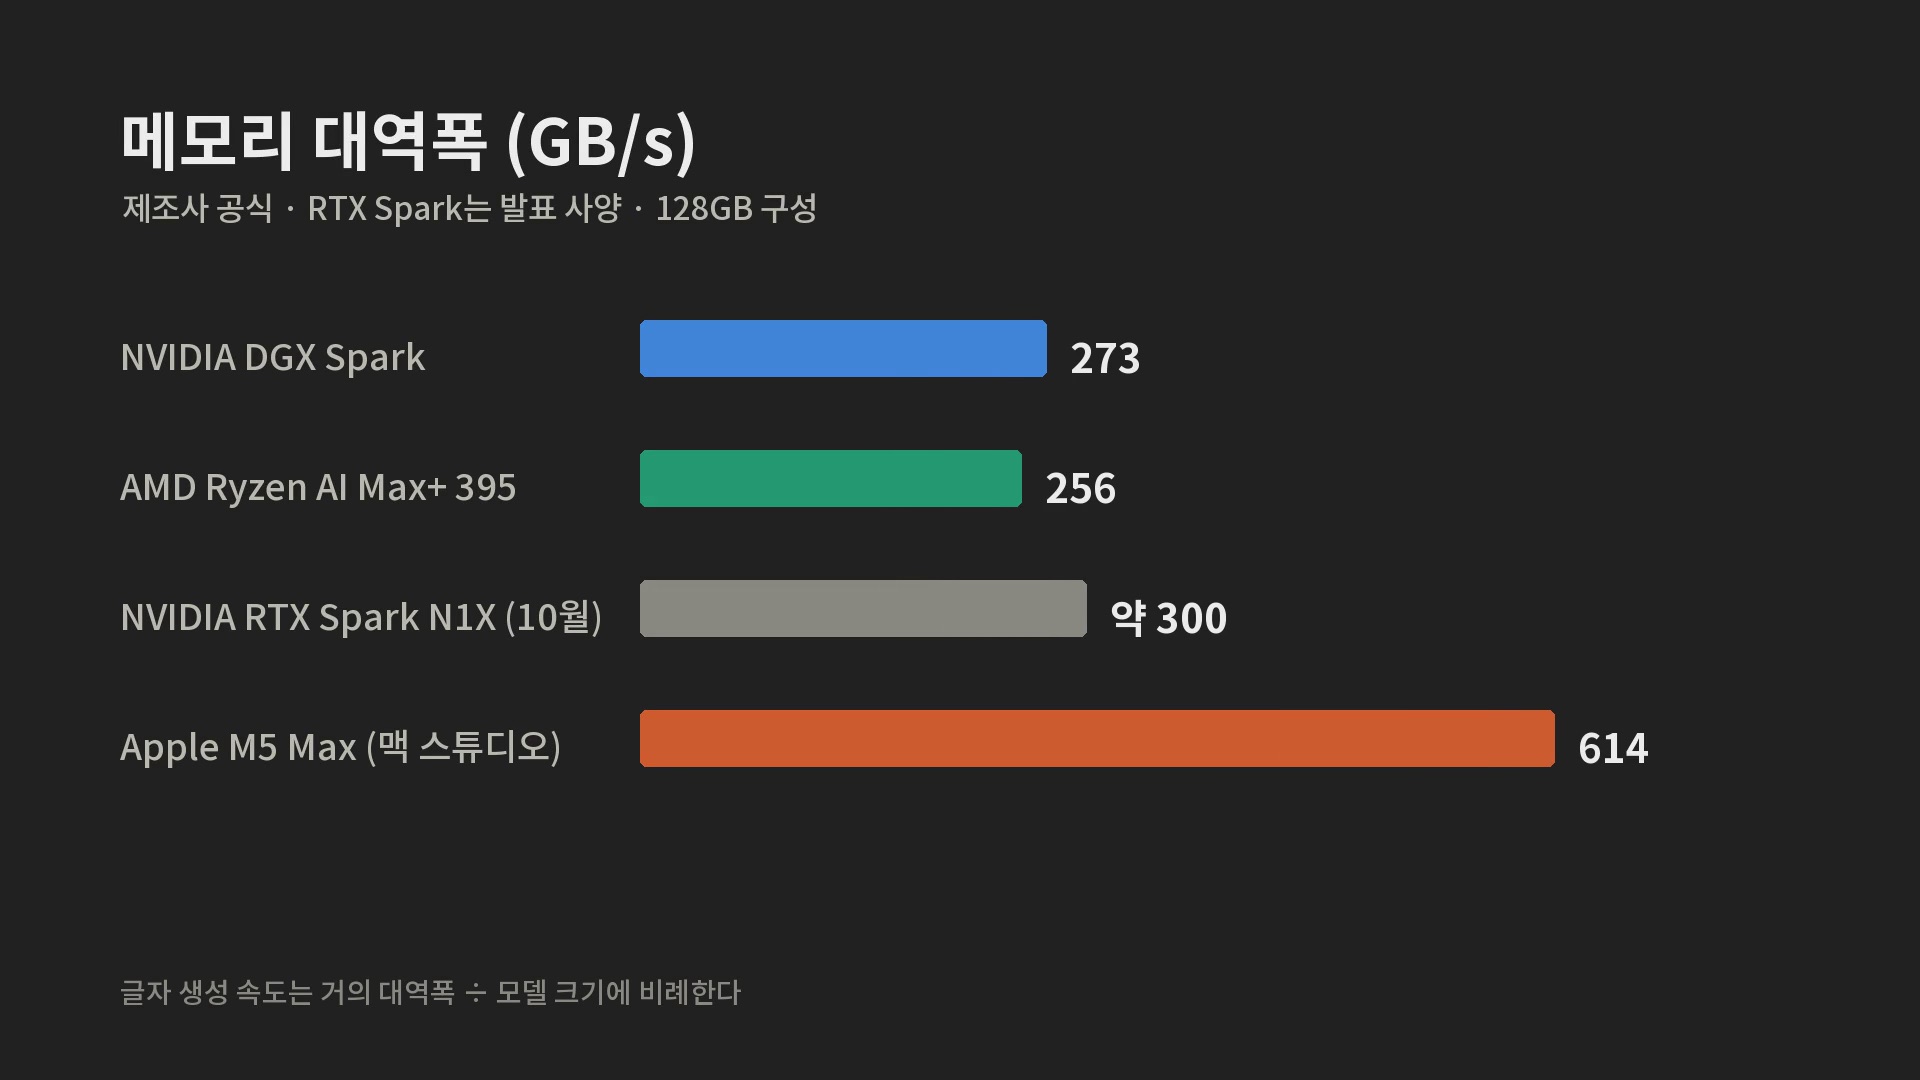
글자 생성 속도는 대역폭으로 먼저 가늠한다
글자를 한 개씩 만들 때마다 모델 전체를 메모리에서 읽기 때문에, 속도는 대략 "대역폭 ÷ 모델 크기"에 비례합니다. 맥 스튜디오 M5 Max는 614로 DGX Spark 273의 약 2.2배입니다(계산).
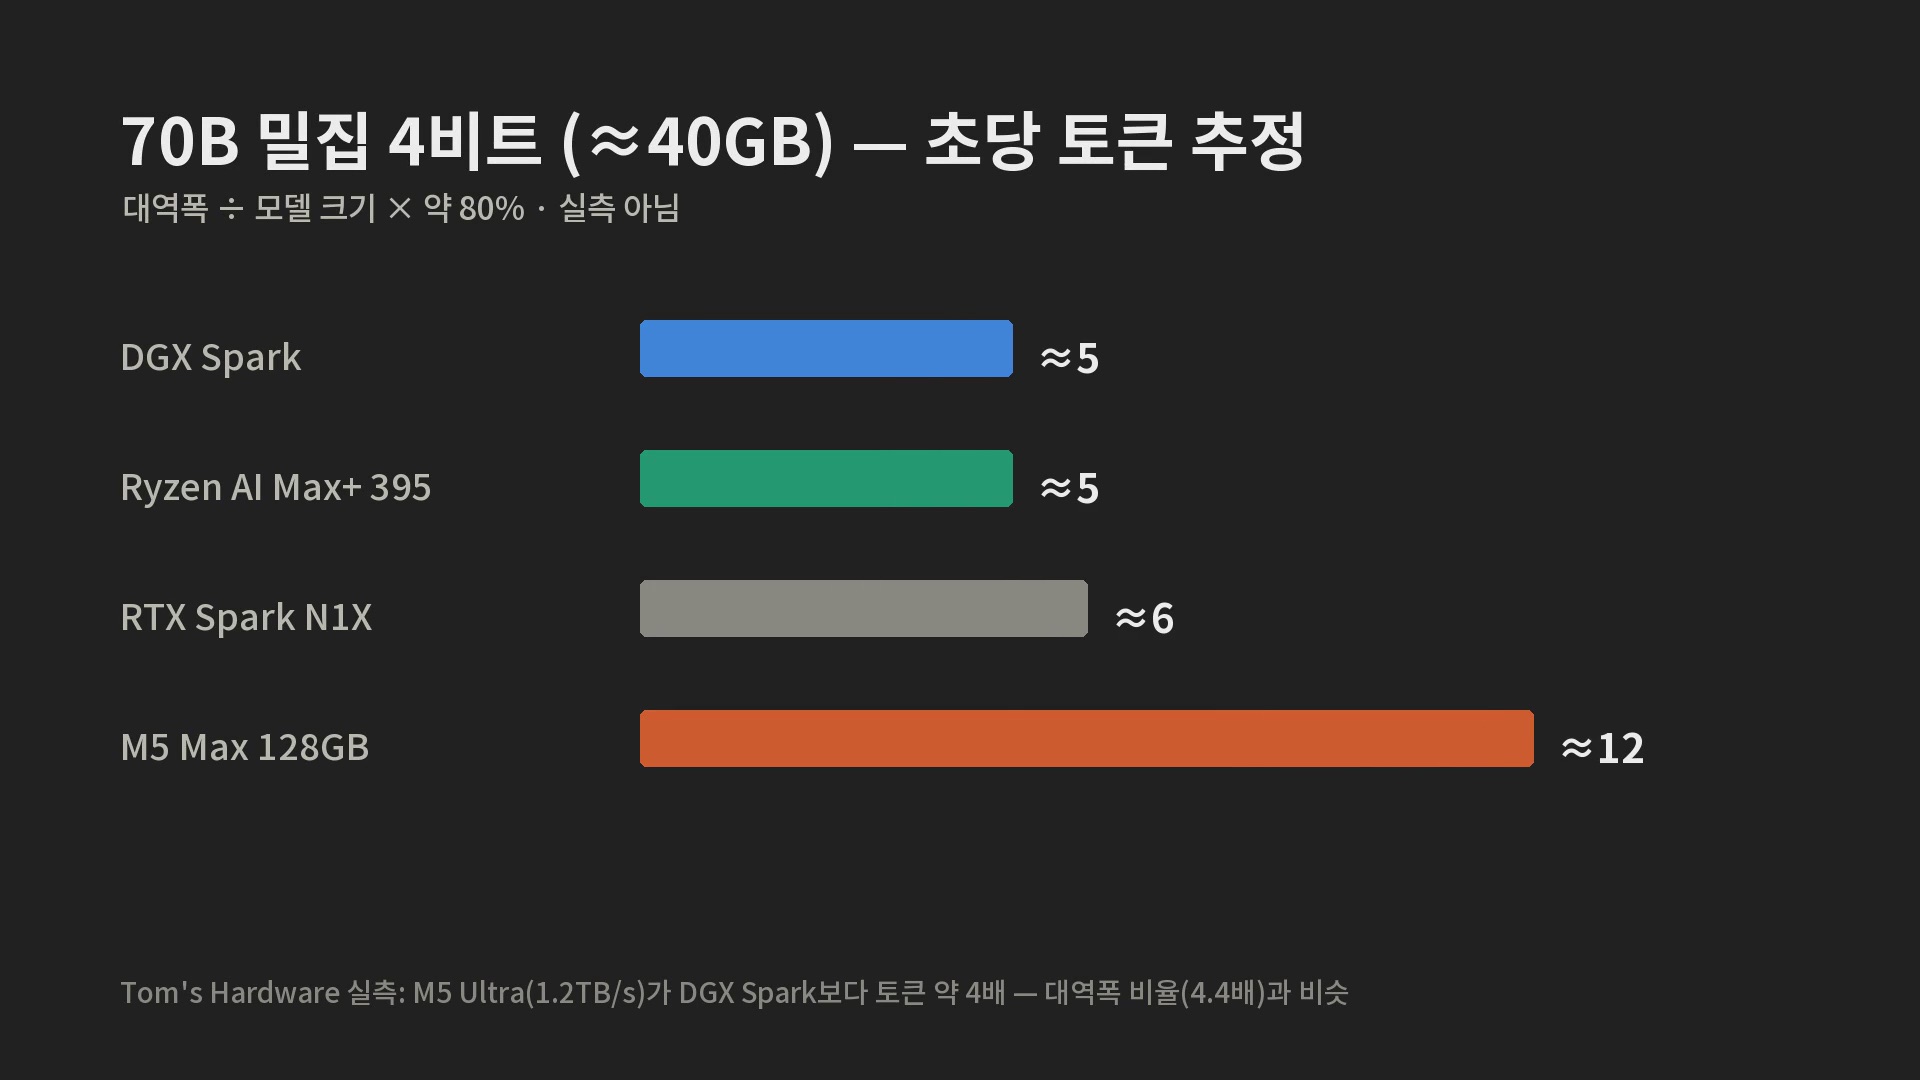
40GB짜리 70B 밀집 4비트 모델에 "대역폭 ÷ 크기 × 약 80%"를 적용하면 DGX Spark와 AMD는 초당 약 5토큰, RTX Spark 약 6, M5 Max 약 12토큰입니다(추정). 70B는 빌린 DGX Spark에서 두 번 실패해(호스트 재부팅, 서버 무로그 종료) 직접 재지 못했습니다. Tom's Hardware 측정에서는 M5 Ultra(1.2TB/s)가 DGX Spark보다 토큰이 약 4배로, 대역폭 비율 4.4배와 비슷했습니다(인용 · 2차).
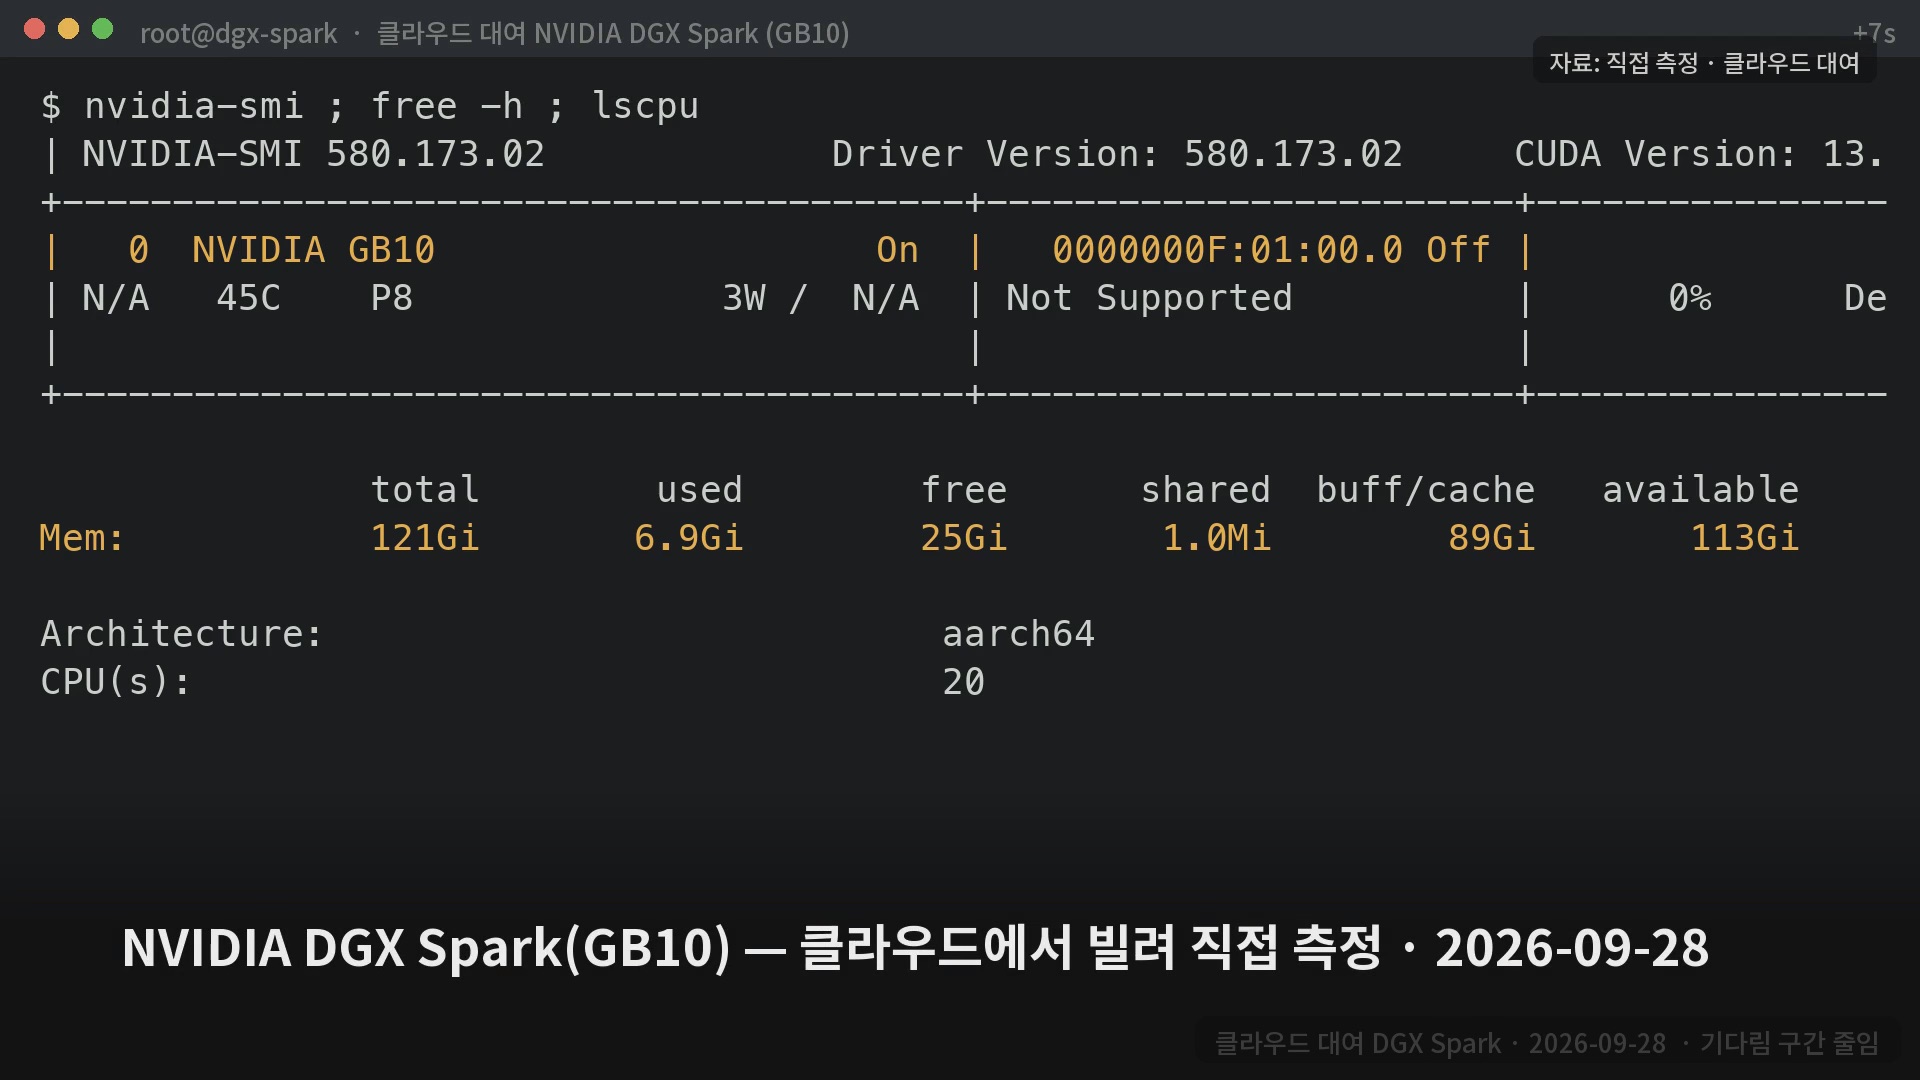
직접 빌려 재 본 DGX Spark: 혼자 쓸 때
2026-09-28에 클라우드(vast.ai)에서 DGX Spark를 시간당 $0.387에 빌렸습니다. 메모리는 121GiB로 잡히고 CPU는 ARM 20코어입니다.
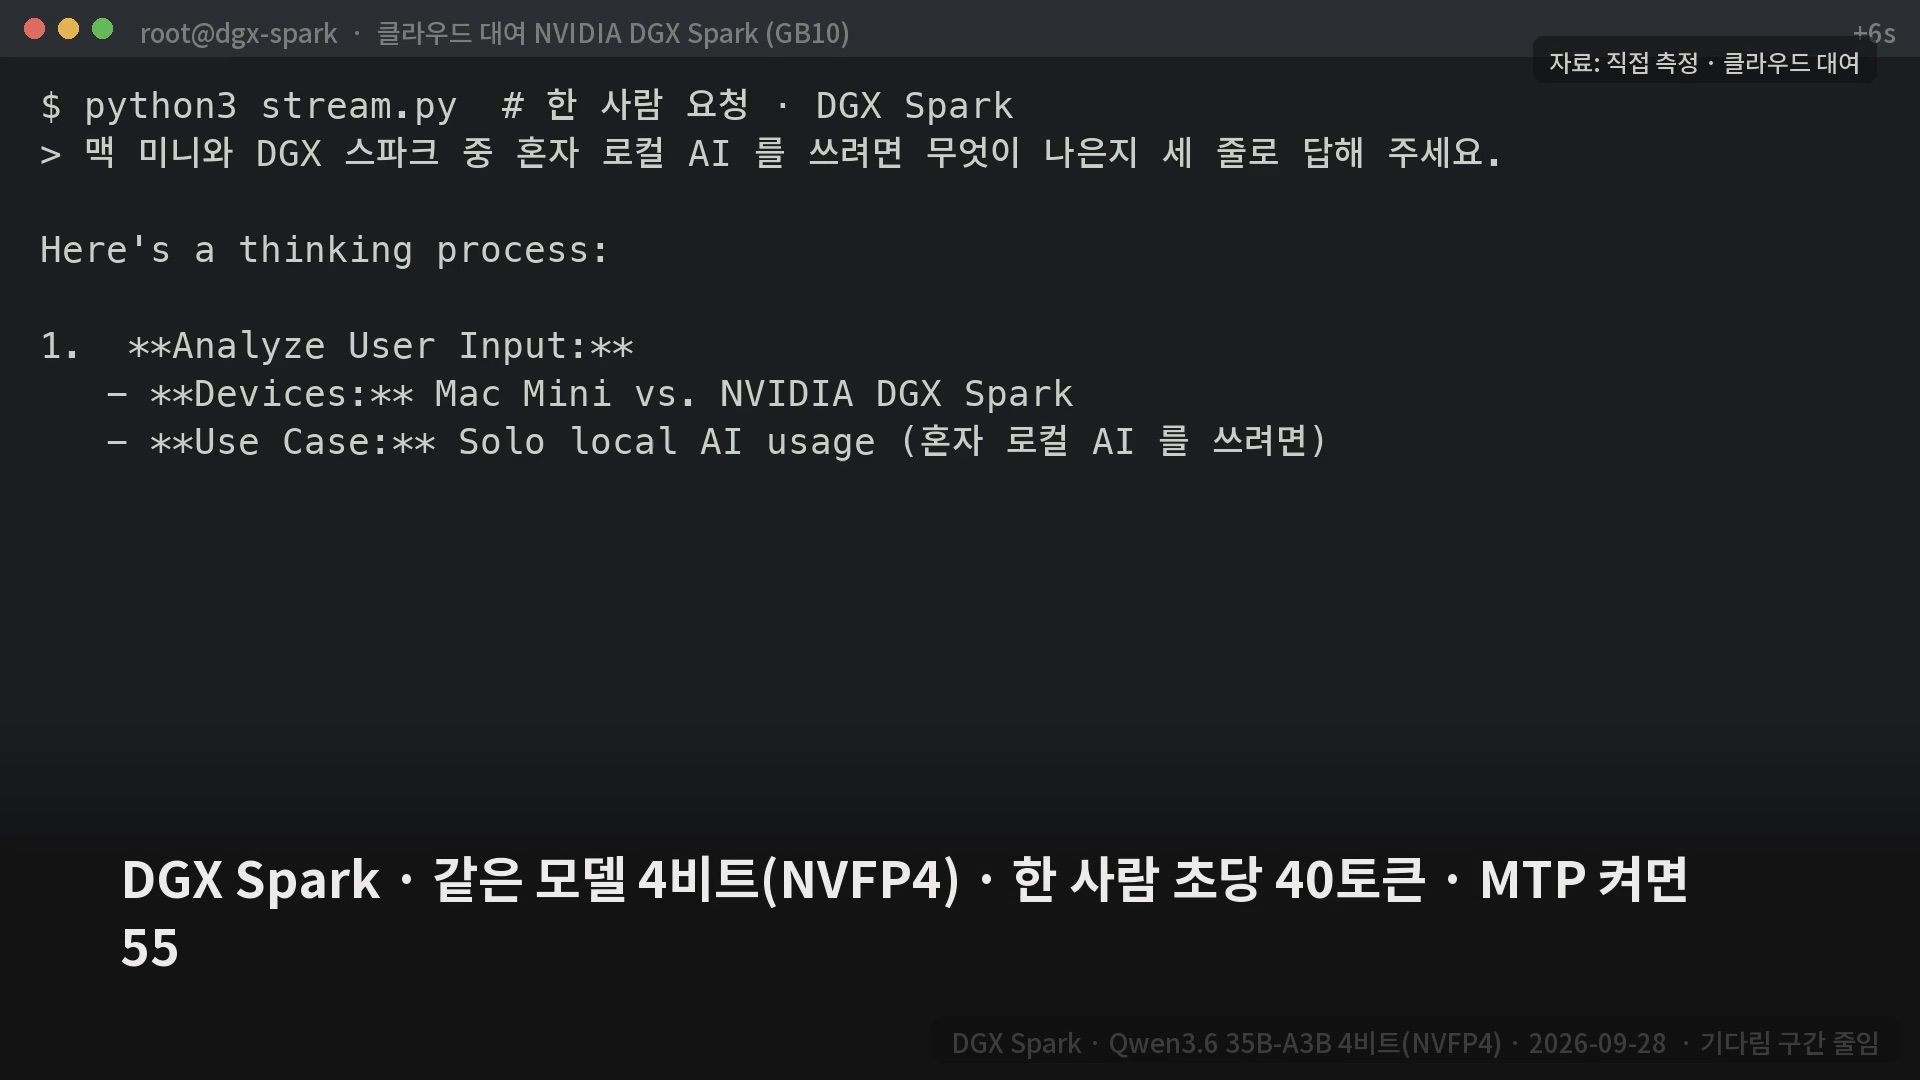
요즘 인기 모델은 전체는 크지만 글자마다 일부만 계산하는 MoE입니다. 같은 8개 질문을 돌려 쓰는 Qwen3.6 35B-A3B 4비트로, 한 사람이 300토큰을 받는 속도를 쟀습니다(측정).
| 구성 | 한 사람 초당 토큰 |
|---|---|
| 맥 미니 M6 32GB (MLX 4비트) | 63.9 |
| DGX Spark (NVFP4) | 39.9 · 40.8 |
| DGX Spark + 추측 디코딩 MTP | 54.1 · 55.3 |
혼자 쓰는 속도만 보면 DGX Spark가 맥 미니를 넘지 못했습니다. 다만 두 쪽의 4비트 형식이 다릅니다(DGX는 NVFP4, 맥은 MLX 4비트). NVIDIA 공식 NVFP4 파일은 쓴 vLLM 판에서 로딩 오류가 나 RedHatAI 판을 썼습니다. 빌린 서버는 소매 기기와 전력 · 설정이 다를 수 있습니다.
128GB의 진짜 쓰임: 큰 모델을 통째로
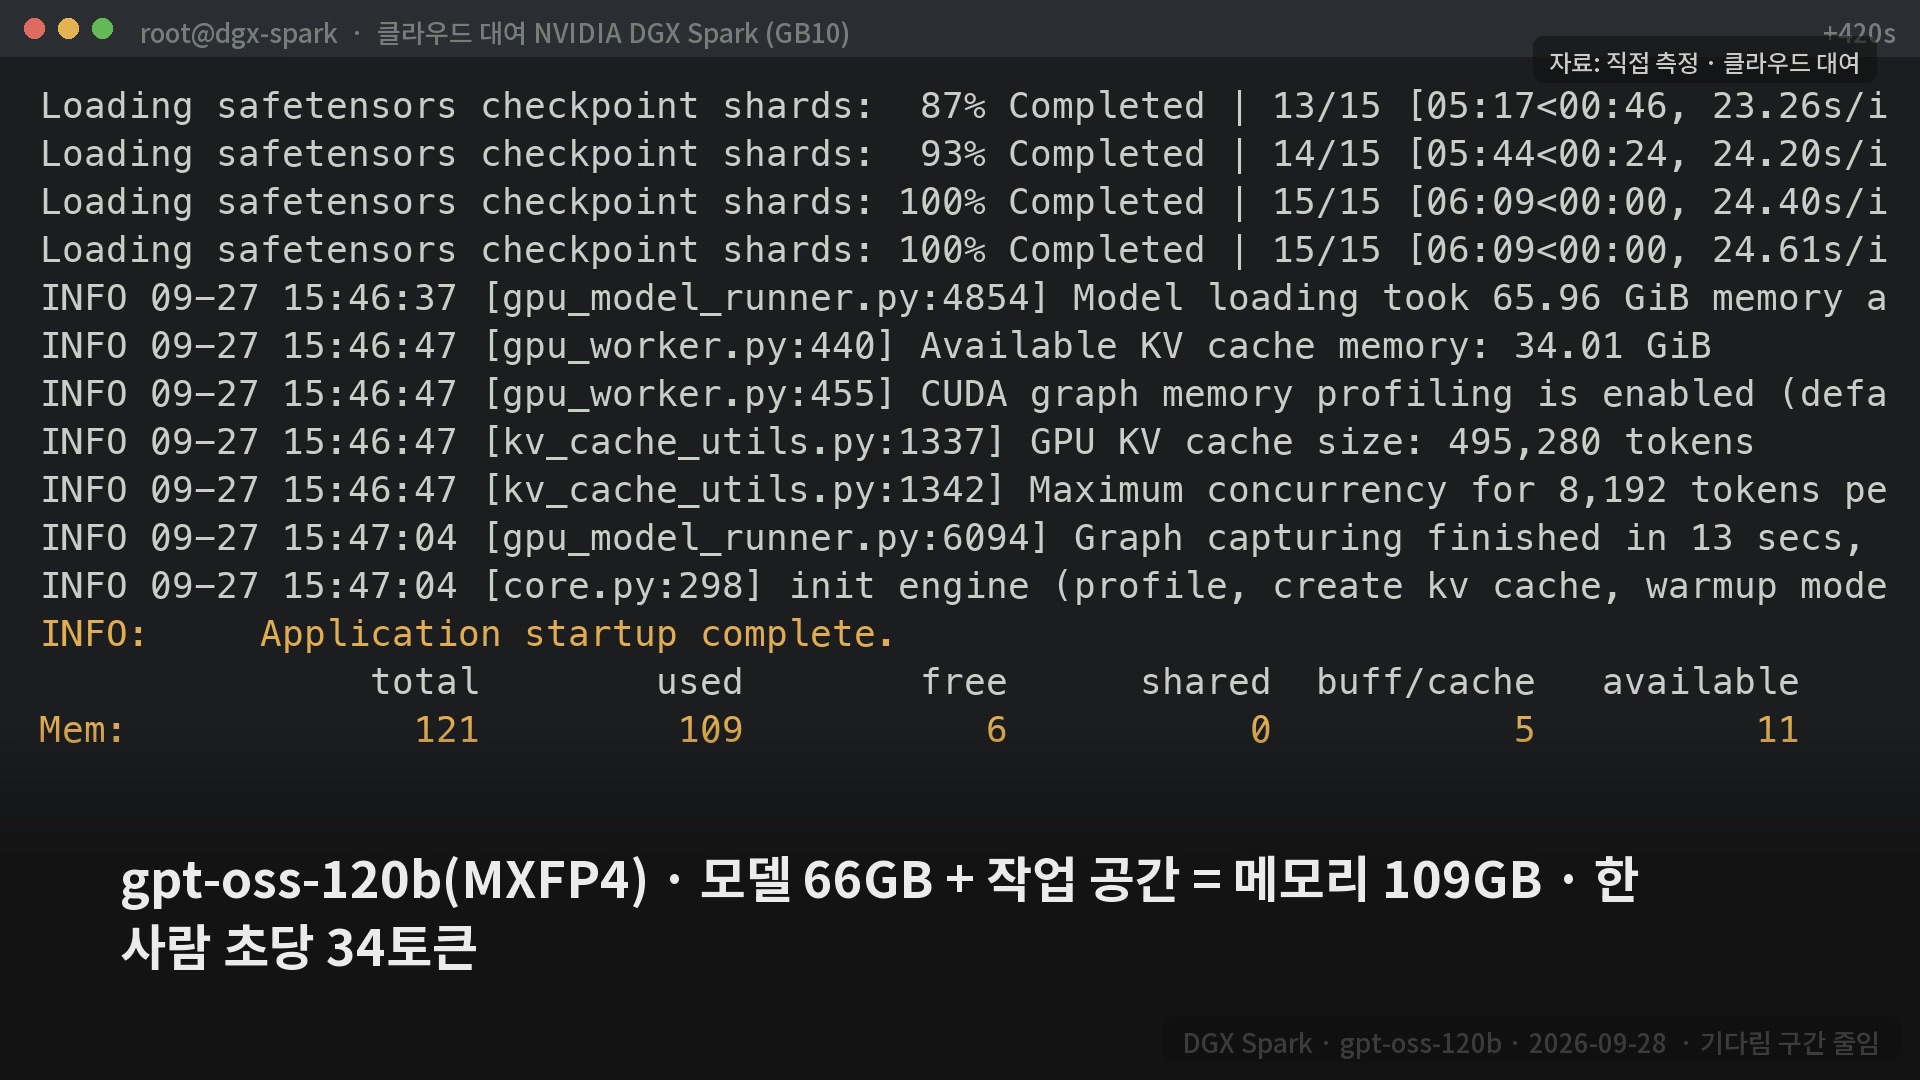
1,200억 개짜리 gpt-oss-120b(MXFP4)는 모델 약 66GiB에 작업 공간을 더해 메모리 109GiB(전체 121GiB 중)를 잡았고, 한 사람 초당 34.3토큰이 나왔습니다(측정, Dendro Logic 공개 측정 33.5와 비슷). 32GB 맥 미니에는 들어가지 않는 모델입니다.
동시에 쓰면 뒤집힌다
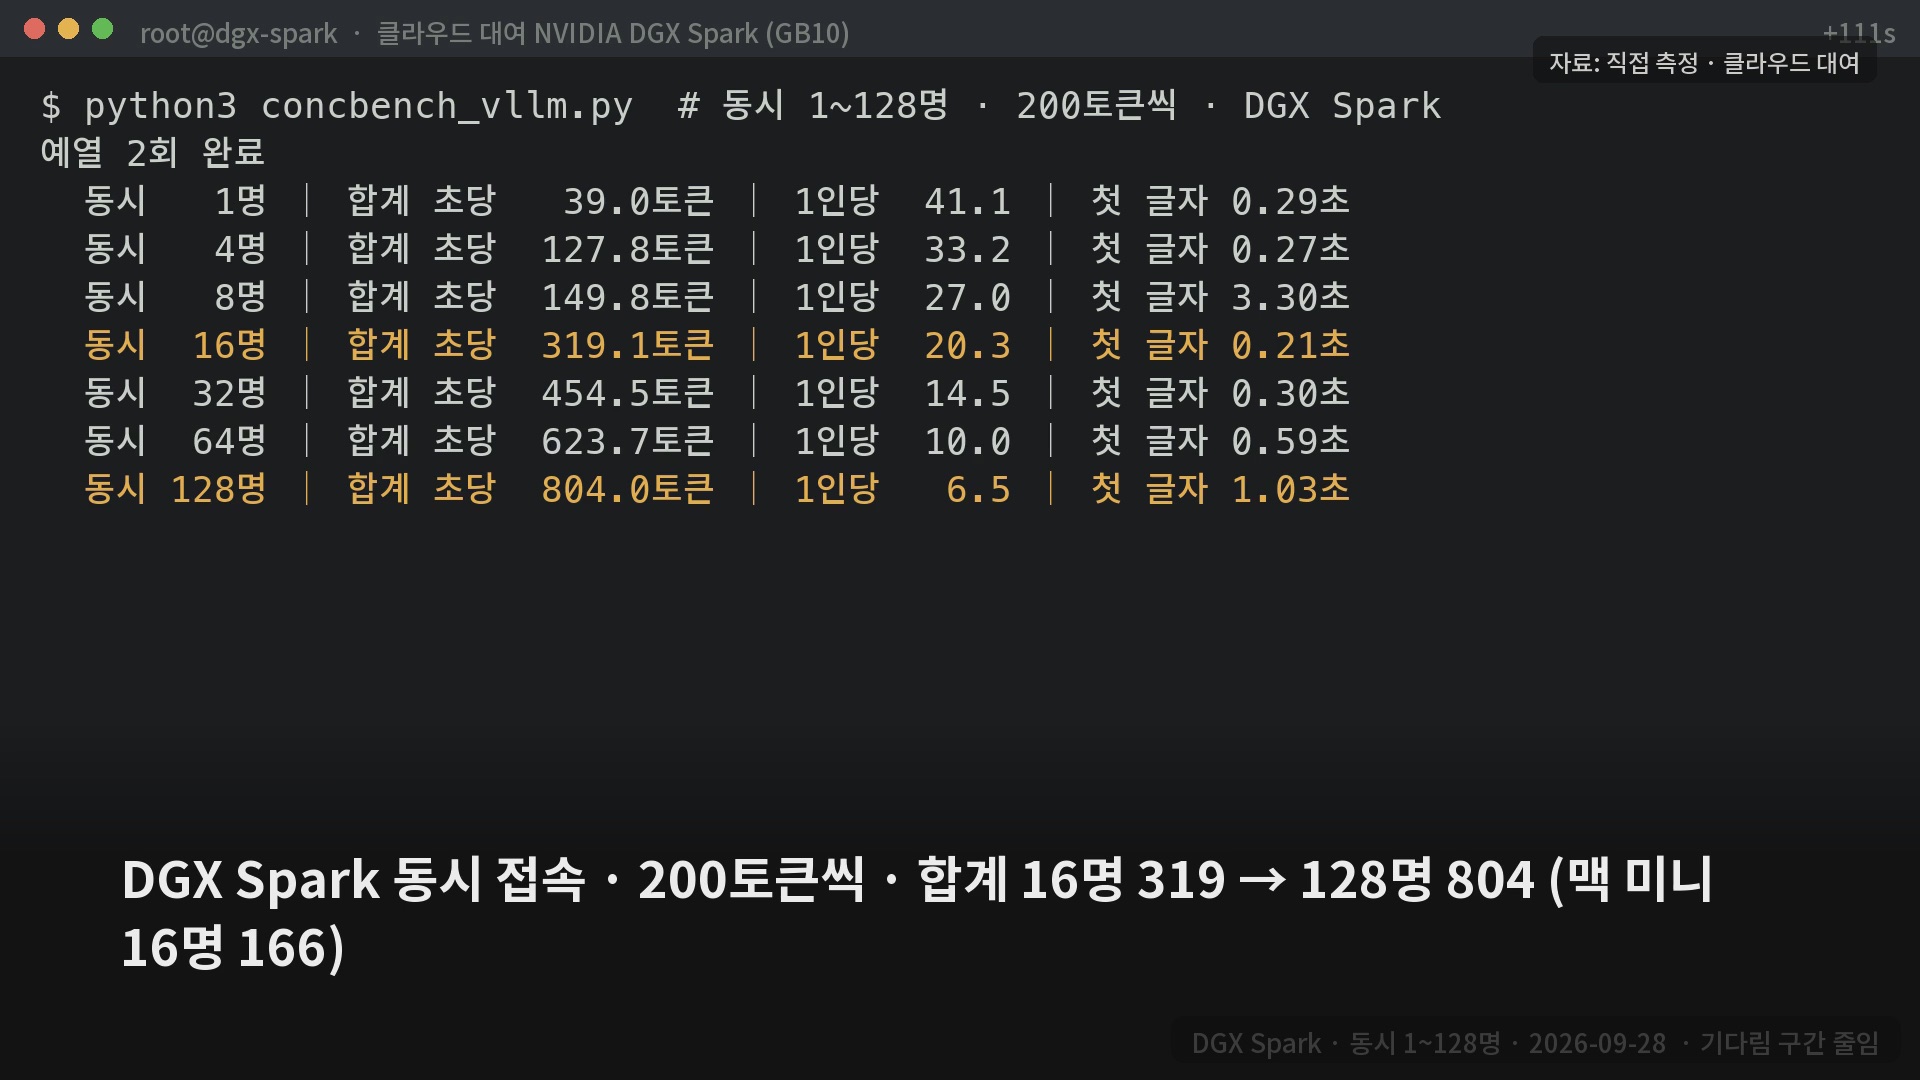
같은 모델에 1~128명이 요청마다 200토큰씩 동시에 요청했습니다. 칸은 "합계 · 1인 중앙값"(토큰/초, 측정)이고 DGX는 MTP를 끈 값입니다.
| 동시 사용자 | DGX Spark | 맥 미니 M6 32GB |
|---|---|---|
| 1명 | 39.0 · 41.1 | 62.4 · 64.6 |
| 4명 | 127.8 · 33.2 | 123.2 · 34.0 |
| 8명 | 149.8 · 27.0 | 150.0 · 20.7 |
| 16명 | 319.1 · 20.3 | 165.7 · 11.8 |
| 32명 | 454.5 · 14.5 | 미측정 |
| 64명 | 623.7 · 10.0 | 미측정 |
| 128명 | 804.0 · 6.5 | 미측정 |
1명에서는 맥 미니가 약 1.6배 앞서고(62.4÷39.0, 계산), 4명과 8명에서는 합계가 거의 같으며, 16명에서 DGX Spark가 약 1.9배(319.1÷165.7, 계산)입니다. 1명 행의 DGX 값(39.0 · 41.1)이 위 표의 39.9 · 40.8과 다른 것은 도구와 길이가 다르기 때문입니다. 위 표는 300토큰 시연 요청을 연달아 두 번 잰 값이고, 이 표는 200토큰 요청의 합계(첫 글자를 기다린 시간까지 넣어 나눔)와 1인 중앙값(글자가 나오기 시작한 뒤의 속도)입니다. 맥 미니는 16명까지만 쟀고 그 이상은 모릅니다.
고르는 순서
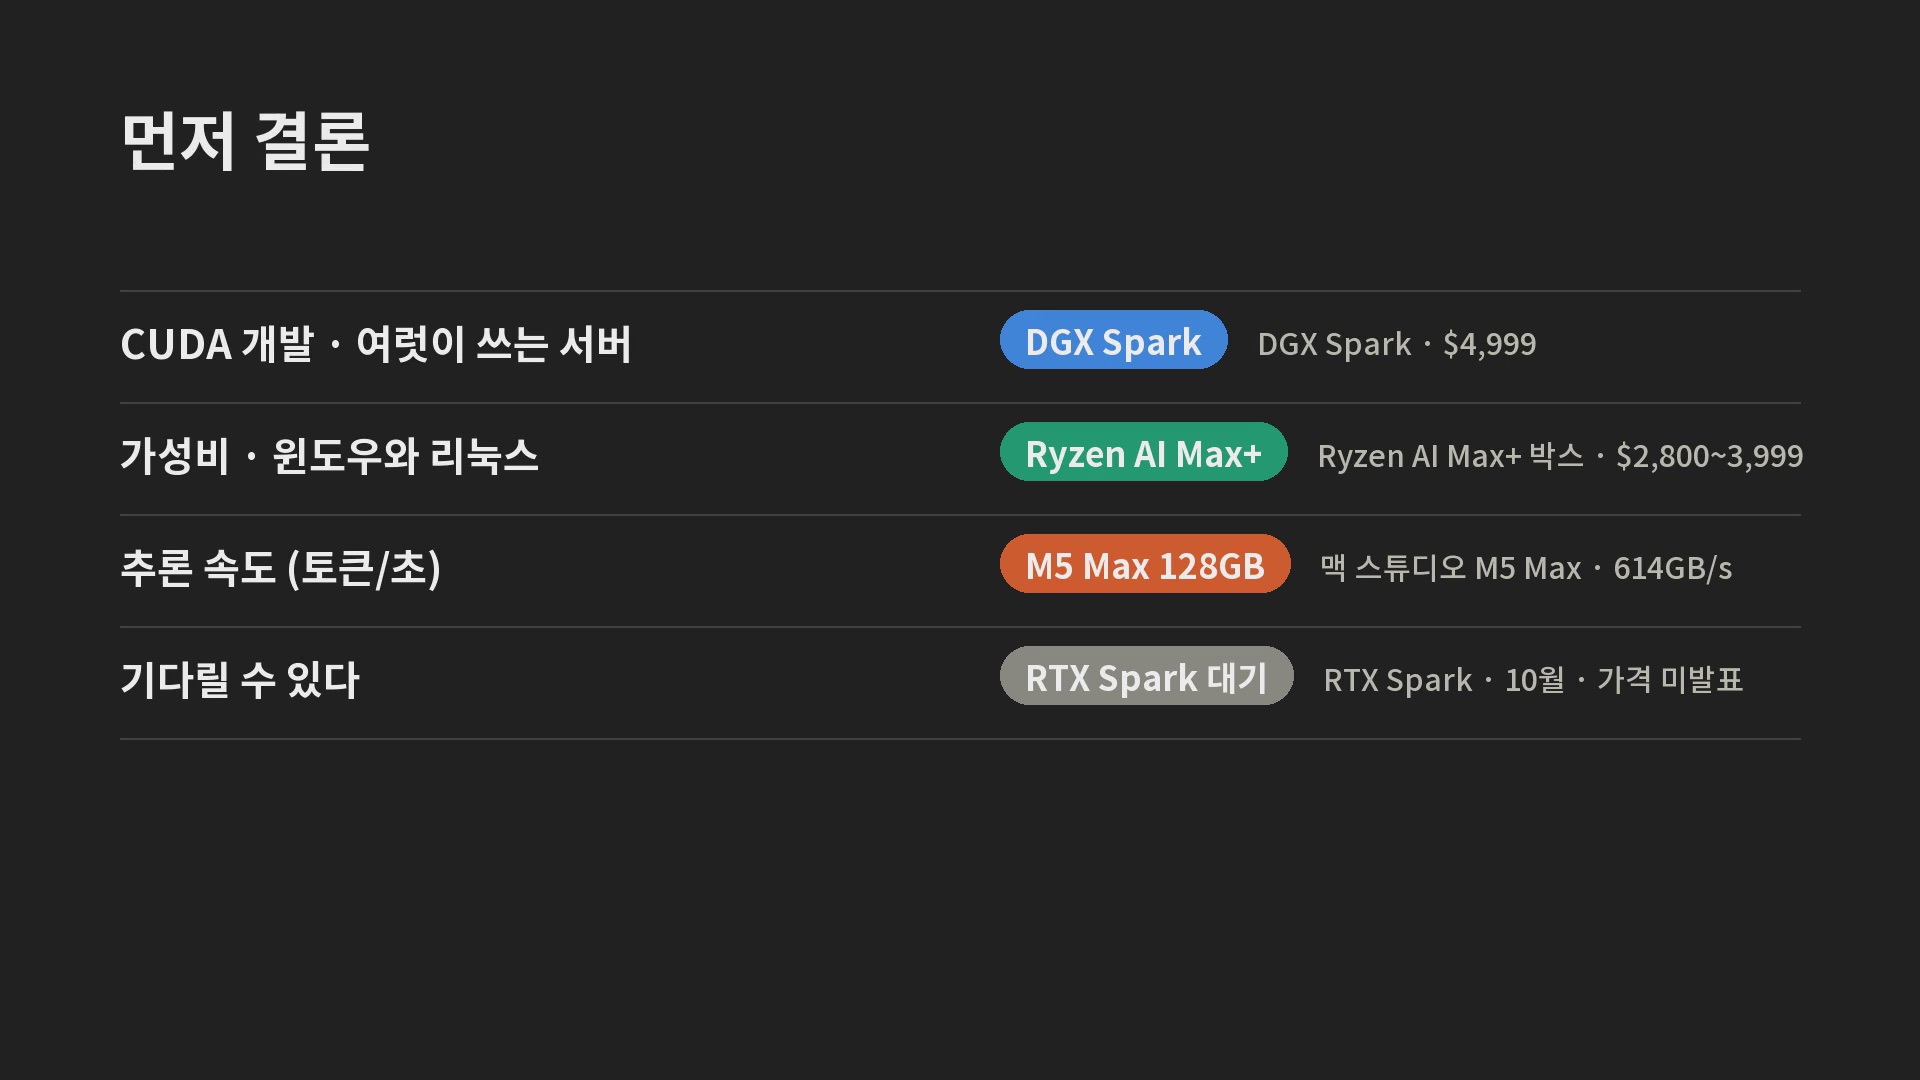
- CUDA 개발이나 여럿이 쓰는 서버면 DGX Spark.
- 값, 윈도우와 리눅스 둘 다면 Ryzen AI Max+ 박스 중 가장 싼 것. 같은 칩이라 속도는 같고 차이는 냉각 · 포트 · 보증입니다.
- 혼자 쓰는 추론 속도가 목적이면 대역폭이 높은 맥 스튜디오 M5 Max. 단 우리가 재지 않은 사양 기반 판단입니다.
- 기다릴 수 있으면 영상 당시 미발표였던 RTX Spark의 값과 호환성을 확인하세요(Windows on Arm이라 호환성은 출시 뒤 확인).
영상은 사기 전 세 가지도 짚었습니다. 128GB를 다 GPU가 쓰지는 못합니다(맥 약 75%, 다른 상자도 설정 한도). 램값 상승으로 이 상자들 값이 1년 새 40~65% 올랐다고 했습니다(영상 인용). 혼자 채팅이 목적이면 구독이 여전히 쌉니다.
측정 조건과 못 잰 것
조건(2026-09-28). DGX Spark: vast.ai 대여 · vLLM 0.19.2rc1 · 최대 길이 8192 · KV fp8. 맥 미니: mlx_lm 0.31.3 · mlx-community 4비트. 질문 8개 순환, 요청마다 200토큰, 한 사람은 300토큰.
못 잰 것. 70B 밀집 모델, Ryzen AI Max+ 박스, RTX Spark, 맥 스튜디오 M5 Max(모두 사양 · 추정 · 인용), 맥 미니 17명 이상, 전력 · 소음, 답변 품질.
출처 · 기준일. 측정 2026-09-28. 가격 2026-09-27: pi3g DGX Spark 가격표, TweakTown(2026-06-14), TerminalBytes(2026-05), 모건스탠리 추정(RTX Spark 정리 글), Apple Newsroom 2026-08-25, Tom's Hardware M5 Ultra 리뷰.
본 글은 AI 음성이 쓰인 영상을 바탕으로 AI 작성 보조를 받아 정리했습니다. 정보 제공 목적이며 구매 권유가 아닙니다.