맥 미니 M6 32GB 서버 vs M5 Pro 24GB, 5가지 상황별 비교(M6 직접 측정)
올린 날 영상 공개
맥 미니 M6 32GB 서버와 M5 Pro 24GB를 웹사이트·집 서버·작은 AI·동시 접속 AI·큰 모델 5가지 상황으로 비교했습니다. M6는 직접 측정, M5 Pro는 공개값·추정으로 구분하고 판단 순서와 못 잰 것도 정리했습니다.
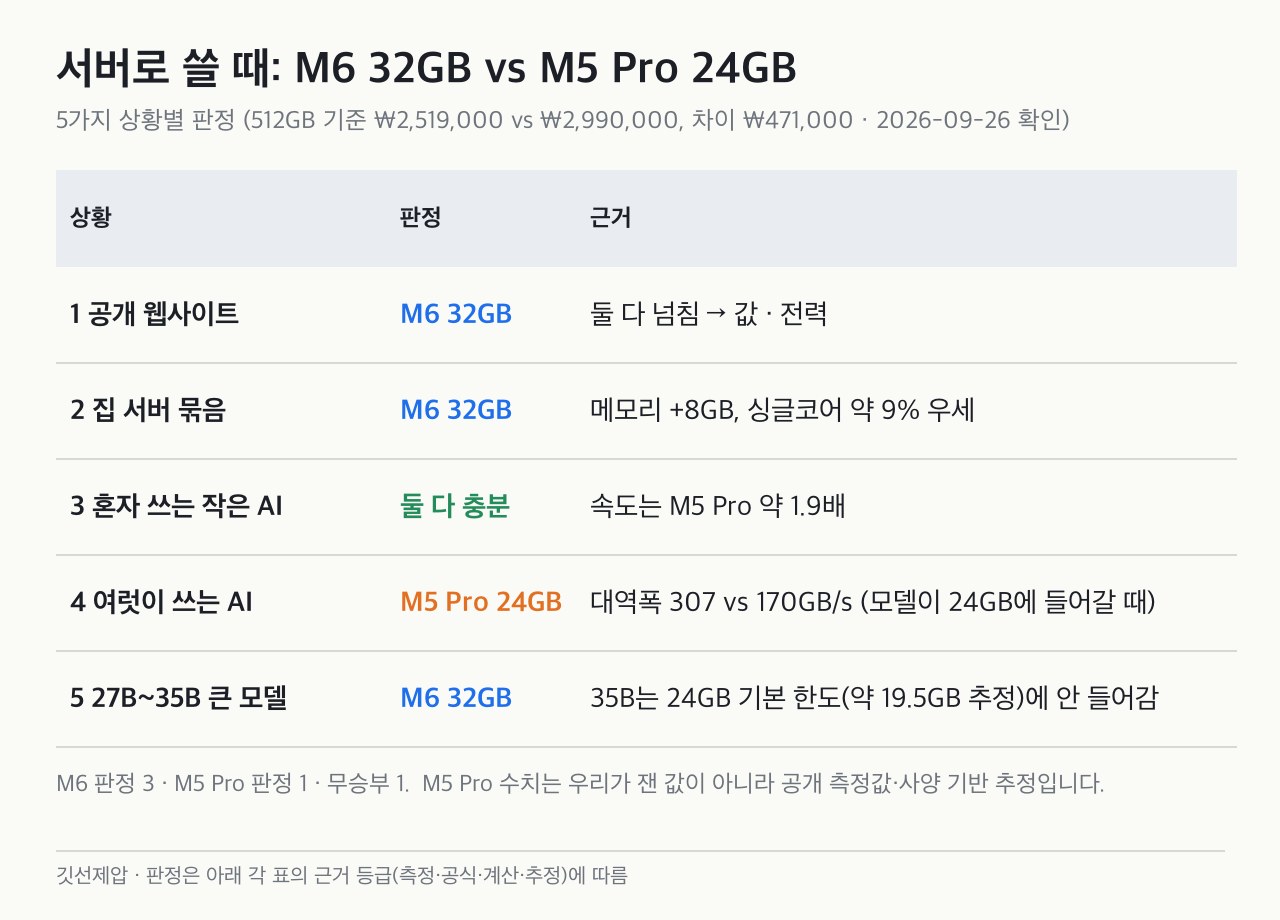
맥 미니 M6 32GB 서버와 M5 Pro 24GB 서버 중 무엇이 맞는지는 "무엇을 돌리느냐"로 갈립니다. 공개 웹사이트 · 집 서버 묶음 · 큰 AI 모델은 M6 32GB, 여럿이 동시에 쓰는 AI 서버는 M5 Pro, 혼자 쓰는 작은 AI는 둘 다 충분했습니다.
영상을 찍은 2026-09-26에는 512GB 기준 값 차이가 47만 1천 원이었습니다(2,519,000원 대 2,990,000원). 2026-10-30 애플 코리아 표시가는 맥 미니 M6 32GB(저장 256GB) 2,179,000원, M5 Pro 24GB(저장 512GB) 2,990,000원으로, 저장공간 구성이 달라 같은 조건의 차액은 아닙니다.
M6 32GB는 직접 쟀고, M5 Pro는 실물이 없어 공개 측정값과 사양으로 비교했습니다. 숫자마다 측정 · 공식 · 계산 · 추정 등급을 붙였습니다. 이 글은 YouTube 영상(11분 46초)의 내용을 글로 다시 정리한 것입니다.
두 기종 한눈에 비교
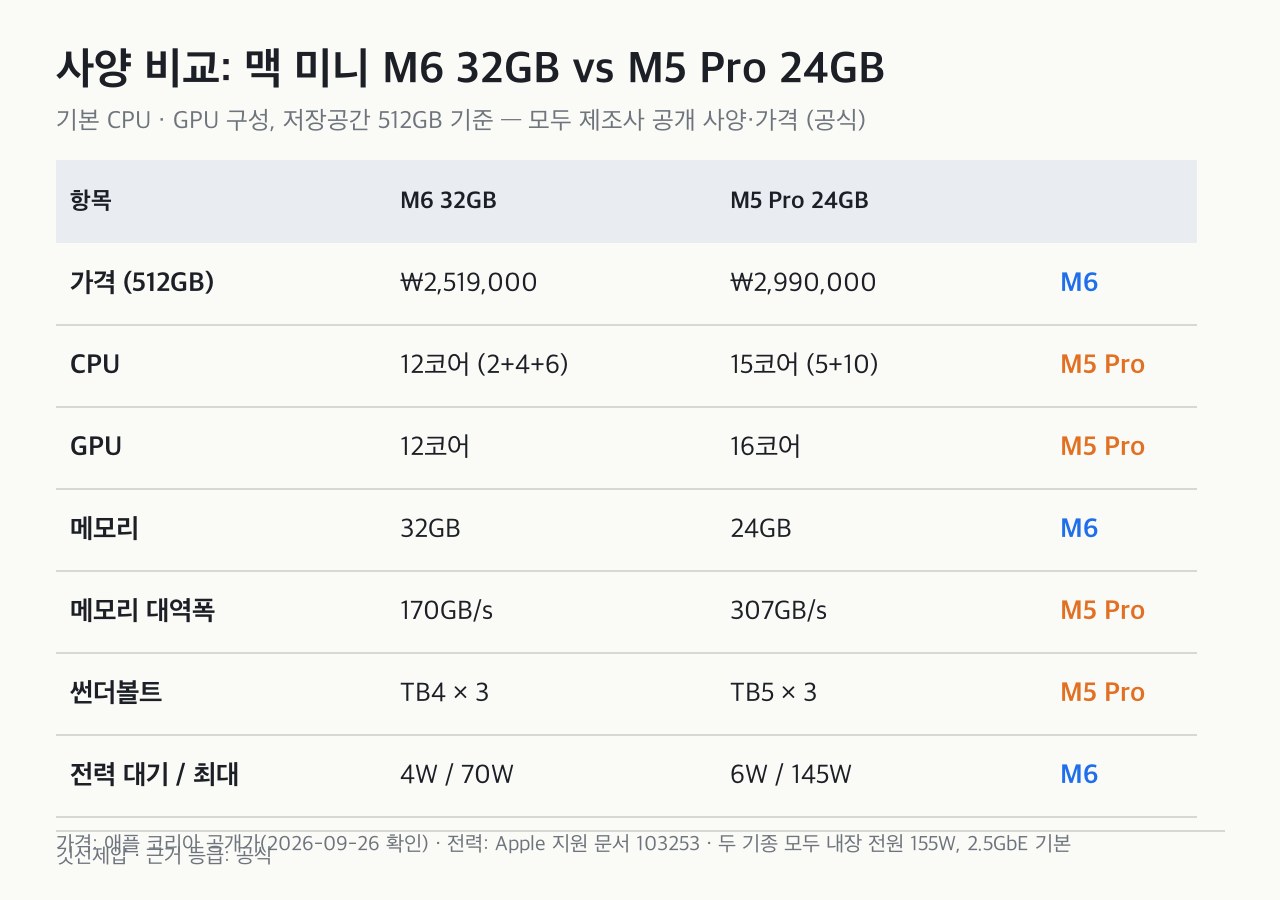
겉은 같고(전원 155W · 2.5GbE) 차이는 안에 있습니다. 서버에서는 메모리 용량(창고 크기)과 대역폭(창고 문 너비)이 핵심입니다. M6는 32GB · 170GB/s, M5 Pro는 24GB · 307GB/s입니다(공식).
맥 미니 서버로 웹사이트와 집 서버 묶음 (상황 1·2)
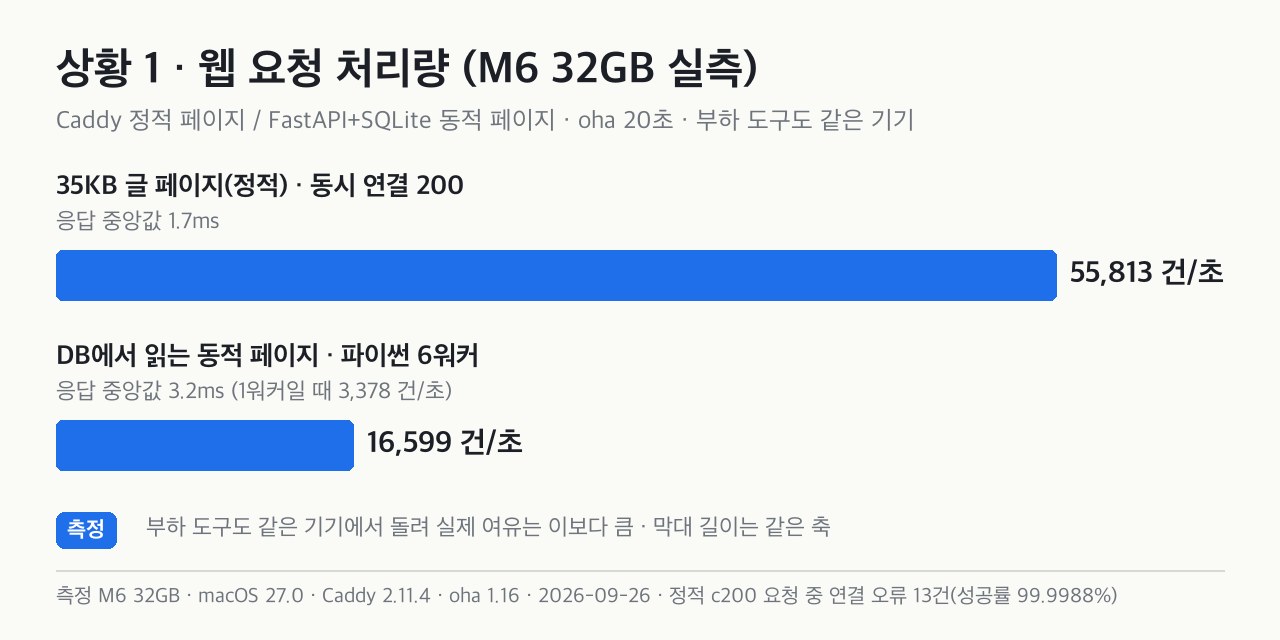
상황 1, 공개 웹사이트. M6 32GB의 Caddy 웹서버에 35KB 글 페이지를 20초 동안 요청했더니 초당 55,813건(동시 연결 200)이었습니다. DB에서 읽는 동적 페이지(FastAPI+SQLite, 6워커)도 초당 16,599건입니다(모두 측정). 부하 도구도 같은 기기에서 돌렸습니다.
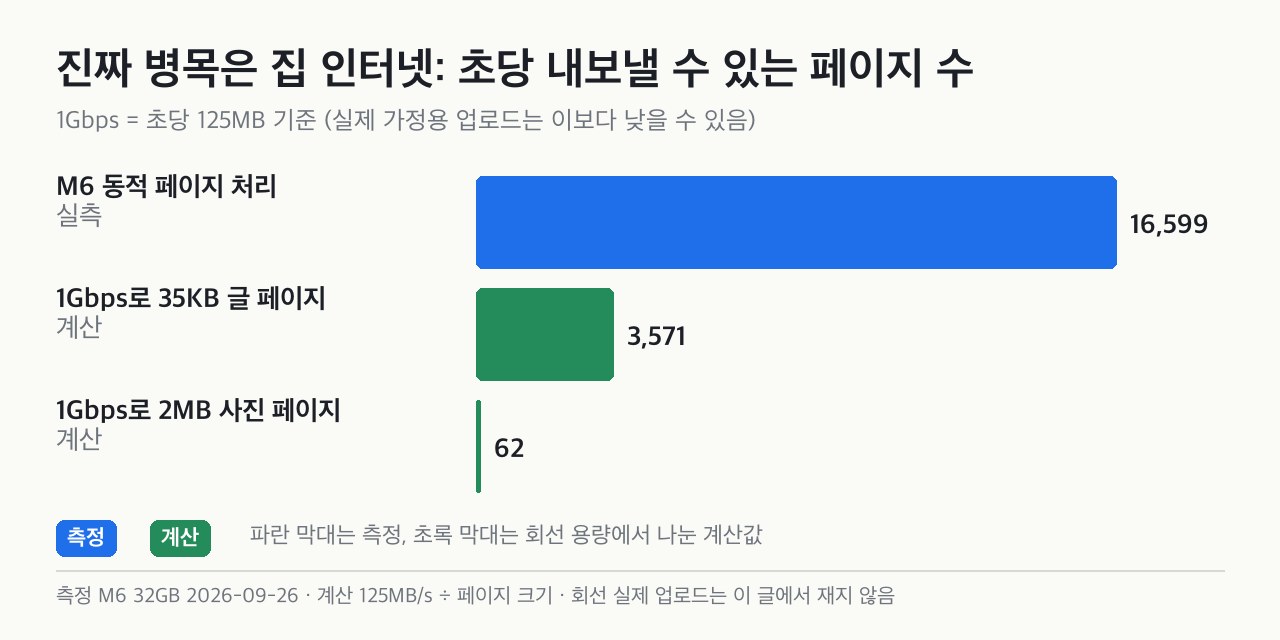
병목은 집 인터넷입니다. 1Gbps(초당 125MB)면 35KB 페이지는 초당 약 3,571건, 2MB 사진 페이지는 약 62건이 한계입니다(계산). KT 약관(2025.3)은 승인 없는 상업용 서버 운영도 제한합니다(인용). 둘 다 넘치면 싸고 전기를 덜 쓰는 쪽이 낫고, 공식 대기 전력 4W · 6W로 한 달이면 약 750원 · 1,100원입니다(계산). 가정은 하루 24시간 · 한 달 720시간(4W=약 2.9kWh, 6W=약 4.3kWh), 주택용 2구간 단가 kWh당 214.6원에 부가요금 14원을 더하고 부가세·기금 1.127배를 곱한 값입니다. 가구가 2구간이라는 가정은 출처가 없고, 1구간이면 4W는 약 440원, 3구간이면 약 1,050원입니다.
상황 2, 집 서버 묶음. 레딧 서버 글 387개의 용도는 1위 파일 · 백업, 2위 미디어, 3위 도커였습니다(전수 조사 아님). 이 묶음은 칩보다 메모리가 먼저 모자랍니다(맥의 도커는 가상머신 안에서 돌며 메모리를 따로 뗍니다). M6는 메모리가 8GB 많고 싱글코어가 약 9% 앞서(공개 Geekbench 7 비교, 2차 자료) M6 32GB가 맞습니다.
혼자 쓰는 작은 AI (상황 3)
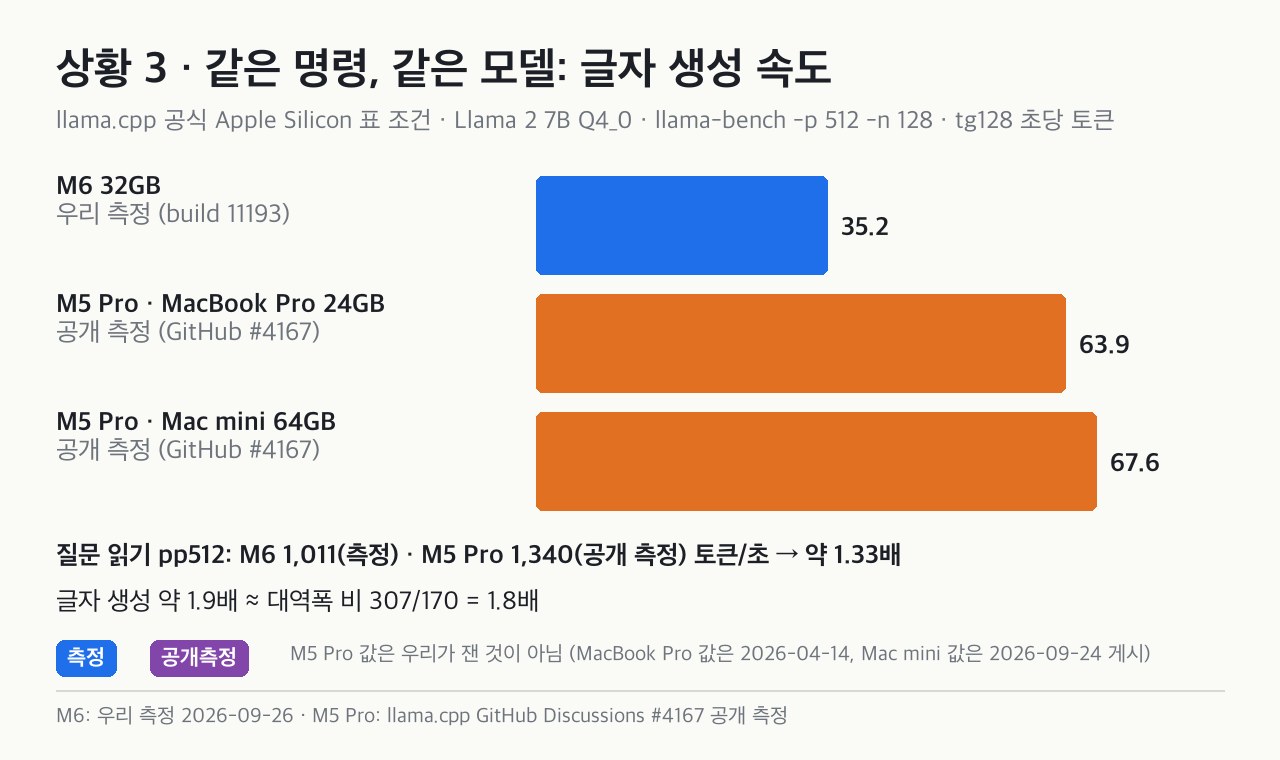
llama.cpp 공식 표와 같은 명령(llama-bench, Llama 2 7B Q4_0)으로 쟀습니다. 글자 생성은 M6 32GB가 초당 35.2토큰(측정)이고, M5 Pro는 MacBook Pro 24GB 63.9 · Mac mini 64GB 67.6토큰으로 약 1.9배입니다(공개 측정, GitHub #4167).
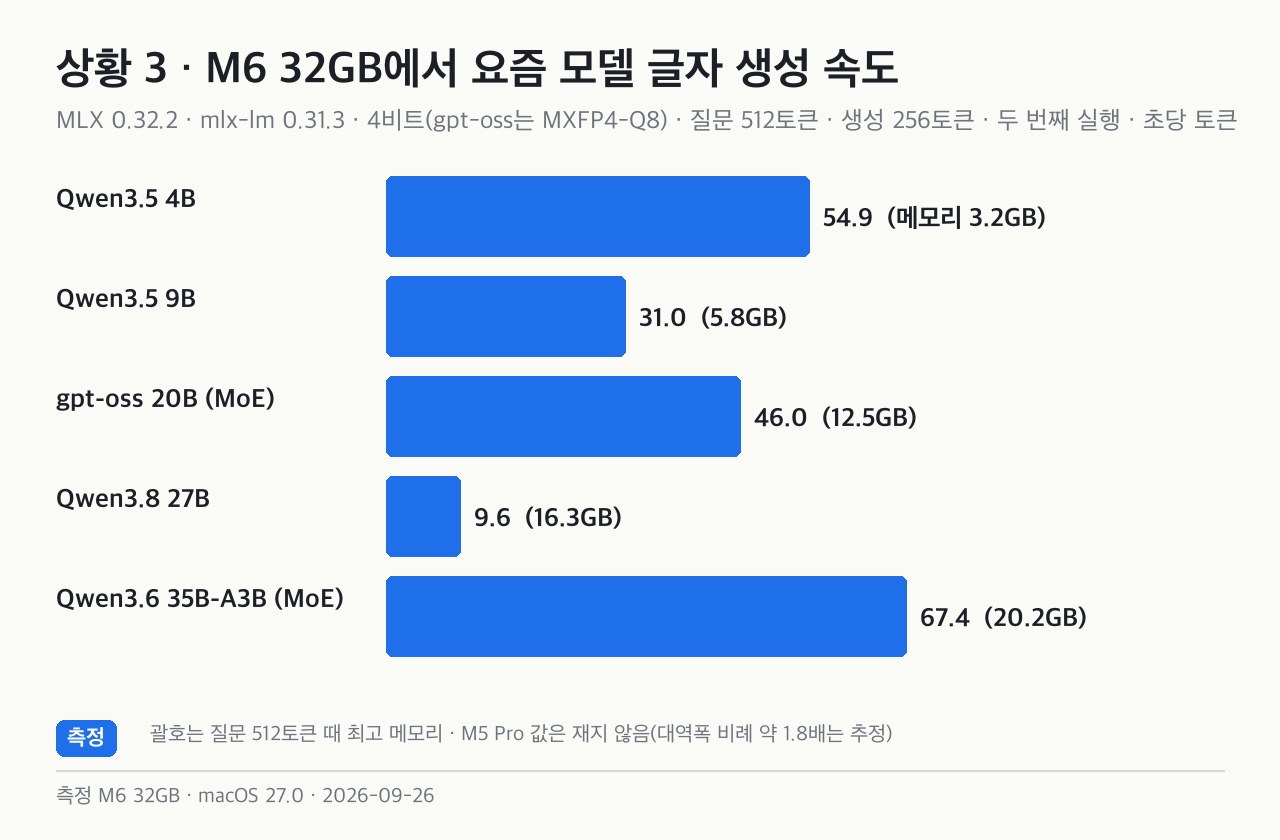
요즘 모델은 M6 32GB에서 MLX 4비트로 쟀습니다. Qwen3.5 4B 54.9, 9B 31.0, gpt-oss 20B 46.0, Qwen3.8 27B 9.6, Qwen3.6 35B-A3B 67.4토큰/초입니다(측정). 읽는 속도가 초당 대여섯 토큰이라 혼자 쓰기엔 M6도 충분합니다.
여럿이 쓰는 AI 서버 (상황 4)
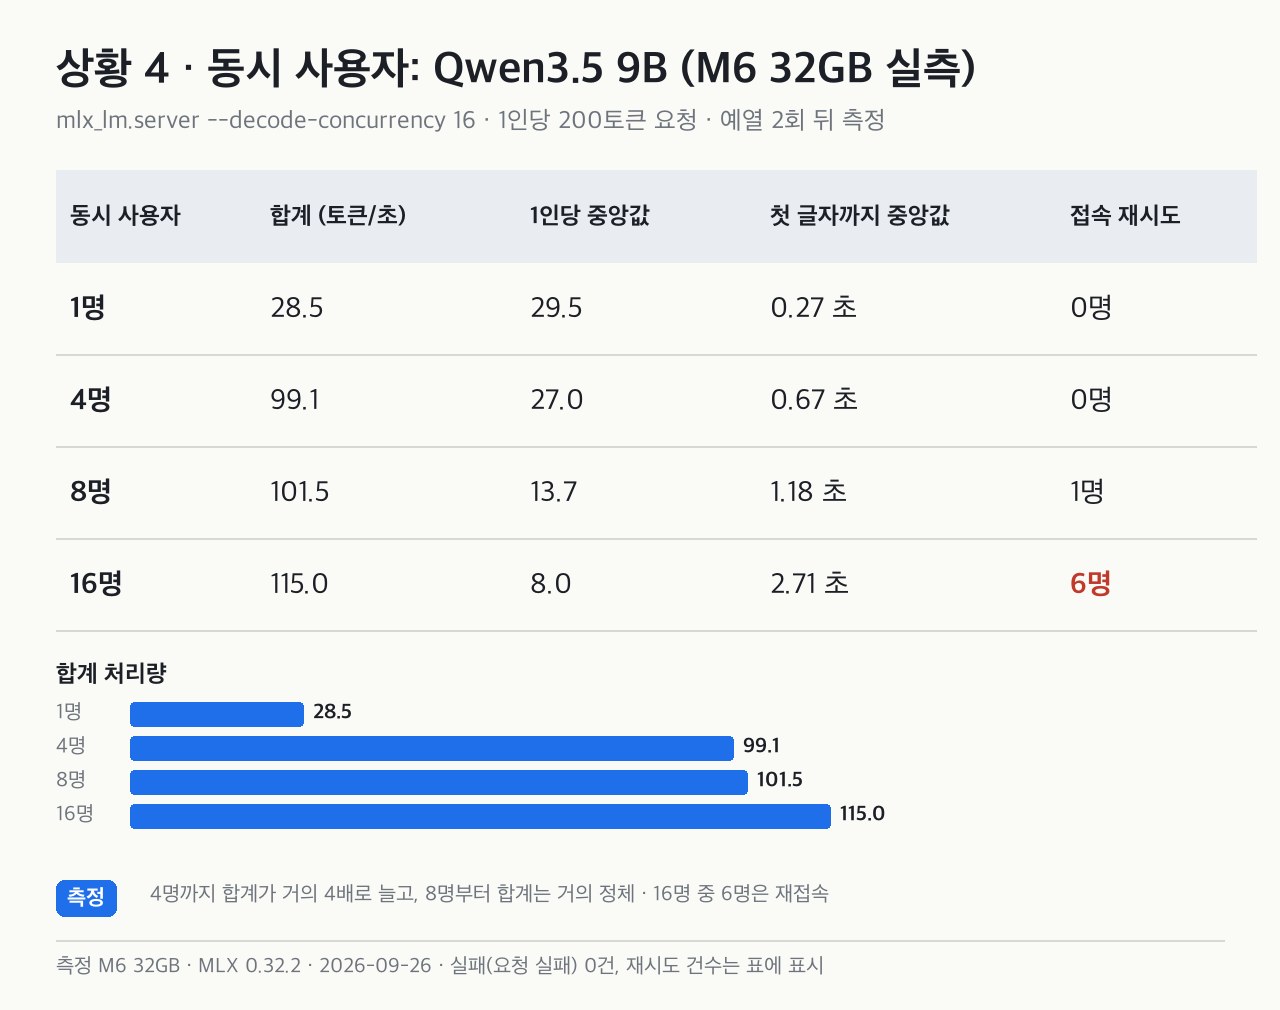
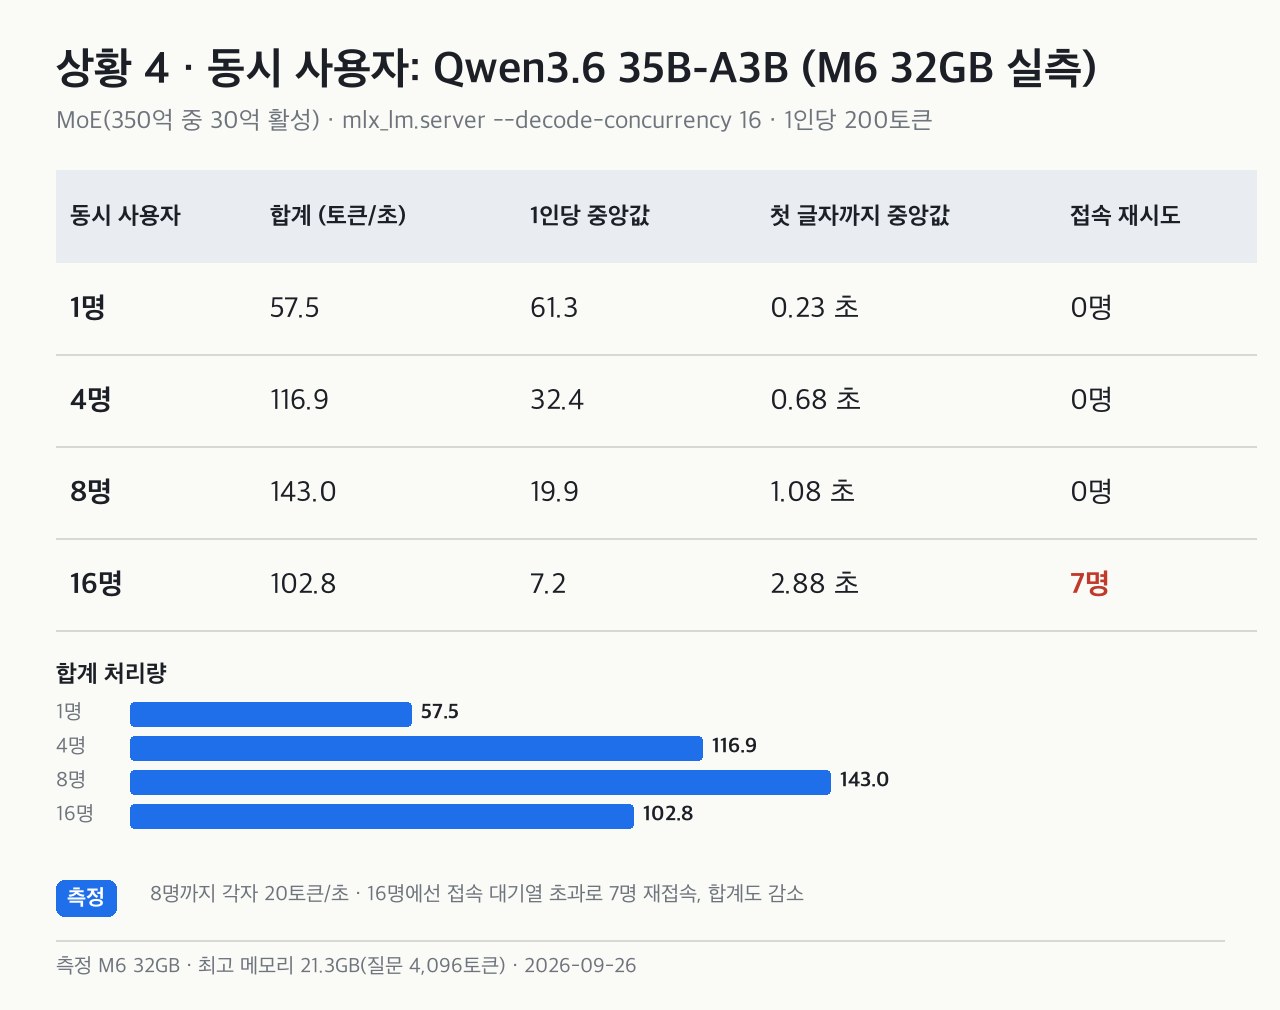
mlx_lm.server(연속 배칭 16)에 1 · 4 · 8 · 16명이 1인당 200토큰씩 동시에 요청했습니다. 칸은 "합계 · 1인 중앙값"(토큰/초, 측정)입니다.
| 동시 사용자 | Qwen3.5 9B | Qwen3.6 35B-A3B |
|---|---|---|
| 1명 | 28.5 · 29.5 | 57.5 · 61.3 |
| 4명 | 99.1 · 27.0 | 116.9 · 32.4 |
| 8명 | 101.5 · 13.7 | 143.0 · 19.9 |
| 16명 | 115.0 · 8.0 | 102.8 · 7.2 |
9B는 4명까지 합계가 거의 4배로 늘다가 8명부터 정체하고, 16명에선 1인 8토큰(6명 재접속)입니다. 35B-A3B는 8명까지 각자 20토큰으로 넉넉했으나 16명에서 접속 대기열이 넘쳐 7명이 재접속했고 합계도 줄었습니다. 공개 서비스라면 요청을 줄 세우는 장치가 필요합니다.
M5 Pro는 대역폭 1.8배만큼 빨라질 것으로 보이지만 재지 않은 추정이고, 24GB는 대화 기억(KV 캐시) 여유가 적습니다. 인증 없이 열린 Ollama 서버가 17만 5천 대 발견됐다는 2026-01 보고(인용)도 있으니 포트를 그대로 열지 마세요.
맥 미니 서버에 큰 AI 모델 올리기 (상황 5)
맥은 메모리 전부를 그래픽에 쓰지 못합니다. M6 32GB의 기본 한도는 26.8GB(약 78%, 실측)입니다. 78%는 32GB를 32GiB(약 34.4GB)로 보고 센 비율이고, 26.8GB는 24.96GiB와 같은 값입니다. M5 Pro 24GB는 비슷한 비율(74~78%)을 적용하면 약 19.1~20.1GB이고 영상에서는 가운데 값인 약 19.5GB로 표시했습니다(추정, 실측 없음).
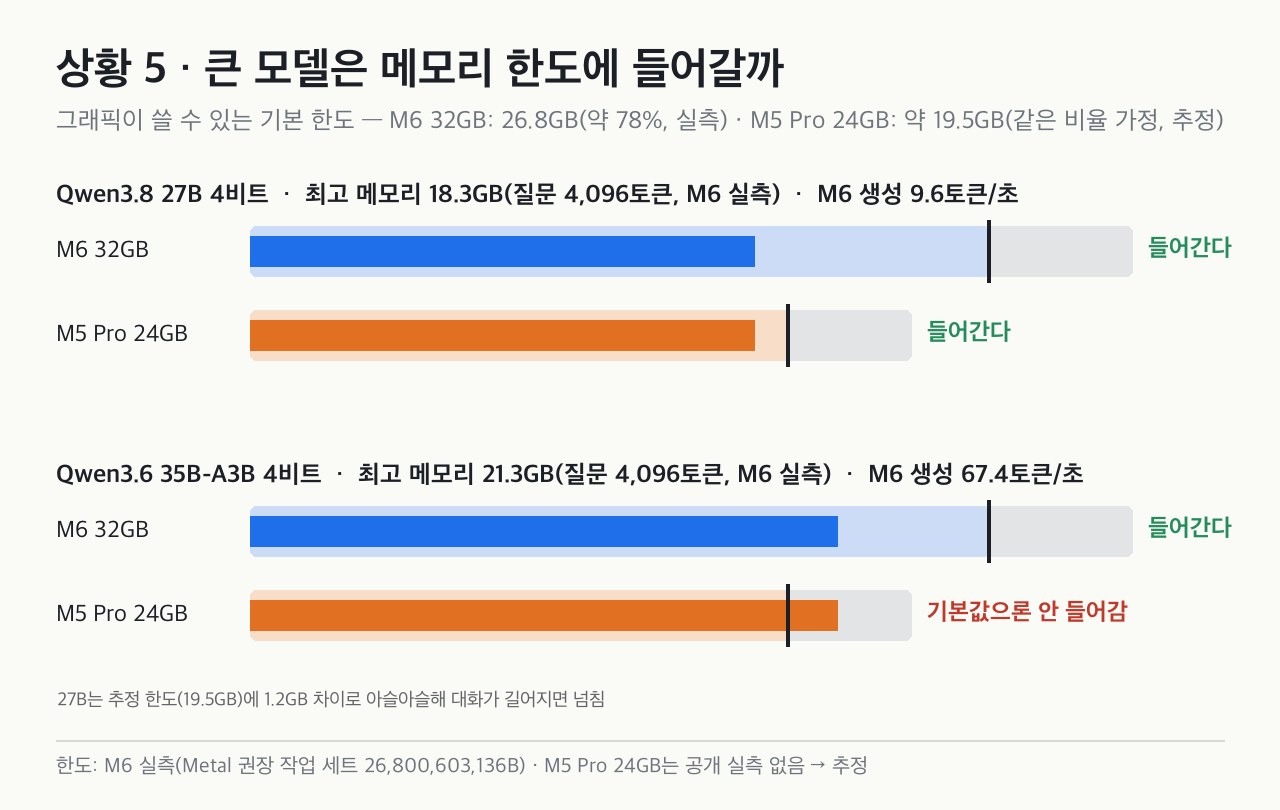
Qwen3.8 27B는 질문 4,096토큰에서 최고 18.3GB, 35B-A3B는 21.3GB였습니다(측정). 35B-A3B는 M5 Pro 24GB 기본 설정에 안 들어가고, 27B는 추정 한도 19.5GB에 1.2GB(19.5−18.3, 계산) 차이로 아슬아슬합니다. 느린 것과 안 올라가는 것은 다릅니다.
맥 미니 서버 판단 순서: 동시 접속 → 메모리 → 전력 → 한계
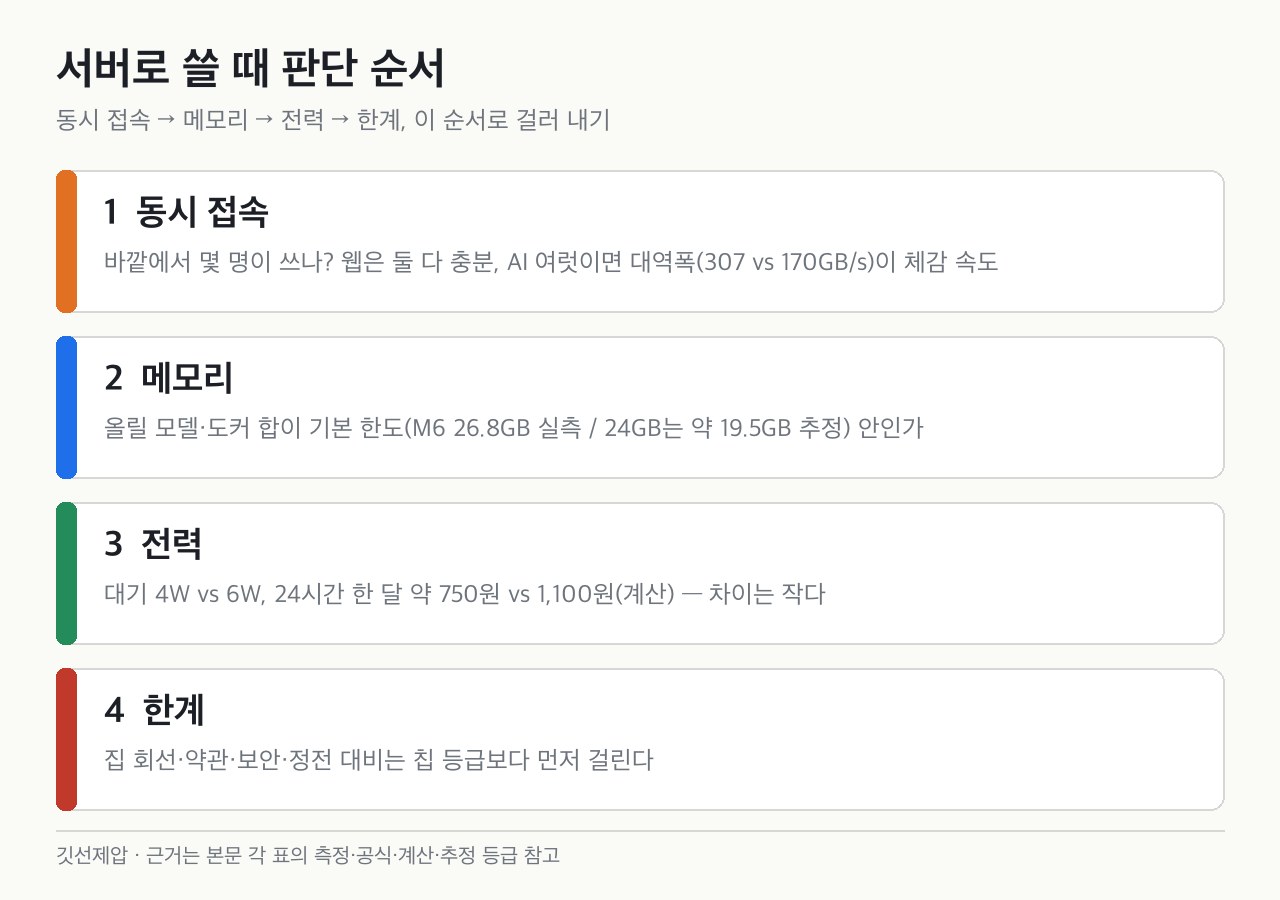
- 동시 접속. 바깥에서 몇 명이 쓰는지 먼저 정합니다. AI를 여럿이 쓰면 대역폭이 체감 속도를 정합니다.
- 메모리. 올릴 모델과 도커의 합이 기본 한도 안인지 봅니다.
- 전력. 차이가 작아 성능이 넘칠 때의 보조 기준입니다.
- 한계. 회선 · 약관 · 보안 · 정전 대비는 칩보다 먼저 걸립니다. 잠자기 끄기, 정전 뒤 자동 켜짐, UPS를 확인하세요(커뮤니티 의견).
측정 조건과 못 잰 것
조건(M6 32GB, macOS 27.0, 2026-09-26). 웹 Caddy 2.11.4 · oha 1.16 · 20초. llama.cpp b11193. AI는 MLX 0.32.2 · mlx-lm 0.31.3, 4비트(gpt-oss는 MXFP4-Q8). 동시 접속은 --decode-concurrency 16.
못 잰 것. M5 Pro 실물(공개 측정 · 추정으로 대체), 전력 실측(공식값 계산), 집 회선 실제 속도, 장시간 발열, Ollama 동시 처리, 답변 품질, 긴 대화 여럿의 메모리.
마무리 요약
| 상황 | 핵심 숫자 | 판정 | 근거 등급 |
|---|---|---|---|
| 1 공개 웹사이트 | 정적 55,813 · 동적 16,599건/초 | M6 32GB | 측정 |
| 2 집 서버 묶음 | 메모리 32 대 24GB, 싱글코어 약 +9% | M6 32GB | 공식 · 계산 |
| 3 혼자 쓰는 작은 AI | 35.2 대 63.9~67.6토큰/초 | 둘 다 충분 | 측정 · 공개 측정 |
| 4 여럿이 쓰는 AI | 16명 1인 8토큰, 307 대 170GB/s | M5 Pro 24GB | 측정 · 추정 |
| 5 큰 AI 모델 | 35B 21.3GB 대 한도 약 19.5GB | M6 32GB | 측정 · 추정 |
대부분의 집 서버에는 값을 아낀 맥 미니 M6 32GB 서버가 맞고, M5 Pro는 48GB 이상에서 진가가 난다는 것이 커뮤니티 결론입니다.
출처 · 기준일. 측정 2026-09-26. 가격은 애플 코리아 공개가(영상 값은 2026-09-26 확인, 2026-10-30 표시가는 본문에 따로 적음). Apple 지원 문서 103253(전력) · llama.cpp GitHub #4167 · SentinelLABS/Censys(2026-01) · KT 이용약관(2025.3) · 레딧 서버 글 387개 집계.
이 글은 AI 음성이 쓰인 영상을 바탕으로 AI 작성 보조를 받아 정리했습니다. 구매를 권유하는 글이 아닙니다.