무료 챗GPT급 로컬 AI, 24GB 한 장이면 될까? 3090·5090·맥 미니 실측
올린 날 영상 공개
24GB 그래픽카드 한 장(RTX 3090, 4비트)이면 무료 챗GPT급 로컬 AI와 같은 줄에 섭니다. 3090·5090·맥 미니 M6를 같은 문제로 직접 재 본 메모리·속도·품질 표와 비교 기준, 한계를 정리했습니다.
결론부터 말하면, 무료 챗GPT급 로컬 AI는 24GB 그래픽카드 한 장(RTX 3090, 4비트)으로 '같은 줄'까지는 갑니다. 다만 성격이 다릅니다. 무료 ChatGPT는 짧고 덜 틀렸고, 로컬 큐웬(Qwen3.8 27B)은 더 자세하지만 가끔 지어냈습니다. 맥 미니 M6 32GB에도 들어가지만 초당 8토큰 안팎입니다. 숫자는 2026년 10월 1~2일에 직접 잰 값이고, 계산·인용은 따로 표시했습니다. 이 글은 YouTube 영상의 측정 내용을 글로 다시 정리한 것입니다.
무료 챗GPT급의 기준과 비교 방법
기준은 ChatGPT 무료 요금제의 모델 GPT-5.6 Luna입니다(공식, 요금제 페이지 무료 칸, 2026-10-02 확인). '생각하기'를 켠 쪽과 끈 쪽을 모두 물었습니다. 로컬은 Qwen3.8 27B 하나를 원본 54.7GB, 8비트 29.05GB, 4비트 17.56GB로 바꿔 올렸습니다.
시험은 직접 만든 160문항(8과제×20)이고, 그중 무작위 40문항(8과제×5)은 무료 ChatGPT에도 똑같이 냈습니다. 다만 무료 ChatGPT는 이미지 첨부가 하루 3장까지라 이미지 과제는 Think를 켠 3문항만 보낼 수 있었습니다. 정답·코드는 자동 채점, 환각은 사람이 두 기준(너그러운 / 엄격), 조언·글쓰기는 모델 이름을 가린 AI 판정 10점입니다.
공개 지표(인용)는 엇갈립니다. Artificial Analysis는 최대 추론 설정에서 Luna 34.56, Qwen 33.70(중간 설정이면 27.55), Arena 한국어는 1413 대 1397로 오차 범위가 겹칩니다. benchlm은 66.2 대 55.4로 차이가 크다고 봅니다.
한계: 과제마다 5문항이라 표본이 작고 조언·글쓰기는 AI 판정입니다. 무료 ChatGPT는 약 20문항 뒤 모델 이름이 작은 모델로 바뀌어 그 답(켬 3 · 끔 4)은 뺐습니다.
3기기 측정표
| 기기 | 모델 · 양자화 | 메모리 | 생성 속도 | 품질(160문) |
|---|---|---|---|---|
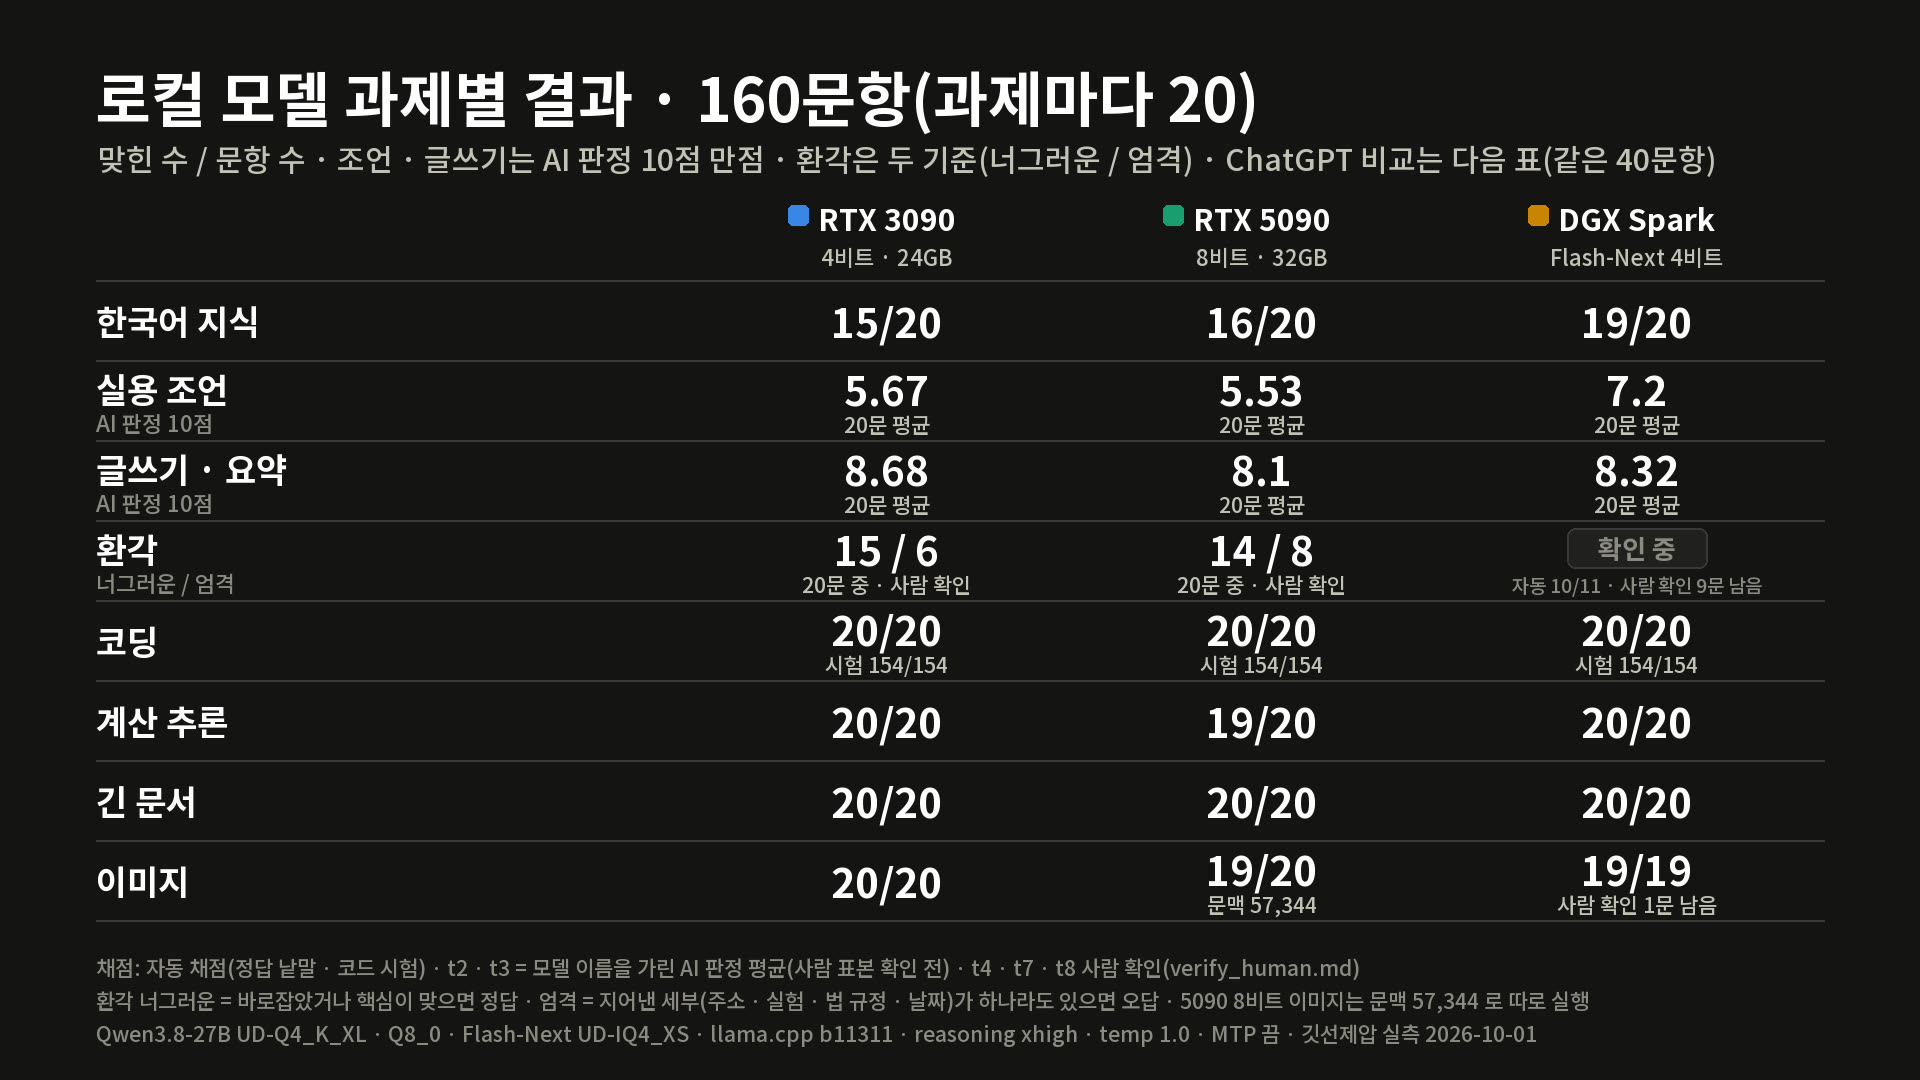
| RTX 3090 24GB | 4비트 | 최대 21,838MiB (문맥 65,536) | 36.3 토큰/초 | 한국 사실 15/20 · 코딩 20/20 · 조언 5.67 |
| RTX 5090 32GB | 8비트 | 31,891MiB (문맥 65,536, 여유 716MiB) | 52.7 토큰/초 | 한국 사실 16/20 · 코딩 20/20 · 조언 5.53 |
| 맥 미니 M6 32GB | 4비트 llama.cpp | 22.36GiB (문맥 32,768) | 8.17 토큰/초 | 시험 안 함 |
| 맥 미니 M6 32GB | MLX 4bit | 최대 20.14GB (문맥 32,768) | 9.21 토큰/초 | 시험 안 함 |
| 참고 DGX Spark 128GB | Flash-Next 4비트 | 67,067MiB (문맥 131,072) | 28.6 토큰/초 | 한국 사실 19/20 |
모두 직접 측정입니다. 속도는 혼자 쓸 때 문맥 깊이 0의 값(3090 280W, 5090 575W 제한)이고 추측 디코딩(MTP)은 껐습니다. 메모리는 괄호 속 문맥 조건이며 재는 방식이 기기마다 달라 곧바로 비교하면 안 됩니다. 조언은 AI 판정 10점입니다.
기기별 해석
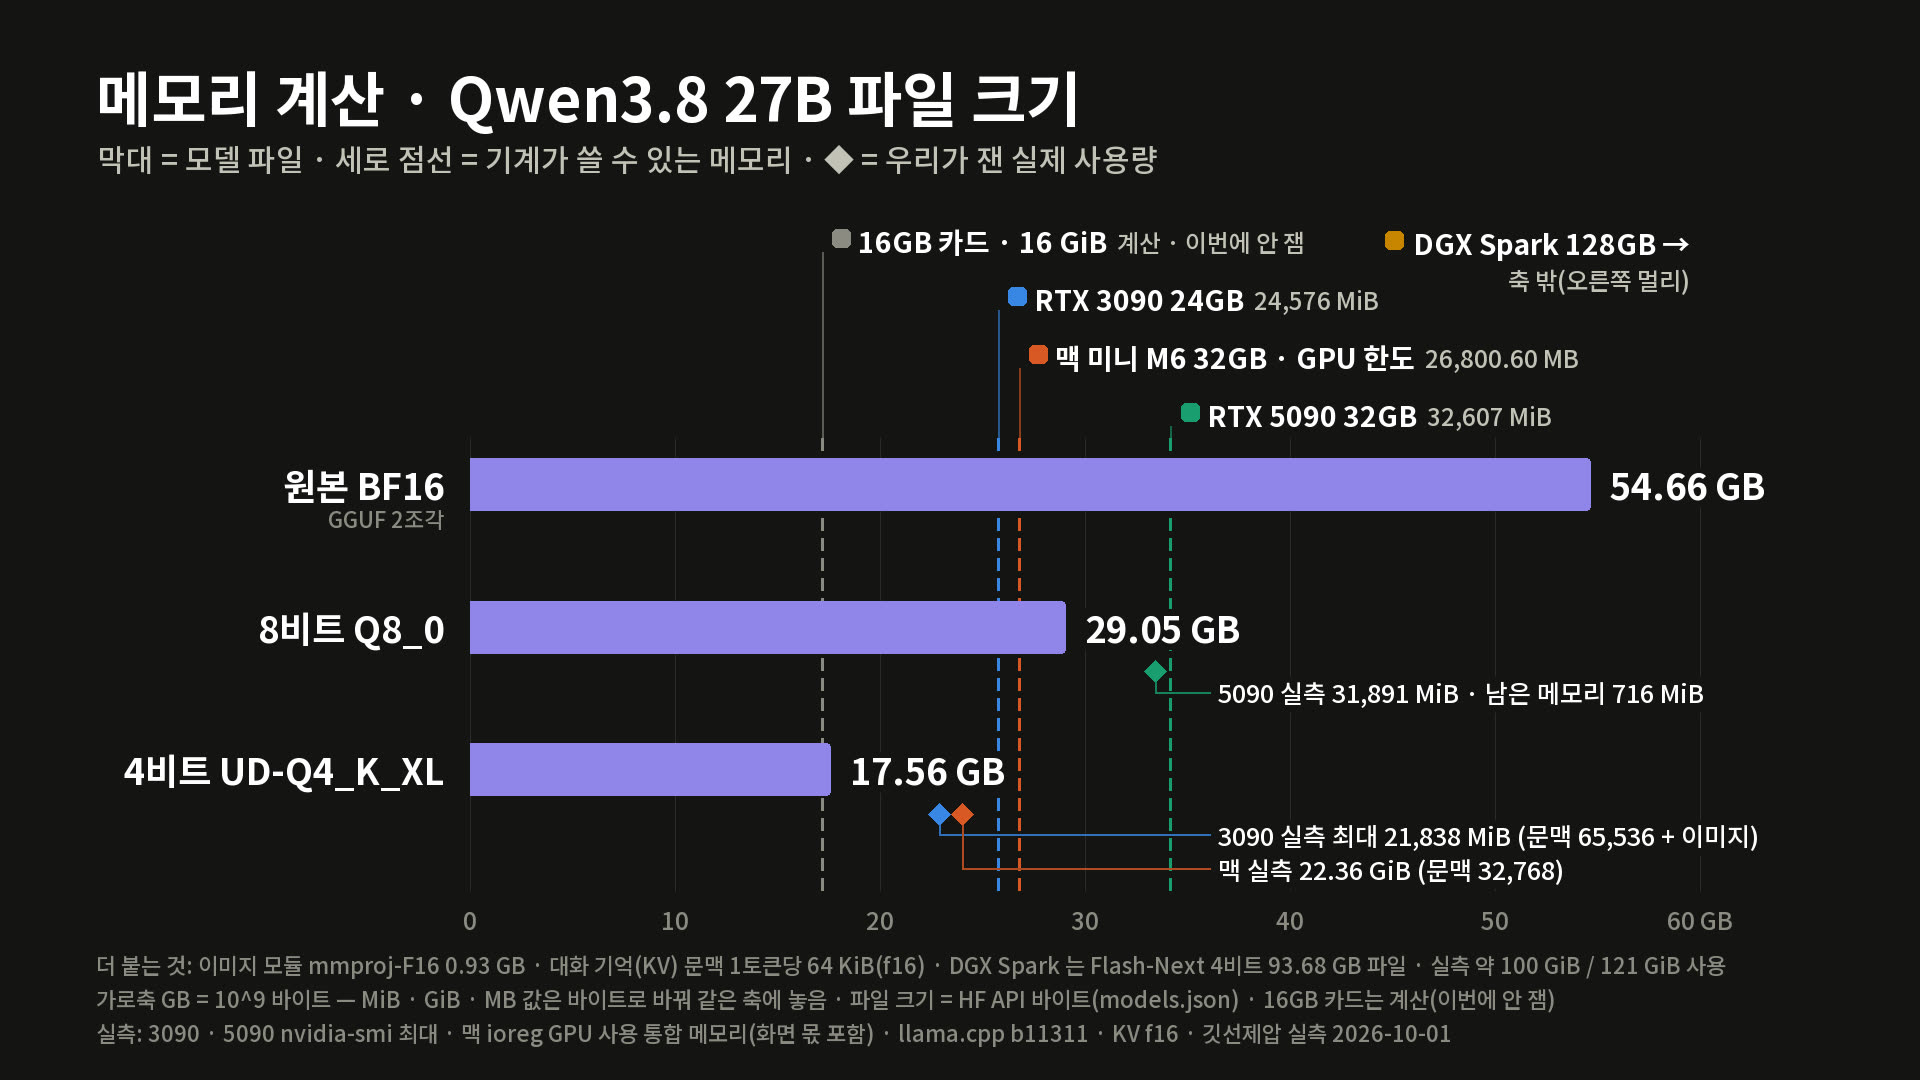
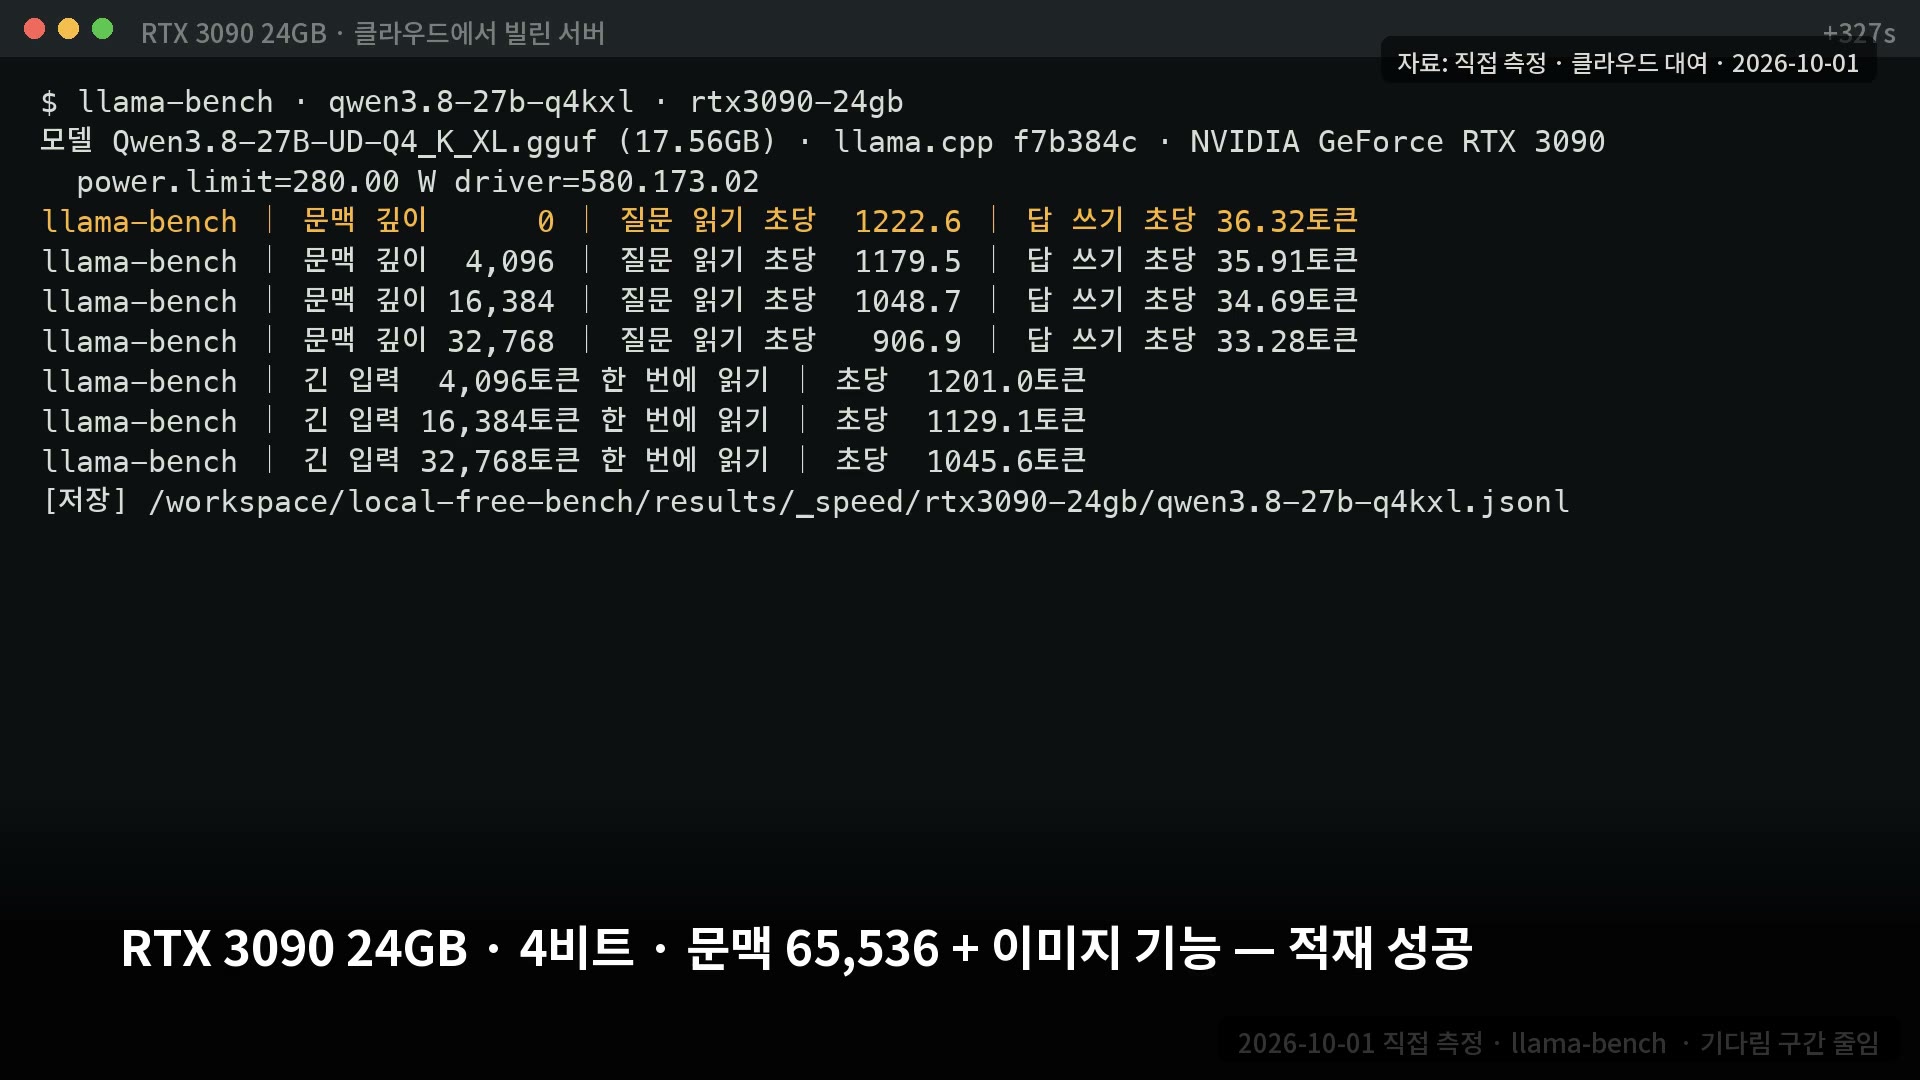
RTX 3090 24GB. 4비트 17.56GB가 문맥 65,536과 이미지 기능까지 켠 채 들어갔고, 160문항을 끝까지 풀었습니다. 메모리는 최대 약 89%였고 문맥 초과나 서버 재시작은 없었습니다. 코딩은 20문항을 모두 풀었고, 문항마다 숨은 시험이 있어 합계 154개도 전부 통과했습니다(표의 20/20은 문항 수, 154는 시험 수).
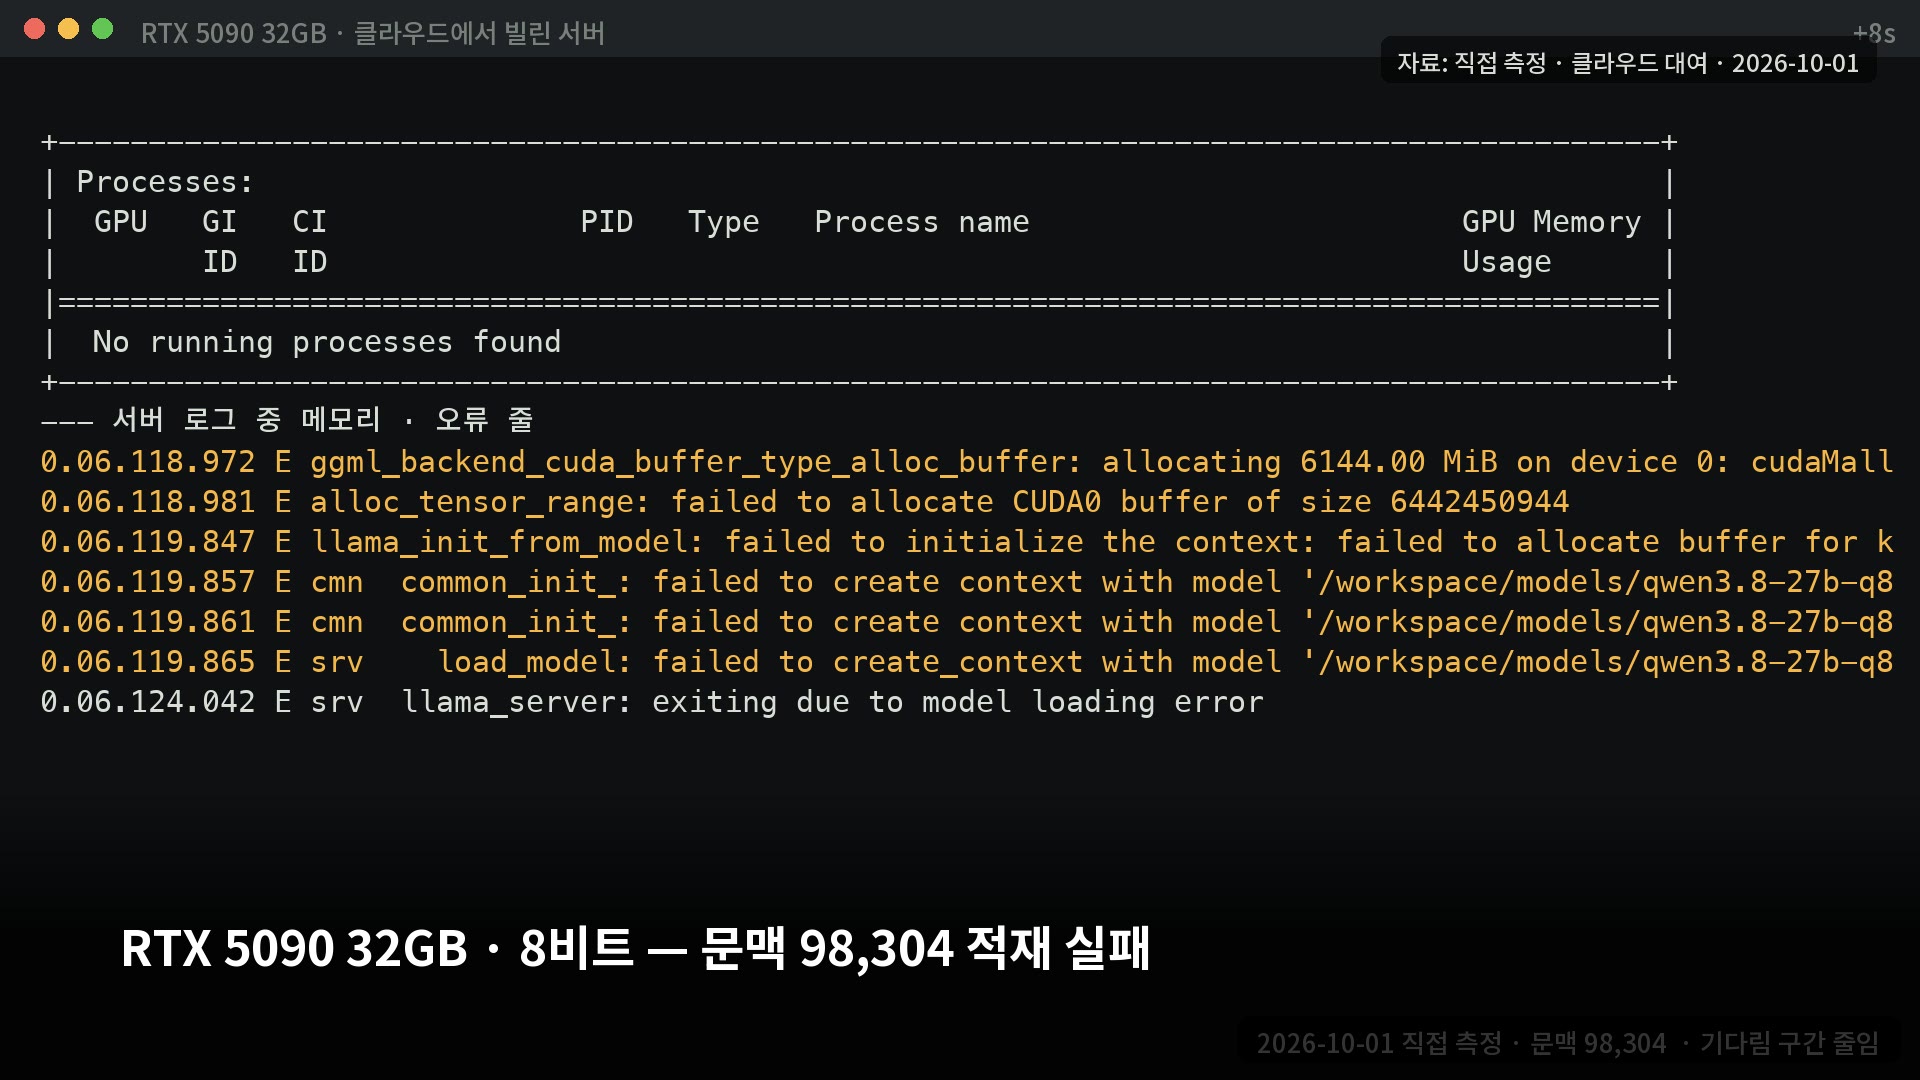
RTX 5090 32GB. 8비트는 겨우 들어갑니다. 텍스트 55문항을 풀다가 이미지 문제가 들어온 순간 서버가 꺼졌고, 문맥을 57,344로 줄이자 이미지 20문항이 정상으로 돌았습니다. 이미지 기능 없이 문맥 98,304는 적재 자체가 실패했습니다. 속도만 잰 4비트는 77.0 토큰/초로 8비트보다 약 46% 빨랐습니다(계산).
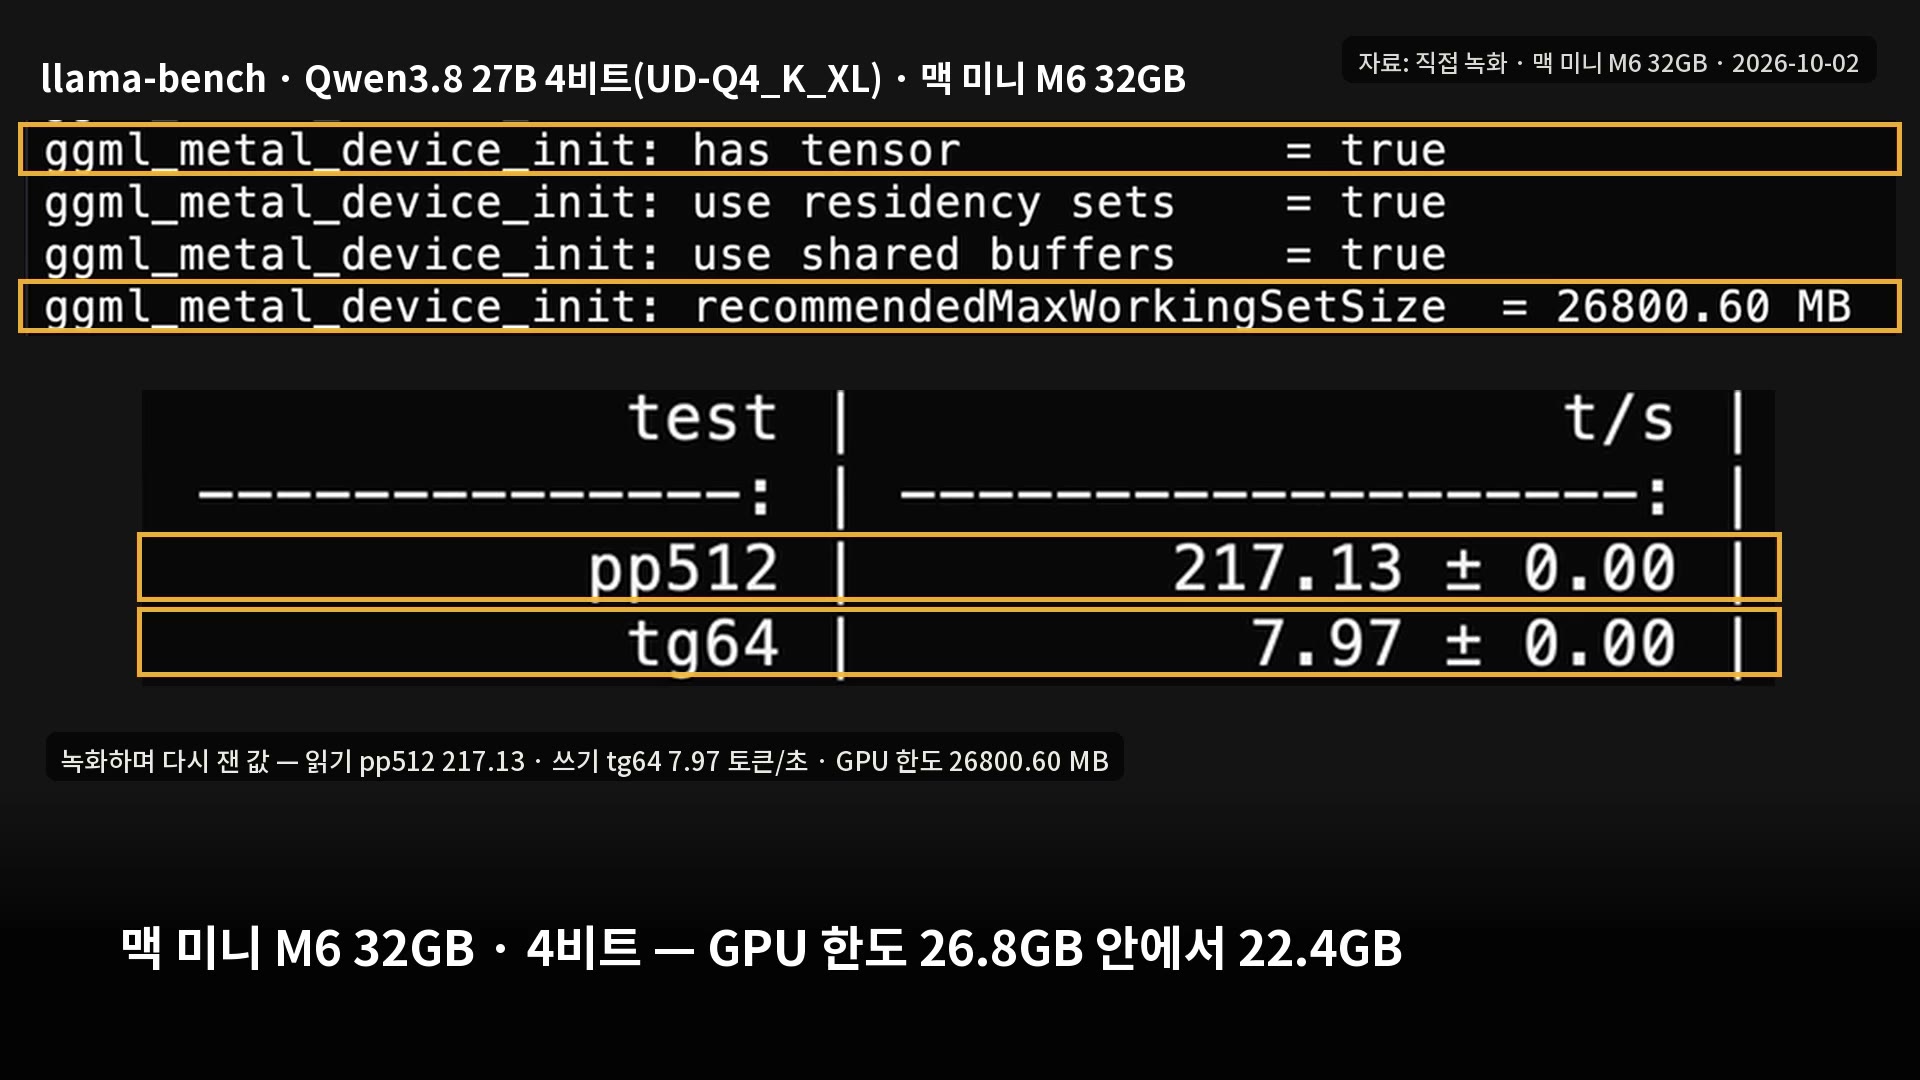
맥 미니 M6 32GB. 4비트가 GPU 한도 26.8GB 안에 들어갔습니다. 생성은 3090의 22% 수준이고, 모델을 띄운 동안 스왑이 9GB까지 늘었습니다. 3090 실행 기준 한 문항 평균 2,479토큰이라, 맥에서는 한 문항에 5분쯤 걸리는 셈입니다(계산).
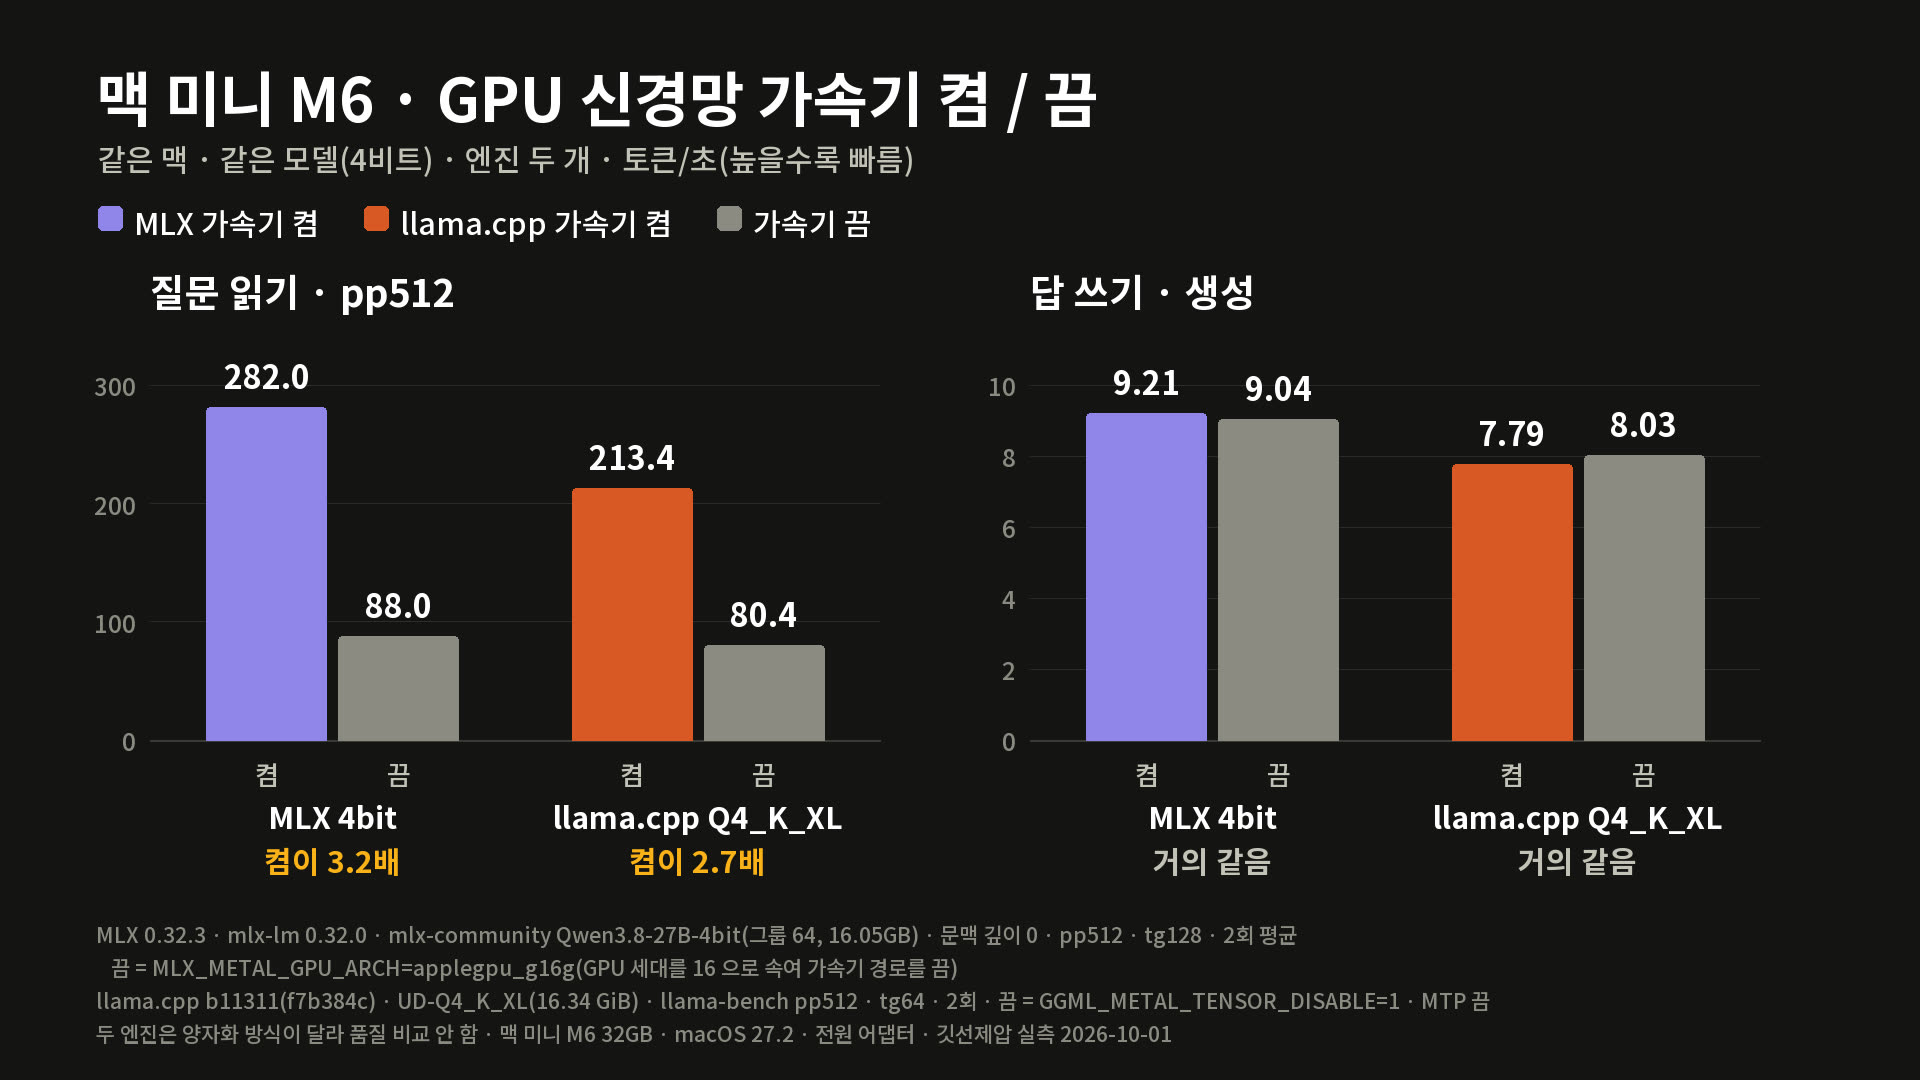
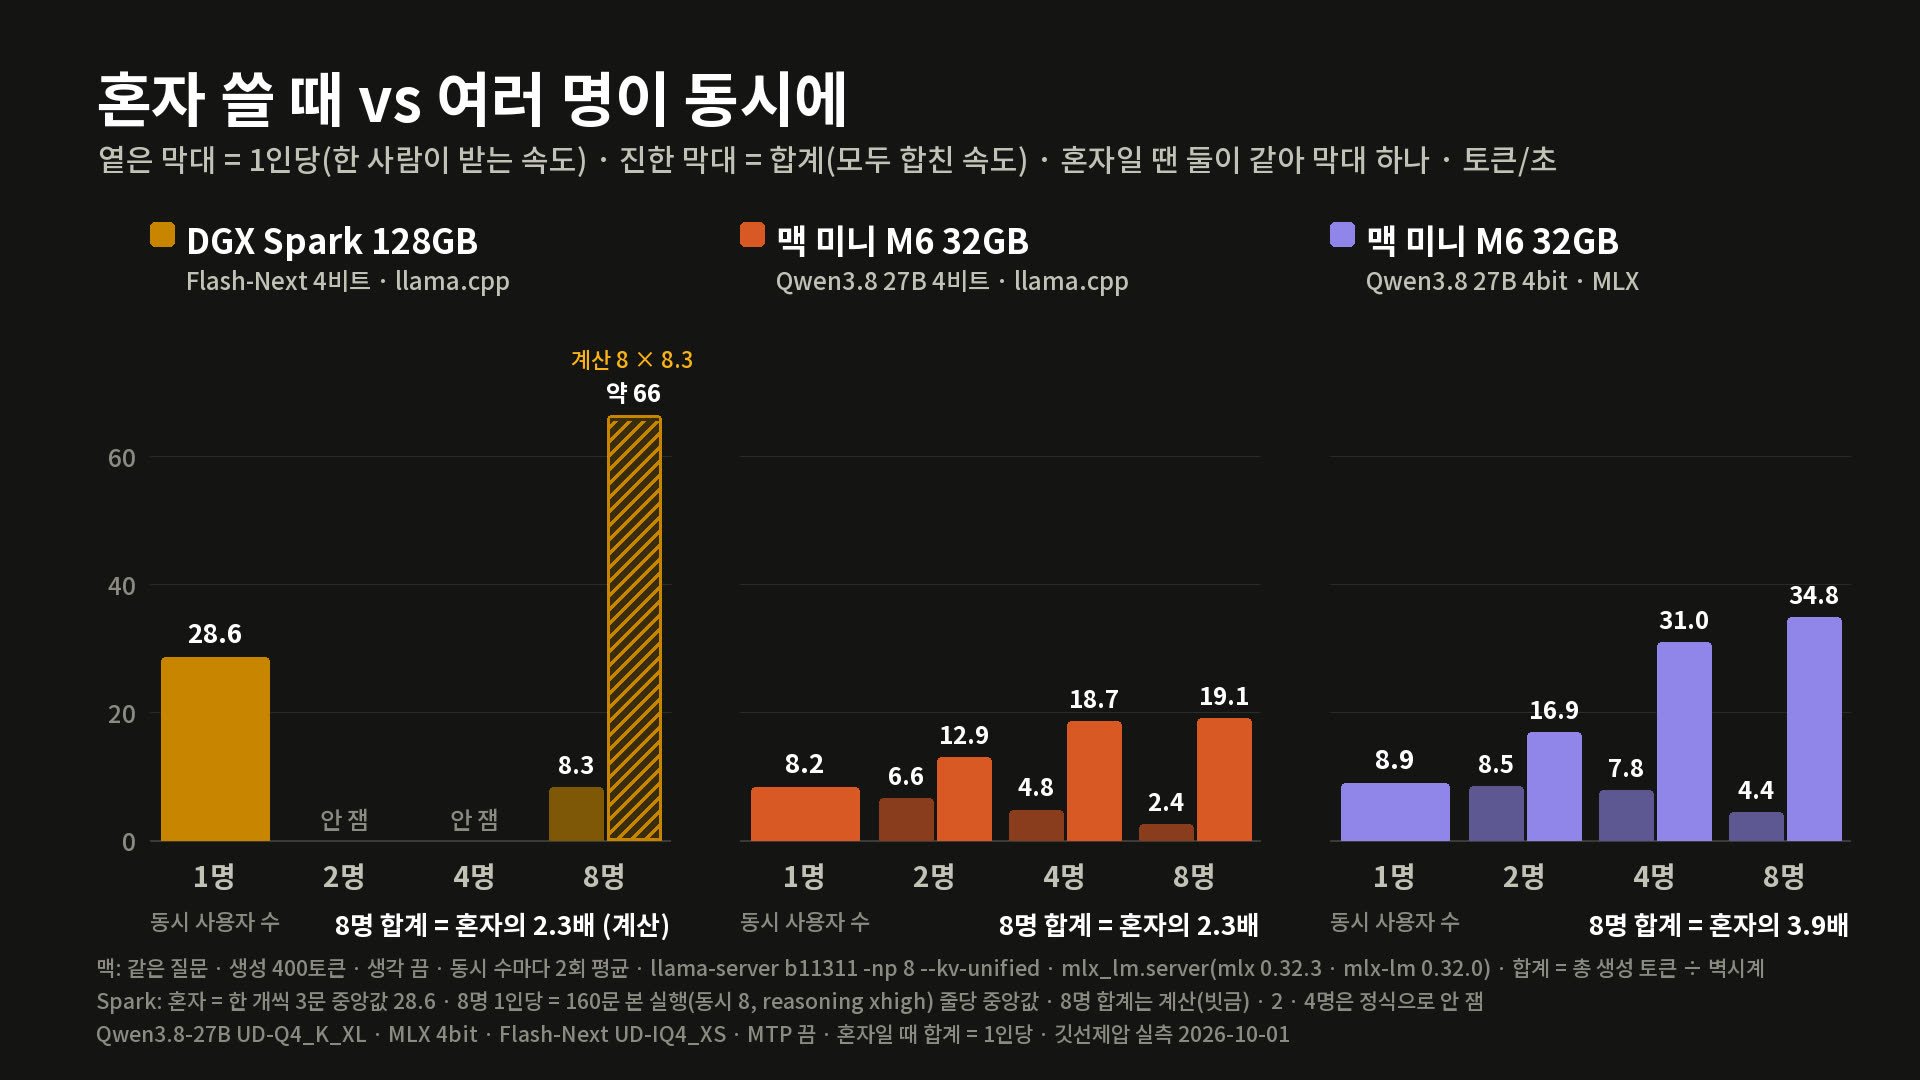
M6의 GPU 신경망 가속기를 끄면 질문 읽기만 느려집니다. MLX는 282 대 88토큰/초(약 3.2배), 답 쓰기는 9.21 대 9.04로 같았습니다. 8명이 동시에 쓰면 합계는 llama.cpp 19.1, MLX 34.8 토큰/초입니다.
같은 40문제 비교
8과제 중 이미지 과제는 ChatGPT가 3문항뿐이라 맨 아래 한 줄로 따로 두었습니다. 조언 점수는 위 3기기 표(3090 5.67, 5090 5.53)와 아래 표(7.6, 6.0)가 다릅니다. 위 표는 160문항 중 조언 20문항 평균이고, 아래 표는 같은 조언 5문항만 ChatGPT 답과 함께 모델 이름을 가려 다시 판정한 값이라 문항과 판정 회차가 달라 서로 견줄 수 없습니다.
| 과제 (5문항) | ChatGPT 켬 | ChatGPT 끔 | 3090 4비트 | 5090 8비트 |
|---|---|---|---|---|
| 한국 사실 | 5/5 | 5/5 | 4/5 | 4/5 |
| 조언 (10점) | 6.6 | 6.3 | 7.6 | 6.0 |
| 글쓰기 (10점) | 6.7 | 6.5 | 8.4 | 7.9 |
| 환각 (너그러운/엄격) | 5/5 | 5/5 | 3/1 | 3/2 |
| 코딩 (문항 수) | 5/5 | 5/5 | 5/5 | 5/5 |
| 계산 추론 | 5/5 | 4/5 | 5/5 | 4/5 |
| 긴 문서 | 4/5 | 5/5 | 5/5 | 5/5 |
| 이미지 | 3/3 (3문만) | 안 보냄(한도) | 5/5 | 5/5 (문맥 57,344) |
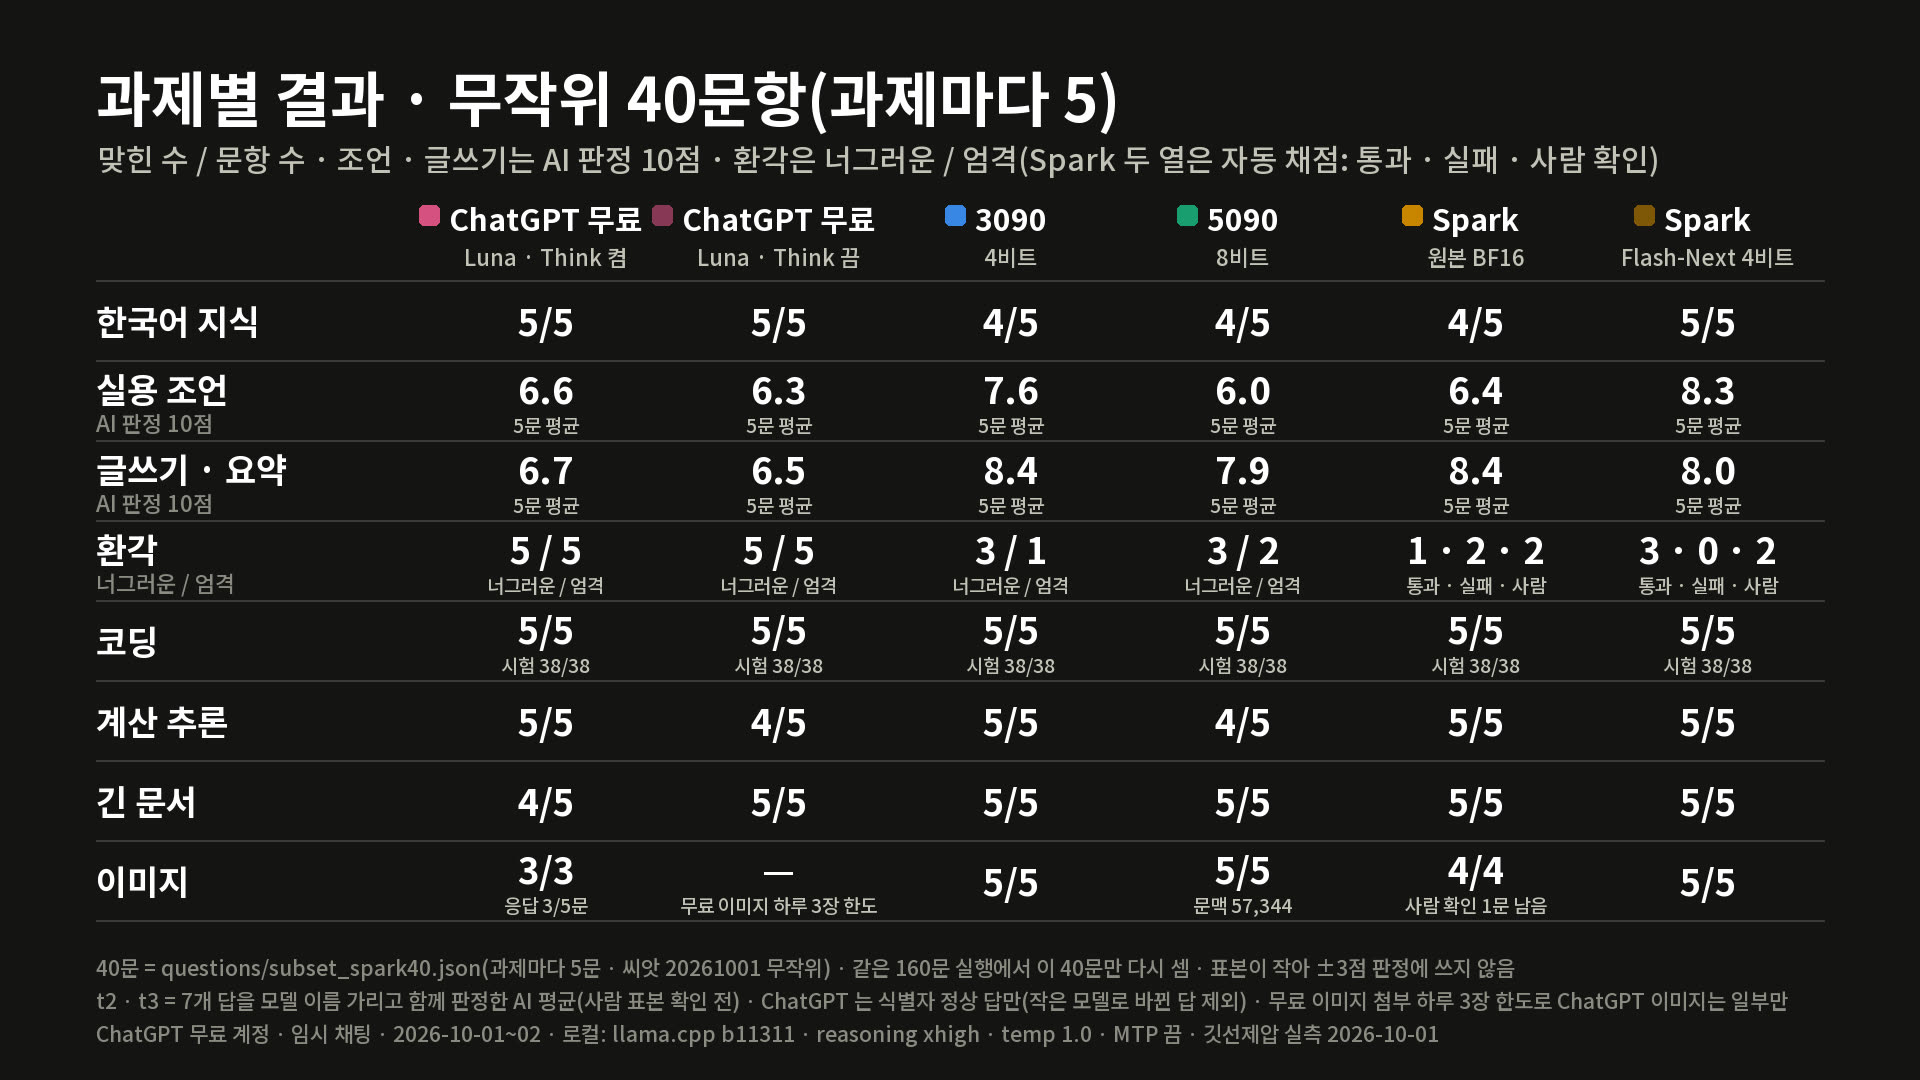
로컬이 지는 곳은 세 가지입니다. 한국 사실(5천 원권 인물의 정답은 이이인데 4비트는 없는 이름으로, 8비트는 신사임당으로 답함), 지어낸 세부, 기다리는 시간입니다. 3090의 조언 한 문항은 중앙값 280초, 무료 ChatGPT는 중앙값 4초(최대 31초)였습니다. 다만 ChatGPT는 필요하면 인터넷을 검색해 출처를 붙였고 로컬은 인터넷 없이 답했습니다.
이기는 곳은 조언·글쓰기의 AI 판정 점수(자세하게 씀)와, 사용 한도 없이 내 기계 안에서 끝난다는 점입니다.
무료 챗GPT급 로컬 AI 선택지와 한계
- 24GB 이상 그래픽카드: 4비트가 들어갑니다. 한국 사실·법·번호는 따로 확인하세요.
- 32GB 맥: 들어가지만 초당 8토큰대라 혼자 짧게 쓰는 용도까지입니다.
- 16GB 이하: 4비트 17.56GB에 대화 기억 공간이 더 붙어 어렵습니다(계산, 미측정).
- 128GB급: 더 큰 Flash-Next 4비트가 올라갑니다(DGX Spark 클라우드 대여 측정).
무료 챗GPT급 로컬 AI는 '성격이 다르다'는 전제에서만 같은 줄입니다. 속도와 정확도 중 무엇을 양보할지가 기준입니다.
출처 · 기준일 · 한계
- 측정: 2026-10-01~02, 그래픽카드·DGX Spark는 클라우드 대여, 맥 미니는 자체 보유 기기. llama.cpp 11311, MLX 0.32.3, reasoning xhigh
- 공식: ChatGPT 요금제 페이지. 인용: Artificial Analysis v4.3.2 · Arena 한국어 · benchlm. 계산: 비율·소요 시간·메모리 필요량
- 영상 공개일(2026-10-02) 기준이며 모델·요금제·한도는 이후 바뀔 수 있습니다.
이 글은 AI 음성이 쓰인 영상을 바탕으로 AI 작성 보조를 받아 정리했습니다. 구매를 권유하는 글이 아닙니다.