맥 미니 M6 32GB 큐웬 3.8 27B 4비트 실측: JSON 49.7토큰, 한국어 8.8토큰
올린 날 영상 공개
맥 미니 M6 32GB에서 Qwen3.8 27B 4비트 파일 3종과 MTP·DFlash2를 쟀습니다. 가장 빠른 조합이 JSON 49.7토큰이지만 한국어는 8.8토큰. 가장 빠른 파일은 품질 손실도 최대(기준 UD-Q6_K).
맥 미니 M6 32GB에서 Qwen3.8 27B 4비트의 가장 빠른 조합(byteshape 13.1GB 파일 + DFlash2 초안)은 JSON 변환에서 초당 49.7토큰까지 나왔지만, 같은 조합의 한국어 글쓰기는 8.8토큰이었습니다. 아무것도 켜지 않은 기본 상태가 8.5토큰이니 한국어는 거의 빨라지지 않았습니다. 50토큰 근처는 JSON이나 코드처럼 다음 말이 뻔한 출력의 최상 사례였고, 가장 빠른 파일은 품질 손실도 가장 컸습니다.
모든 값은 2026-10-11 맥 미니 한 대에서 llama.cpp b11552(Metal)로 쟀고 서버는 빌리지 않았습니다. 이 글은 7분 43초 영상(공개 2026-10-11)을 글로 다시 정리한 것입니다.
무엇을 쟀나
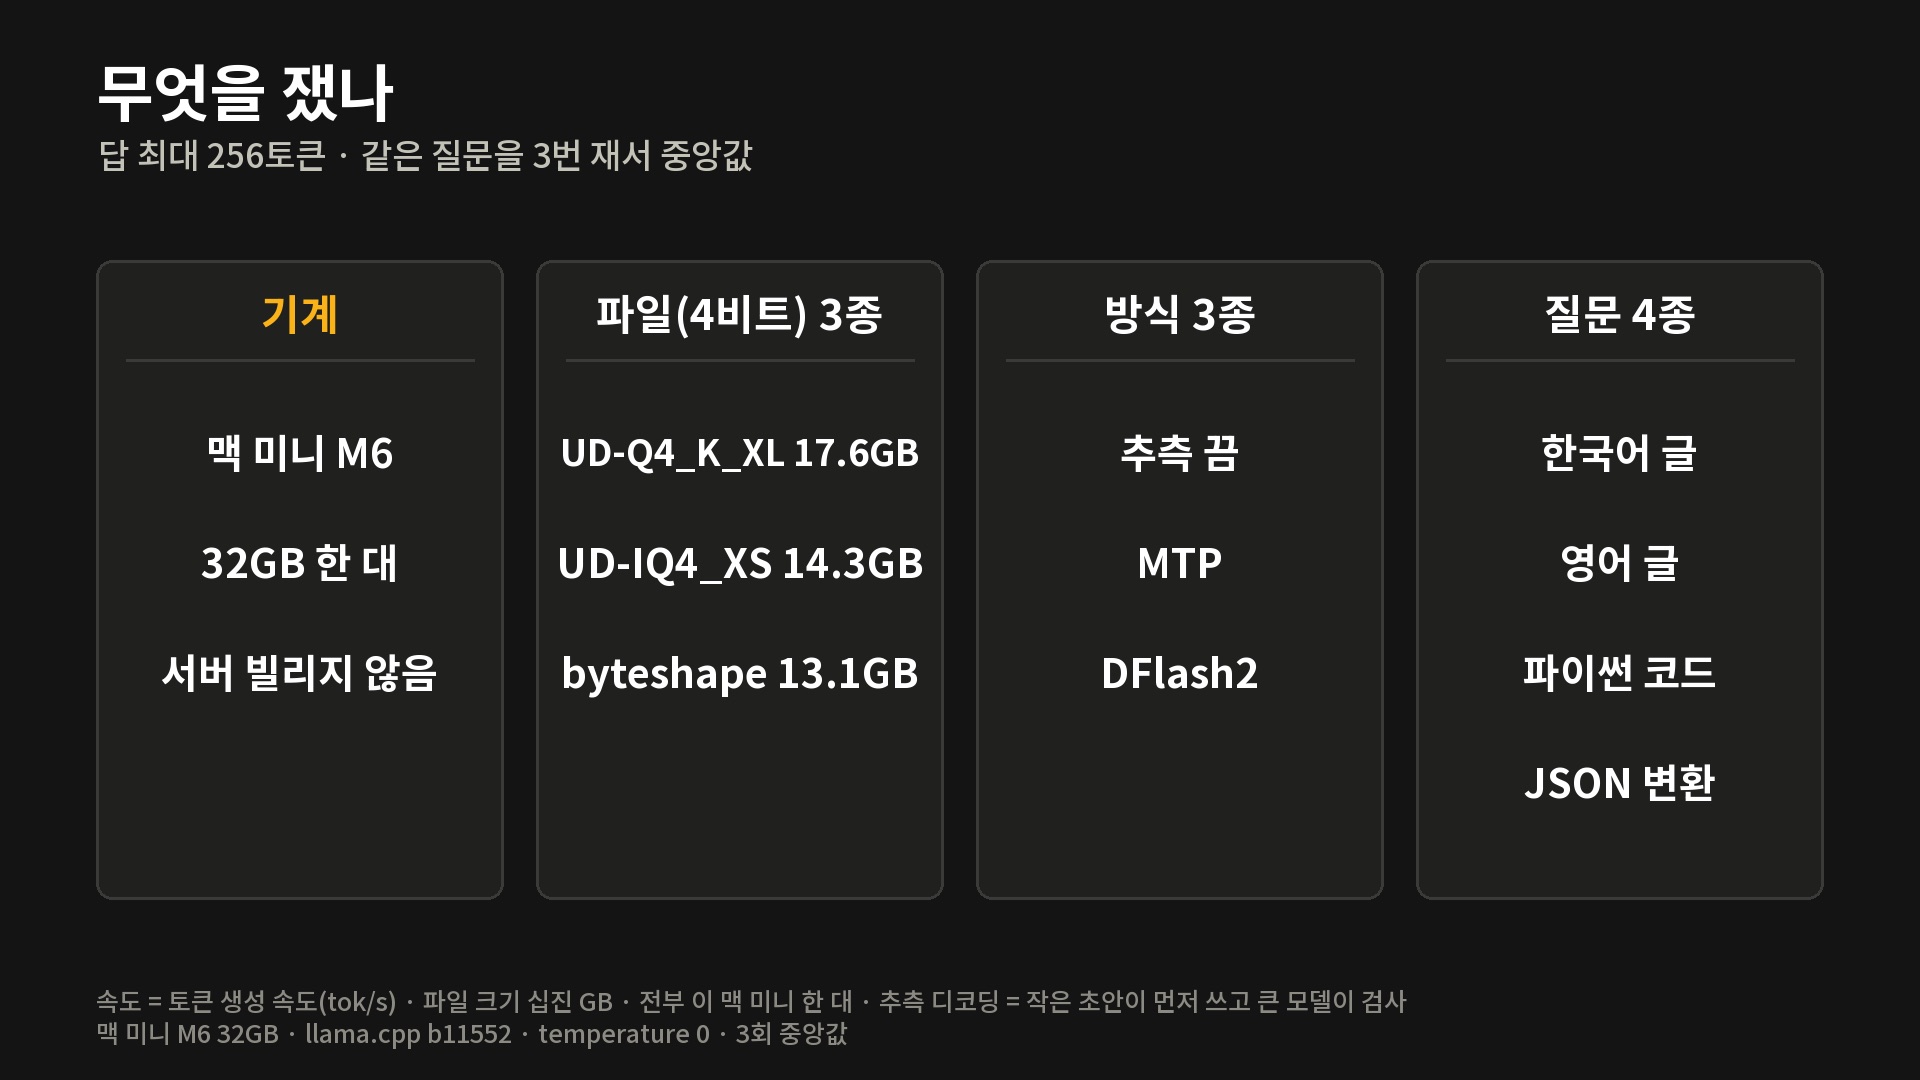
4비트 파일은 UD-Q4_K_XL 17.6GB, UD-IQ4_XS 14.3GB, byteshape 13.1GB입니다. 추측 디코딩은 작은 초안이 토큰 여러 개를 먼저 쓰고 큰 모델이 한꺼번에 검사해 맞은 만큼 건너뛰는 방식이고, MTP(모델 안의 예측 부분)와 DFlash2(1.1GB 초안 모델, 7토큰)를 비교했습니다. 질문은 한국어 · 영어 · 파이썬 코드 · JSON 4종, 답은 최대 256토큰, 온도 0, 3회 중앙값입니다. 표의 속도는 소수 첫째 자리로 반올림한 값이고, 글 속 배수와 비율은 반올림 전 측정값으로 계산했습니다. 그래서 표 값으로 다시 나누면 끝자리가 다를 수 있습니다(예: 표 값 10.8÷8.5=1.27, 반올림 전 10.834÷8.483=1.28).
파일이 작을수록 빠르다
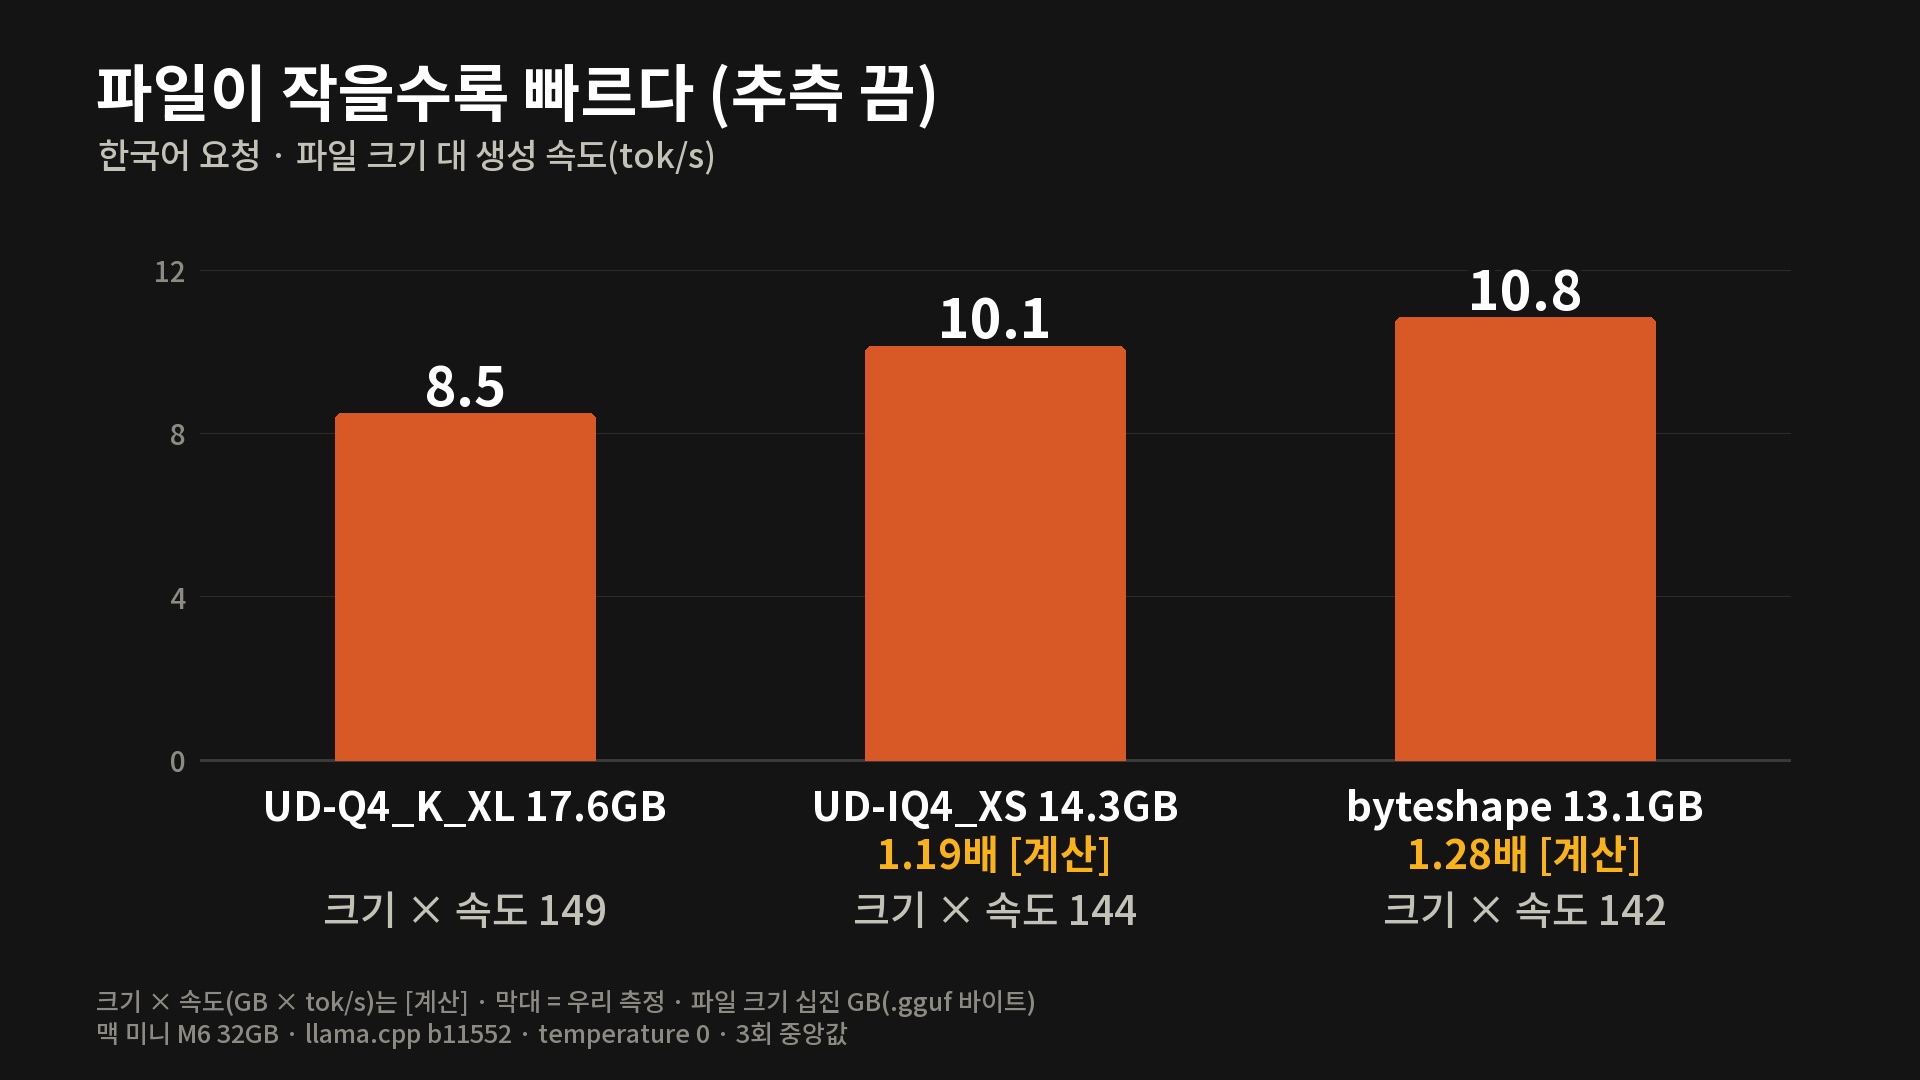
추측을 끄고 한국어를 시키면 17.6GB 파일 8.5, 14.3GB 파일 10.1, 13.1GB 파일 10.8토큰입니다. 크기와 속도의 곱이 대략 일정해서(대역폭이 한계) 파일을 줄이는 것만으로 1.19배, 1.28배(계산)가 됩니다.
초안이 맞아야 빨라진다
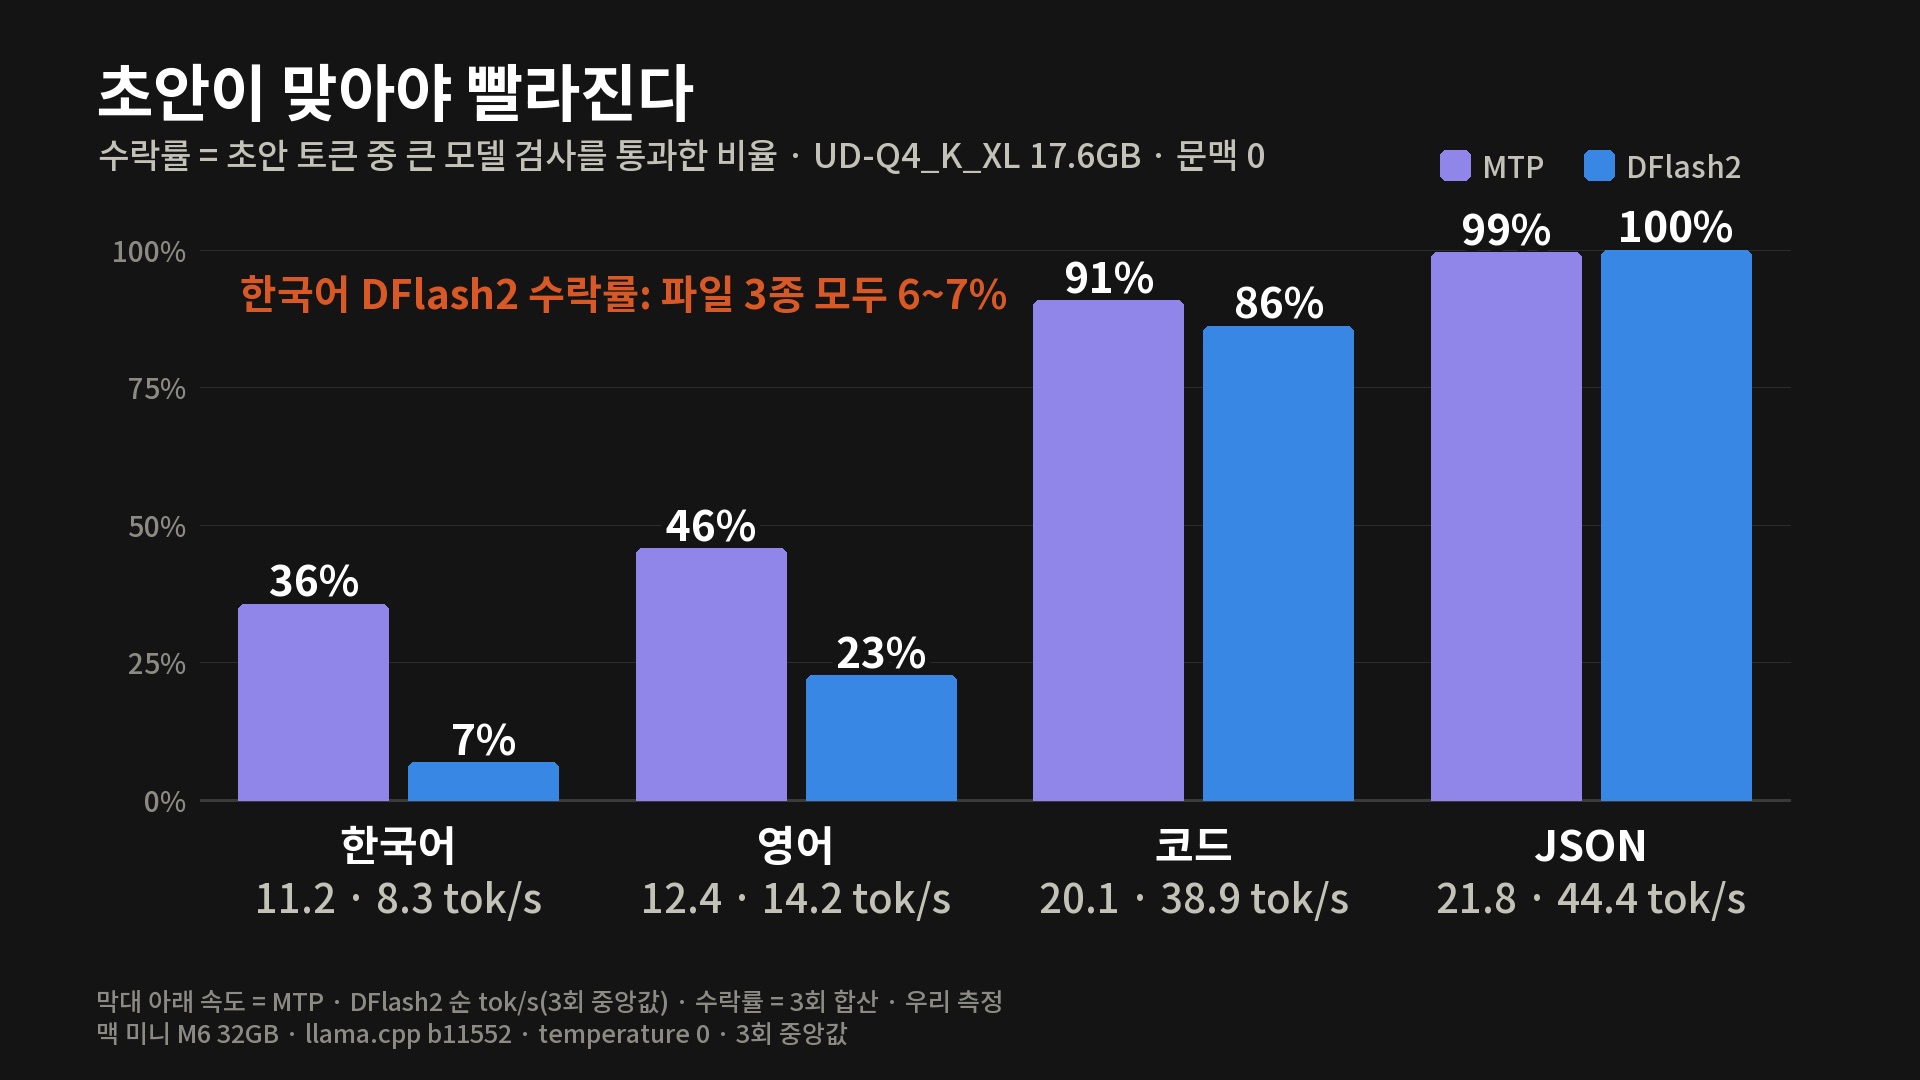
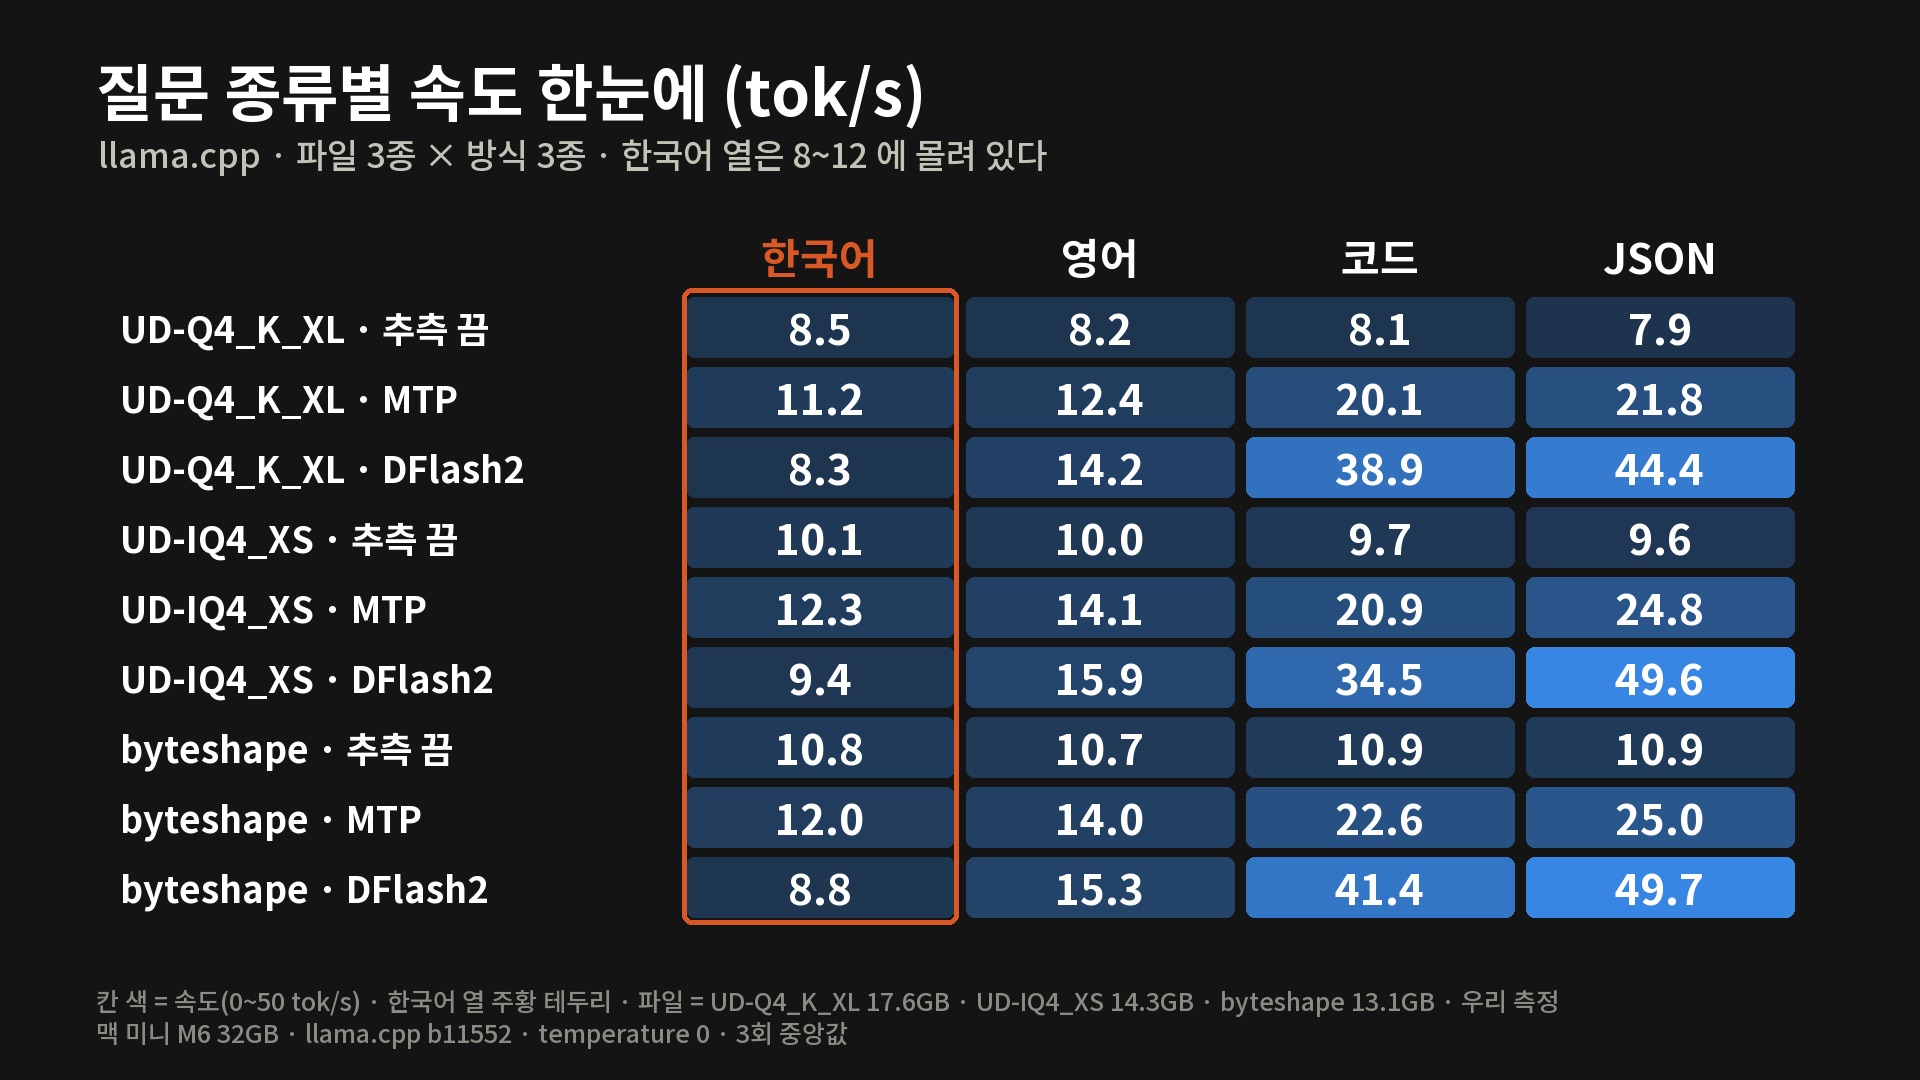
UD-Q4_K_XL에 MTP를 켜면 한국어 11.2 · 코드 20.1 · JSON 21.8토큰, DFlash2를 켜면 한국어 8.3 · 코드 38.9 · JSON 44.4토큰입니다. 초안 수락률이 속도를 정합니다. JSON은 MTP 99%, DFlash2 100%지만 한국어는 MTP 36%, DFlash2 7%였습니다.
가장 빠른 조합의 반전
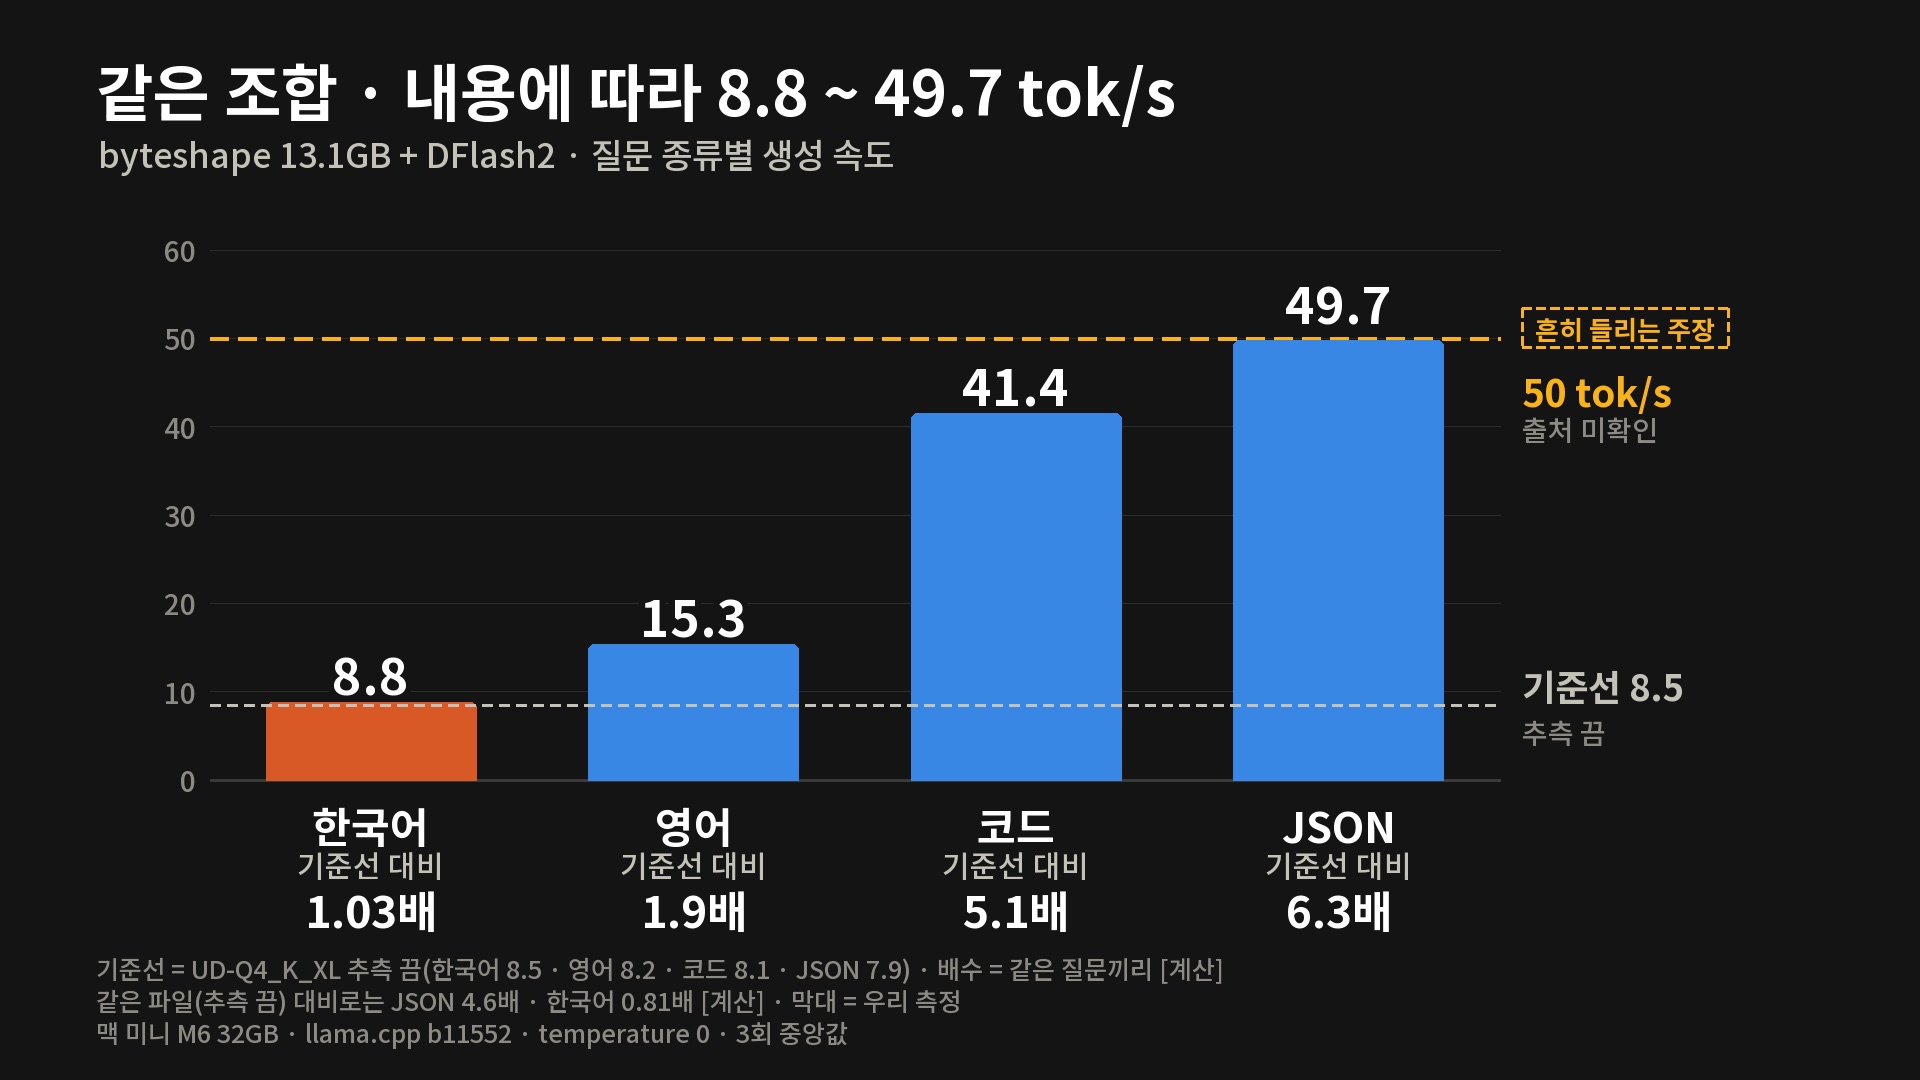
byteshape에 DFlash2를 합치면 JSON 49.7 · 코드 41.4 · 영어 15.3 · 한국어 8.8토큰입니다. 기준선(UD-Q4_K_XL, 추측 끔) 대비 JSON 6.3배 · 코드 5.1배 · 한국어 1.03배(계산)인데, 파일이 작아진 효과가 섞여 있어 같은 파일끼리는 JSON 4.6배입니다(byteshape 추측 끔 JSON 10.9토큰, 49.7÷10.9, 계산). 같은 파일에서 추측을 끄면 한국어가 10.8이었으니 켜서 오히려 느려졌습니다.
질문 종류별 속도 (토큰/초, 측정)
| 구성 | 한국어 | 영어 | 코드 | JSON |
|---|---|---|---|---|
| UD-Q4_K_XL 추측 끔 (기준선) | 8.5 | 8.2 | 8.1 | 7.9 |
| UD-Q4_K_XL + MTP | 11.2 | 12.4 | 20.1 | 21.8 |
| UD-Q4_K_XL + DFlash2 | 8.3 | 14.2 | 38.9 | 44.4 |
| UD-IQ4_XS + MTP | 12.3 | 14.1 | 20.9 | 24.8 |
| byteshape + DFlash2 | 8.8 | 15.3 | 41.4 | 49.7 |
JSON · 코드 열은 8에서 50까지 벌어지는데 한국어 열은 8~12에 몰렸습니다. 한국어에서 가장 빠른 llama.cpp 구성은 UD-IQ4_XS + MTP의 12.3토큰입니다. JSON은 쉬운 변환이라 실사용 평균은 더 낮습니다.
다른 실행기와 긴 문맥
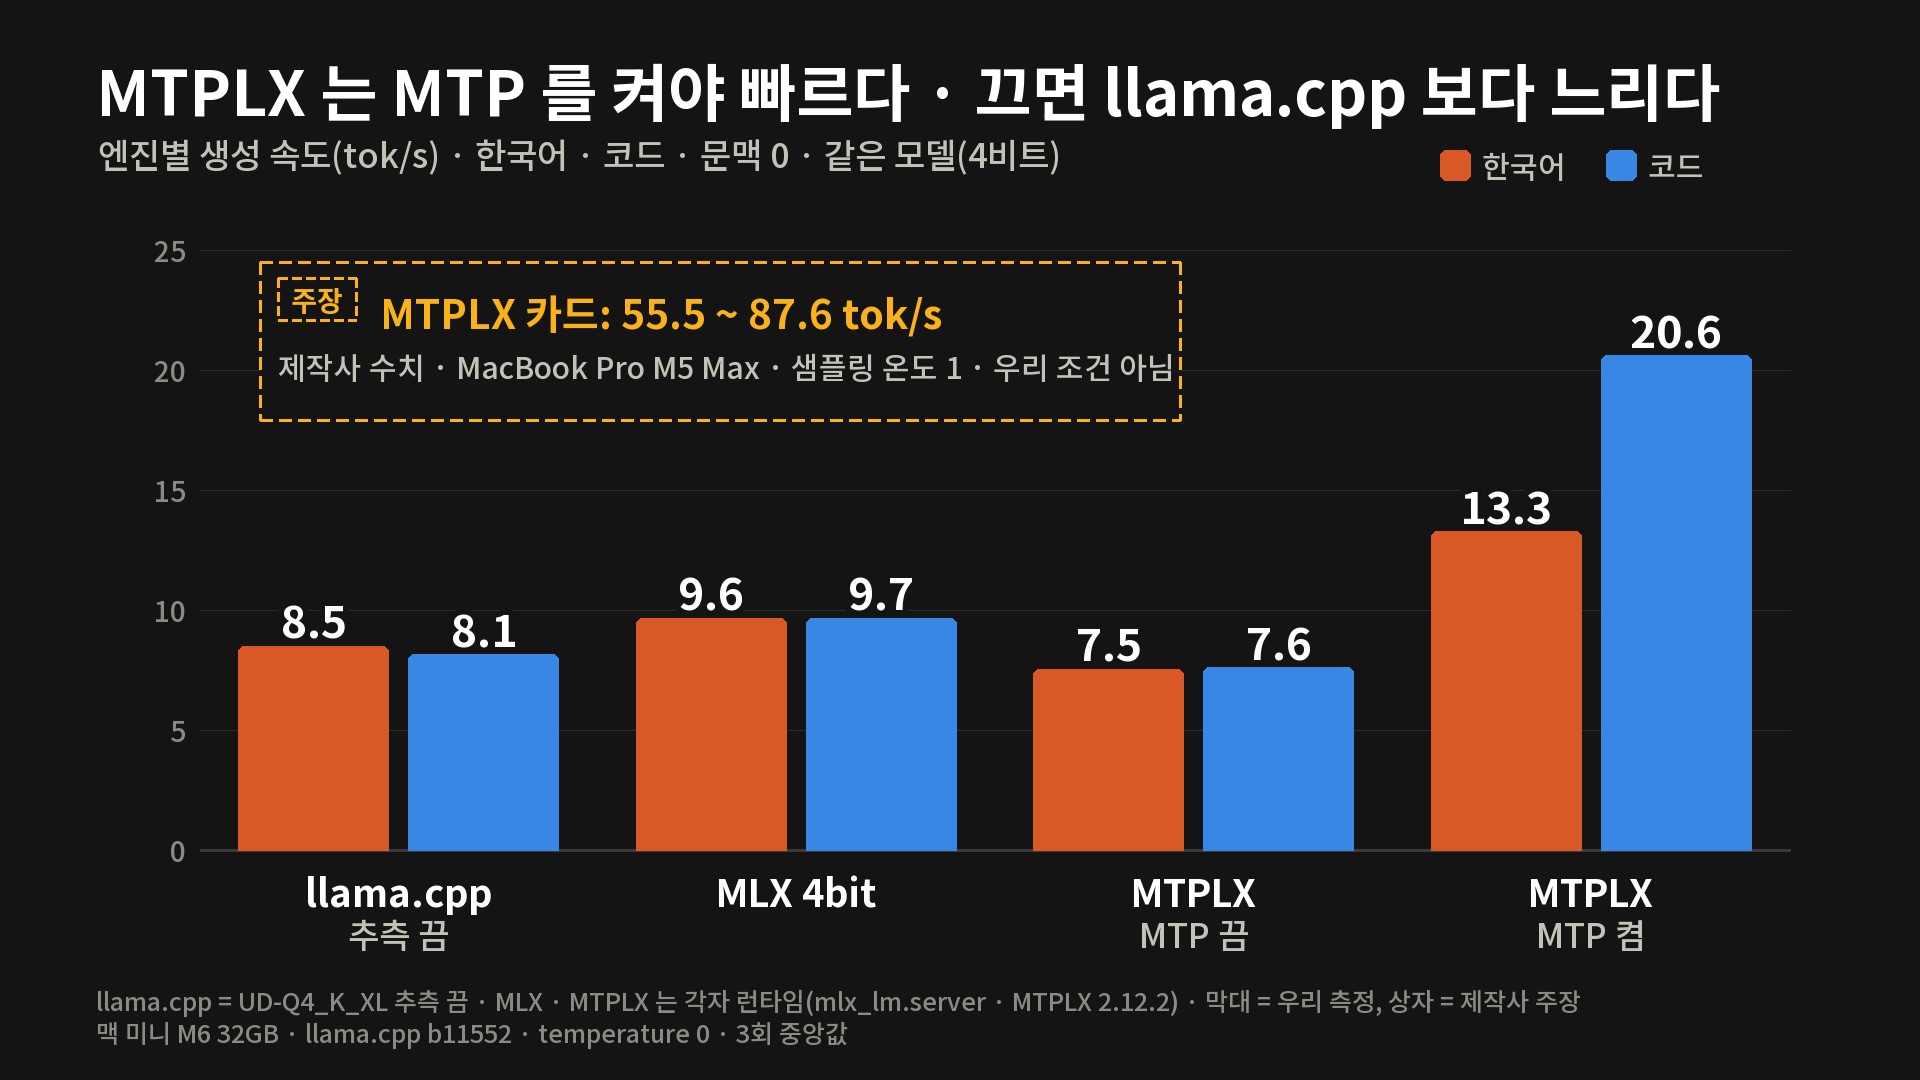
MLX 4비트는 한국어 9.6토큰입니다. MTPLX 팩은 MTP를 끄면 7.5로 llama.cpp보다 느리고, 켜면 한국어 13.3 · 코드 20.6토큰입니다. 문맥 4천 토큰에서는 기본 설정이 메모리 부족으로 요청을 막았습니다. MTPLX 카드의 초당 55.5~87.6토큰은 M5 Max 기준 제작사 수치라 같은 조건이 아닙니다.
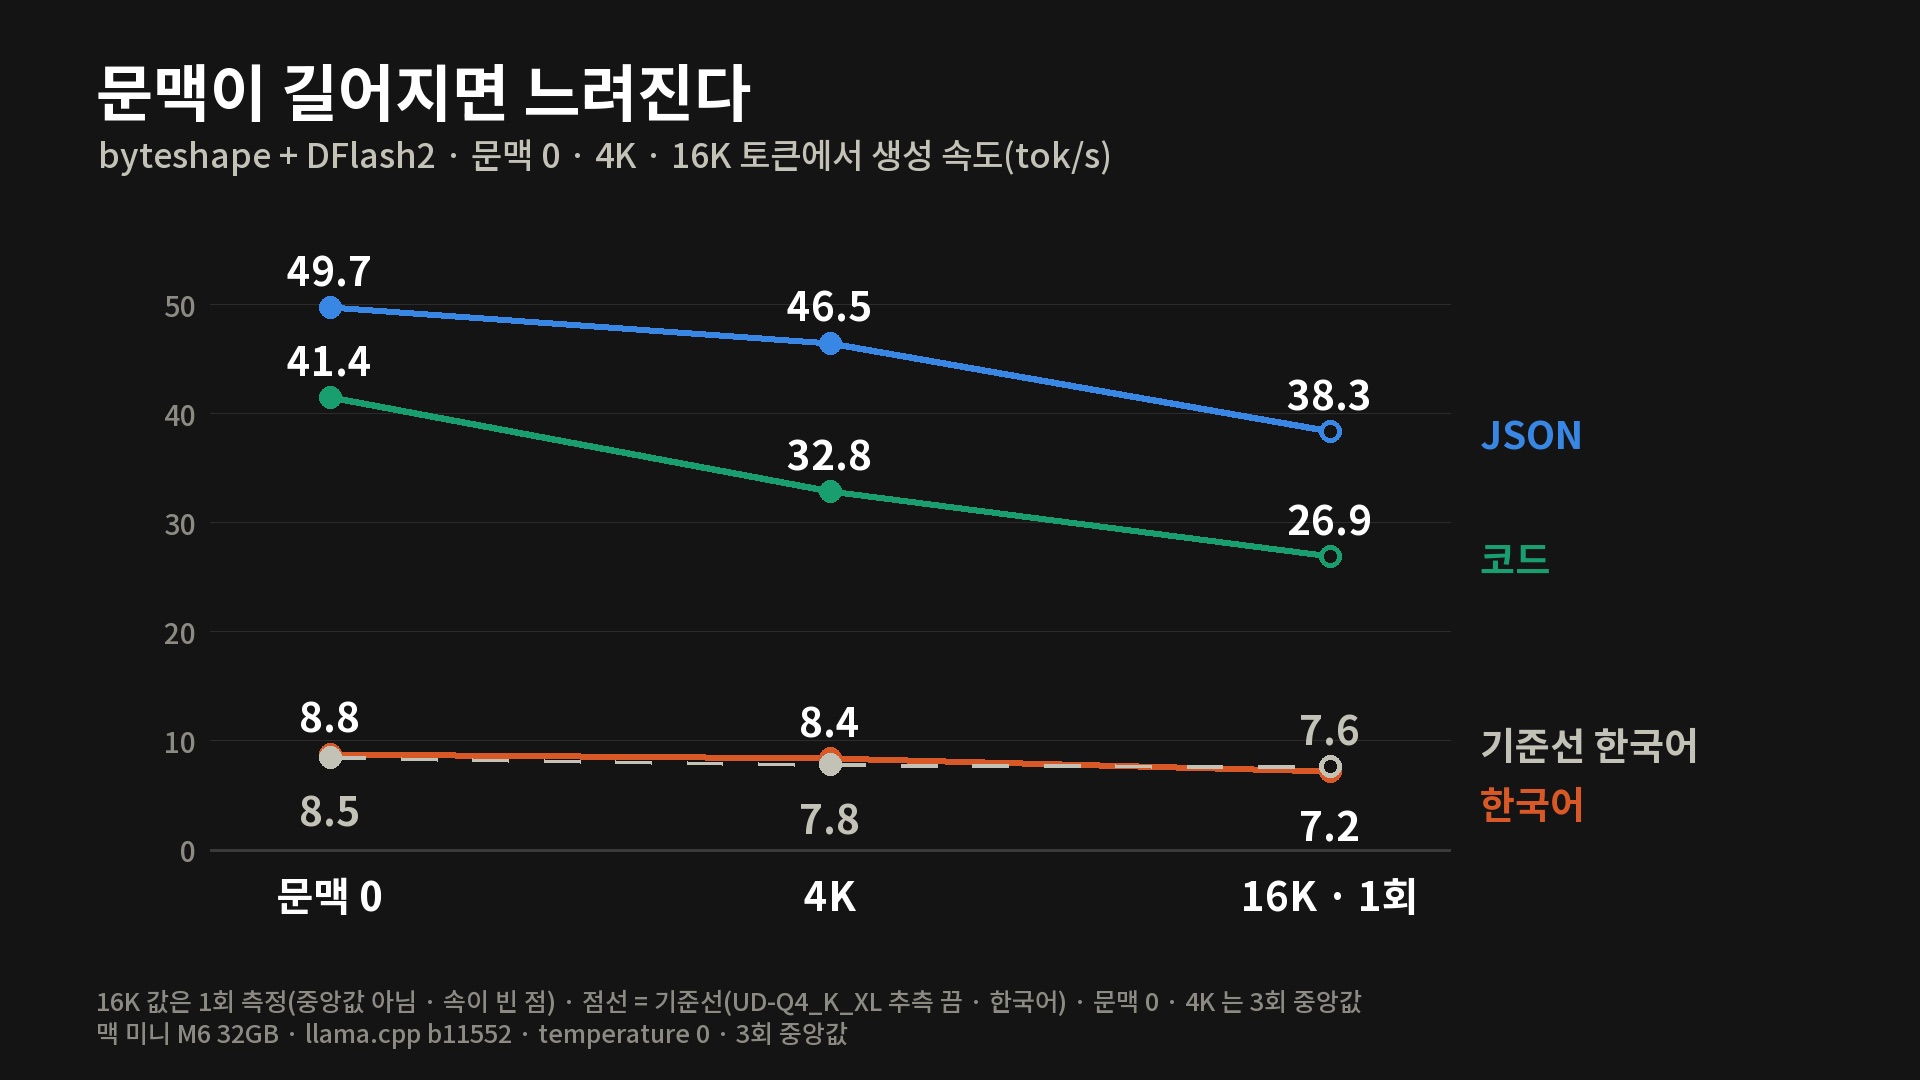
문맥이 길어지면 byteshape + DFlash2의 JSON은 문맥 0에서 49.7, 4천에서 46.5, 1만 6천에서 38.3토큰입니다(1만 6천은 1회 측정). 한국어는 8.8, 8.4, 7.2로 1만 6천 토큰의 기준선 7.6보다 낮아졌습니다.
품질: 가장 빠른 파일이 손실도 가장 크다
각 파일이 22GB 6비트 파일(UD-Q6_K)과 다음 낱말을 얼마나 다르게 예측하는지(KL, 낮을수록 기준에 가깝다) 쟀습니다. 기준은 BF16 원본이 아니고 BF16은 받지도 돌리지도 않았습니다.
| 파일 | 한국어 KL | 한국어 일치율 | 영문 KL | 영문 일치율 |
|---|---|---|---|---|
| UD-Q4_K_XL 17.6GB | 0.0068 | 96.4% | 0.0236 | 95.0% |
| UD-IQ4_XS 14.3GB | 0.0226 | 92.9% | 0.0621 | 91.6% |
| byteshape 13.1GB | 0.0507 | 89.3% | 0.1146 | 88.4% |
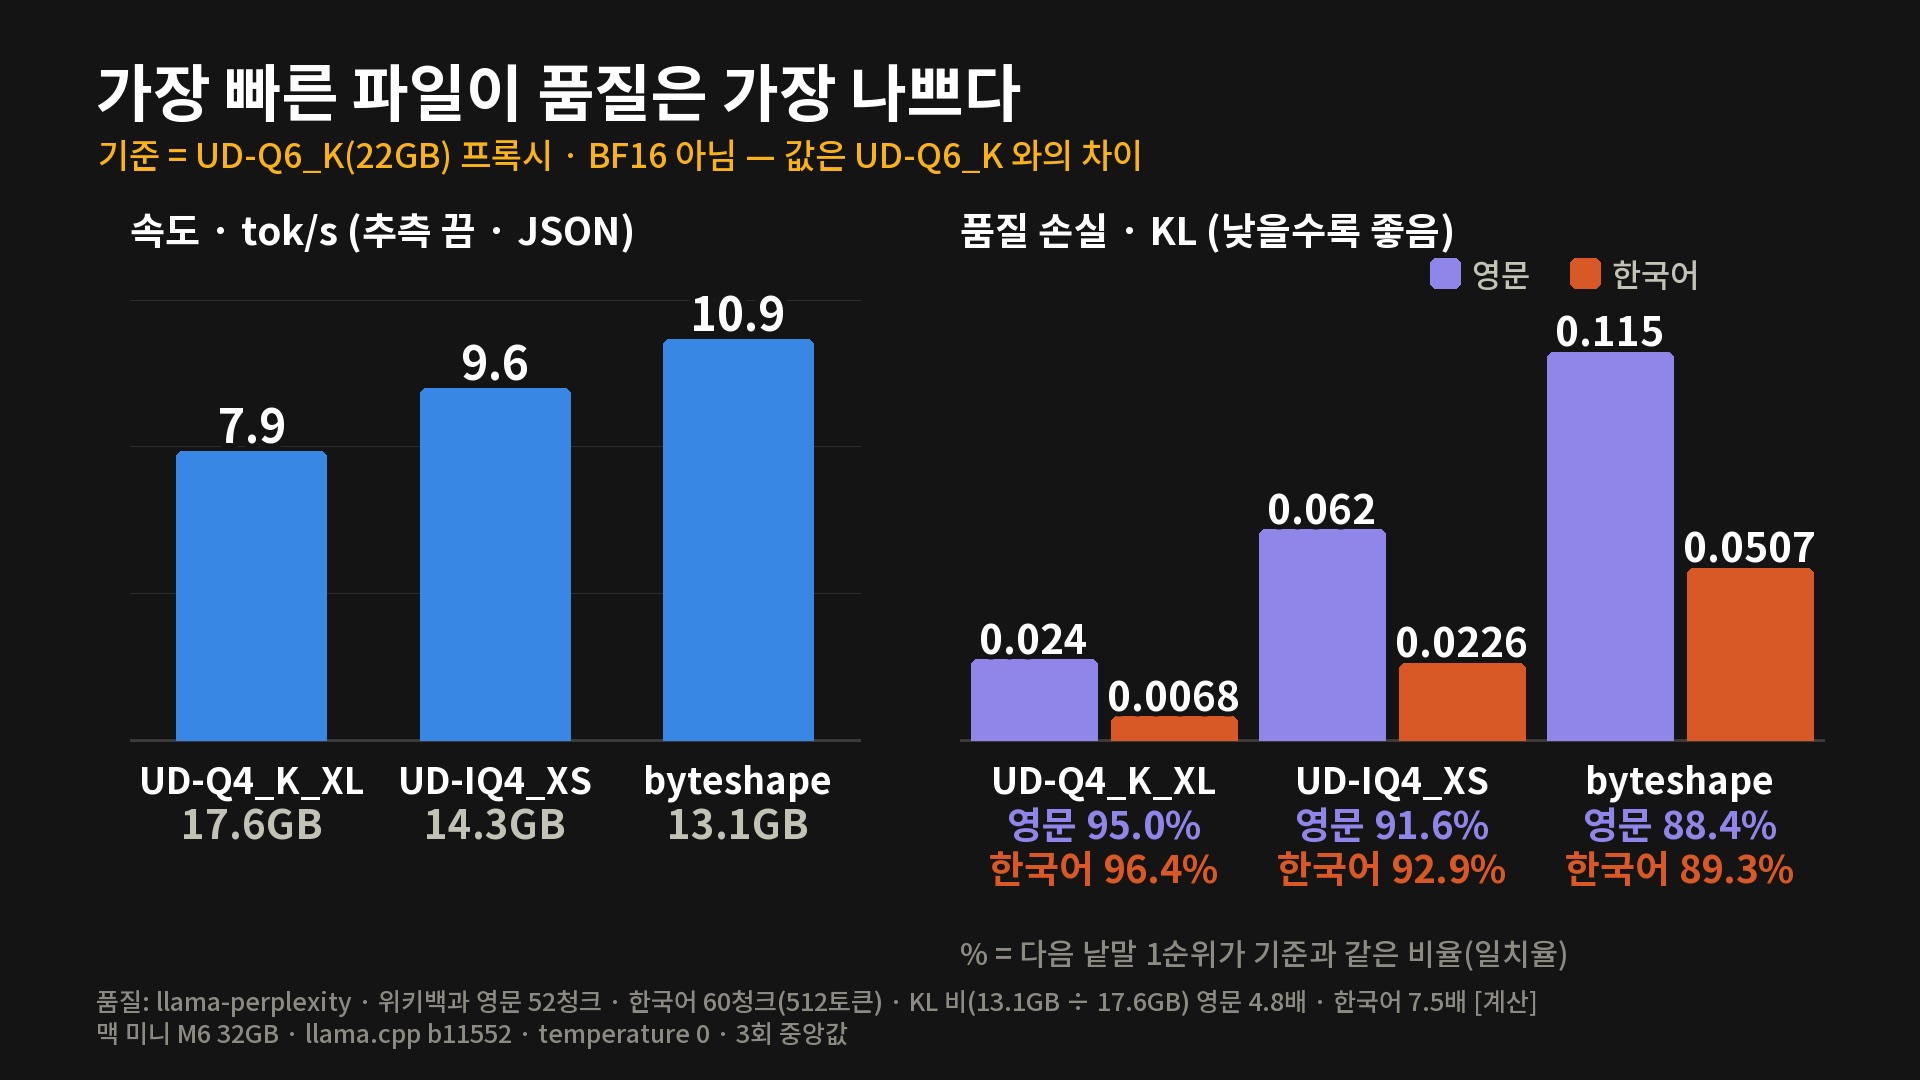
byteshape는 UD-Q4_K_XL보다 한국어 KL이 약 7.5배, 영문이 약 4.8배입니다(계산, 반올림 전 0.114565÷0.023645=4.845). 속도 이득은 같은 DFlash2끼리 JSON 12%, 코드 6.6%였습니다(계산, 반올림 전 41.45÷38.88. 표 값 41.4÷38.9로는 6.4%). 제작사는 자체 작업 점수(RTX PRO 6000 측정)로 byteshape가 가장 높다고 하지만 잰 대상이 달라 직접 비교할 수 없고, 작은 파일이 품질까지 낫다고는 이 시험으로 말할 수 없습니다. 표본은 위키백과 영문 12만 자와 한국어 7만 자입니다.
속도표에서 뺀 숫자와 고르는 순서
ngram 방식은 같은 한국어 질문을 되풀이할 때 초당 108~111토큰이 찍히지만 앞 답을 재생한 것으로 보이고, 첫 요청은 8.4토큰, 서버를 새로 켜면 8.1~8.6토큰이어서 성능으로 쓰지 않았습니다.
- 한국어 글 · 대화는 UD-Q4_K_XL + MTP(11.2토큰, 품질 손실 최소).
- 한국어를 더 빠르게 하려면 UD-IQ4_XS + MTP(12.3토큰, 한국어 KL 3배 넘게 증가).
- 코드 · JSON이 주 용도면 UD-Q4_K_XL + DFlash2(38.9~44.4토큰). 코드 · JSON 품질은 따로 재지 않았습니다.
못 잰 것과 후속 메모
BF16 기준 품질, 정답률 문제 40개, 온도 0이 아닌 샘플링 수락률, 팬 · 온도, Splash(공식 최소 메모리 36GB)는 재지 않았습니다. 모든 값은 이 맥 한 대 · 한 세션이며 몇 퍼센트 차이는 오차일 수 있습니다.
후속 메모: 2026-10-13 채널의 Strata 영상에서 같은 UD-IQ4_XS MTP 파일의 한국어를 다시 쟀더니 14.1토큰(수락률 45.3%)이 나와 이 글의 12.3(수락률 33%)과 달랐습니다. 질문 글과 호출 방식이 다른 것 외에 원인은 확인하지 못했고, 두 값은 같은 표에 섞지 않습니다.
출처 · 기준일. 측정 2026-10-11. ByteShape 블로그(2026-10-11 열람, 인용만), MTPLX 모델 카드.
본 글은 AI 음성이 쓰인 영상을 바탕으로 AI 작성 보조를 받아 정리했습니다. 정보 제공 목적이며 구매 권유가 아닙니다.