스트라타 RTX 3090 125B 양자화 5종 실측, 램 32GB 급이면 IQ3_S 프리필 2045→207
올린 날 영상 공개
RTX 3090 한 장에서 스트라타로 큐웬 3.8 Flash-Next 125B 양자화 5종을 직접 쟀습니다. 한국어 정답률은 겹쳤고, 램 32GB 급에서 IQ3_S 프리필이 2045→207토큰/초로 떨어졌습니다.
RTX 3090(24GB) 한 장에서 스트라타(Strata) 엔진으로 큐웬 3.8 Flash-Next(125B MoE)를 돌릴 때, 양자화 5종은 무엇이 다를까요. 빌린 클라우드 3090 서버에서 직접 쟀더니 한국어 정답률은 많이 겹쳤고, 먼저 갈린 것은 램과 속도였습니다. 사용 가능한 램을 32GB 급으로 줄여 재현하면 IQ3_S의 4천 토큰 프리필이 초당 2045.1토큰에서 206.7토큰으로 떨어졌습니다. 이 글은 YouTube 영상의 내용을 글로 다시 정리한 것입니다.
결론 먼저
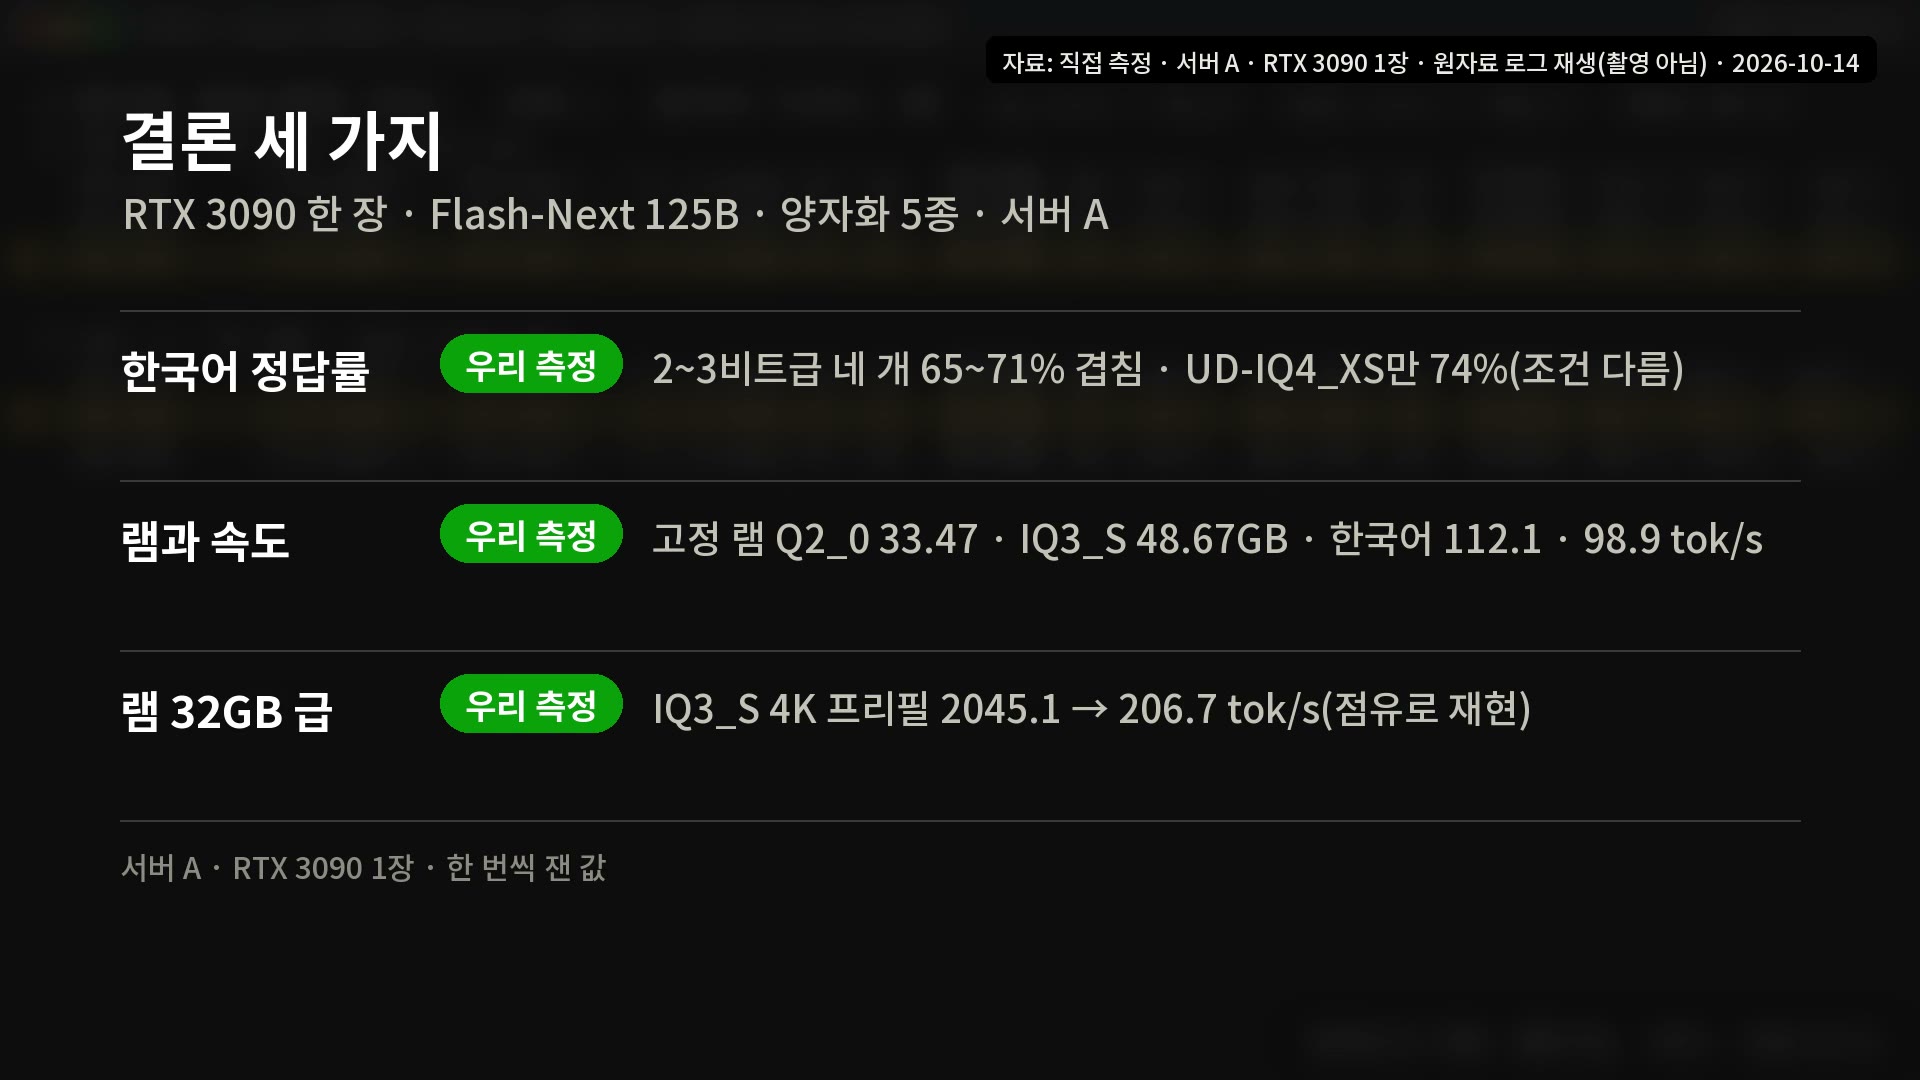
- 한국어 정답률(KMMLU 450문항): 2~3비트급 네 개(Q2_0, IQ2_XS, IQ3_XXS, IQ3_S)는 65~71%로 많이 겹쳤고, 조건이 다른 UD-IQ4_XS만 74%였습니다.
- 먼저 갈린 것은 램과 속도입니다. 가장 작은 Q2_0는 고정 램 33.47GiB에 한국어 디코드 초당 112.1토큰, IQ3_S는 48.67GiB에 98.9토큰이었습니다.
- 사용 가능한 램을 32GB 급으로 줄이면 IQ3_S의 4천 토큰 프리필이 2045.1 → 206.7토큰/초로 떨어졌고, Q2_0는 2276.8 → 1664.4로 덜 떨어졌습니다.
- 이 조건에서는 정답률보다 내 램을 먼저 보고 고르는 쪽이 낫다는 것이 영상의 읽기입니다. 모든 값은 한 번씩 잰 값입니다.
이 글의 숫자 종류
숫자는 거의 모두 우리 측정입니다(서버 A, 1회, 그리디, 생각 끈 형식). 카드 두 장 배율은 같은 서버 안에서 1장 값과 2장 값을 나눈 계산입니다. 램 구간 값은 실제 그 램을 가진 기계가 아니라 같은 서버에서 점유 프로세스로 사용 가능한 램을 줄여 재현한 값입니다. 리뷰 실측, 공식 사양, 가격은 쓰지 않았습니다.
왜 쟀나
영상은 최근 한 달 반 동안 올라온 Strata 영상 77편 가운데 댓글이 있는 63편, 댓글 4천 6백여 개를 읽는 것에서 시작합니다(질문 분류는 수작업 대략치). 가장 많은 질문은 "내 그래픽카드와 램으로 되나"였고, 찾아본 범위에서는 한국어 정답률을 수치로 잰 영상이 없었다고 합니다.
측정 조건
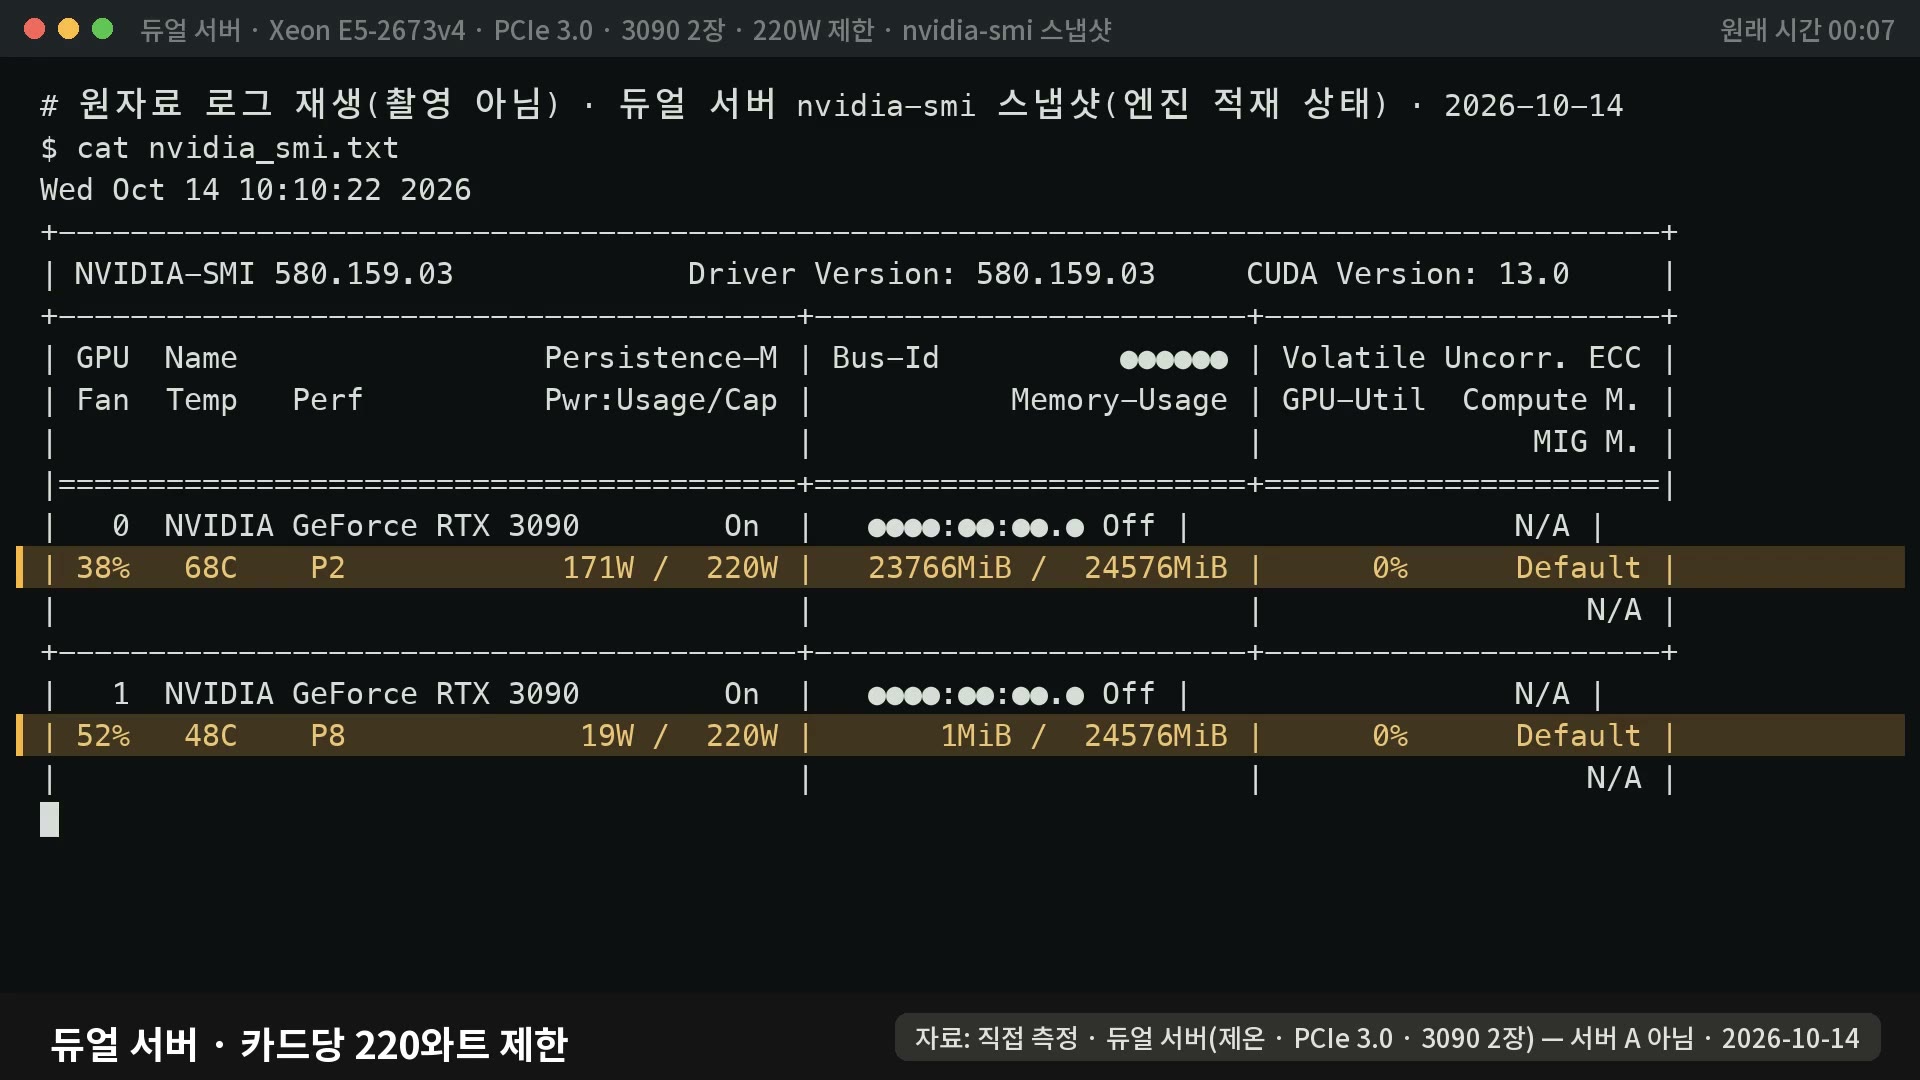
서버 A는 빌린 클라우드 서버로 라이젠 9 5950X, RTX 3090 24GB 1장, PCIe 4.0, 전력 한도 420W입니다. 엔진은 Strata 0.1.44.1(다섯 양자화 모두 같은 커밋), 컨텍스트 32768, KV int8, MTP 사용, 생각을 끈 형식에 그리디(온도 0)이고 속도는 3회 중앙값입니다. GGUF 파일 크기는 Q2_0 66.4, IQ2_XS 68.0, IQ3_XXS 75.8, IQ3_S 83.6, UD-IQ4_XS 93.7GB입니다. UD-IQ4_XS만 ROUTE_TAIL_SKIP=0, STRATA_HC_Q8=1로 돌아 나머지 넷과 조건이 다릅니다. 카드 두 장 시험은 제온 CPU, PCIe 3.0, NVLink 없음, 카드당 220W 제한인 다른 서버에서 했고, 서버 A와 절대 속도를 비교하지 않습니다.
한국어 정답률은 겹쳤다
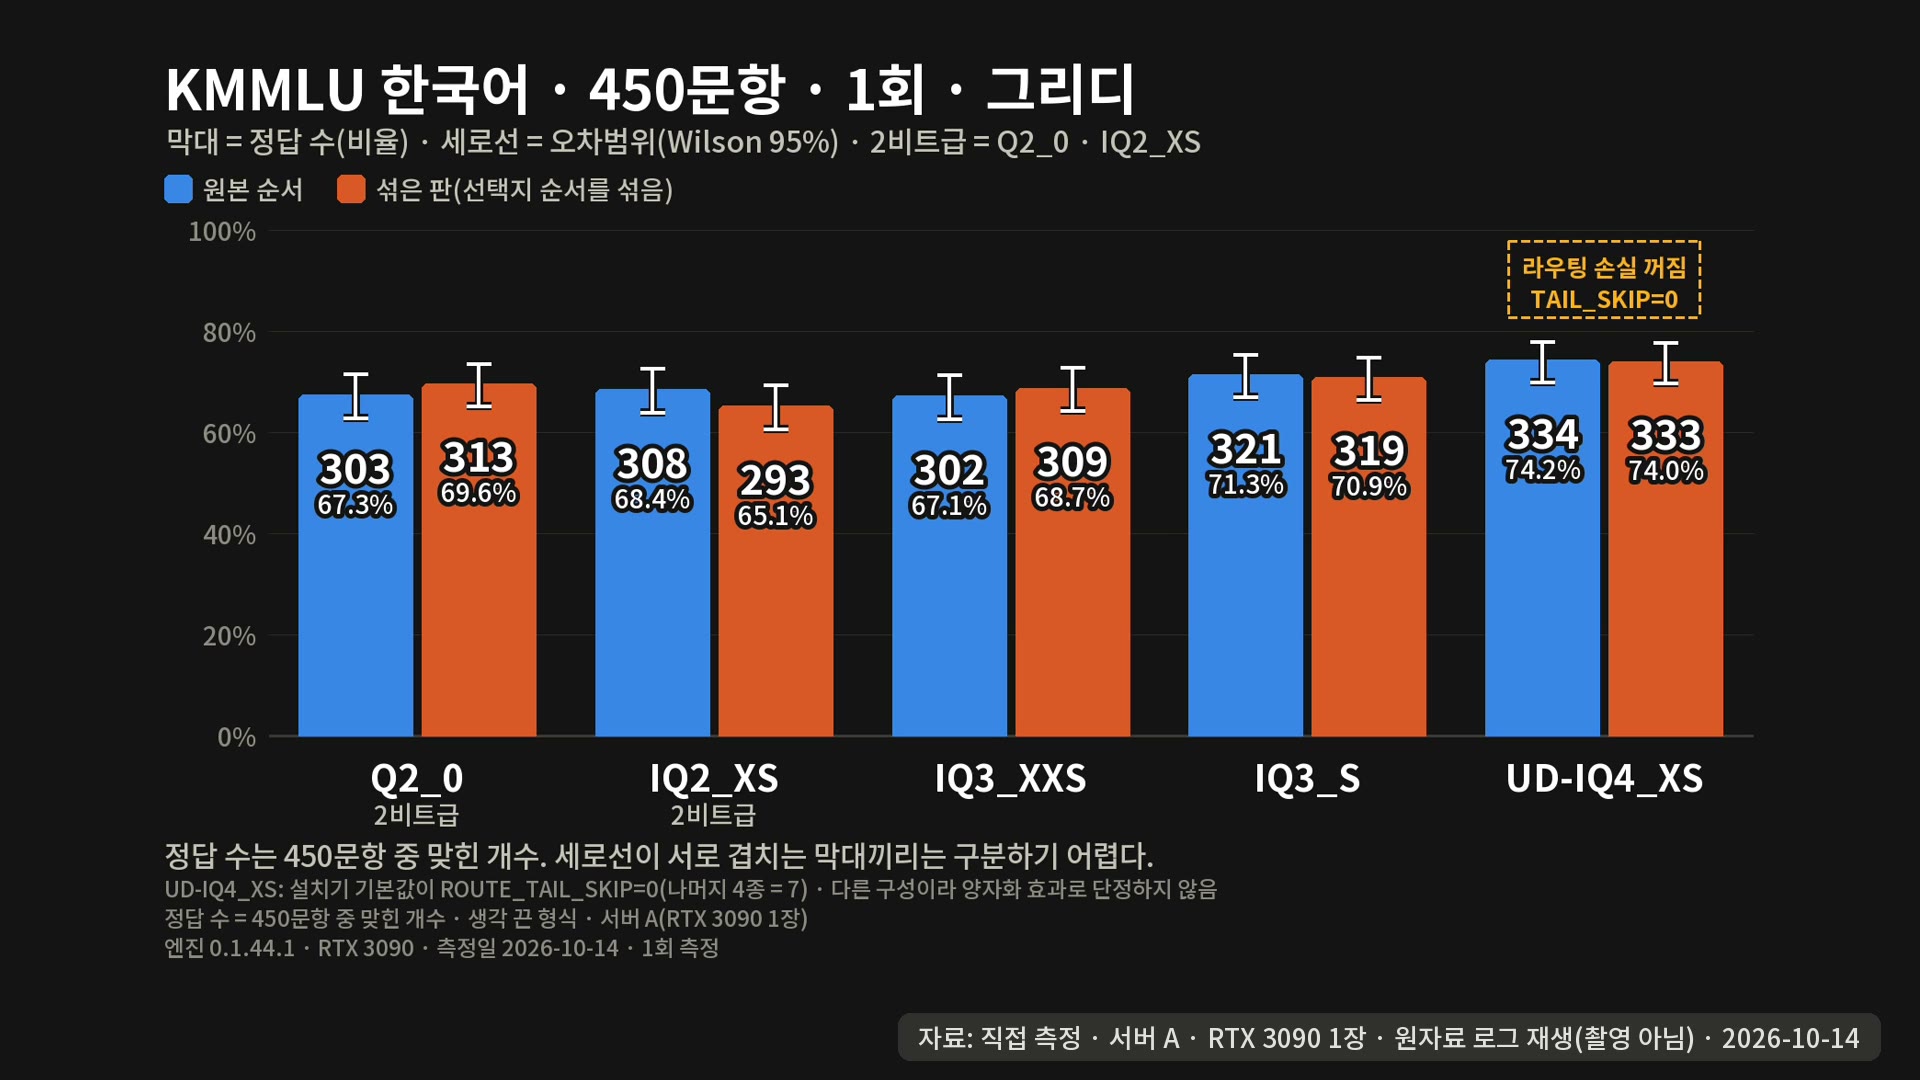
KMMLU 450문항을 원본 보기 순서와 선택지를 섞은 순서로 풀게 했습니다. 정답이 두 번째 보기인 문제가 113개인데 IQ2_XS는 섞은 판에서 두 번째 보기를 179번 골랐고, 이런 보기 쏠림이 값을 움직인 듯해 한쪽 순서만 인용하지 않았습니다. 95% 신뢰구간은 위아래 4%포인트쯤이라 대부분 겹칩니다. 스무 번의 쌍 비교 중 엄격한 기준을 넘은 쌍은 다섯인데, 그중 넷은 조건이 다른 UD-IQ4_XS가 낀 쌍이라 양자화 효과로 단정하지 못합니다.
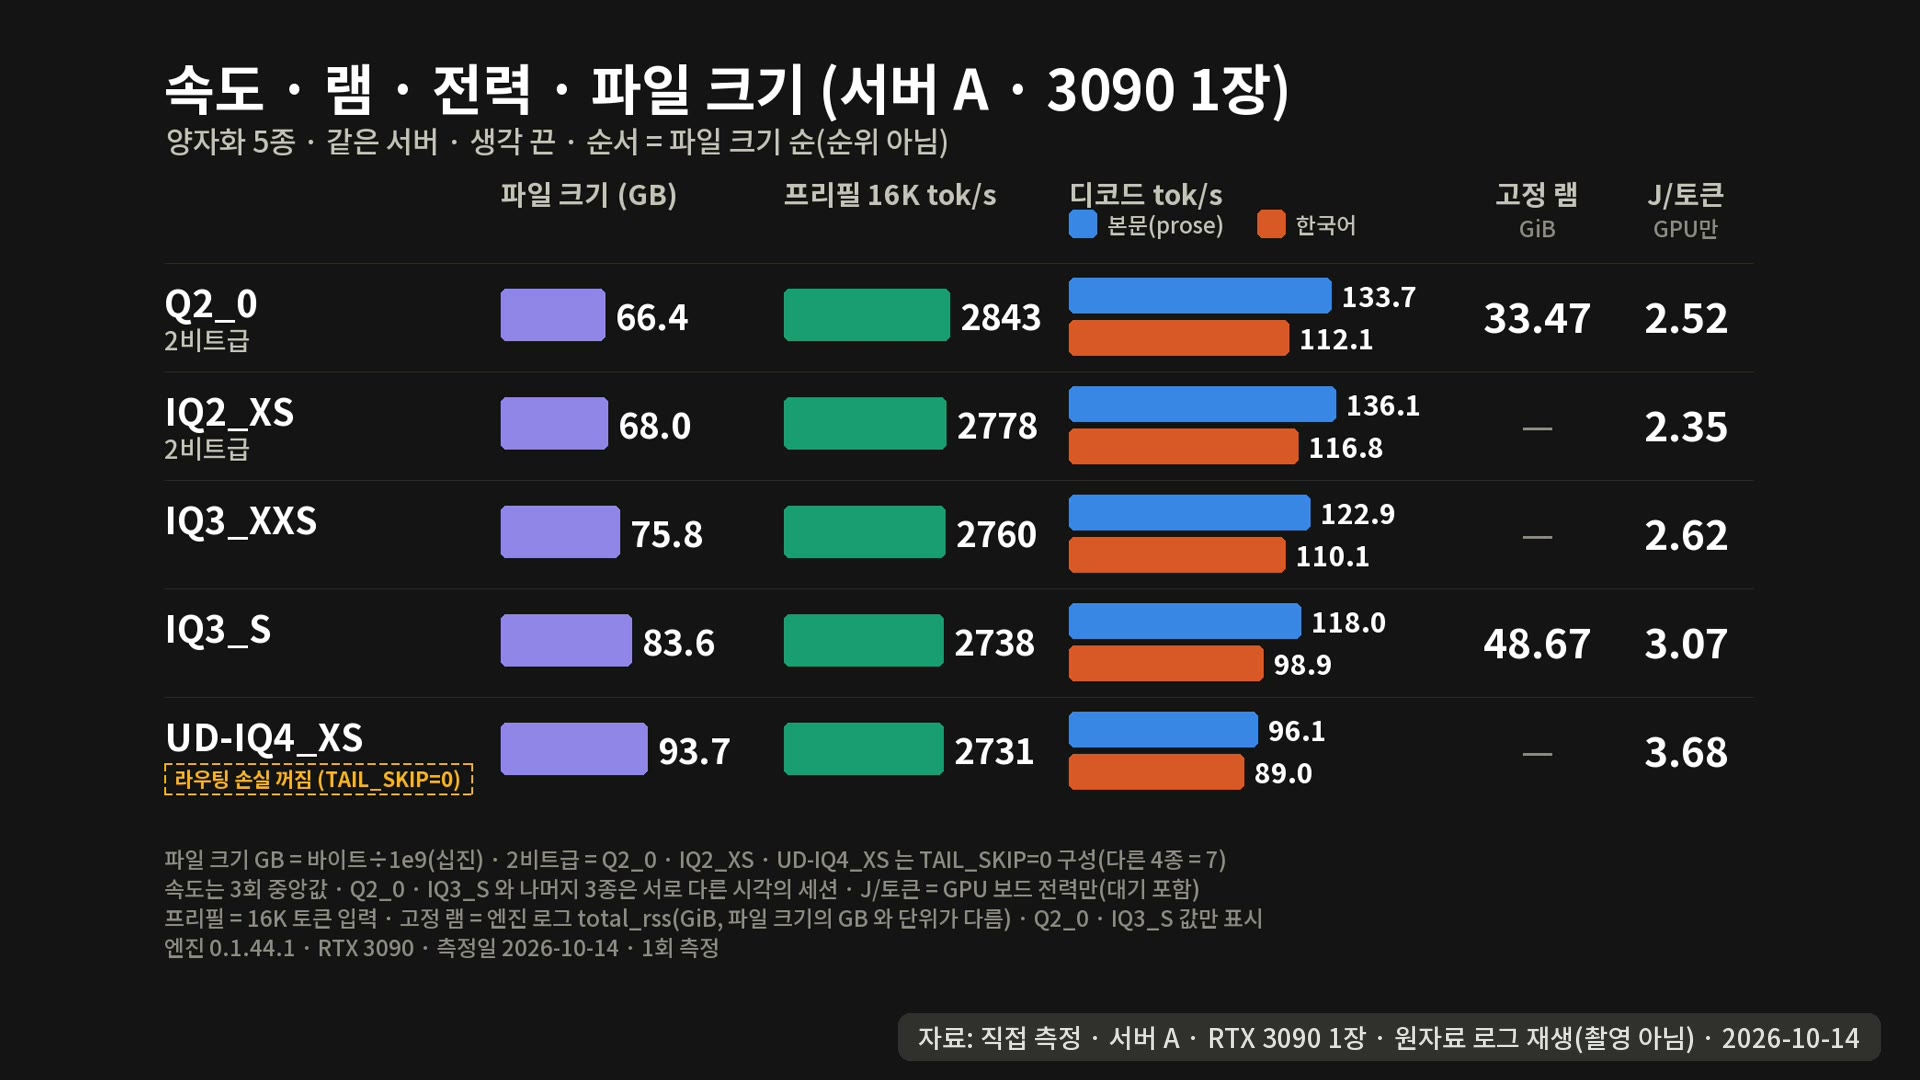
5종 한눈에 (서버 A, 우리 측정)
| 양자화 | 파일 GB | KMMLU 원본 / 섞은 % | 디코드 산문 / 한국어 tok/s | GPU J/토큰 | 코딩 52 | 툴콜 49(v2) |
|---|---|---|---|---|---|---|
| Q2_0 | 66.4 | 67.3 / 69.6 | 133.7 / 112.1 | 2.52 | 34 | 48 |
| IQ2_XS | 68.0 | 68.4 / 65.1 | 136.1 / 116.8 | 2.35 | 37 | 46 |
| IQ3_XXS | 75.8 | 67.1 / 68.7 | 122.9 / 110.1 | 2.62 | 40 | 48 |
| IQ3_S | 83.6 | 71.3 / 70.9 | 118.0 / 98.9 | 3.07 | 38 | 48 |
| UD-IQ4_XS | 93.7 | 74.2 / 74.0 | 96.1 / 89.0 | 3.68 | 39 | 47 |
긴 입력을 읽는 프리필(1만 6천 토큰)은 초당 2843에서 2731토큰까지 다섯 개가 거의 같았습니다. 갈린 것은 글을 쓰는 디코드이고, 파일이 클수록 대체로 느려지고 토큰당 에너지(GPU 전력만, 대기 전력 포함)도 늘었습니다. 속도는 같은 서버에서 시간을 달리해 두 번에 나눠 잰 값입니다. 고정 램은 Q2_0와 IQ3_S만 기록이 있습니다.
코딩 · 툴콜 · 한자 · 반복
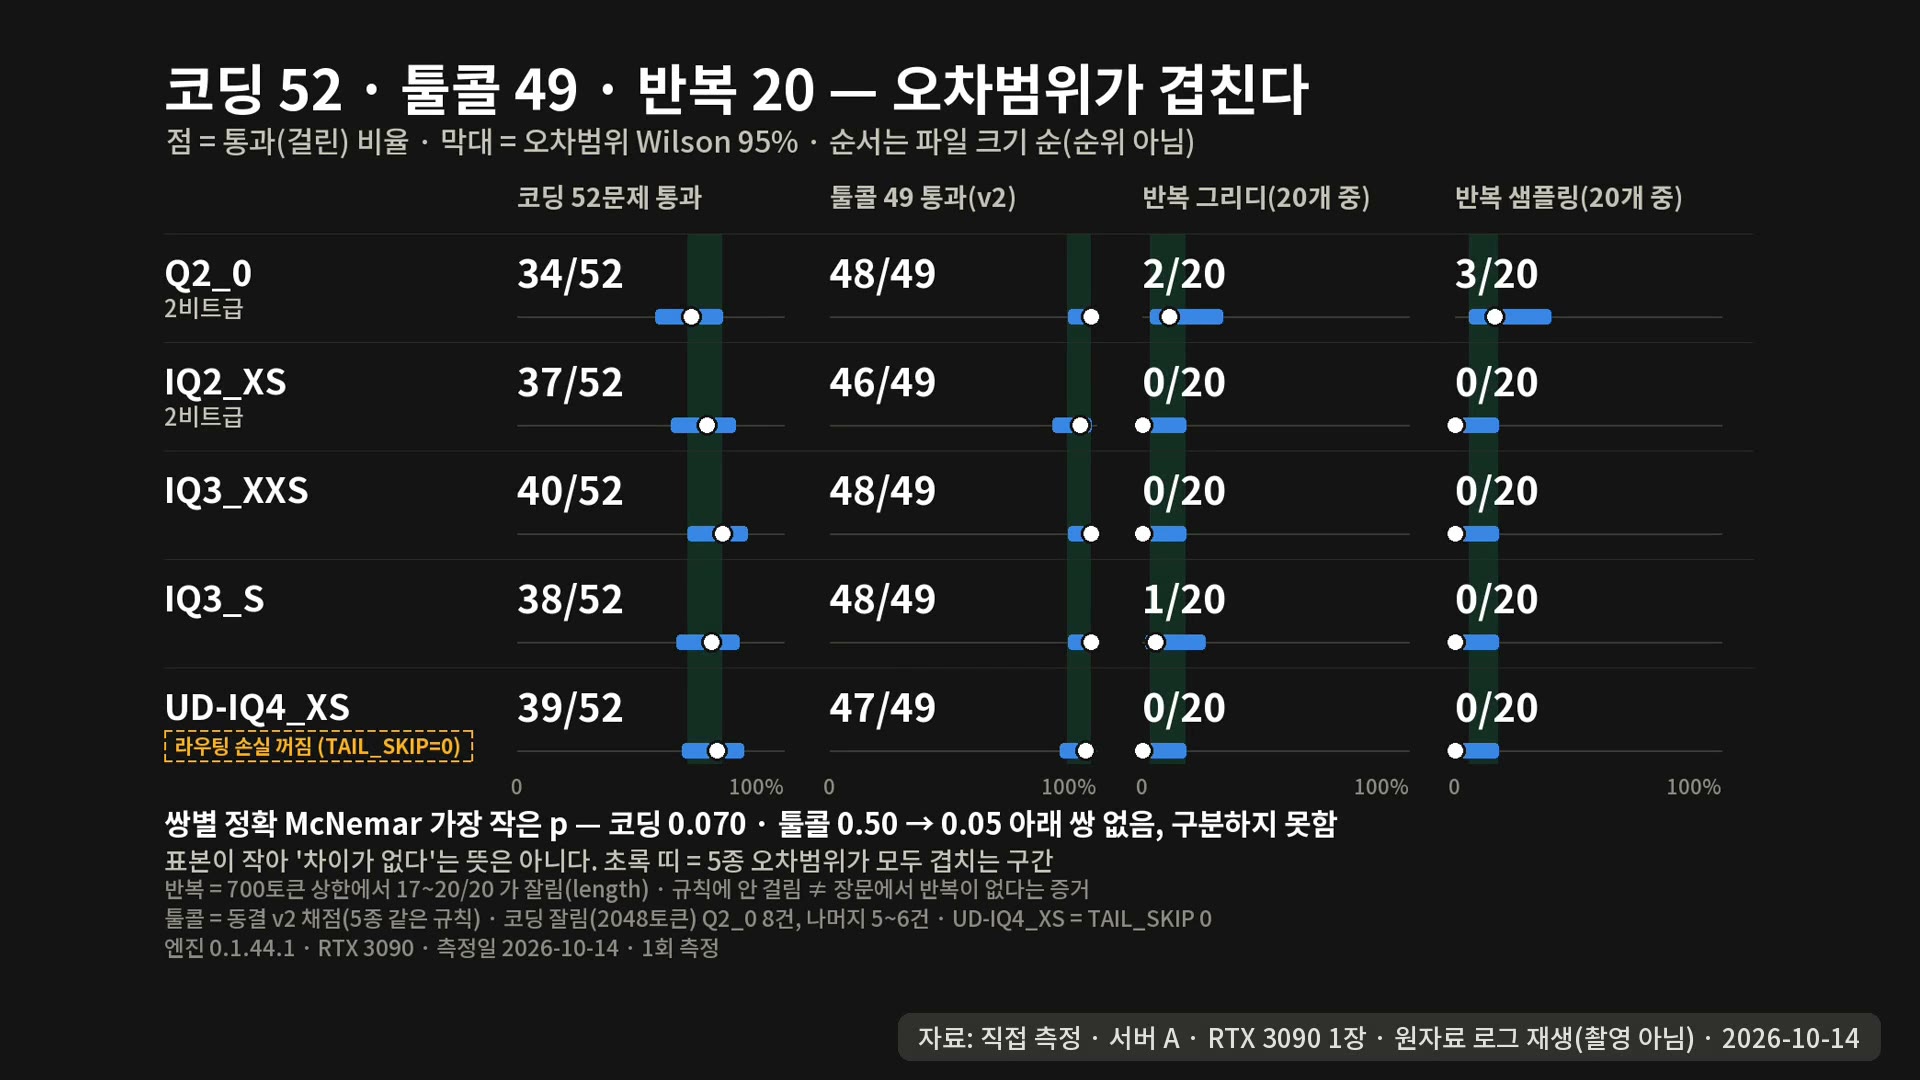
코딩 52문제 통과는 34~40개였고, 열 쌍을 짝으로 비교해도 5% 기준을 넘는 차이는 없었습니다. 2048토큰에서 잘린 답이 Q2_0 8건, IQ2_XS 5건, 나머지 6건씩이라 통과율에 짧게 끝내는 습관이 섞였을 수 있습니다. 툴콜 49개는 동결한 판정기 v2로 46~48개가 통과했고, 판정 예외 하나가 Q2_0에만 작용해 순위는 말하지 않습니다. 한자 혼입은 짧은 한국어 프롬프트 12개에서 Q2_0의 5개 답에 섞였고 나머지는 0개, 700토큰 장문 20개에서는 Q2_0 16개, IQ2_XS 2개, 나머지 0개였습니다. 반복 판정은 20개 중 그리디에서 Q2_0 2개, IQ3_S 1개, 샘플링에서 Q2_0 3개가 걸렸지만 거의 모든 답이 700토큰에서 잘려, 긴 글에서 반복이 안 생긴다는 뜻으로 읽으면 안 됩니다.
램이 모자라면
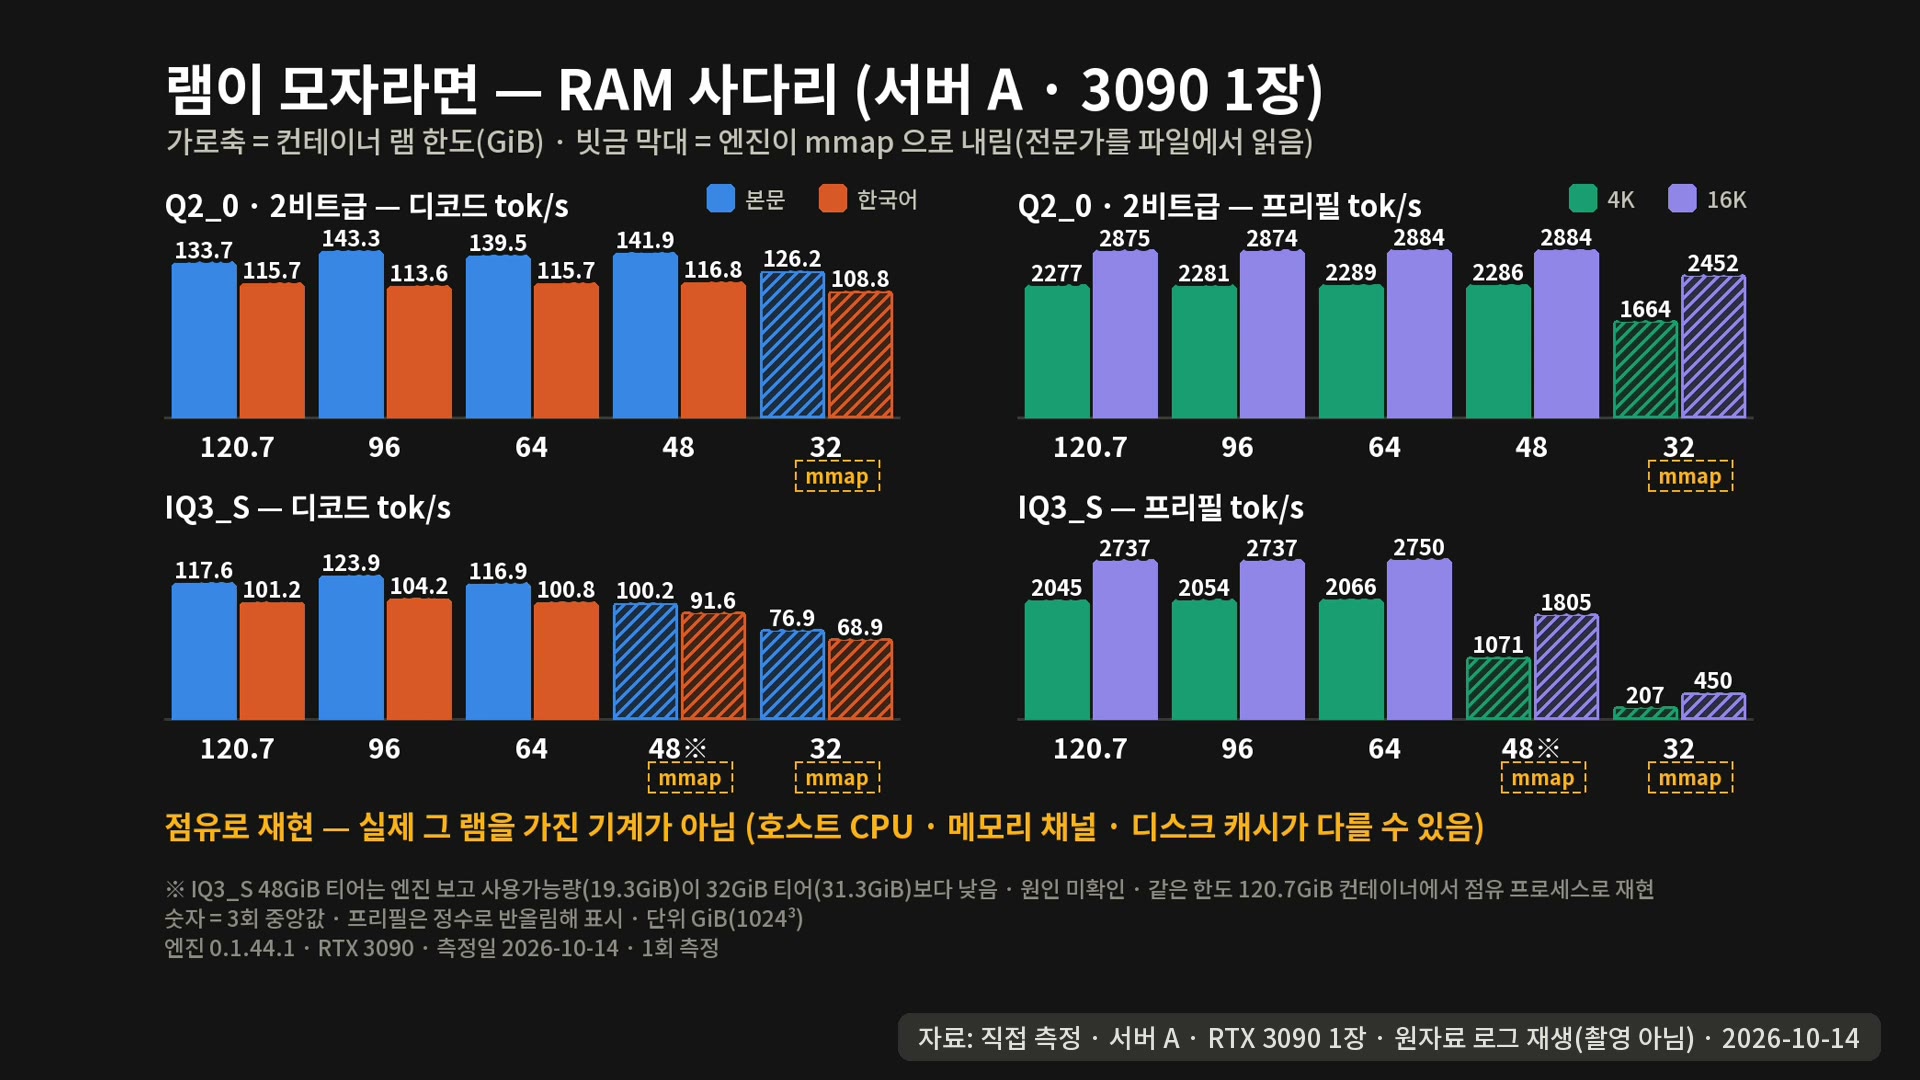
같은 서버 A에서 점유 프로세스로 사용 가능한 램을 줄여 Q2_0와 IQ3_S 두 개만 재현했습니다. 엔진은 전문가를 전부 램에 올리는 정상 모드에서 램이 모자라면 전문가를 파일에서 읽는 모드(mmap)로 내려갑니다.
| 사용 가능 램 | Q2_0 디코드 평균 / 4K 프리필 | IQ3_S 디코드 평균 / 4K 프리필 |
|---|---|---|
| 자연(약 120GiB) | 124.7 / 2276.8 | 109.4 / 2045.1 |
| 96GiB | 128.4 / 2281.4 | 114.1 / 2054.2 |
| 64GiB | 127.6 / 2289 | 108.8 / 2066 |
| 48GiB | 129.3 / 2285.5 | 파일 읽기 모드, 숫자 생략(원인 미확인) |
| 32GiB 급 | 117.5 / 1664.4 (파일 읽기 모드) | 72.9 / 206.7 (파일 읽기 모드) |
디코드는 산문과 한국어의 평균입니다. Q2_0는 48GiB까지 정상이고 32GiB 급에서 내려갔으며, IQ3_S는 64GiB까지 정상이고 48GiB부터 내려갔습니다. IQ3_S의 48GiB 구간은 엔진이 보고한 사용 가능량의 원인을 확인하지 못해 숫자를 쓰지 않았습니다.
카드 한 장 더
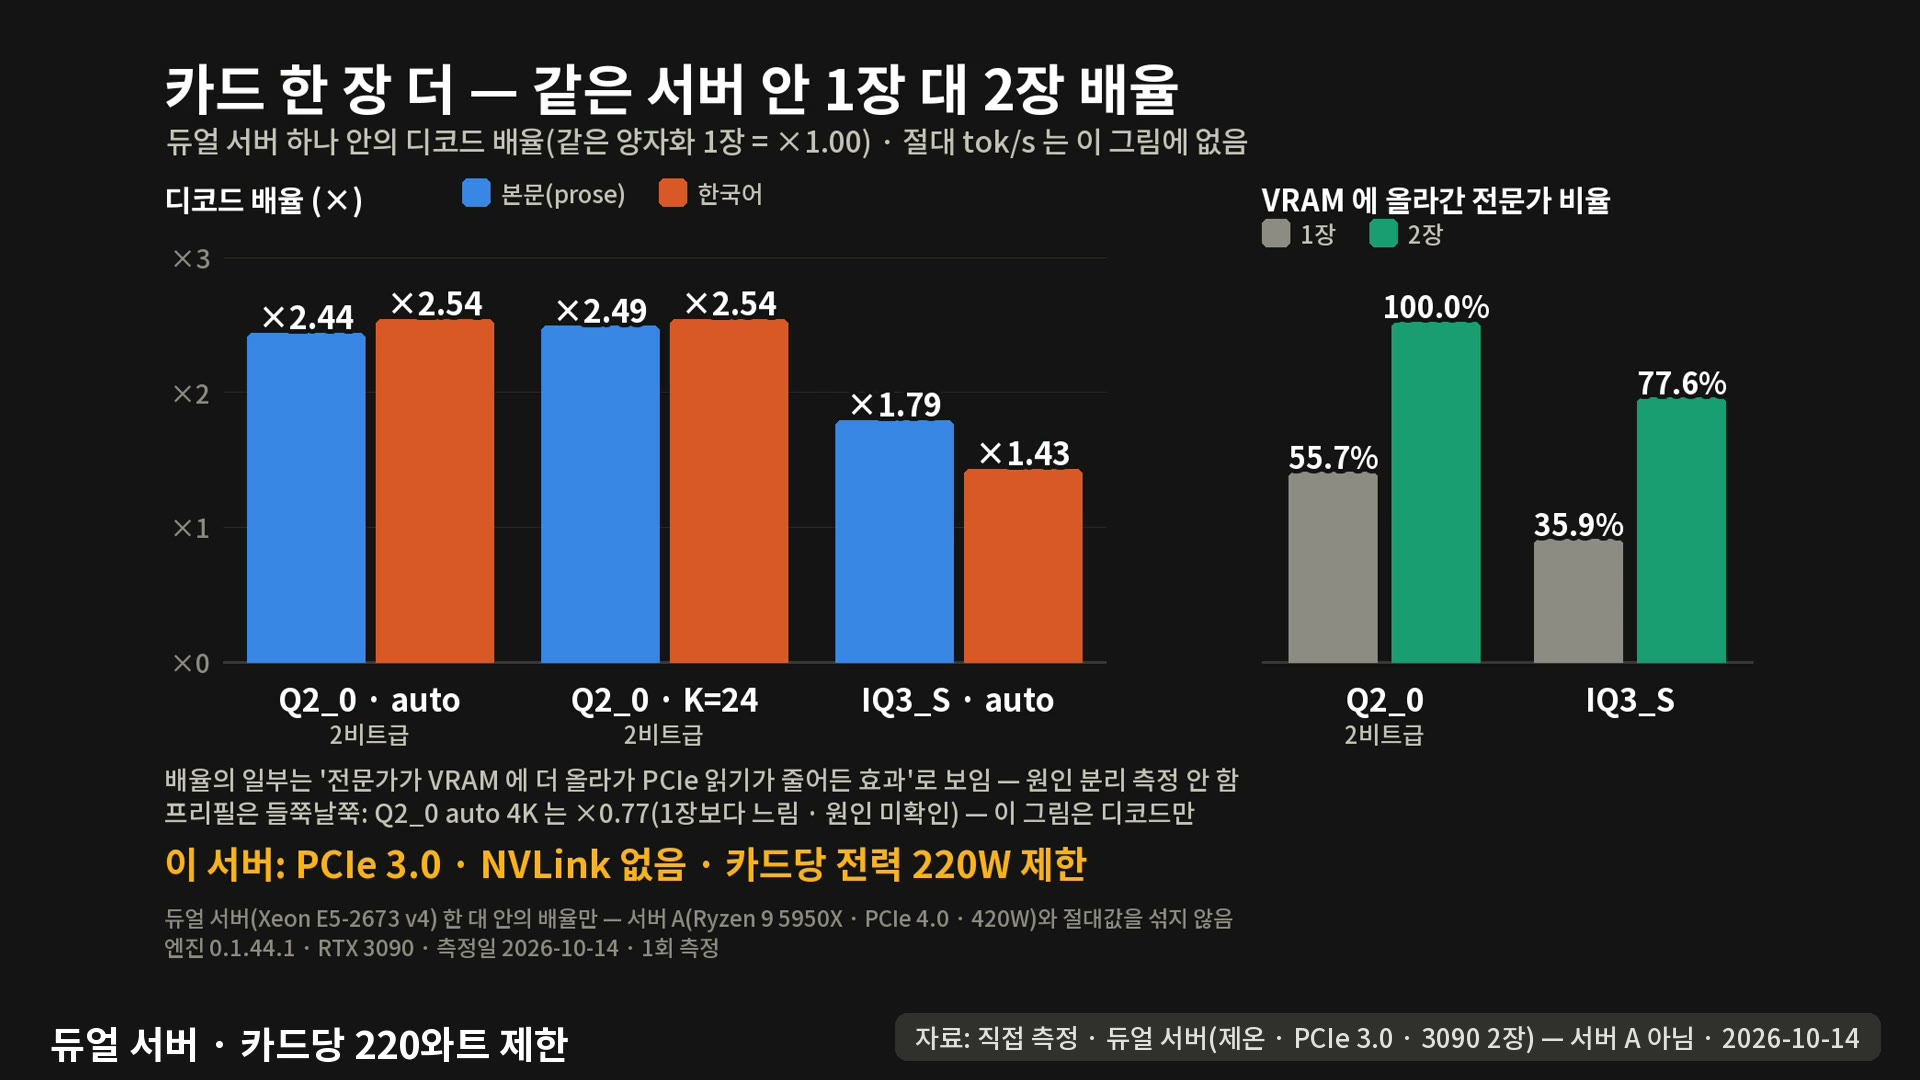
3090 두 장짜리 다른 서버에서 같은 서버 안 1장 대 2장만 비교한 배율입니다. 이 서버는 PCIe 3.0에 NVLink가 없고 카드당 전력이 220W로 제한돼 있습니다.
산문 디코드는 Q2_0가 2.44배(분할을 직접 정하면 2.49배), IQ3_S가 1.79배였습니다. 이 배율에는 카드 연산과, 전문가가 전부 그래픽카드 메모리에 들어간 효과가 섞여 있고 원인은 분리해 재지 않았습니다. 그래픽카드 메모리에 올라간 전문가 비율은 Q2_0가 55.7%에서 100%, IQ3_S가 35.9%에서 77.6%였습니다. Q2_0의 4K 프리필은 2장에서 오히려 0.77배였고 원인은 확인하지 못했습니다.
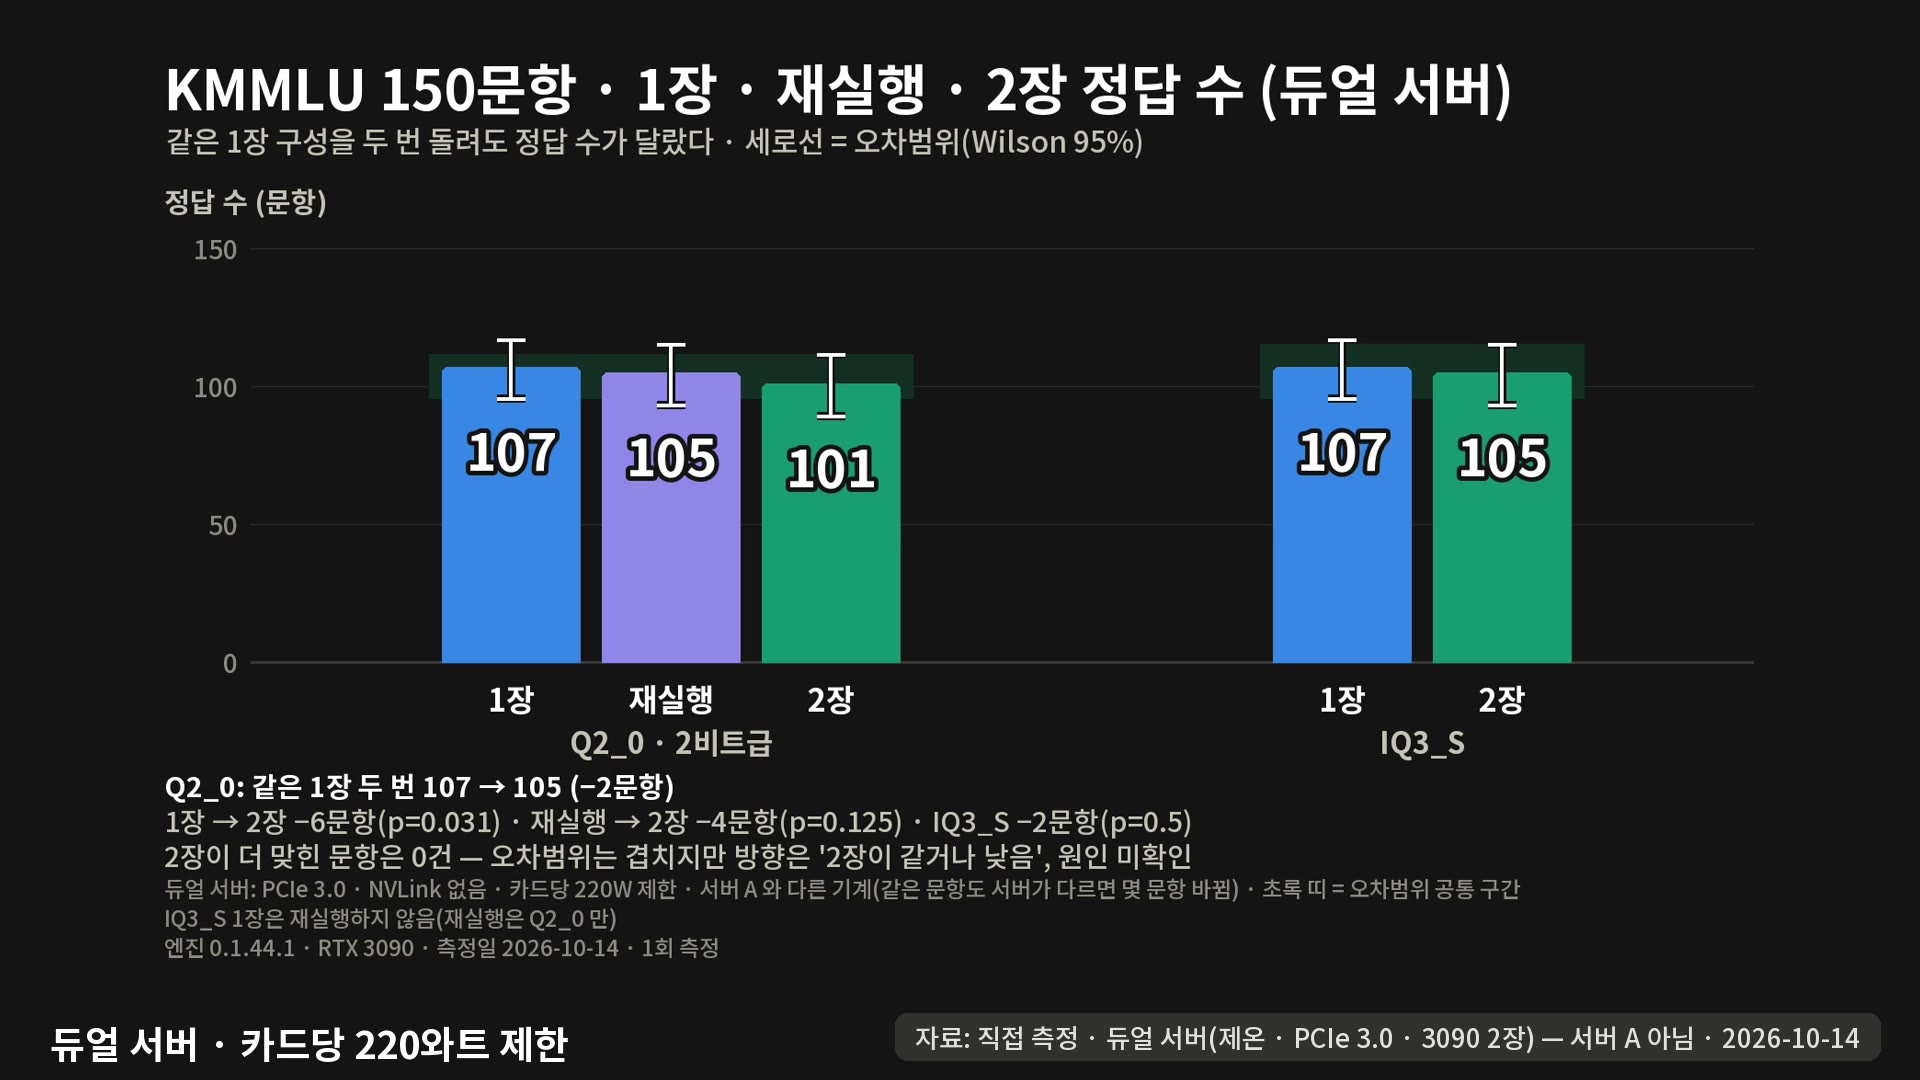
KMMLU 150문항 부분집합에서는 Q2_0가 1장 107, 같은 1장을 다시 돌려 105, 2장 101문항이었고 IQ3_S는 1장 107, 2장 105문항이었습니다. 2장 쪽이 2~6문항 낮게 나왔습니다. 같은 1장을 다시 돌려도 2~3문항 흔들리니 그 편차와 겹치는 범위일 수 있지만, Q2_0의 첫 비교(107 대 101)는 6 대 0으로 p=0.03이었습니다. 원인은 카드를 나눈 방식일 수 있다는 정도이고 확인하지 못했습니다. 그래서 2장이라고 정확도가 같다고 단정하지는 않습니다. 2장이 더 맞힌 문항은 두 양자화 모두 0건이었습니다.
한계 · 기준일
- 모든 시험은 한 번 측정에 그리디, 생각을 끈 형식입니다. 2비트급 두 개, 한자 12개, 반복 20개, 코딩 52개, 툴콜 49개는 표본이 작아 일반화할 수 없습니다.
- 서버 A 값과 듀얼 서버 값은 섞지 않았고, 램 구간 값은 점유로 재현한 것이라 실제 그 램의 기계와 다를 수 있습니다(호스트 CPU, 메모리 채널, 디스크 캐시).
- UD-IQ4_XS는 조건이 달라 양자화 효과로 단정하지 못합니다.
- 기준일: 측정과 영상 공개는 2026-10-14~15(영상 공개 2026-10-15). 엔진은 Strata 0.1.44.1입니다.
요약
- 정답률은 오차범위 안에서 겹쳤고, 램이 모자랄 때 IQ3_S는 크게, Q2_0는 완만하게 내려갔습니다.
- 카드를 한 장 더 다는 효과는 이 서버에서 1.79~2.49배였지만 메모리 효과가 섞여 다른 구성에 그대로 옮길 수 없습니다.