미니맥스 H3 최적 설정, RTX 5090 한 장으로 AI 단편영화 만들며 겪은 문제 7가지
올린 날 영상 공개
RTX 5090 한 장으로 20분 AI 단편영화를 만들며 정한 MiniMax H3 설정과 대사 되풀이, 말소리, 전경 자리 문제의 해결법, SageAttention 직접 잰 값을 정리했습니다.
RTX 5090 한 장으로 20분짜리 AI 단편영화 「90초」(15장면, 클립 198개)를 만들면서 MiniMax H3의 최적 설정을 찾고, 실제로 터진 문제를 해결한 과정을 정리했습니다. 설정 중 속도를 가장 크게 바꾼 것은 Turbo LoRA였고, 나머지 문제 대부분은 GPU와 상관없는 "품질 규칙"이었습니다. 이 글은 YouTube 영상의 내용을 읽기 쉽게 다시 정리한 것입니다.
결론 먼저
- 영상 모델은 int8 판을, 속도는 모드별 Turbo LoRA를 썼습니다. 인물 참조 컷은 ref2v 8스텝, 첫 프레임에서 시작하는 인서트 컷은 fl2v 4스텝이고 둘 다 768p용이라 해상도를 1344x768로 맞췄습니다.
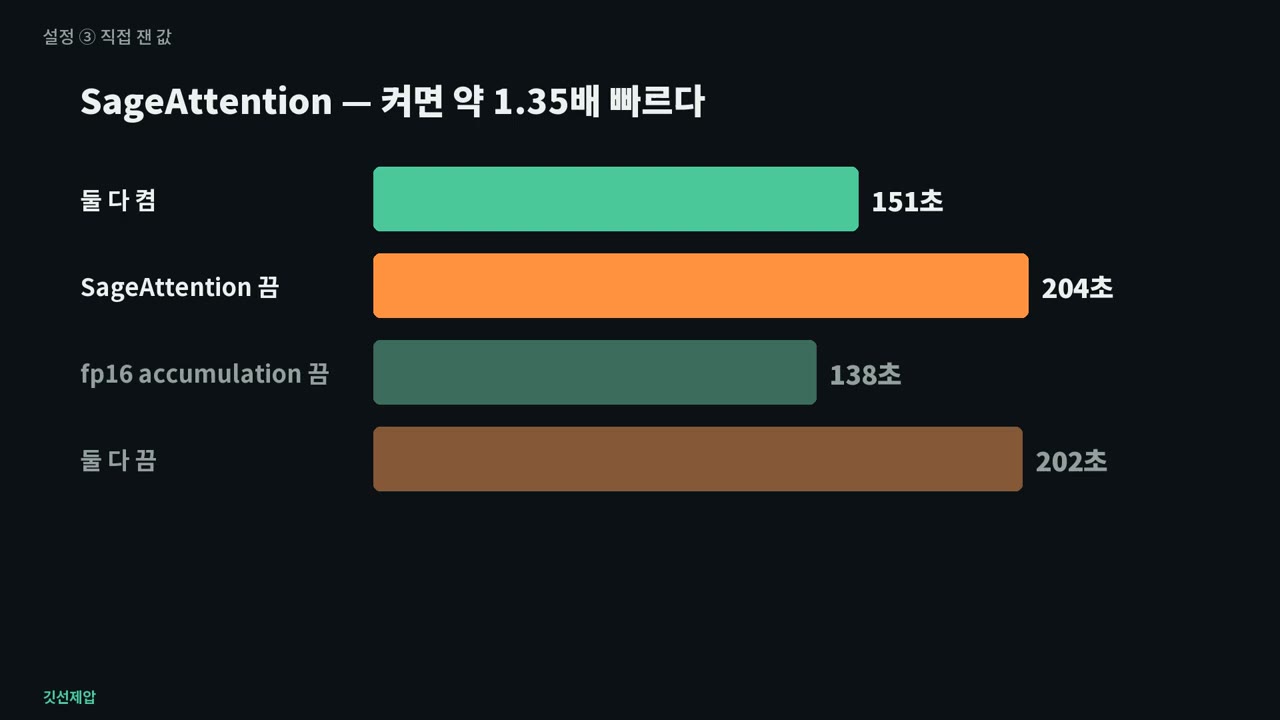
- SageAttention은 끄면 한 구간이 151초에서 204초로 약 1.35배 느려져 켜 둡니다. fp16 accumulation은 H3 생성에서 차이가 없었습니다.
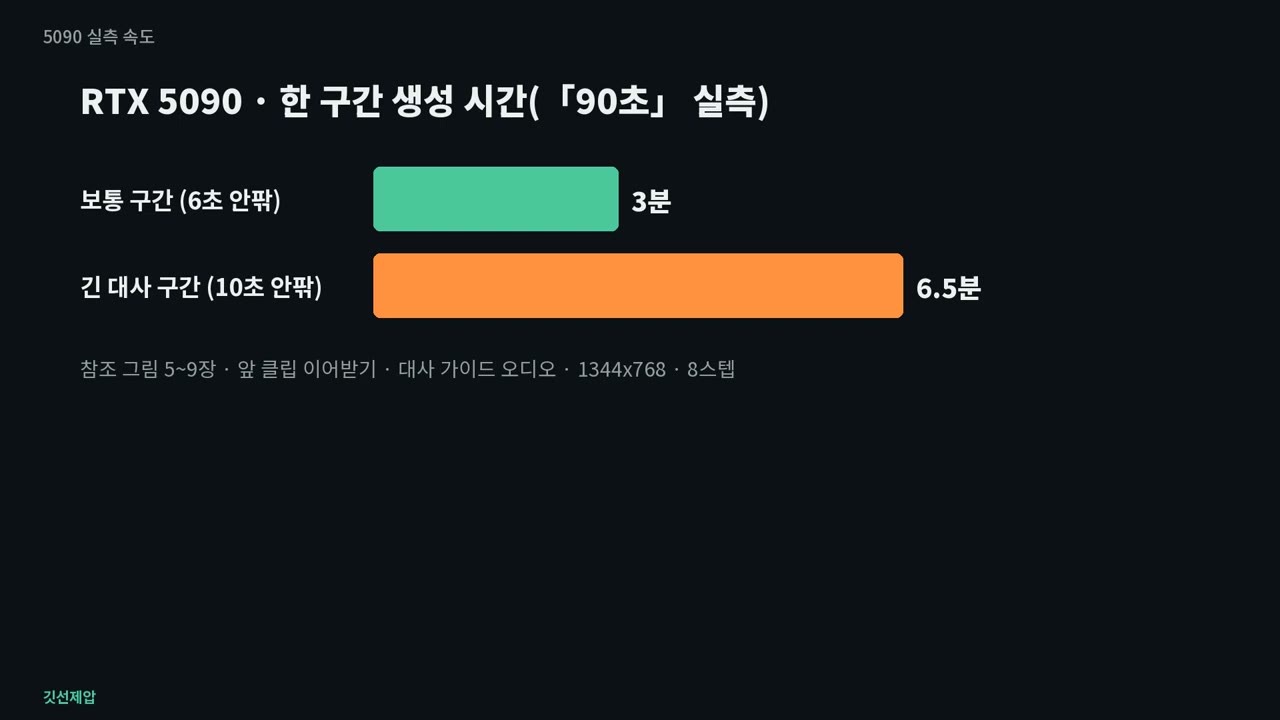
- 실제 생성은 보통 구간(6초 안팎) 3분, 긴 대사 구간(10초 안팎) 6.5분이었습니다. 전체 예상 시간은 6~9시간에서 10~12시간으로 고쳤습니다.
- 대사는 구간 끝에, 소리 설명에는 방 소리만, 화면 글자는 편집에서, 여럿이 나오는 전경은 자리를 박은 첫 프레임으로 만듭니다.
이 글의 숫자는 세 종류입니다
| 표기 | 뜻 |
|---|---|
| 우리 측정 | RTX 5090 32GB 한 장(클라우드 대여), ComfyUI 0.37에서 직접 잰 값(2026-09-25 영상 기준) |
| 타인 주장·보고 | 모델 제작 측 설명, 다른 채널의 측정, 커뮤니티 의견(출처는 영상 설명란) |
| 추정 | 직접 재지 않은 것. 낮은 GPU에 대한 조언이 여기에 해당 |
무엇을 만들었고 어떻게 돌렸나
「90초」는 심리 스릴러입니다. 인물과 장소 그림은 FLUX.2 [dev], 영상은 MiniMax H3로 만들었고, 대사 음성을 먼저 만들어 H3의 가이드 오디오로 넣어 따로 립싱크 없이 생성 때부터 입이 말에 맞게 움직입니다. 영상 생성은 클라우드의 RTX 5090에서 했습니다.
설정 ① 모델 파일과 ② Turbo LoRA
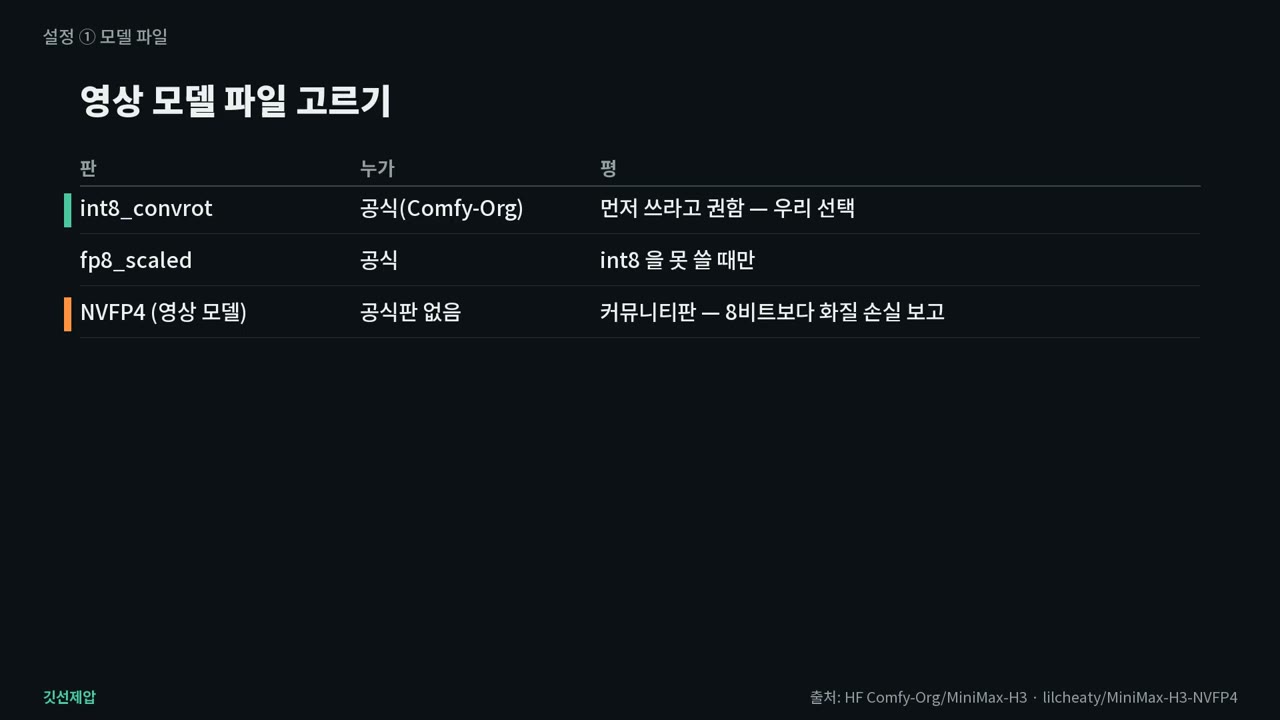
공식 저장소(Comfy-Org)는 int8_convrot 판을 먼저 쓰라고 권합니다. fp8_scaled는 int8을 못 쓸 때만 쓰는 공식 판입니다. 50 시리즈라 NVFP4가 떠오르지만 영상 모델에는 공식 NVFP4 판이 없고, 커뮤니티 판은 8비트보다 화질 손실이 눈에 띈다는 보고가 있어 int8로 갔습니다.
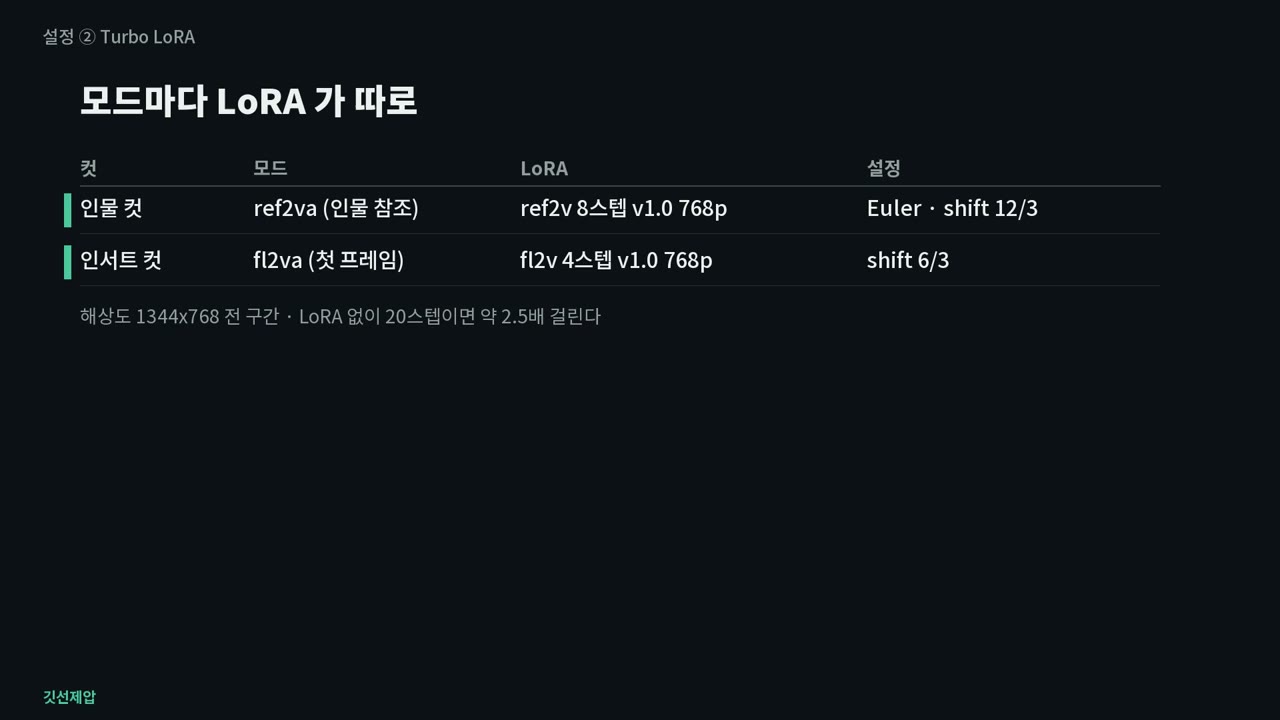
속도를 가장 크게 바꾸는 것은 lightx2v의 Turbo LoRA이고, 모드마다 LoRA가 따로입니다. 해상도 1344x768 전 구간에서 LoRA 없이 20스텝이면 약 2.5배 걸린다고 영상에 표시됐습니다.
| 컷 | 모드 | LoRA | 설정 |
|---|---|---|---|
| 인물 컷 | ref2v(인물 참조) | ref2v 8스텝 v1.0 768p | Euler, shift 12/3 |
| 인서트 컷 | fl2v(첫 프레임) | fl2v 4스텝 v1.0 768p | shift 6/3 |
fl2v 버전은 평이 엇갈립니다. v1.2가 낫다는 영상도 있고, v1.0이 가장 낫고 v1.2는 원본을 많이 바꾼다는 사용자 평도 있어(타인 의견), 첫 프레임을 덜 바꾸는 v1.0을 골랐습니다.
설정 ③ 켠 것과 안 켠 것(직접 잰 값)
커뮤니티가 권하는 속도 옵션 두 개를 5090에서 켜고 끄며 같은 구간, 같은 시드로 네 조합을 뽑았습니다(조합마다 한 판씩).
| 조합 | 한 구간 생성 시간 | 기준 대비 SSIM |
|---|---|---|
| 둘 다 켬 | 151초 | 기준 |
| SageAttention 끔 | 204초 | 0.947 |
| fp16 accumulation 끔 | 138초 | 0.929 |
| 둘 다 끔 | 202초 | 0.932 |
SageAttention은 확실한 효과가 있었습니다(약 1.35배). fp16 accumulation은 오히려 끈 쪽이 조금 빨랐지만 한 판씩 잰 값이라 오차 범위로 봅니다. Comfy 블로그가 이 옵션으로 빨라졌다고 한 곳은 영상 생성이 아니라 영상 VAE였습니다. 화면은 네 조합 모두 구도와 내용이 같았습니다.
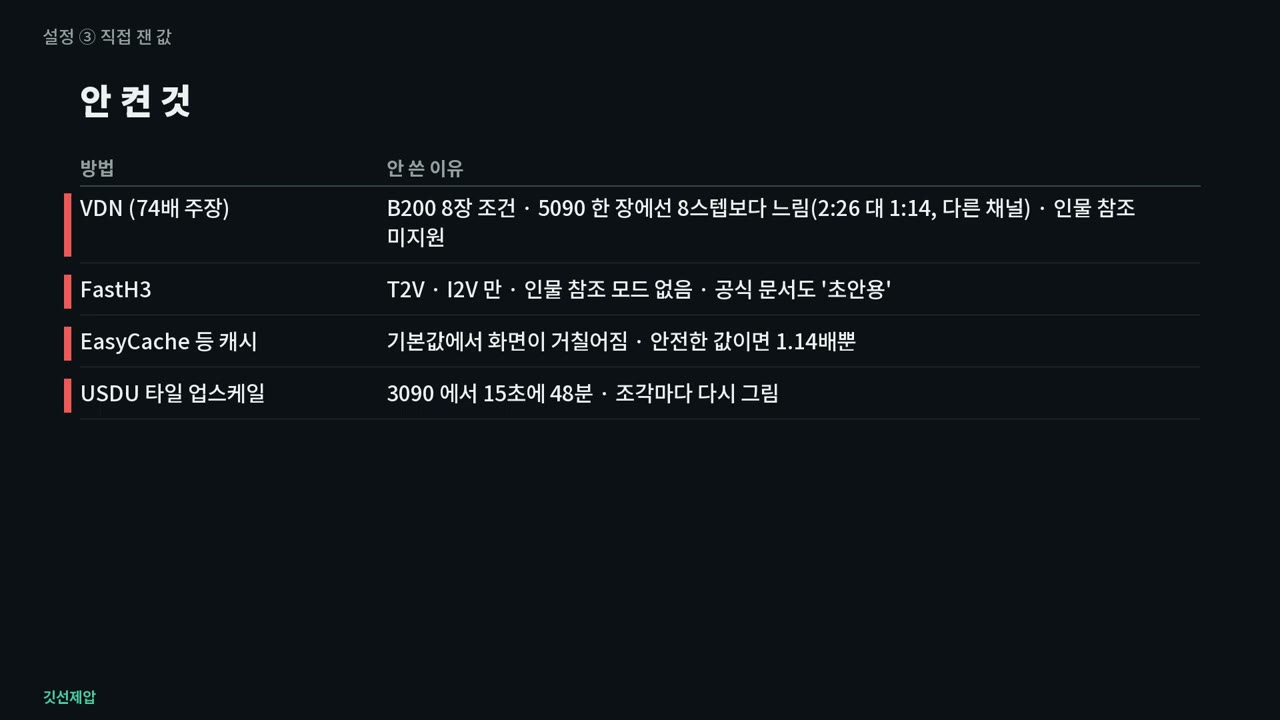
안 켠 것도 있습니다. 74배 빠르다는 VDN은 B200 8장 조건의 주장이고 5090 한 장에서는 8스텝보다 느렸다는 다른 채널의 측정이 있으며 인물 참조도 지원하지 않습니다. FastH3는 T2V·I2V만 되고 인물 참조 모드가 없으며 공식 문서도 '초안용'이라고 적습니다. EasyCache 같은 캐시 가속은 기본값에서 화면이 거칠어지고 안전한 값이면 1.14배뿐이라 껐고, USDU 타일 업스케일은 영상 표기로 3090에서 '15초에 48분'이 걸리고 조각마다 다시 그려서 쓰지 않았습니다.
5090 실측 속도
한 구간 생성은 보통 구간(6초 안팎)이 약 3분, 긴 대사 구간(10초 안팎)이 약 6.5분이었습니다(영상 나레이션은 2~4분과 5~8분). 참조 그림 5~9장, 앞 클립 이어받기, 대사 가이드 오디오가 붙기 때문에 커뮤니티 숫자보다 느립니다. 198클립 전체의 처음 예측은 6~9시간이었고, 첫 클립 실측을 보고 10~12시간으로 고쳤습니다.
문제 ① 같은 대사를 두 번 말한다
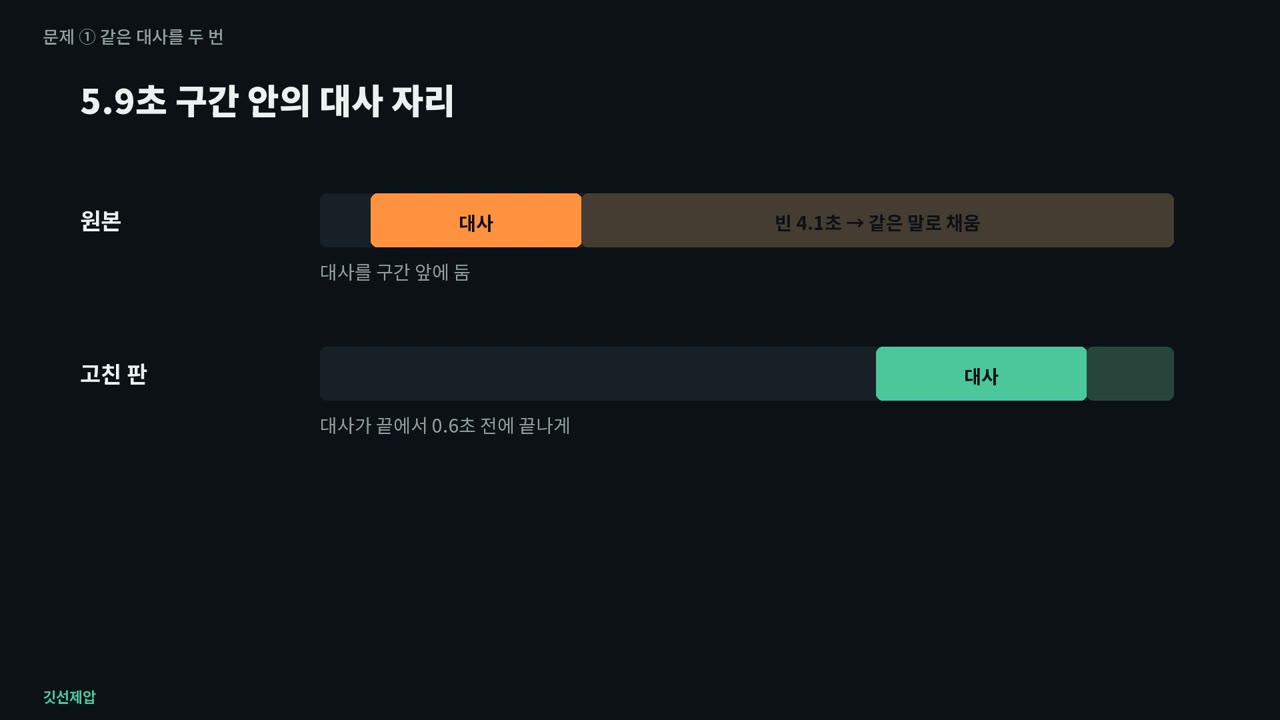
대사는 1.5초인데 구간은 5.9초였고, 남은 4.1초를 H3가 같은 말로 다시 채웠습니다. 프롬프트에 "대사 뒤에 입을 닫는다"를 넣어도 소용없었고, 소리만 가이드로 바꾸면 되풀이 소리는 없어져도 입은 계속 움직였습니다. 해결은 대사 음성을 구간 앞이 아니라 구간 끝에서 0.6초 전에 끝나게 옮기는 것이었습니다. 두 시드 모두 한 번만 말했고, 그 뒤 대사 구간 90개를 받아쓰기(Whisper large-v3)와 소리 비교로 전부 검사해 되풀이는 0이었습니다.
문제 ② ~ ④ 소리와 빈 화면
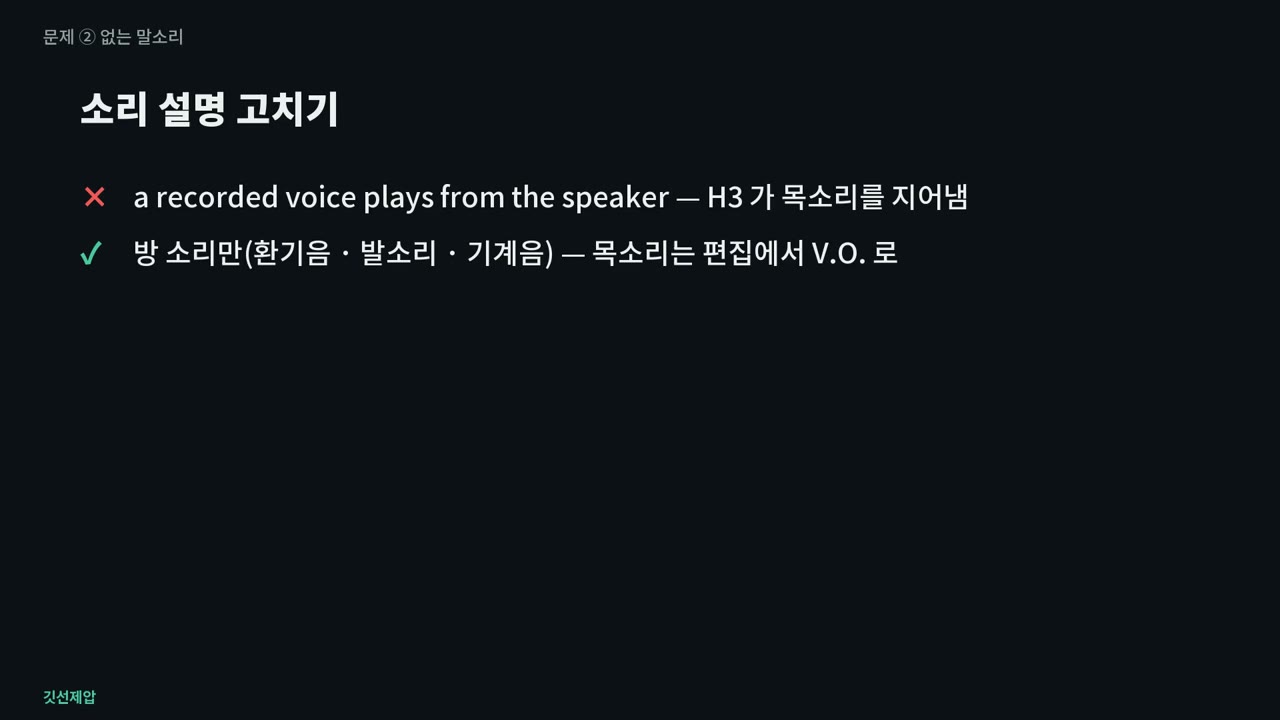
② 대사가 없는 컷에서 러시아어처럼 들리는 말, 뜻 없는 한국어가 섞여 나왔습니다. 소리 설명에 "스피커에서 나오는 녹음된 목소리"라고만 적었더니 H3가 그 목소리를 지어냈습니다. 목소리는 편집에서 얹고 H3에는 환기음, 발소리, 기계음 같은 방 소리만 적는 것이 답입니다.
③ "소리 없이 입술로 따라 읽는다"는 지문은 H3에게 말하는 입이 됩니다. 입을 닫은 동작으로 바꾸자 해결됐습니다.
④ 빈 흰 화면은 H3가 1초 안에 무언가로 채웁니다(빈 흰 기둥 화면에 없던 사람이 나타났습니다). 화면 속 글자와 영상은 생성하지 말고 첫 프레임을 멈춰 쓰고 편집에서 얹습니다.
문제 ⑤ 일곱 명 전경의 자리가 바뀐다
일곱 명이 각자 유리방에 있는 전경에서 컷마다 누가 어느 방인지가 바뀌었고, 자리를 글로 적어도 작은 얼굴 일곱의 순서는 지켜지지 않았습니다. 이미지 모델에게 사람을 제자리에 앉힌 첫 프레임을 그리게 하자 "맨 위 방"을 기둥 꼭대기로 읽어 사람이 방 밖에 서고 옷도 섞였습니다. 결국 사람을 오려 각 방에 좌표로 직접 붙인 이미지를 첫 프레임으로 줬고, 그러자 일곱 컷 모두 끝까지 같은 자리를 지켰습니다. 위치 표현도 주의해야 합니다. "가장 왼쪽 먼 방"은 화면 맨 왼쪽으로 읽히고, "기둥 바로 왼쪽 작은 방"처럼 표지물로 쓰면 맞았습니다.
업스케일과 운영
영상 설명란 챕터가 번호를 붙인 문제는 ①~⑤이고, 이어서 업스케일과 맥 미니·클라우드 운영 문제를 다룹니다(영상 제목은 '문제 7가지'이지만 ⑥·⑦ 번호는 영상에 따로 표시되지 않습니다).
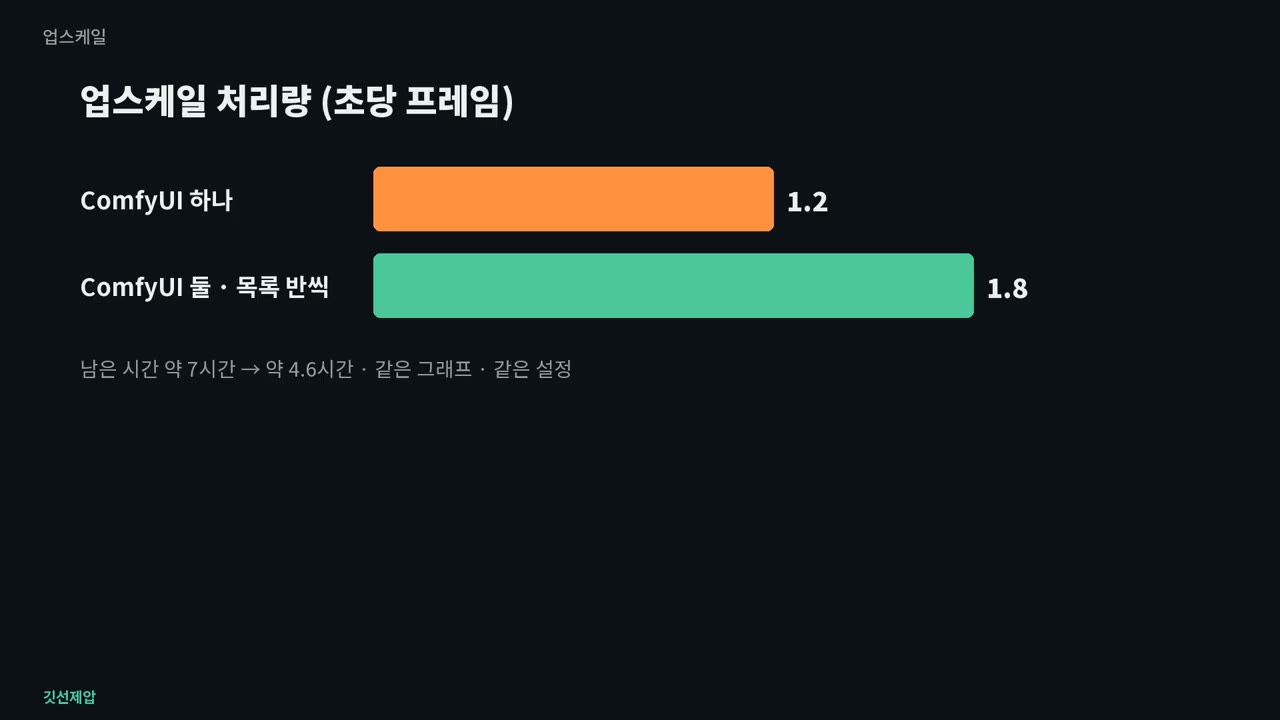
업스케일은 FlashVSR(v1.1 tiny-long) 2배입니다. 입력을 960으로 줄이면 초당 2.7프레임으로 768 입력의 1.2프레임보다 두 배 넘게 빠르지만 얼굴이 조금 달라지고 유리에 없던 선이 더 진하게 생겨 원본 768을 그대로 넣었습니다. 5090 사용률을 4초 간격으로 보니 100%와 0%를 오가며 절반은 놀고 있었는데, 영상을 인코딩하는 동안 GPU가 쉬는 것이었습니다. 서버에 ComfyUI를 하나 더 띄워 목록을 반씩 나눠 돌리자 같은 설정·같은 화질로 초당 1.2에서 1.8프레임, 약 1.5배가 됐고 남은 시간이 약 7시간에서 약 4.6시간으로 줄었습니다.
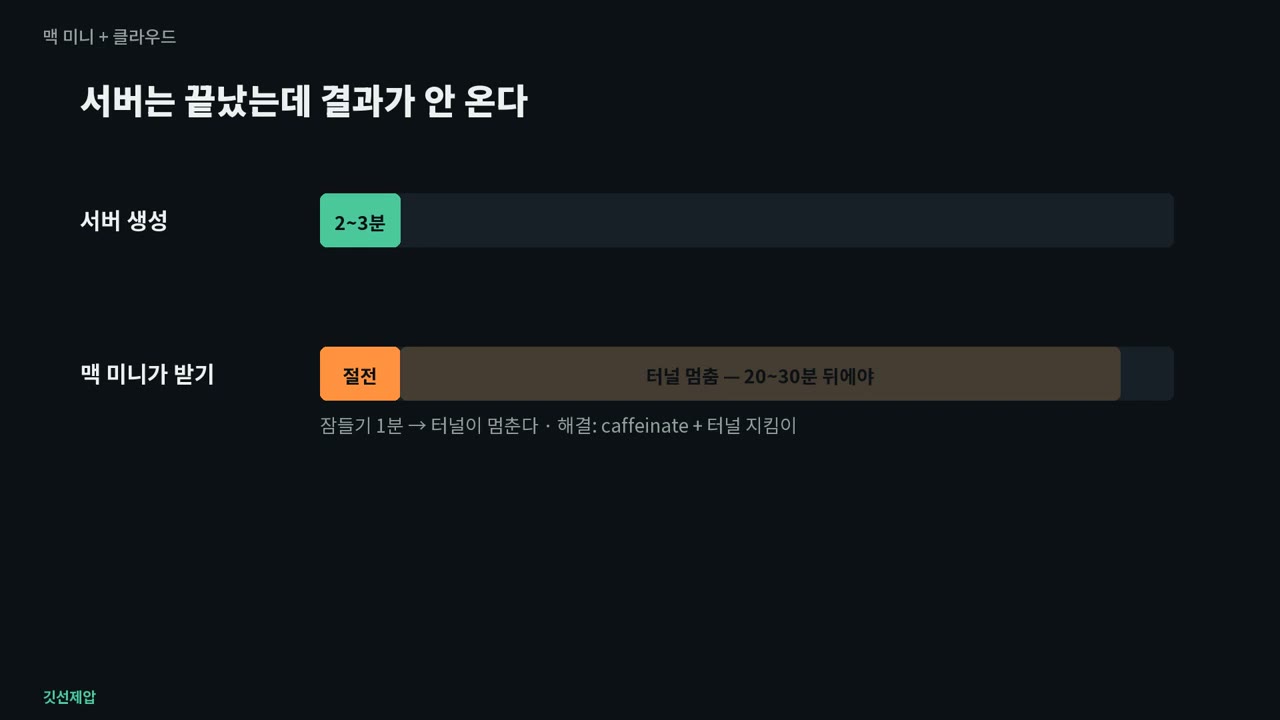
서버 쪽에서는 2~3분이면 끝난 생성 결과가 맥 미니에 20~30분 뒤에야 도착하는 일이 있었습니다. 맥 미니가 1분 만에 잠들면서 서버로 가는 터널이 끊겼고, 그동안 서버는 돈만 쓰며 놀았습니다. 생성 중에는 잠들지 않게 막고(caffeinate) 터널을 지키는 감시를 붙였습니다. 검사 도구는 맥 전용 MLX로 옮겨 대사 한 구간 받아쓰기(Whisper large-v3, 맥 미니 M6)가 CPU faster-whisper 6.2초에서 MLX 0.9초로 빨라졌습니다. 더 빠른 turbo 판(1.2초)은 'PD'를 '피디'로 바꿔 적어 쓰지 않았습니다.
5090보다 낮은 GPU라면(추정)
아래는 직접 재지 않은 추정입니다. 24GB라면 같은 LoRA에서 참조 그림 수를 줄이고 긴 구간은 나누고, 16GB 이하라면 960x544로 생성한 뒤 업스케일하고 여럿 전경은 짧게 가라는 것이 영상의 조언입니다. 어느 카드든 대사 위치, 소리 설명, 화면 글자, 전경 첫 프레임 규칙은 그대로 통합니다.
한계와 기준일
- 속도 옵션 비교는 조합마다 한 판씩이라 오차가 있고, fp16 accumulation의 차이는 오차 범위로 봤습니다.
- 속도와 설정은 RTX 5090 32GB 한 장, ComfyUI 0.37, 「90초」의 참조 그림 5~9장 조건에서 잰 값이라 다른 작업에서는 달라질 수 있습니다.
- VDN, FastH3, 캐시 가속, USDU에 대한 값은 영상 표기를 옮긴 것입니다. VDN의 5090 한 장 비교는 다른 채널 실측이고 FastH3는 공식 문서를 인용했지만, 캐시 가속과 USDU 값은 출처가 영상에 따로 표시되지 않아 직접 잰 것인지 보고를 인용한 것인지 구분할 수 없습니다.
- 낮은 GPU 조언은 추정입니다. 완성된 「90초」는 이 영상에 포함되지 않았습니다.
- 기준일: 2026-09-25 영상 공개. 모델·LoRA 버전과 권장 설정은 그 뒤 바뀌었을 수 있습니다. 실제로 이 영상 공개 이후 채널의 기본 제작 설정은 Turbo LoRA 없이 20스텝으로 바뀌었고, 업스케일은 1344x768 원본을 960x544로 줄인 뒤 2배로 하는 방식이 기본입니다. 이 글의 설정과 판단은 영상 공개일 기준입니다.