Bonsai 2 27B 직접 재 봤다, 6GB로 줄인 27B 맥 미니 M6와 RTX 3090 실측
올린 날 영상 공개
6GB로 줄인 Bonsai 2 27B를 맥 미니 M6와 RTX 3090에서 원본 Qwen3.8 27B와 비교했습니다. 속도는 1.8~2.3배인데 답까지 시간은 20%만 줄고 한국어 낱말은 무너졌습니다.
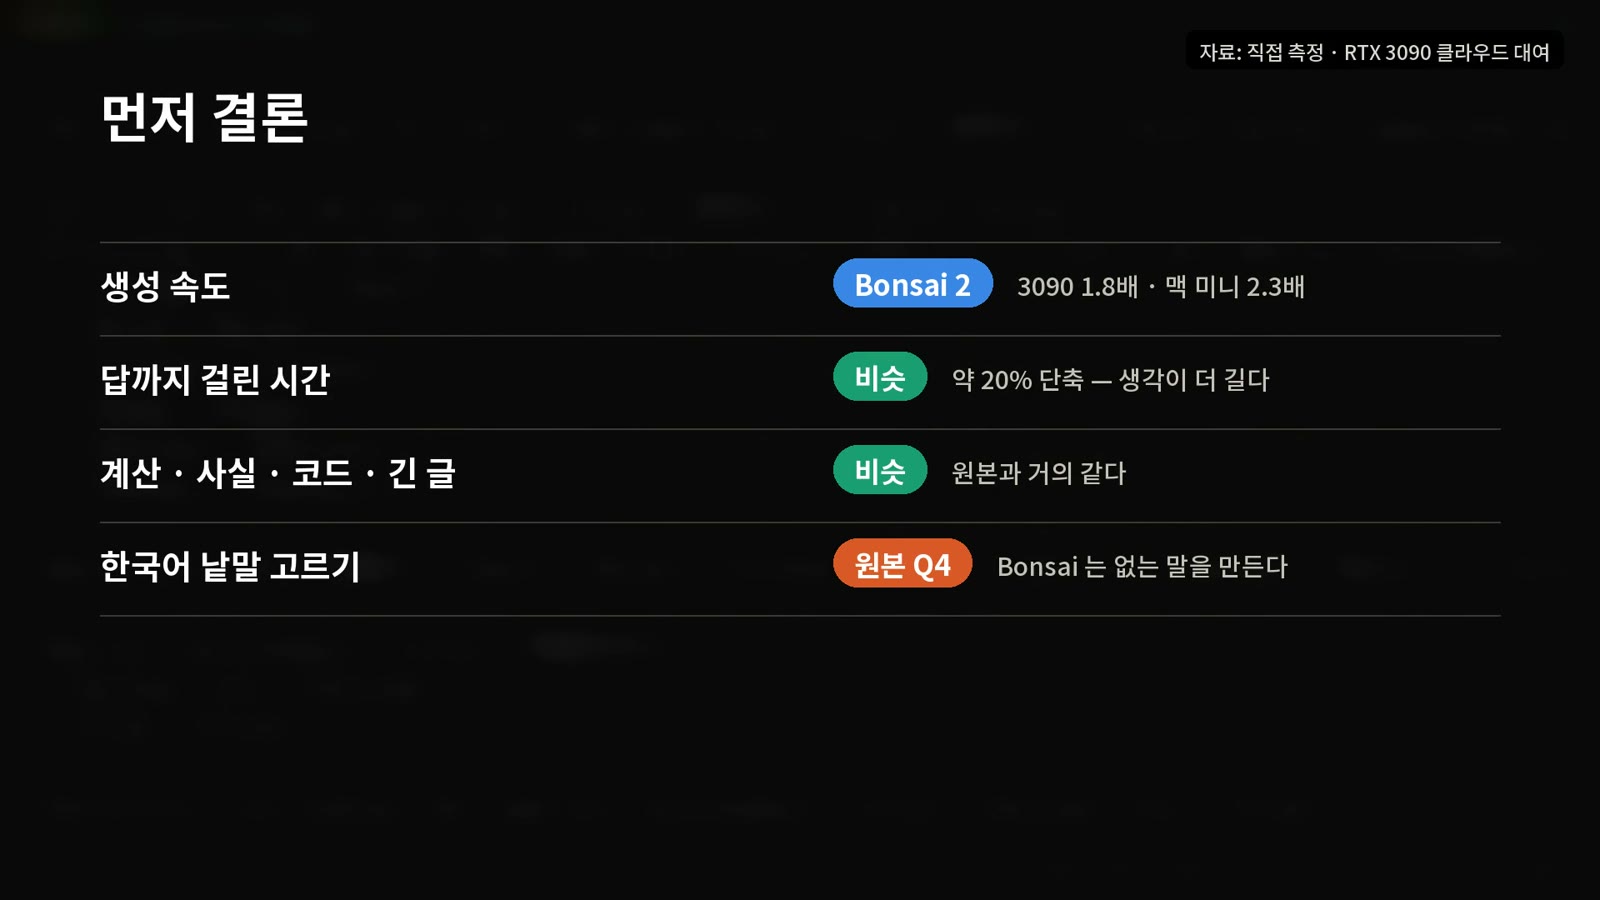
27B 모델을 6GB로 줄였는데도 원본 지능의 98.2%가 남았다는 Bonsai 2 27B를 맥 미니 M6 32GB와 클라우드에서 빌린 RTX 3090에서 원본과 나란히 직접 쟀습니다. 결론은 "속도는 확실히 빠르고, 답까지 걸린 시간은 20%쯤만 줄며, 한국어 낱말 고르기에서는 없는 말을 만든다"입니다. 이 글은 YouTube 영상의 측정을 읽기 쉽게 다시 정리한 것입니다.
결론 먼저
- 생성 속도는 3090에서 1.8배, 맥 미니에서 2.3배 빨랐습니다.
- 그런데 질문을 던지고 답을 받기까지 걸린 시간은 약 20%만 줄었습니다. 생각(추론)을 더 길게 하기 때문입니다.
- 계산, 사실 찾기, 코드, 긴 글 속 정보 찾기는 원본과 거의 같았습니다.
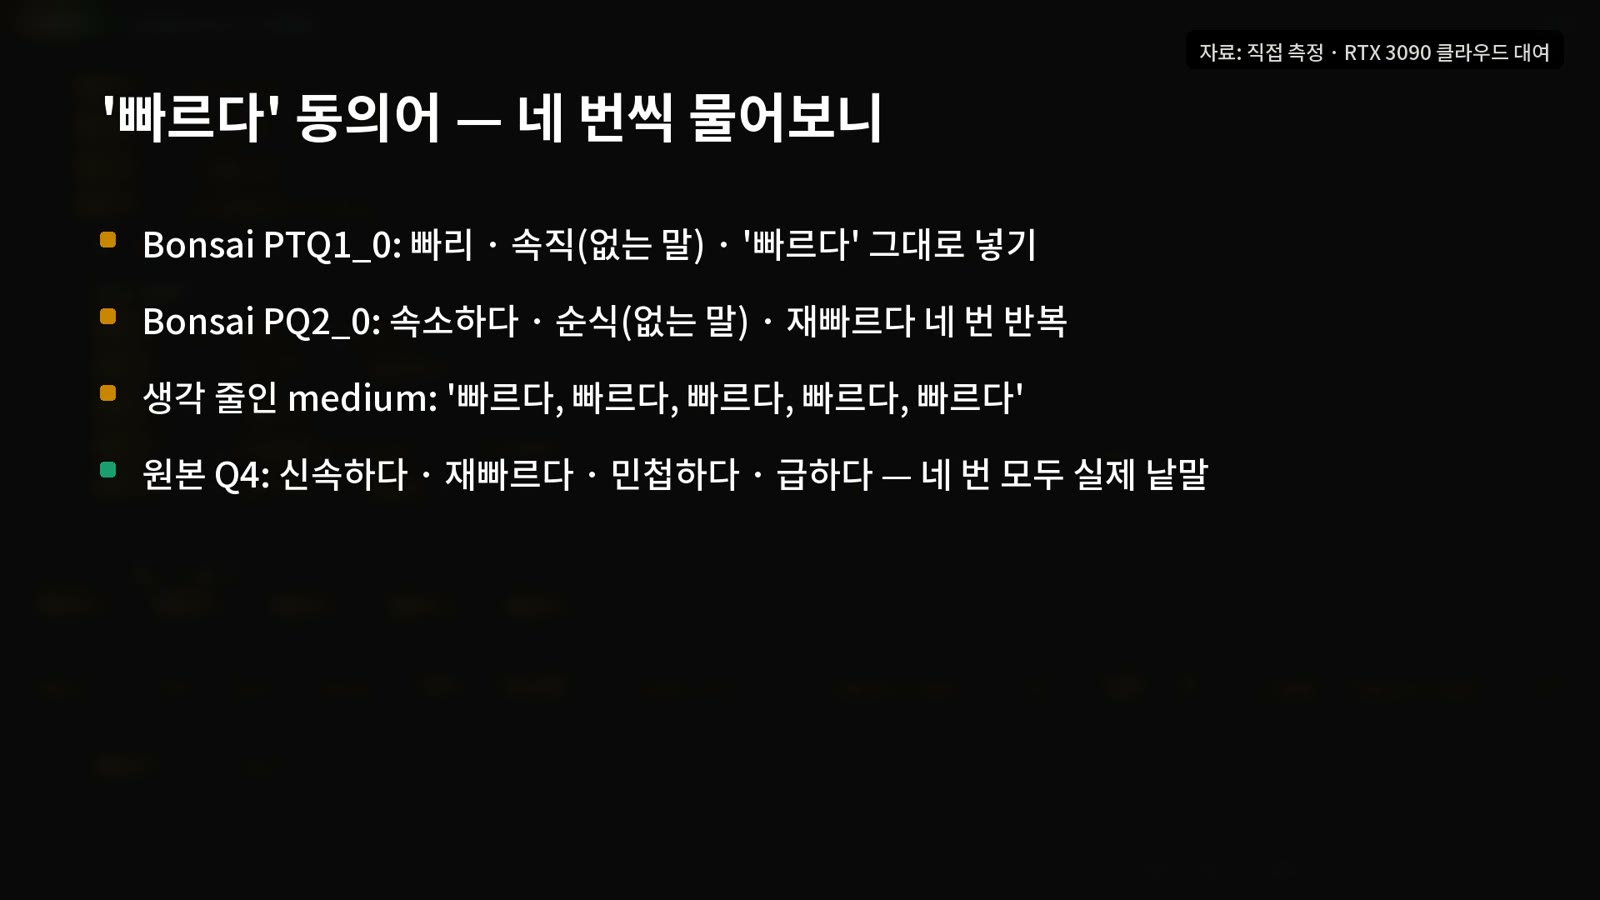
- 한국어 낱말 고르기에서는 '빠리', '속직', '속소하다', '순식' 같은 없는 말이 나왔습니다. 원본은 네 번 모두 실제 낱말이었습니다.
이 글의 숫자는 세 종류입니다
| 표기 | 뜻 |
|---|---|
| 우리 측정 | 맥 미니 M6 32GB와 대여한 RTX 3090 24GB에서 직접 잰 값(2026-09-28) |
| 제작사 발표·타인 보고 | Bonsai 제작사 표(98.2%, M5 Pro·M5 Max 속도), 시청자·커뮤니티가 올린 값 |
| 시청자 제보 | 3090에서 LM Studio로 원본을 돌렸다는 댓글의 값(48.5토큰/초) |
3090은 클라우드에서 한 장을 약 35분 빌렸고 약 $0.20이 들었습니다. 원본과 Bonsai 둘 다 24GB에 올라가 같은 카드에서 바로 비교할 수 있었습니다.
Bonsai 2 27B는 무엇인가
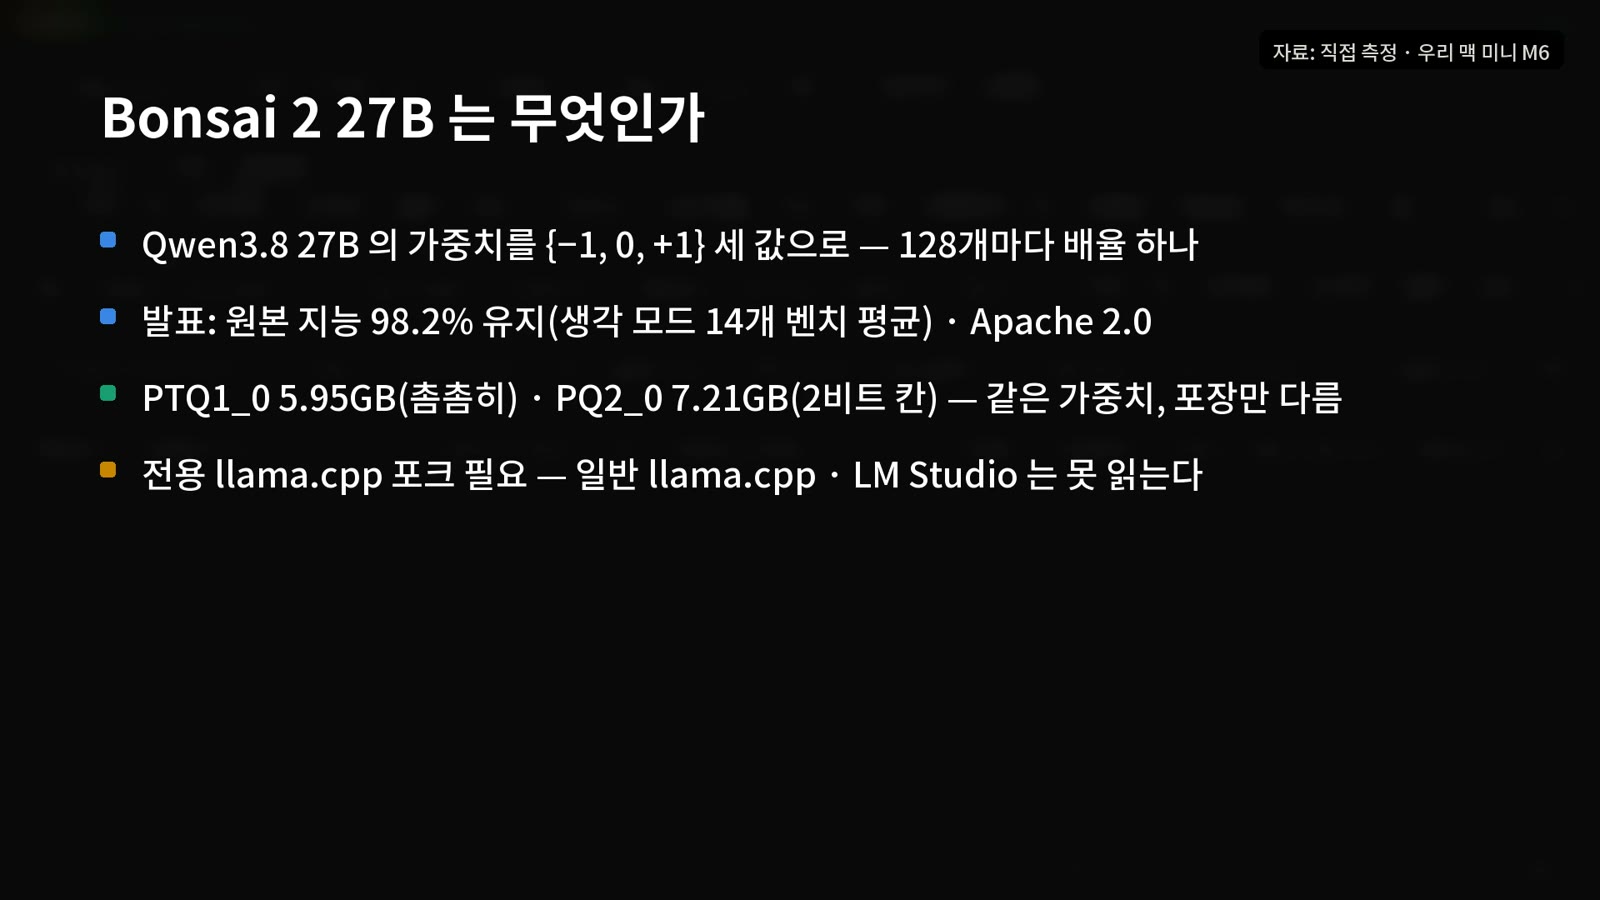
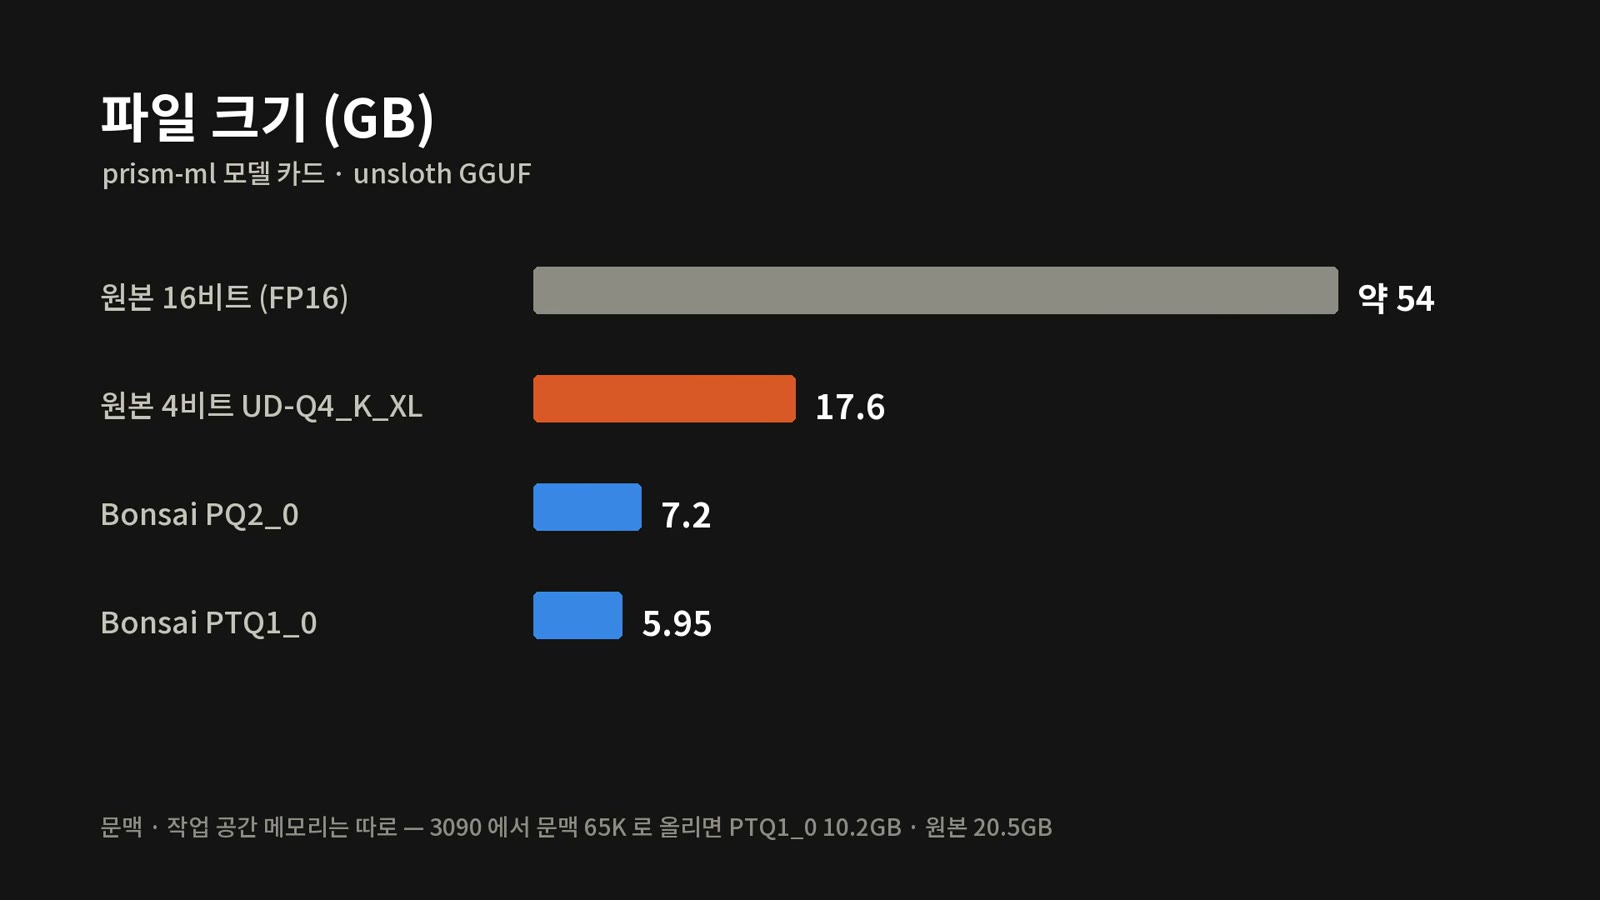
Bonsai 2는 Qwen3.8 27B의 가중치를 -1, 0, +1 세 값으로만 바꾼 모델입니다(128개마다 배율 하나). 제작사 발표로는 14개 벤치마크(생각 모드) 평균에서 원본 지능의 98.2%를 유지하고 라이선스는 Apache 2.0입니다. 파일은 두 가지입니다. 촘촘히 담은 PTQ1_0(5.95GB)과 2비트 칸에 담은 PQ2_0(7.21GB)으로, 안의 가중치는 같고 포장만 다릅니다.
원본 16비트는 약 54GB, 흔히 쓰는 4비트(UD-Q4_K_XL)는 17.6GB이니 크기만 보면 원본 4비트의 3분의 1 수준입니다. 그래서 12GB 그래픽카드나 16GB 맥에도 27B가 올라갑니다. 다만 전용 llama.cpp 포크가 필요하고, 일반 llama.cpp나 LM Studio로는 읽히지 않습니다.
측정 조건은 전용 포크 prism-b10743, 문맥 65,536, temperature 1.0, top_p 0.95, top_k 20, min_p 0.05, 출력 한도 16,384, 생각 강도는 기본값(xhigh)이고 두 모델에 같은 조건을 줬습니다.
속도: 3090과 맥 미니 M6
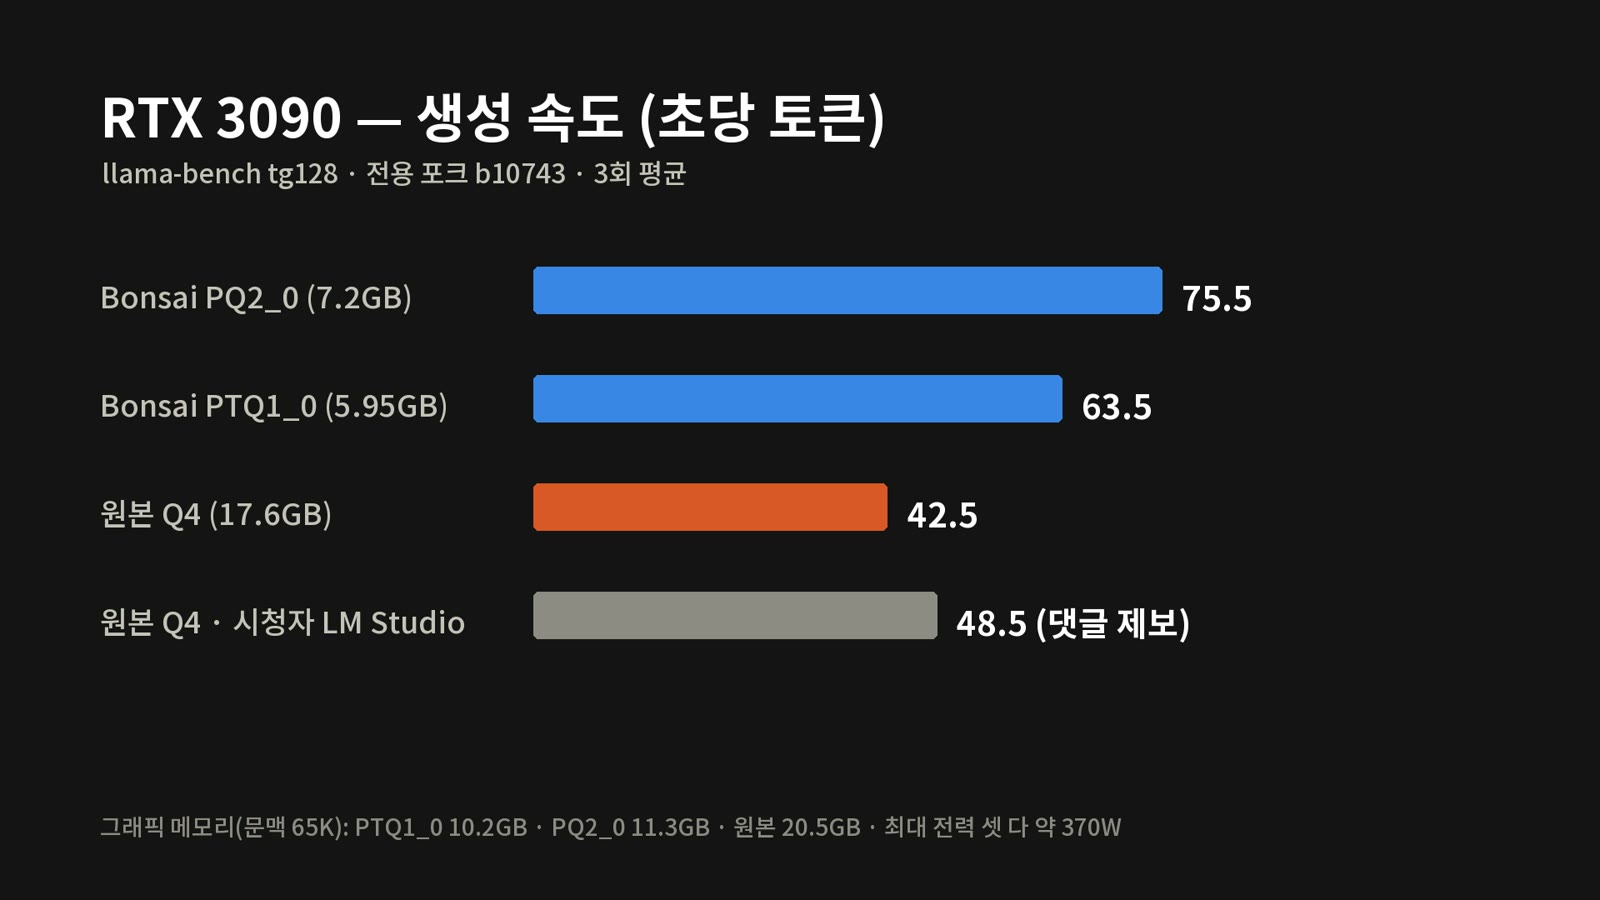
표준 측정 도구(llama-bench)로 글자를 128개 만드는 속도(tg128, 3회 평균)를 쟀습니다.
| 기기 | 모델 | 크기 | 초당 토큰 |
|---|---|---|---|
| RTX 3090 | Bonsai PQ2_0 | 7.21GB | 75.5 |
| RTX 3090 | Bonsai PTQ1_0 | 5.95GB | 63.5 |
| RTX 3090 | 원본 4비트 | 17.56GB | 42.5 |
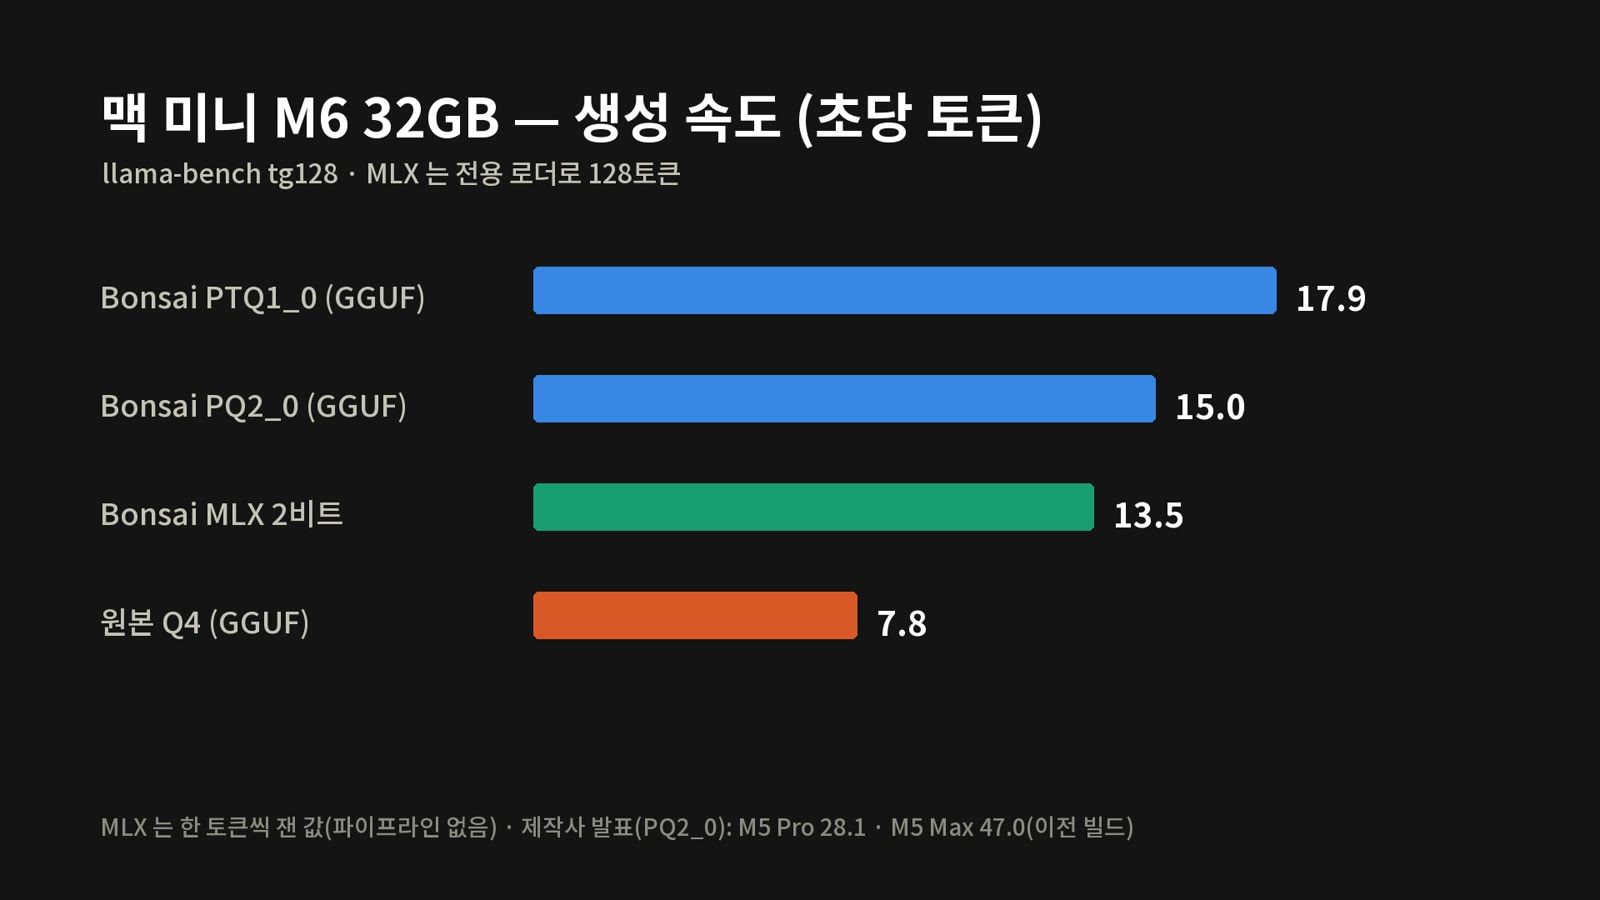
| 맥 미니 M6 32GB | Bonsai PTQ1_0 | 5.95GB | 17.9 |
| 맥 미니 M6 32GB | Bonsai PQ2_0 | 7.21GB | 15.0 |
| 맥 미니 M6 32GB | Bonsai MLX 2비트(전용 로더) | 8.6GB | 13.5 |
| 맥 미니 M6 32GB | 원본 4비트 | 17.56GB | 7.8 |
3090에서는 더 큰 PQ2가 가장 빨랐고(제작사 표에서도 같은 세대인 A100은 PQ2가 빨랐습니다), 맥에서는 오히려 작은 PTQ1이 PQ2보다 빨랐습니다. 3090의 그래픽 메모리는 문맥 65K 기준 원본 20.5GB, Bonsai 10GB 남짓(PTQ1 10.2GB, PQ2 11.3GB)이었습니다. 3090에서 LM Studio로 원본을 돌린다는 시청자는 48.5토큰/초를 알려 주셨는데, 우리 설정에서는 42.5였습니다(시청자 제보와 우리 측정은 설정이 다릅니다). MLX 값은 한 토큰씩 재는 방식이라 다른 방식보다 낮게 나올 수 있습니다. 제작사 발표 속도는 M5 Pro 28.1, M5 Max 47토큰/초(PQ2_0 기준, 영상 카드에는 '이전 빌드'라고 적힘)이고, 영상이 찾아본 곳에는 M6 실측이 아직 없었습니다.
함정: 빨라도 답까지 시간은 20%만 줄었습니다
이 모델은 답하기 전에 생각을 먼저 합니다. 광역시 여섯 곳을 물었을 때 Bonsai는 울산을 특별자치시로 잘못 알고 서울을 빼면 여섯이 안 된다며 한참 고민해 1,103토큰을 생각하고 19초 만에 답했습니다. 같은 질문에 원본은 176토큰만 생각하고 5초 만에 답했습니다.
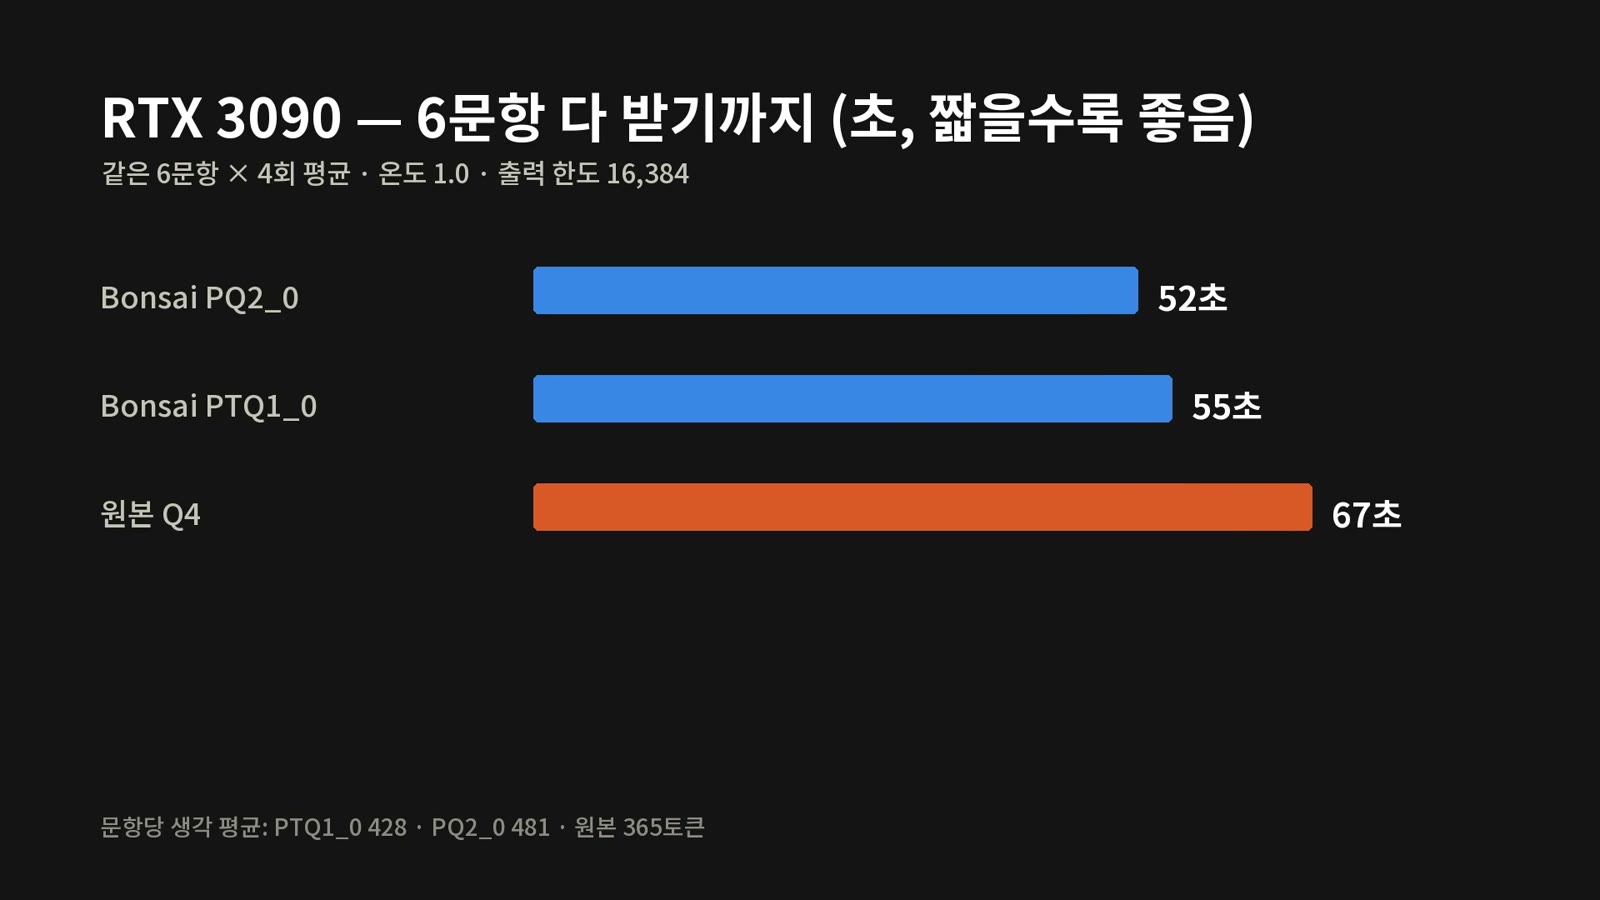
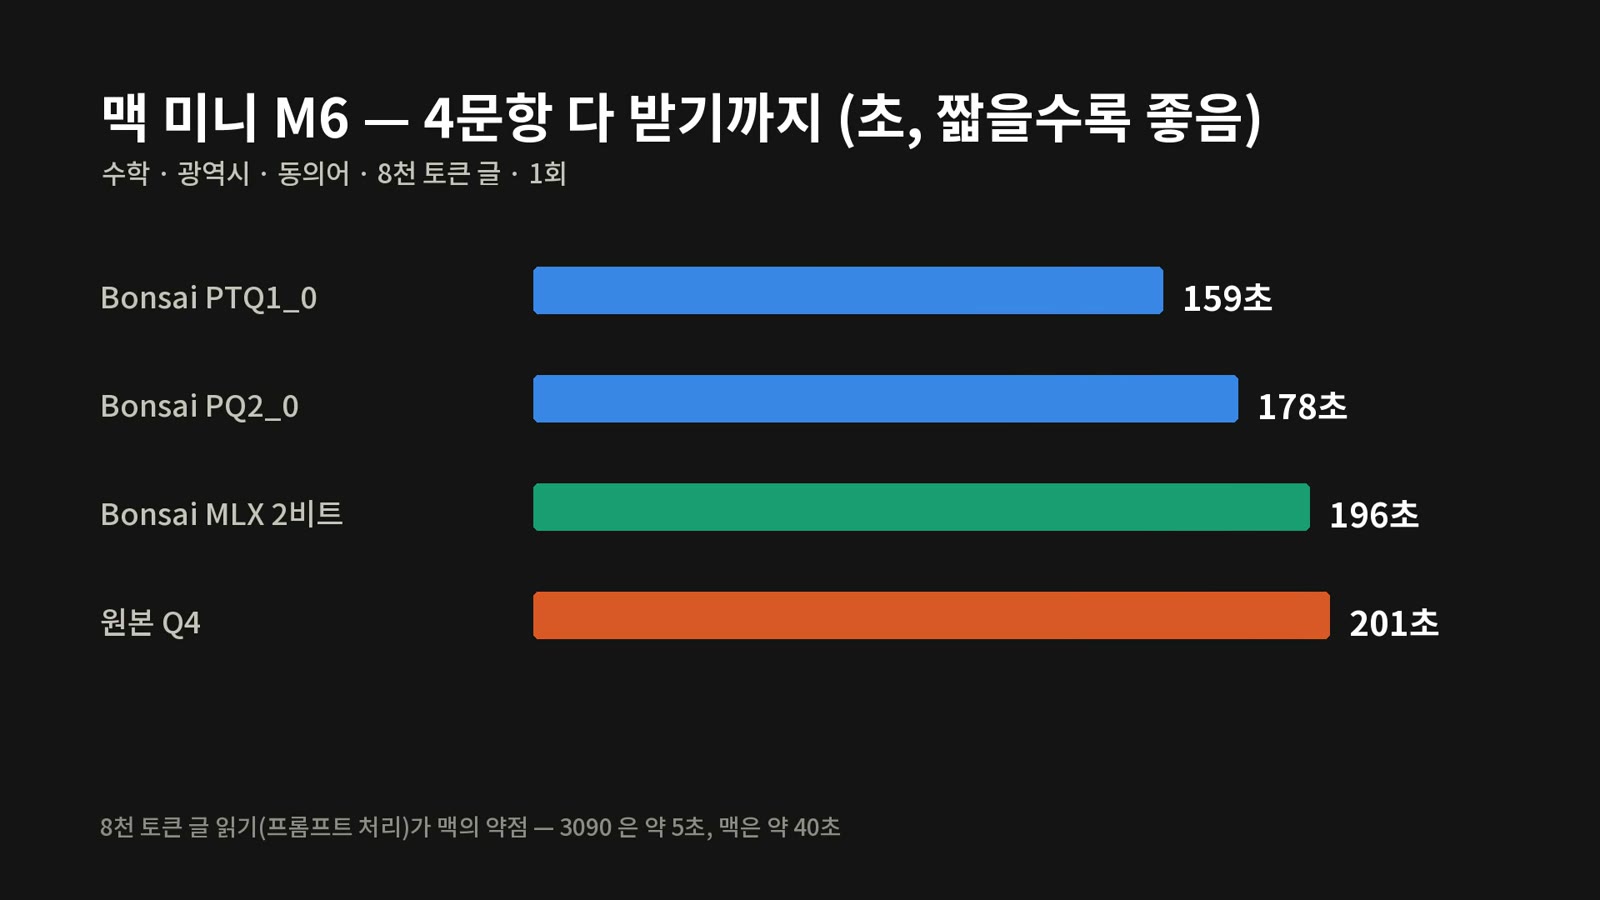
6문항을 네 번씩 돌려 3090에서 모든 문항에 답을 받기까지 걸린 시간의 평균은 Bonsai PQ2 52초, PTQ1 55초, 원본 67초였습니다. 문항당 생각 토큰은 평균 PTQ1 428, PQ2 481, 원본 365였습니다. 속도는 1.5~1.8배인데 기다린 시간은 약 20%만 줄었습니다. 맥 미니도 4문항에 Bonsai PTQ1 159초, 원본 201초로 2.3배 빠른 속도가 약 21% 단축으로 이어졌고, 8천 토큰 글을 읽는 데만 두 모델 다 40초 가까이 걸렸습니다(맥의 약점). 커뮤니티에서 불만이 많던 "생각만 하다 빈 답"은 이번 측정에서 한 번도 없었고, 가장 길게 생각한 것이 2,130토큰이었습니다. 출력 한도를 16,384로 넉넉히 준 덕으로 보입니다. 생각 강도를 낮춘 medium 설정은 PQ2에서 생각이 22% 줄었고 PTQ1에서는 거의 그대로(428 → 418)였습니다.
정확도: 어디서 맞고 어디서 무너졌나
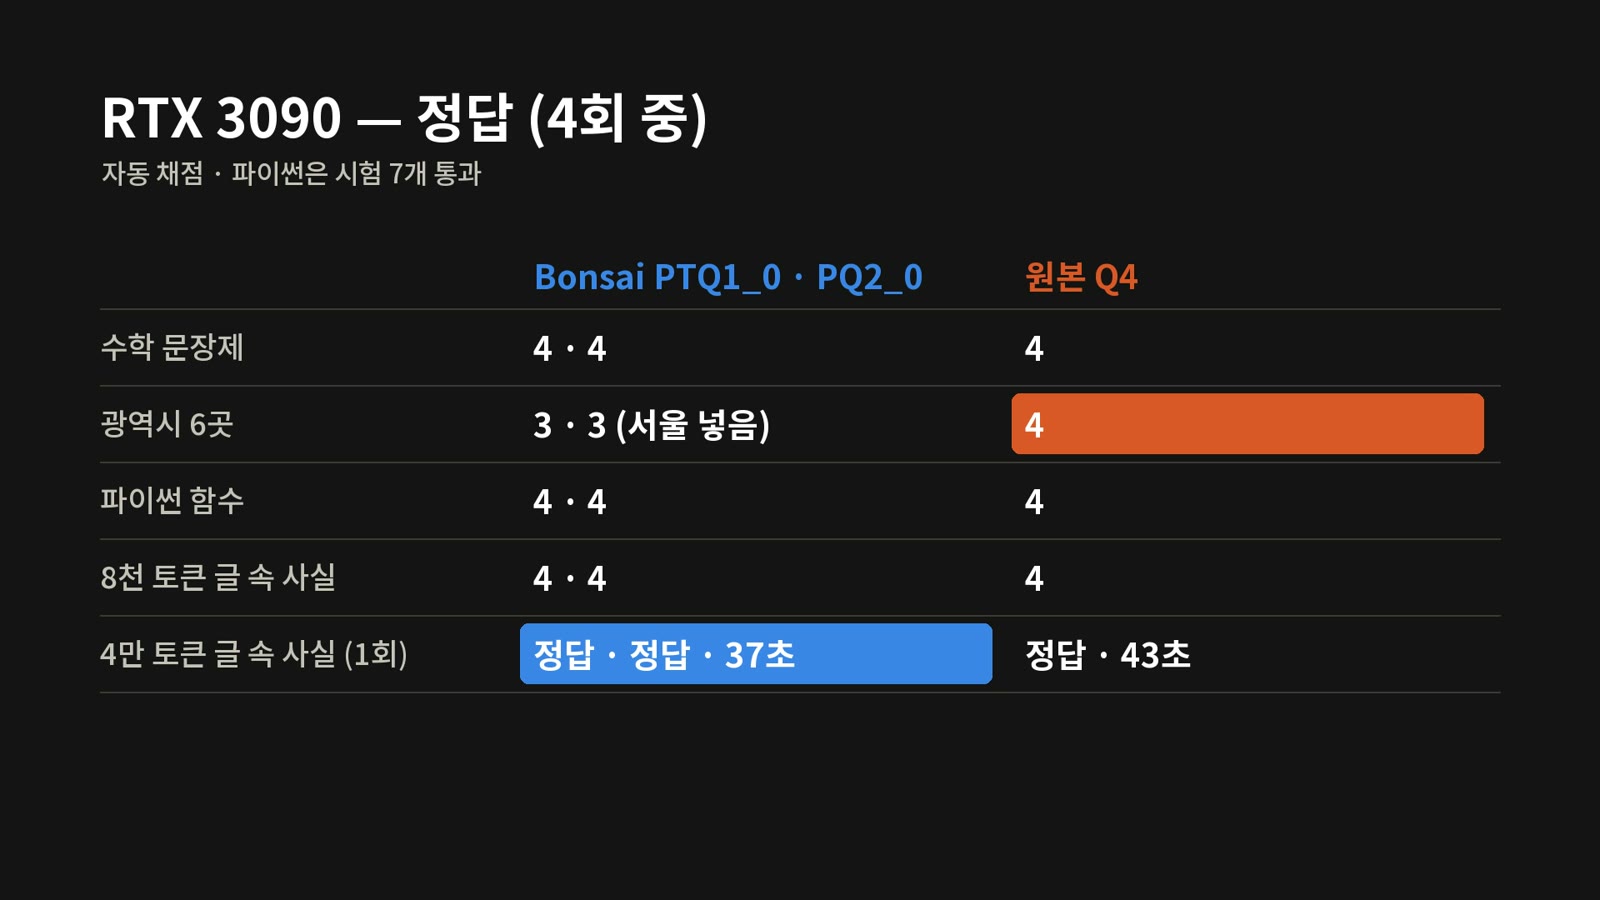
3090에서 네 번 돌린 자동 채점 결과입니다. 수학 문장제, 파이썬 함수(테스트 7개), 8천 토큰 글 속 사실 찾기는 Bonsai와 원본 모두 4/4였습니다. 광역시 6곳은 Bonsai가 3/4로, 네 번 중 한 번은 서울을 넣고 울산이나 인천을 뺐습니다(원본 4/4). 4만 토큰짜리 업무 일지 한가운데 숨긴 비밀번호는 Bonsai 둘 다 37초, 원본 43초로 모두 맞혔습니다(1회).
무너진 곳은 '빠르다'와 뜻이 비슷한 낱말 다섯 개를 묻는 문제였습니다. Bonsai PTQ1은 생각 끝에 '빨리'로 정해 놓고 정작 답에는 없는 말 '빠리'를 적었고, '빠름', '빠른'처럼 모양만 바꾼 것도 섞었습니다. 네 번 물으니 Bonsai에서 속직, 속소하다, 순식 같은 말이 나왔고, 생각을 줄인 medium 설정에서는 '빠르다'만 다섯 번 썼습니다. 원본은 네 번 모두 신속하다, 재빠르다, 민첩하다 같은 실제 낱말이었습니다. 맥 미니에서 한 번 돌린 MLX 2비트 판은 광역시에 성남을 넣었습니다. 3진 압축이 계산과 사실 찾기는 지켰지만 드물게 쓰는 한국어 지식과 낱말 감각은 깎인 것으로 보입니다.
영상이 모은 커뮤니티 반응도 같은 방향입니다. 98.2%라는 발표와 달리 원본과 첫 낱말이 같은 비율은 77.8%(4비트는 96.9%)였다는 측정, 생각이 너무 길다는 불만, 일본어 25문항을 다 맞혔다는 보고, 어색한 한국어 낱말만 빼면 잘한다는 평가가 소개됐습니다(타인 보고).
영상의 판정과 쓰기 전 주의
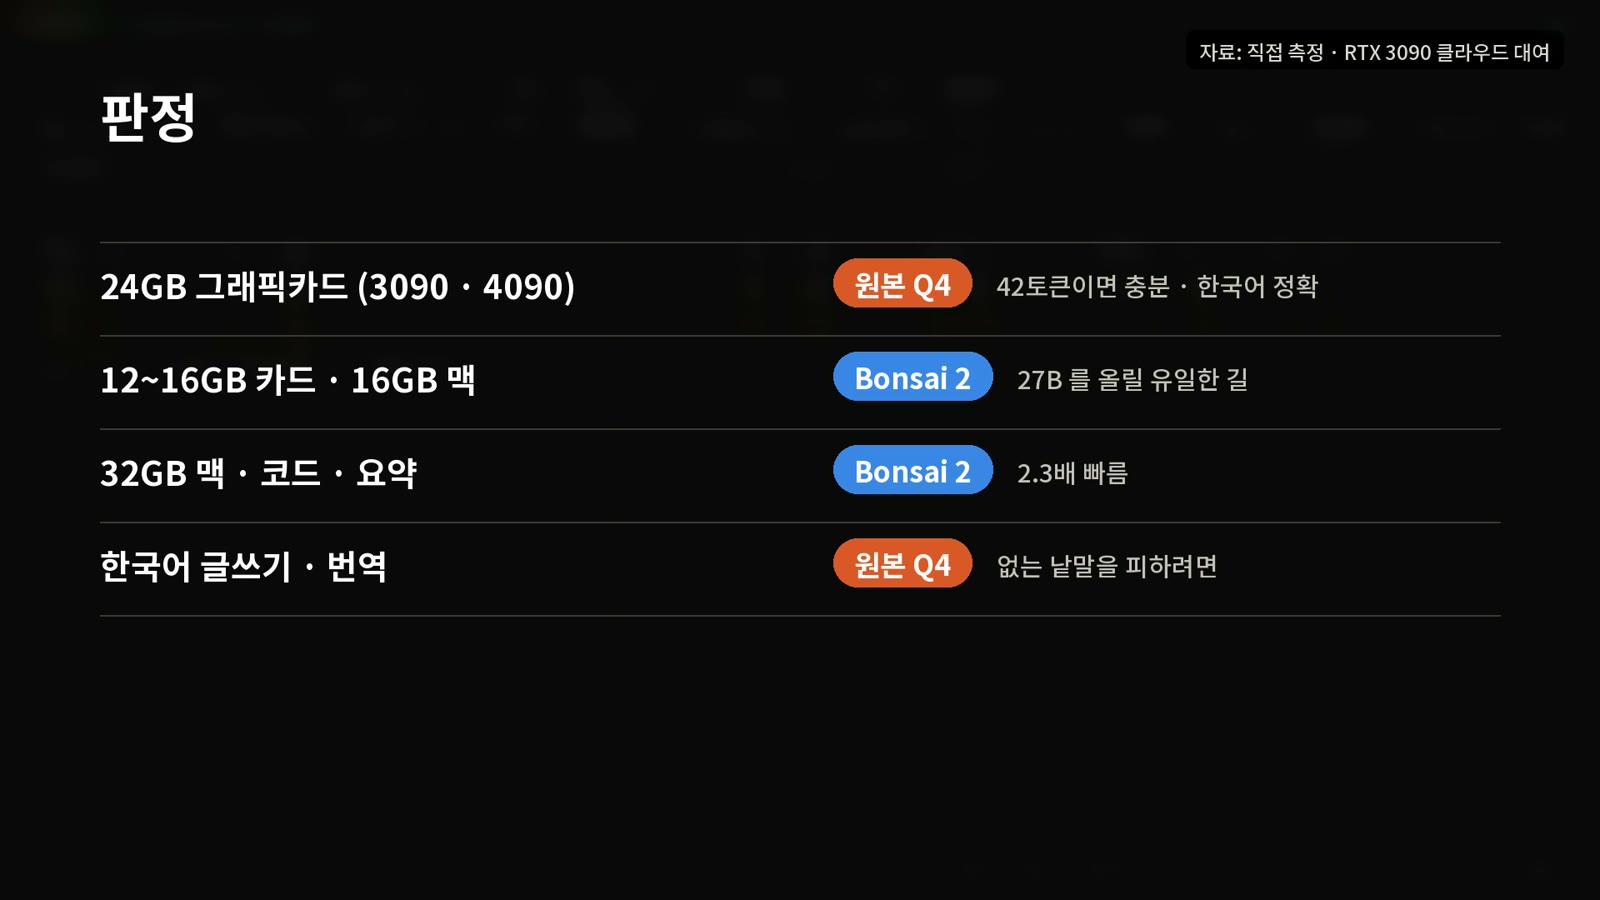
- 24GB 그래픽카드(3090·4090)라면 원본 4비트: 42토큰/초면 충분하고 한국어가 정확합니다.
- 12~16GB 카드나 16GB 맥이라면 Bonsai가 27B를 돌리는 유일한 길입니다.
- 32GB 맥에서 코드나 요약이면 Bonsai, 한국어 글쓰기와 번역이면 원본을 권했습니다.
- 쓰기 전에: 전용 llama.cpp 포크가 필요하고, 출력 한도는 16,384 이상으로 넉넉히 주며, 3090에서는 PQ2, 맥에서는 PTQ1이 더 빨랐습니다.
한계와 기준일
- 3090은 한 장에서 6문항×4회, 맥 미니는 4문항 1회라 표본이 작습니다. 한국어 낱말 문제도 몇 개뿐입니다.
- 속도는 한 가지 전용 포크 빌드(prism-b10743) 기준이고, 다른 도구나 앞으로의 업데이트로 달라질 수 있습니다.
- M5 Pro·M5 Max 속도와 98.2%는 제작사 발표이며 우리가 재지 않았습니다.
- 기준일: 측정 2026-09-28, 영상 공개 2026-09-29. 이 글은 구매를 권유하는 글이 아닙니다.