RTX Spark 대 지포스 노트북 대 맥 M5 Max, 출시 직후 공개 측정·후기 정리
올린 날 영상 공개
RTX Spark 출시 직후, 24GB 안이면 5090 노트북이 2.3~2.4배, 100B급은 128GB 구성. 타인 보고에 우리 측정·계산을 붙인 조건별 판단 틀(10-19 기준).
RTX Spark 노트북이 막 나온 시점(2026-10-19 기준)에, 램 많은 지포스 노트북과 맥 M5 Max 사이에서 무엇을 고를지 정리한 글입니다. 우리는 RTX Spark를 직접 재지 못했습니다. 그래서 남의 리뷰와 영상의 측정값에 우리가 잰 값과 계산을 붙여, 조건별로 판단하는 틀로 묶었습니다. 승패를 가르는 글이 아닙니다.
결론 먼저: 조건별 판단 틀 세 가지
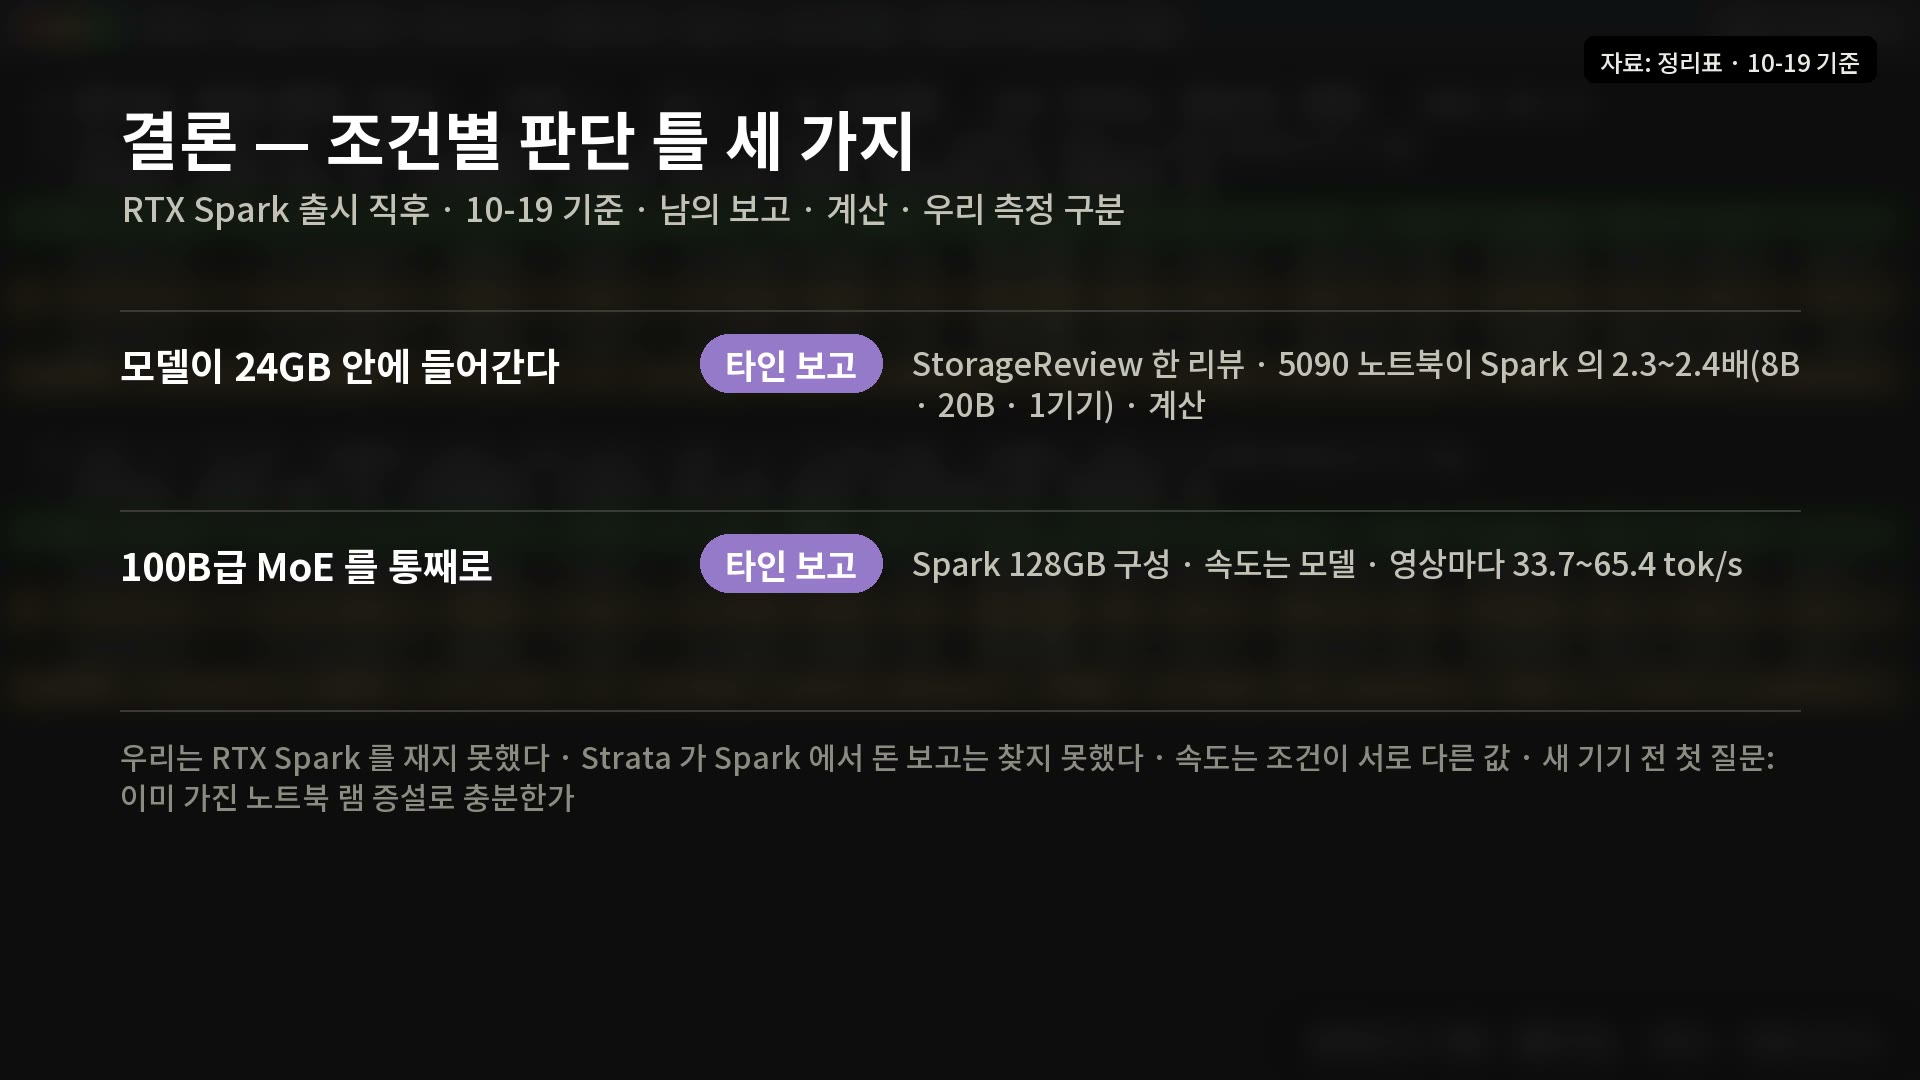
- 모델이 24GB 안에 들어가면 StorageReview 리뷰 한 건에서 5090 노트북이 Spark의 2.3~2.4배였습니다(Llama 8B 128.8 대 56.5, gpt-oss 20B 137.9 대 58.0 tok/s, 한 기기씩).
- 100B급 MoE를 통째로 올려야 하면 Spark 128GB 구성이 선택지입니다. 속도는 모델과 영상마다 33.7~65.4 tok/s로 흩어졌습니다.
- 총 램은 모델이 올라가는 메모리가 아닙니다. HP 128GB 모델은 GPU 몫을 64GB로 설정했고, 쓸 수 있는 양은 62.5GB였습니다.
Strata를 RTX Spark에서 돌렸다는 보고는 찾지 못했고, Reddit 반응도 확인하지 못했습니다.
숫자 종류부터 구분합니다
- 우리 측정: 대여 서버에서 직접 잰 값. 서버마다 CPU·램 한도·전력이 달라 서로 줄 세우지 않습니다.
- 타인 보고: StorageReview, Tom's Hardware, Artificial Analysis, Alex Ziskind·Matthew Moniz 영상 등 남이 잰 값. 소프트웨어·양자화가 다르거나 적혀 있지 않은 경우가 많습니다.
- 공식·문서: NVIDIA 개발자 문서, Strata 문서의 요구 사양.
- 계산·예측: 대역폭을 모델 크기로 나눈 값처럼 측정이 아닌 것. 따로 표시합니다.
RTX Spark는 메모리를 나눠 쓰는 칩입니다
NVIDIA 개발자 문서에는 RTX Spark가 CPU와 GPU가 메모리를 나눠 쓰는 칩이고, 최대 128GB LPDDR5, 256비트, 300GB/s로 적혀 있습니다. 모델이 올라가는지는 모델 파일 크기에 KV 캐시를 더한 값이 GPU가 쓸 수 있는 메모리 안인지로 봅니다.
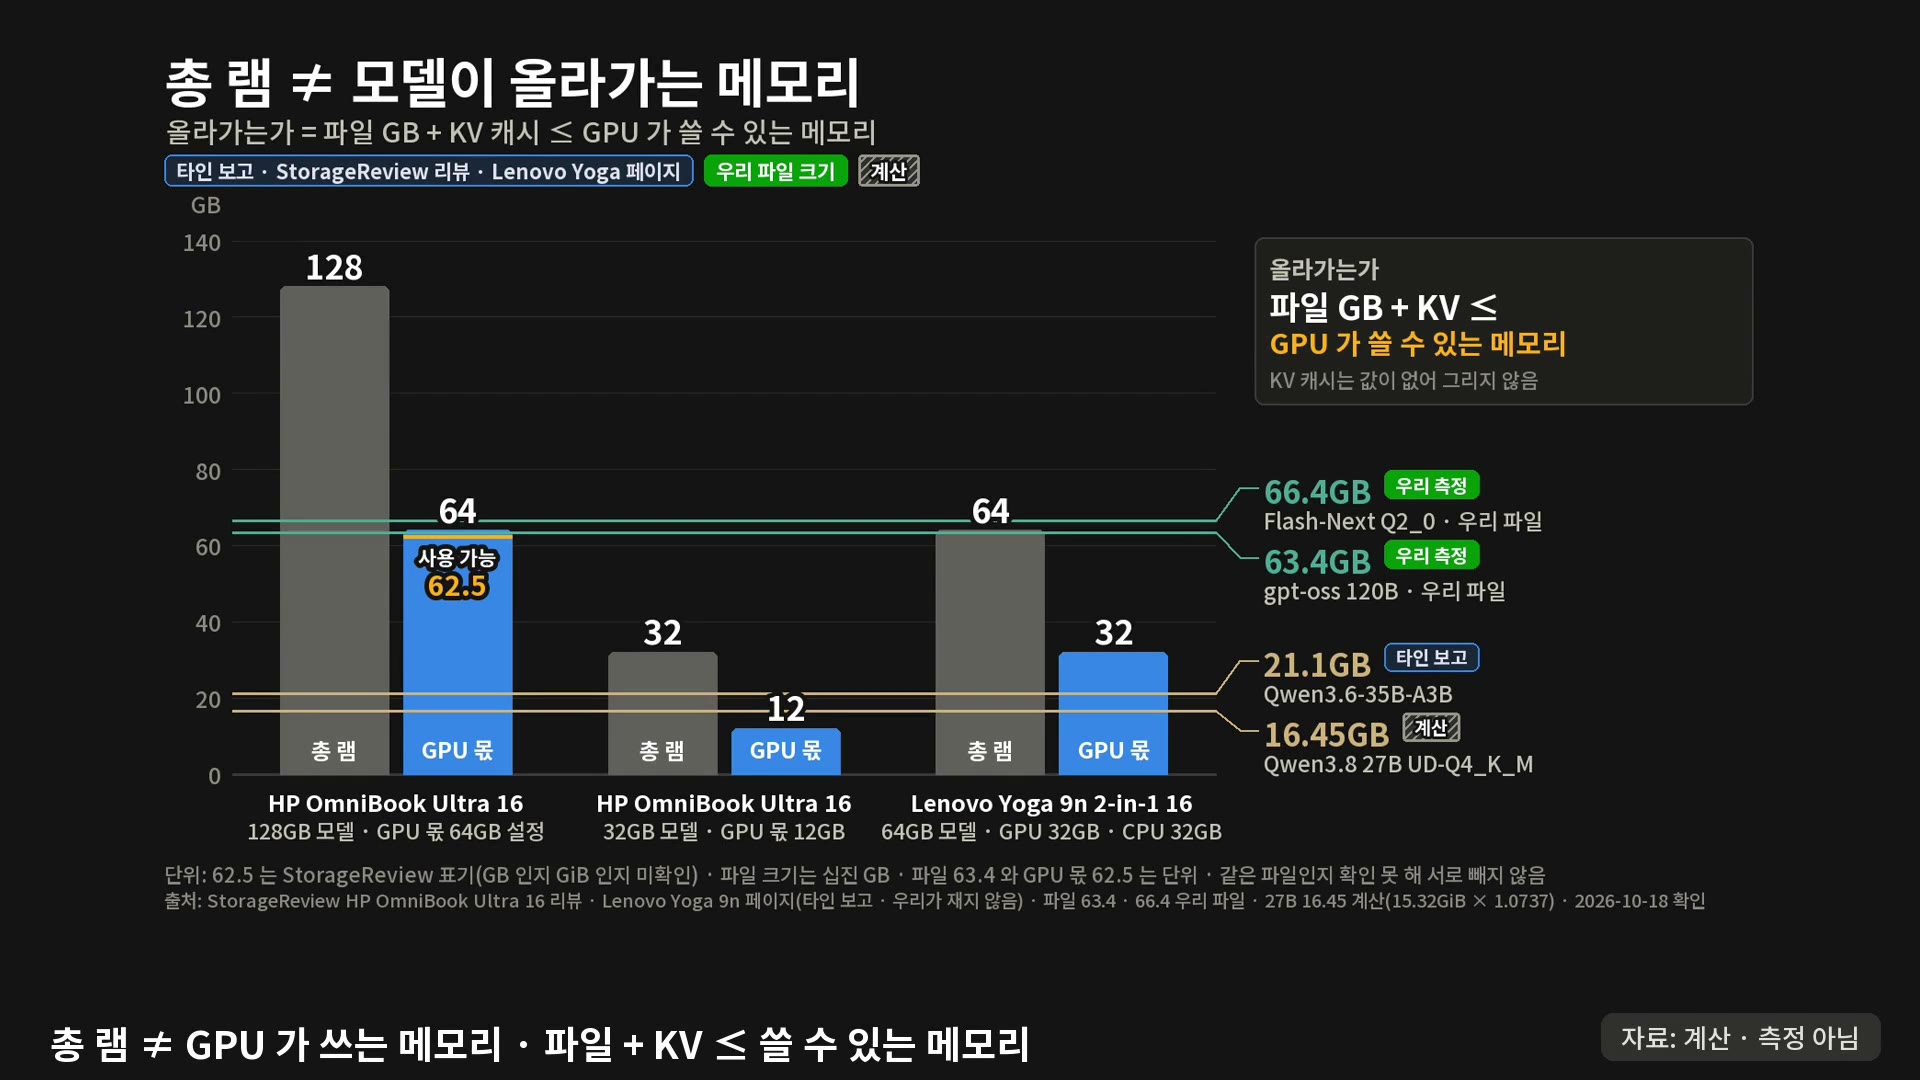
StorageReview의 HP는 GPU 몫을 128GB 모델에서 64GB, 32GB 모델에서 12GB로 설정했고, 이 비율은 NVIDIA 앱에서 조정할 수 있다고 합니다. 그래프의 63.4GB(gpt-oss 120B)와 66.4GB(Flash-Next Q2_0)는 우리가 가진 파일 크기이고, 62.5GB는 StorageReview 표기라 단위(GB인지 GiB인지)가 확인되지 않았습니다. 같은 파일인지 확인하지 못해 서로 빼서 여유를 계산하지 않았습니다.
8B~20B급: 24GB에 들어가면 5090 노트북이 앞섰습니다
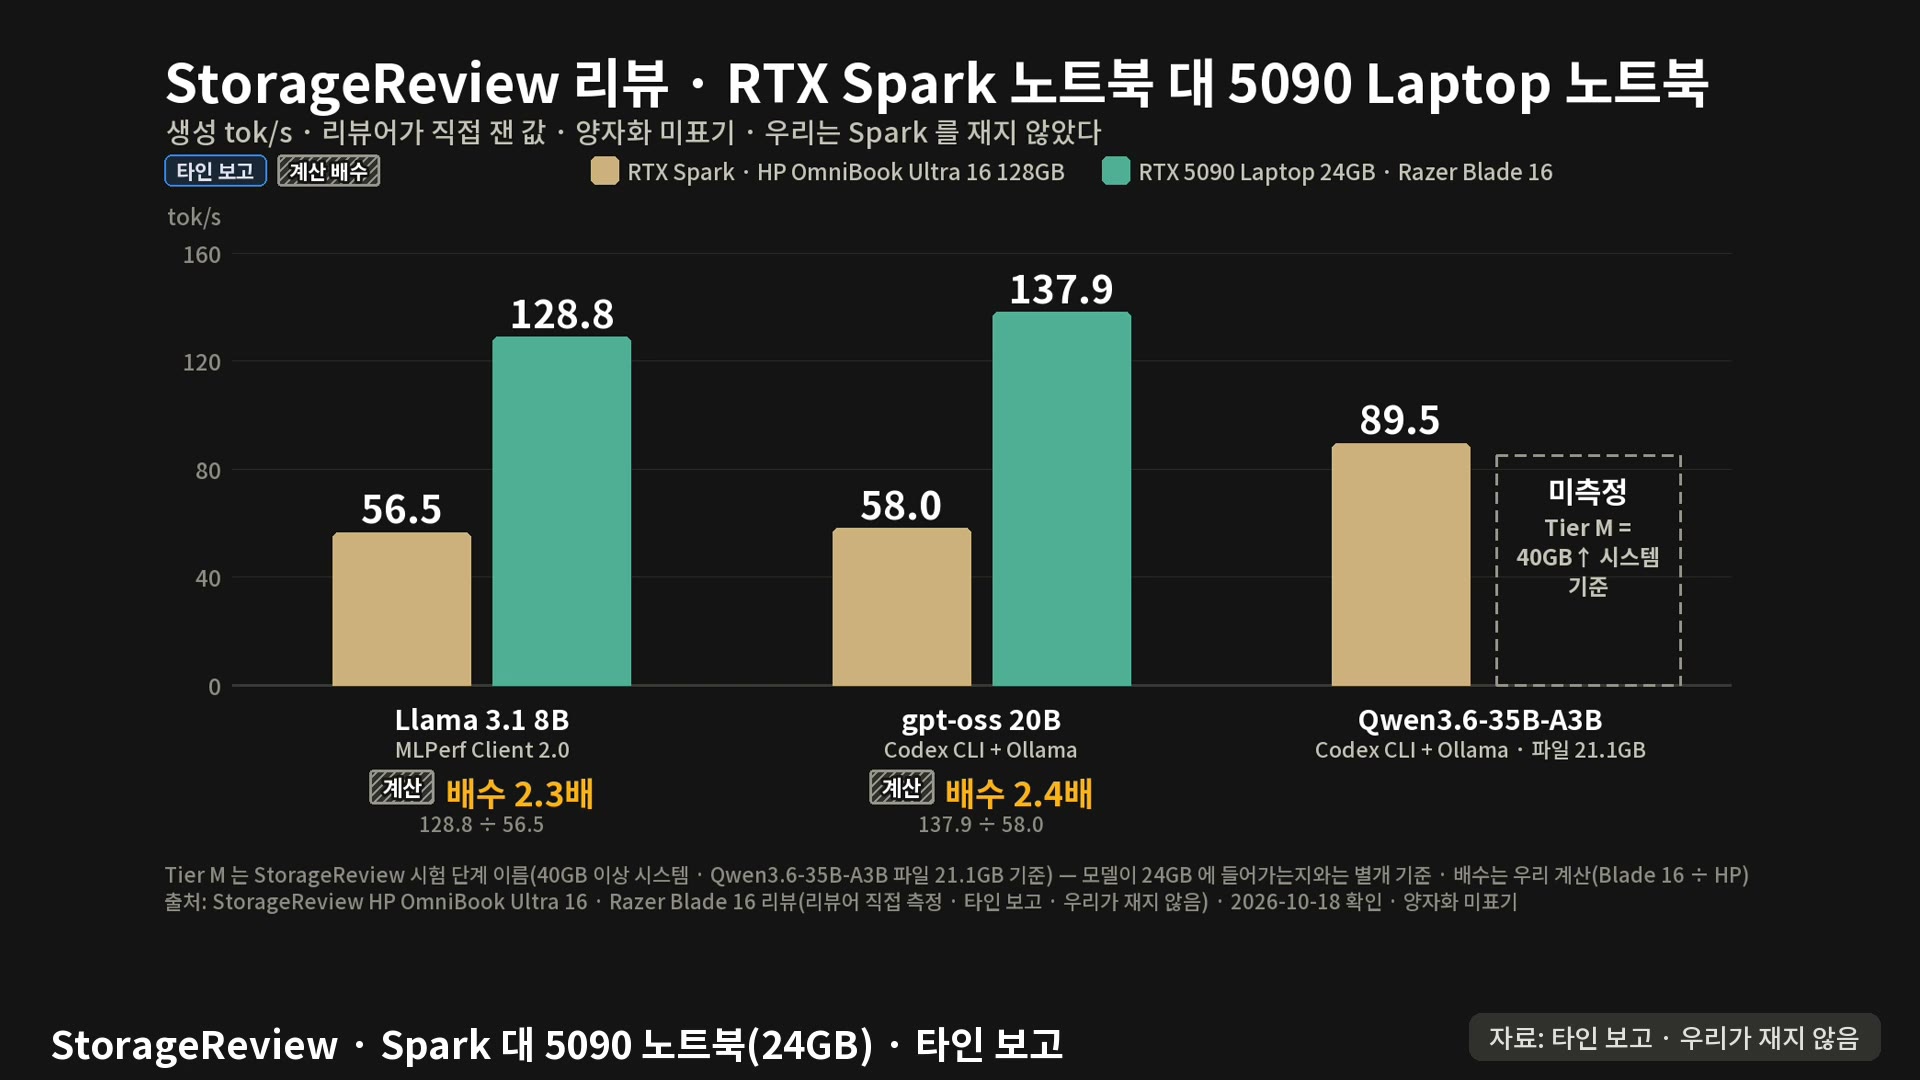
| 모델 | RTX Spark (HP OmniBook Ultra 16 128GB) | RTX 5090 Laptop 24GB (Razer Blade 16) | 배수(우리 계산) |
|---|---|---|---|
| Llama 3.1 8B (MLPerf Client 2.0) | 56.5 | 128.8 | 2.3배 |
| gpt-oss 20B (Codex CLI + Ollama) | 58.0 | 137.9 | 2.4배 |
| Qwen3.6-35B-A3B (파일 21.1GB) | 89.5 | 미측정 | - |
모두 StorageReview 리뷰어가 직접 잰 타인 보고이고 양자화는 적혀 있지 않습니다. 리뷰가 "24GB에 들어가는 것은 2.3배"라고 쓴 문장과 우리 계산 2.3~2.4배가 맞습니다. 35B 모델은 StorageReview의 시험 단계(Tier M)가 40GB 이상 시스템 기준이라 Blade 16에서는 하지 못했습니다. 모델이 24GB에 들어가는지와는 별개의 기준입니다.
27B~35B급: 같은 27B도 13.4에서 26.32까지
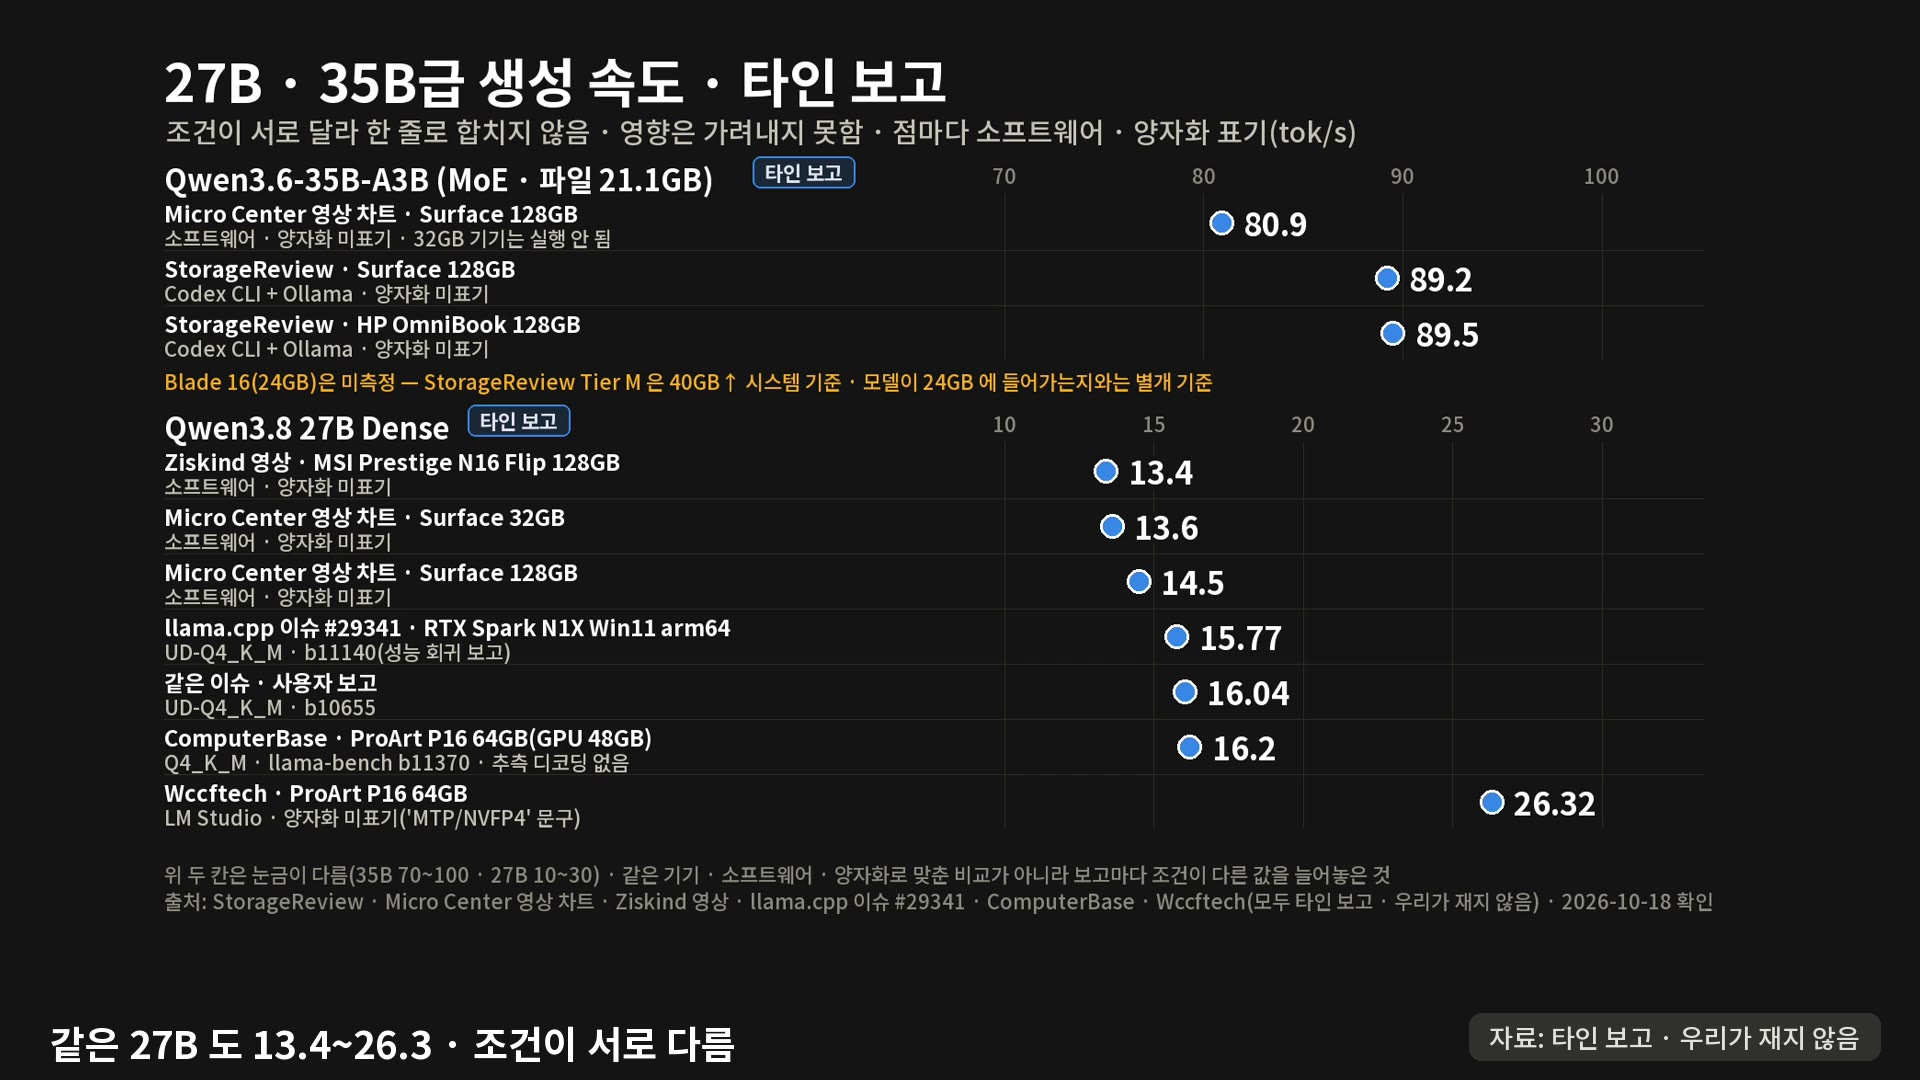
Qwen3.6 35B A3B(MoE)는 HP Spark에서 89.5 tok/s였습니다(StorageReview). 영상 차트에는 Micro Center 80.9도 있는데, 32GB 기기에서는 실행이 안 됐다고 적혀 있었습니다. Qwen 27B Dense는 Ziskind 13.4, Wccftech(LM Studio) 26.32 tok/s로 두 배 가까이 차이가 납니다. 소프트웨어·양자화·MTP 문구가 서로 달라 이 차이의 원인은 가려내지 못했습니다. 이 점도표는 같은 조건의 비교가 아니라 보고마다 조건이 다른 값을 늘어놓은 것입니다.
맥과 견준 보고: 방향이 시험마다 갈립니다
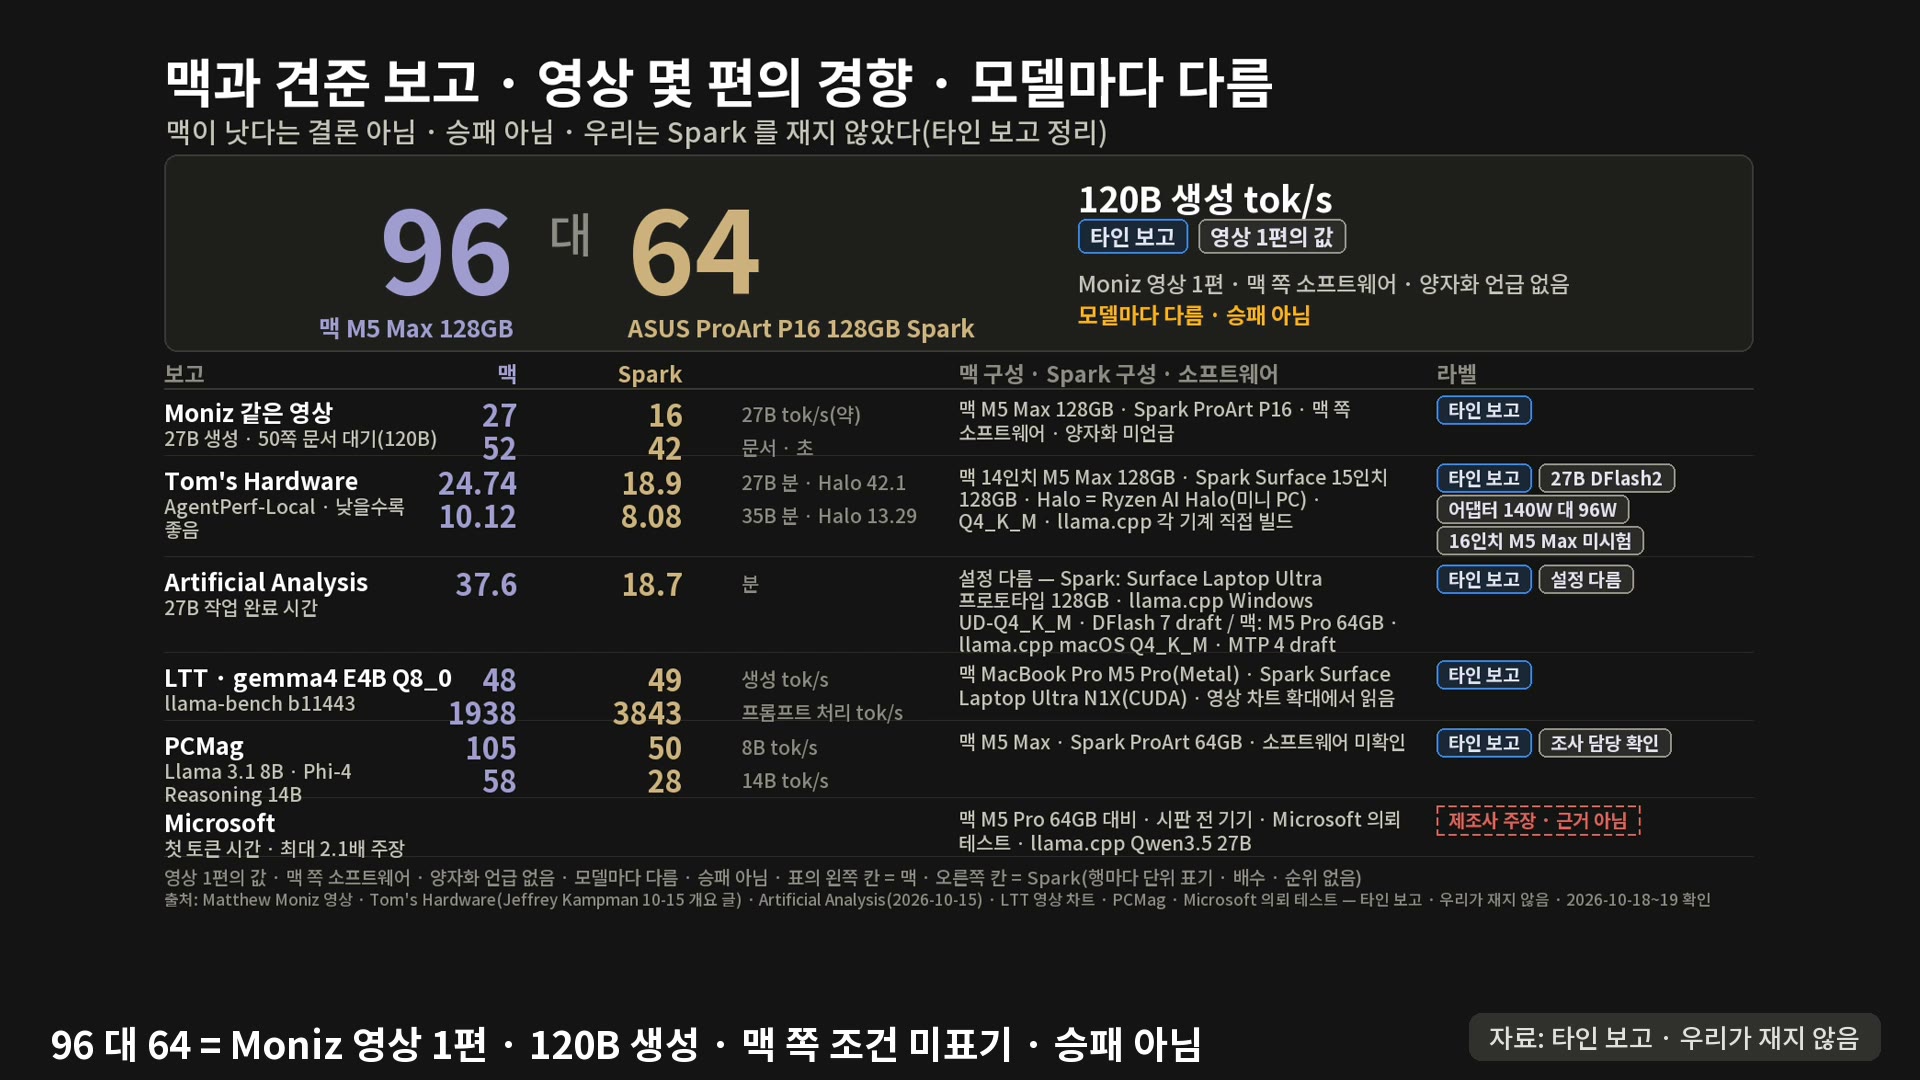
- Moniz 영상 1편: 128GB M5 Max와 ASUS ProArt P16(128GB Spark)의 120B 생성 속도는 맥 96, Spark 64였고, 같은 영상의 27B 생성은 27 대 16이었습니다. 그 영상에서 맥 쪽 소프트웨어와 양자화는 언급이 없었습니다.
- Tom's Hardware의 27B 에이전트 작업(AgentPerf-Local) 완료 시간은 Surface Laptop Ultra 128GB 18.9분, MacBook Pro 14인치 M5 Max 128GB 24.74분(낮을수록 좋음)이었습니다. 어댑터는 140W 대 96W로 달랐고, 16인치 M5 Max는 시험하지 않았습니다.
- Artificial Analysis의 M5 Pro 64GB는 37.6분입니다. Spark 쪽은 설정이 달라 이 값과 나란히 읽으면 안 됩니다.
방향이 시험마다 갈리므로 어느 쪽이 낫다는 결론이 아닙니다.
100B급 이상: 128GB 구성의 값은 33.7~65.4
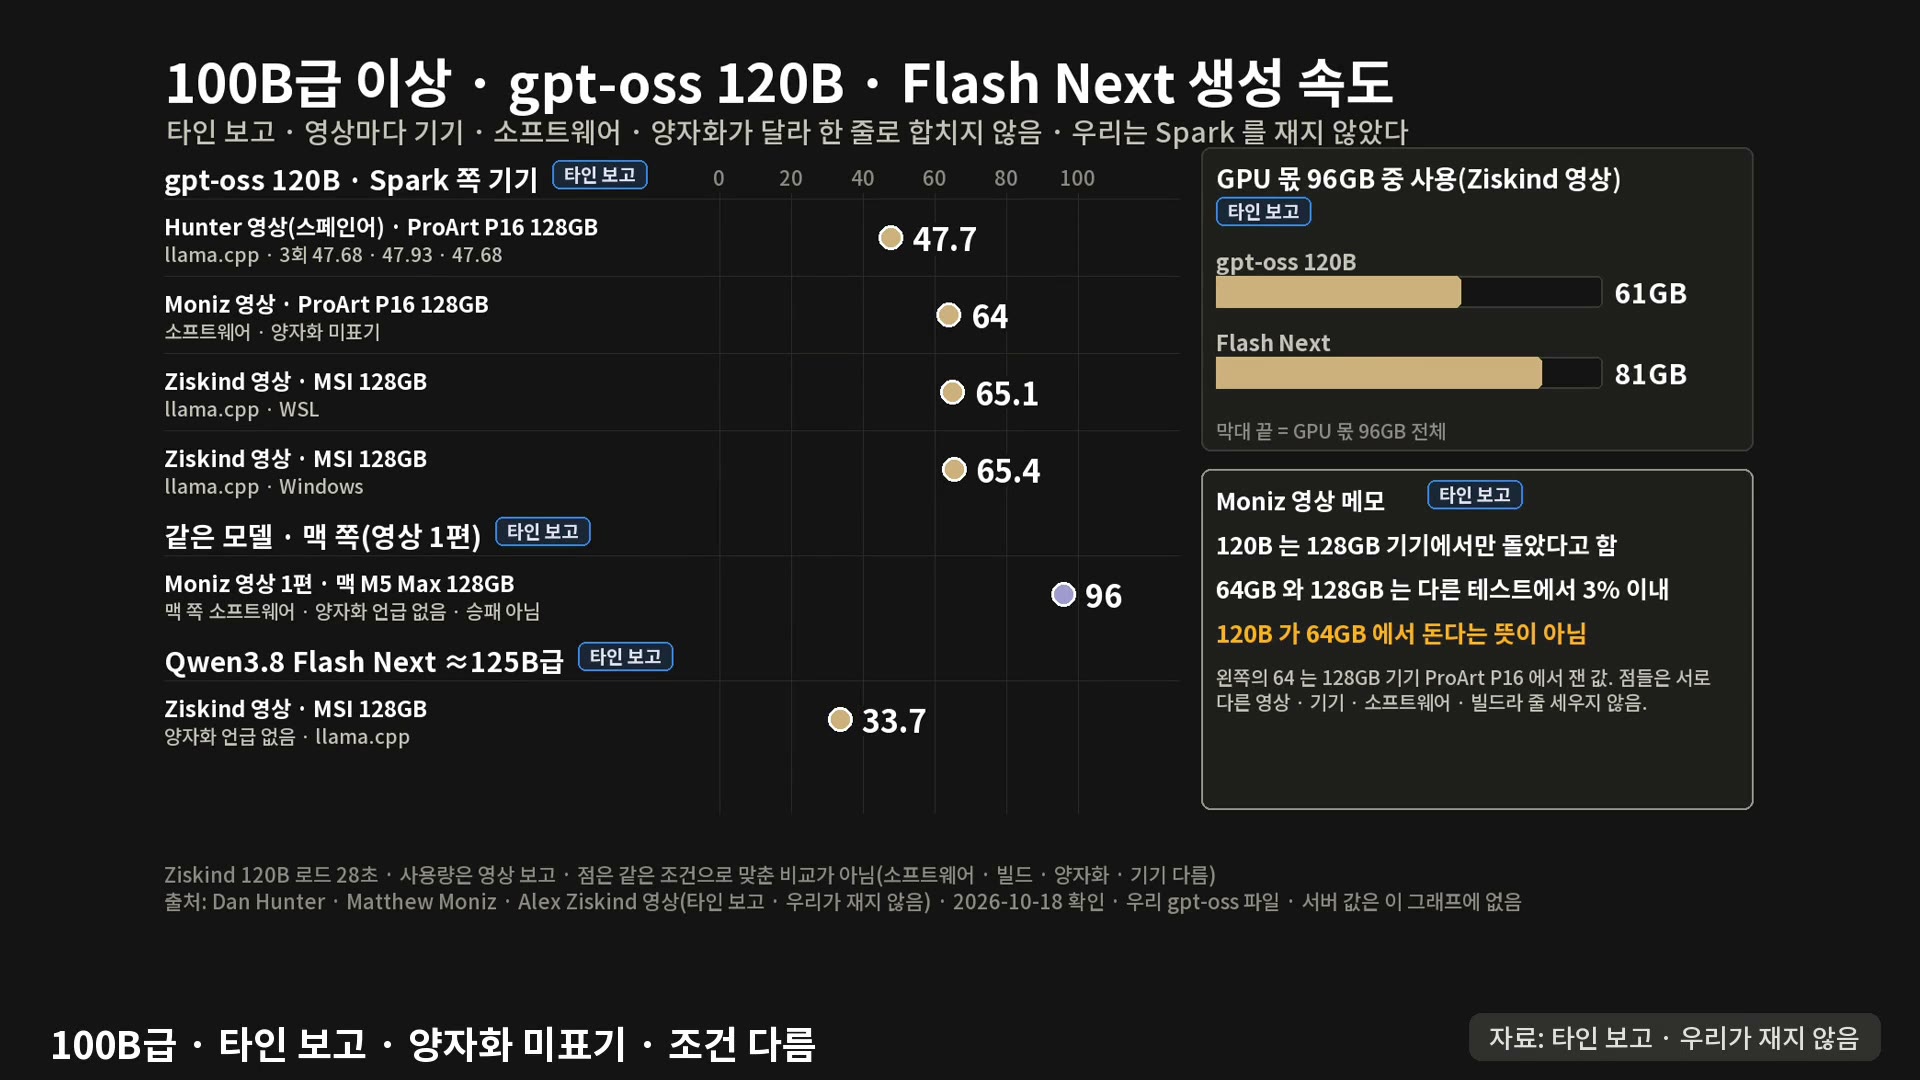
gpt-oss 120B는 Ziskind 65.4, Dan Hunter 47.7 tok/s였습니다. Flash Next(약 125B급)는 Ziskind 영상에서 양자화 언급 없이 33.7 tok/s였습니다. Ziskind 영상의 120B는 GPU 몫 96GB 중 61GB를 썼습니다. Moniz 영상은 120B가 128GB 기기에서만 돌았다고 했습니다. 점은 서로 다른 영상·기기·소프트웨어·빌드라 줄을 세우지 않습니다.
우리가 잰 값: 램이 모자라면 읽기 속도가 무너졌습니다
우리는 Strata로 Flash Next를 대여 서버에서 쟀습니다. Strata는 큰 MoE 모델을 GPU에 가장 많이 쓰는 전문가를 올리고 나머지는 램과 프로세서가 처리하게 하는 방식의 엔진이고, 램이 모자라면 SSD에서 읽습니다(문서 기준). Strata 문서는 VRAM 12GB 이상, 램 32GB 이상을 요구합니다(64GB면 모든 크기).
- RTX 3060 12GB(컨테이너 램 한도 42.6GiB): Q2_0 한국어 생성 39.5 tok/s (범위 37.4~40.1, 10-13)
- RTX 3090 24GB(서버 A): Q2_0 한국어 112.1, IQ3_S 98.9 tok/s (10-14)
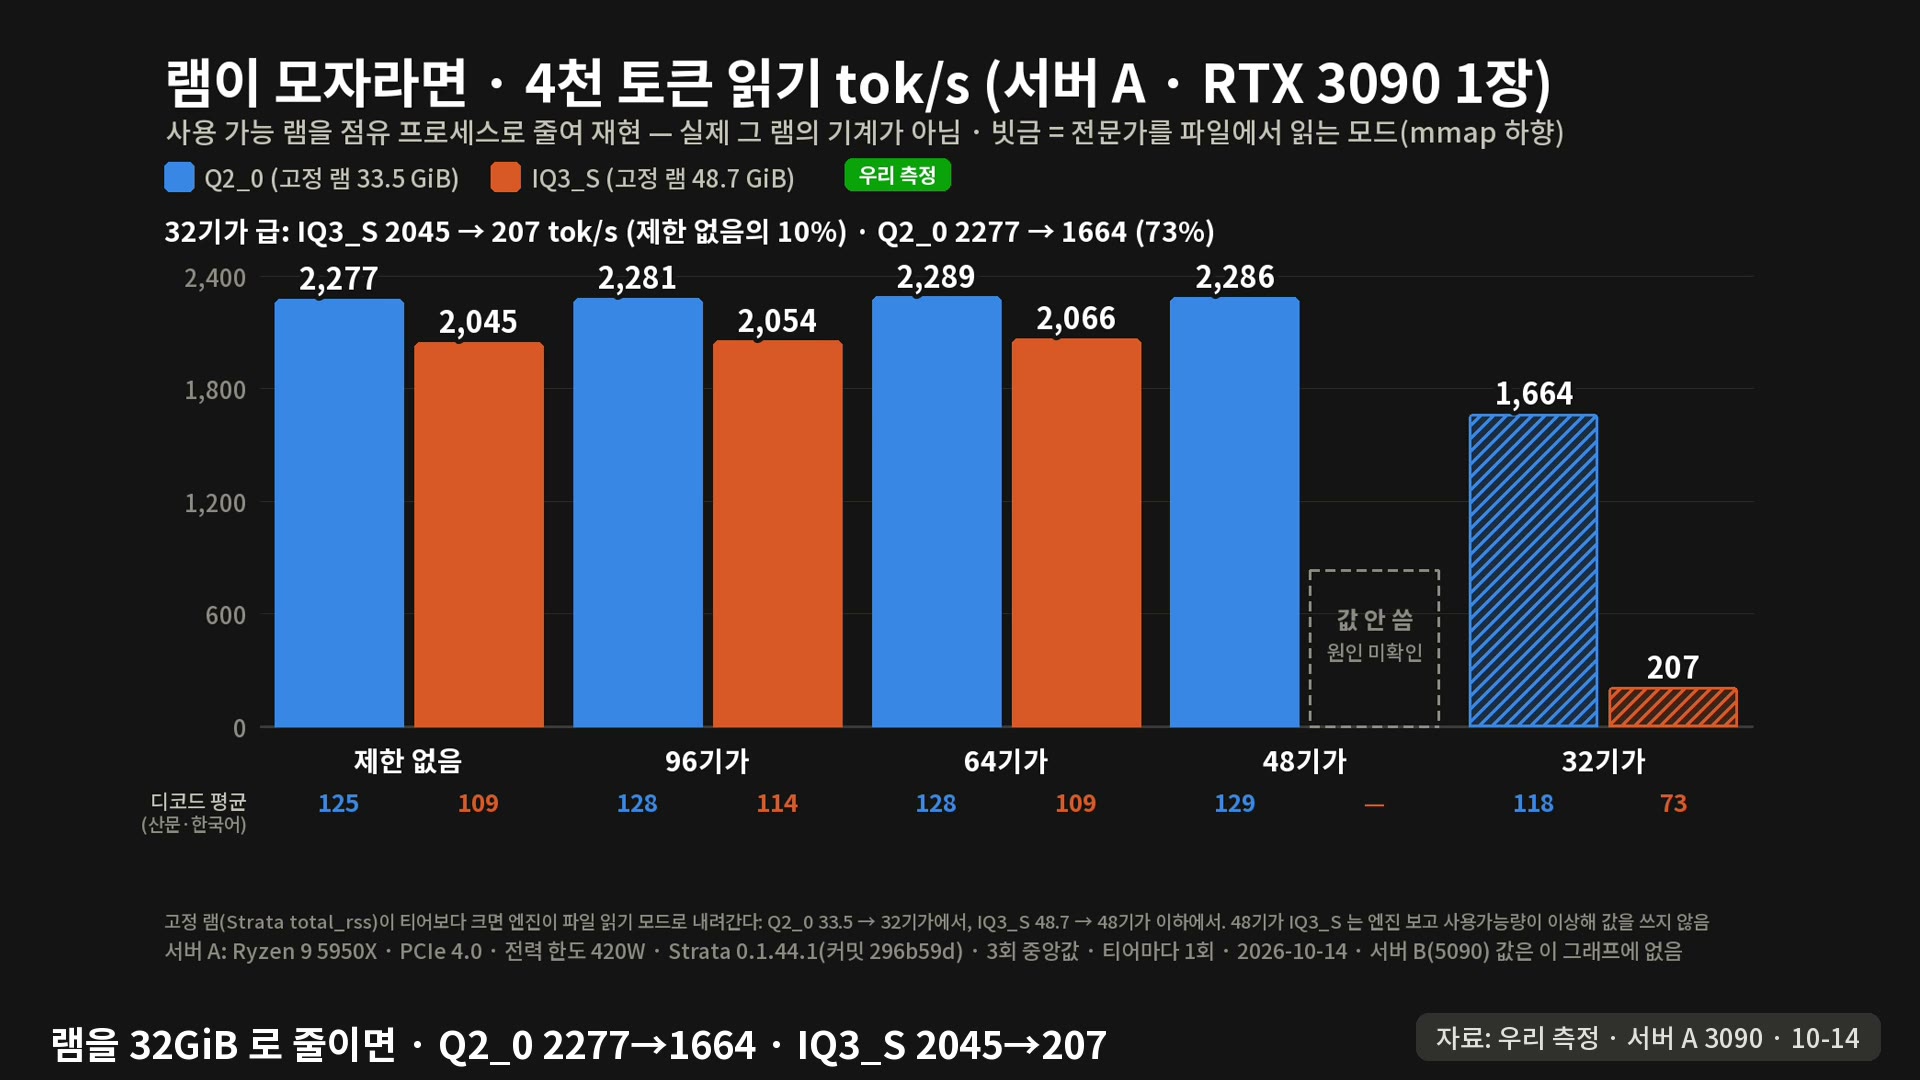
- 같은 3090에서 램을 32GiB로 줄이면(점유 프로세스로 재현한 값, 실제 그 램의 기계가 아님) 4천 토큰 읽기 속도가 Q2_0은 2277에서 1664, IQ3_S는 2045에서 207 tok/s로 떨어졌습니다.
맥 미니 쪽 Strata 값은 영상 화면 카드에 있고 칩이 달라 Spark와 줄 세우지 않았습니다. 대역폭도 NVIDIA 문서 사양과 CPU 쪽에서 잰 실측이 잰 위치가 달라 합치지 않았습니다.
계산: 대역폭으로 본 27B 생성 상한(측정 아님)
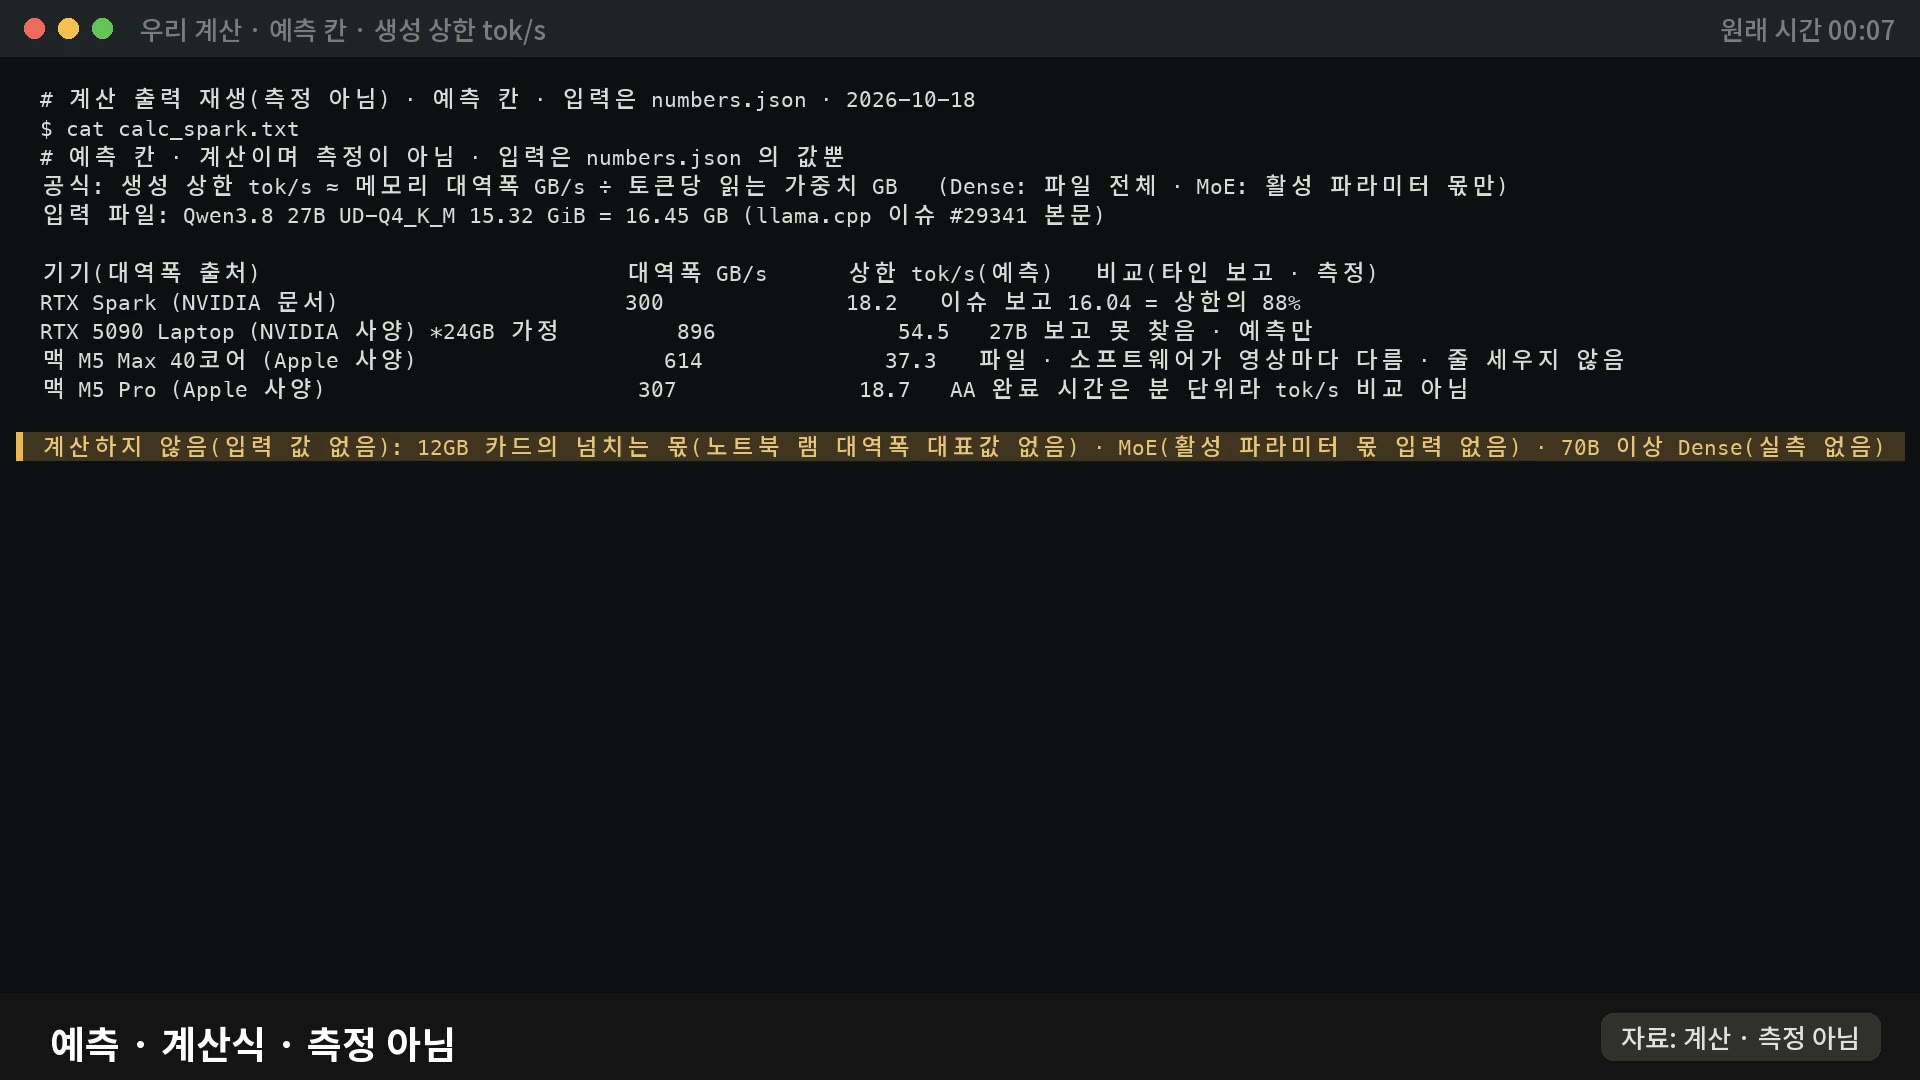
생성 상한은 대역폭을 토큰당 읽는 가중치 크기로 나눈 값입니다. 27B 파일 16.45GB에 Spark의 300GB/s를 넣으면 18.2 tok/s이고, llama.cpp 이슈에 올라온 사용자 보고 16.04는 그 88%입니다. 5090 노트북은 이 파일이 24GB 카드에 들어간다고 가정해 사양 896GB/s를 넣으면 54.5 tok/s지만, 27B에 대한 실측 보고는 찾지 못했습니다. 어디까지나 예측입니다.
모델 선택은 "올라가는가, 속도, 품질" 순서로
속도는 남의 보고를 쓰고, 품질은 우리가 잰 것만 씁니다. Qwen 27B는 우리 KMMLU 150문항에서 UD-Q4_K_XL 98, IQ3_XXS 96, IQ2_M 93으로 구분되지 않았습니다. Flash Next는 450문항에서 Q2_0 303, UD-IQ4_XS 334였습니다. 나머지 모델은 우리 품질 측정이 없습니다.
새 기기를 보기 전에: 이미 가진 노트북으로 되는가
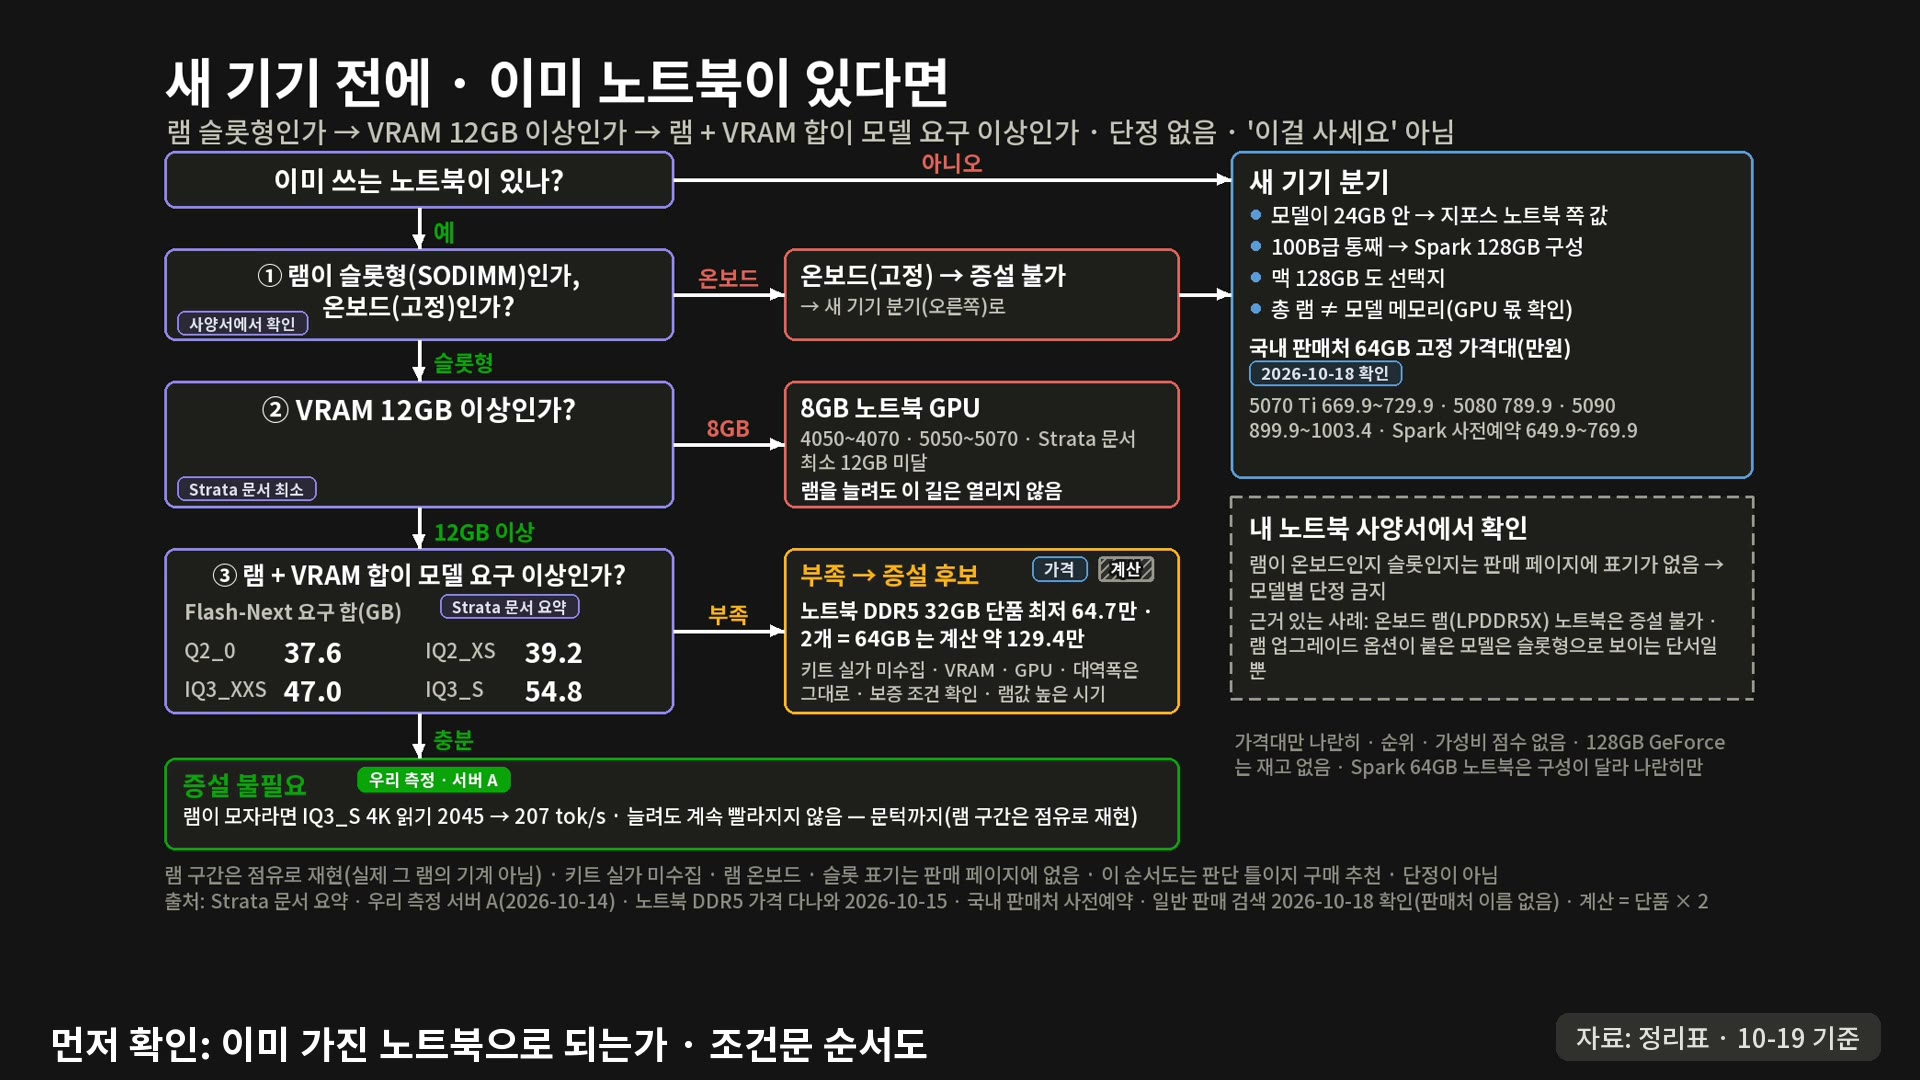
첫 질문은 이미 가진 노트북에 램만 늘리면 되는가입니다. 램이 슬롯형이 아니라 온보드면 늘릴 수 없고, 그다음은 VRAM이 12GB 이상인지입니다. 8GB 노트북은 램을 늘려도 Strata 문서 최소에 못 미칩니다. 램과 VRAM의 합은 Flash Next Q2_0이 37.6GB, IQ3_S가 54.8GB입니다. 우리 점유 재현 측정에서 램이 모자라면 4천 토큰 읽기가 2045에서 207로 떨어졌지만, 늘려도 계속 빨라지지는 않고 SSD 읽기를 피하는 문턱까지입니다. 노트북용 DDR5 32GB 단품은 다나와 10-15 기준 최저 약 65만 원이라 두 개(64GB)는 계산상 약 129만 원이며, VRAM은 늘지 않습니다.
한국 가격(국내 판매처 10월 18일 확인)
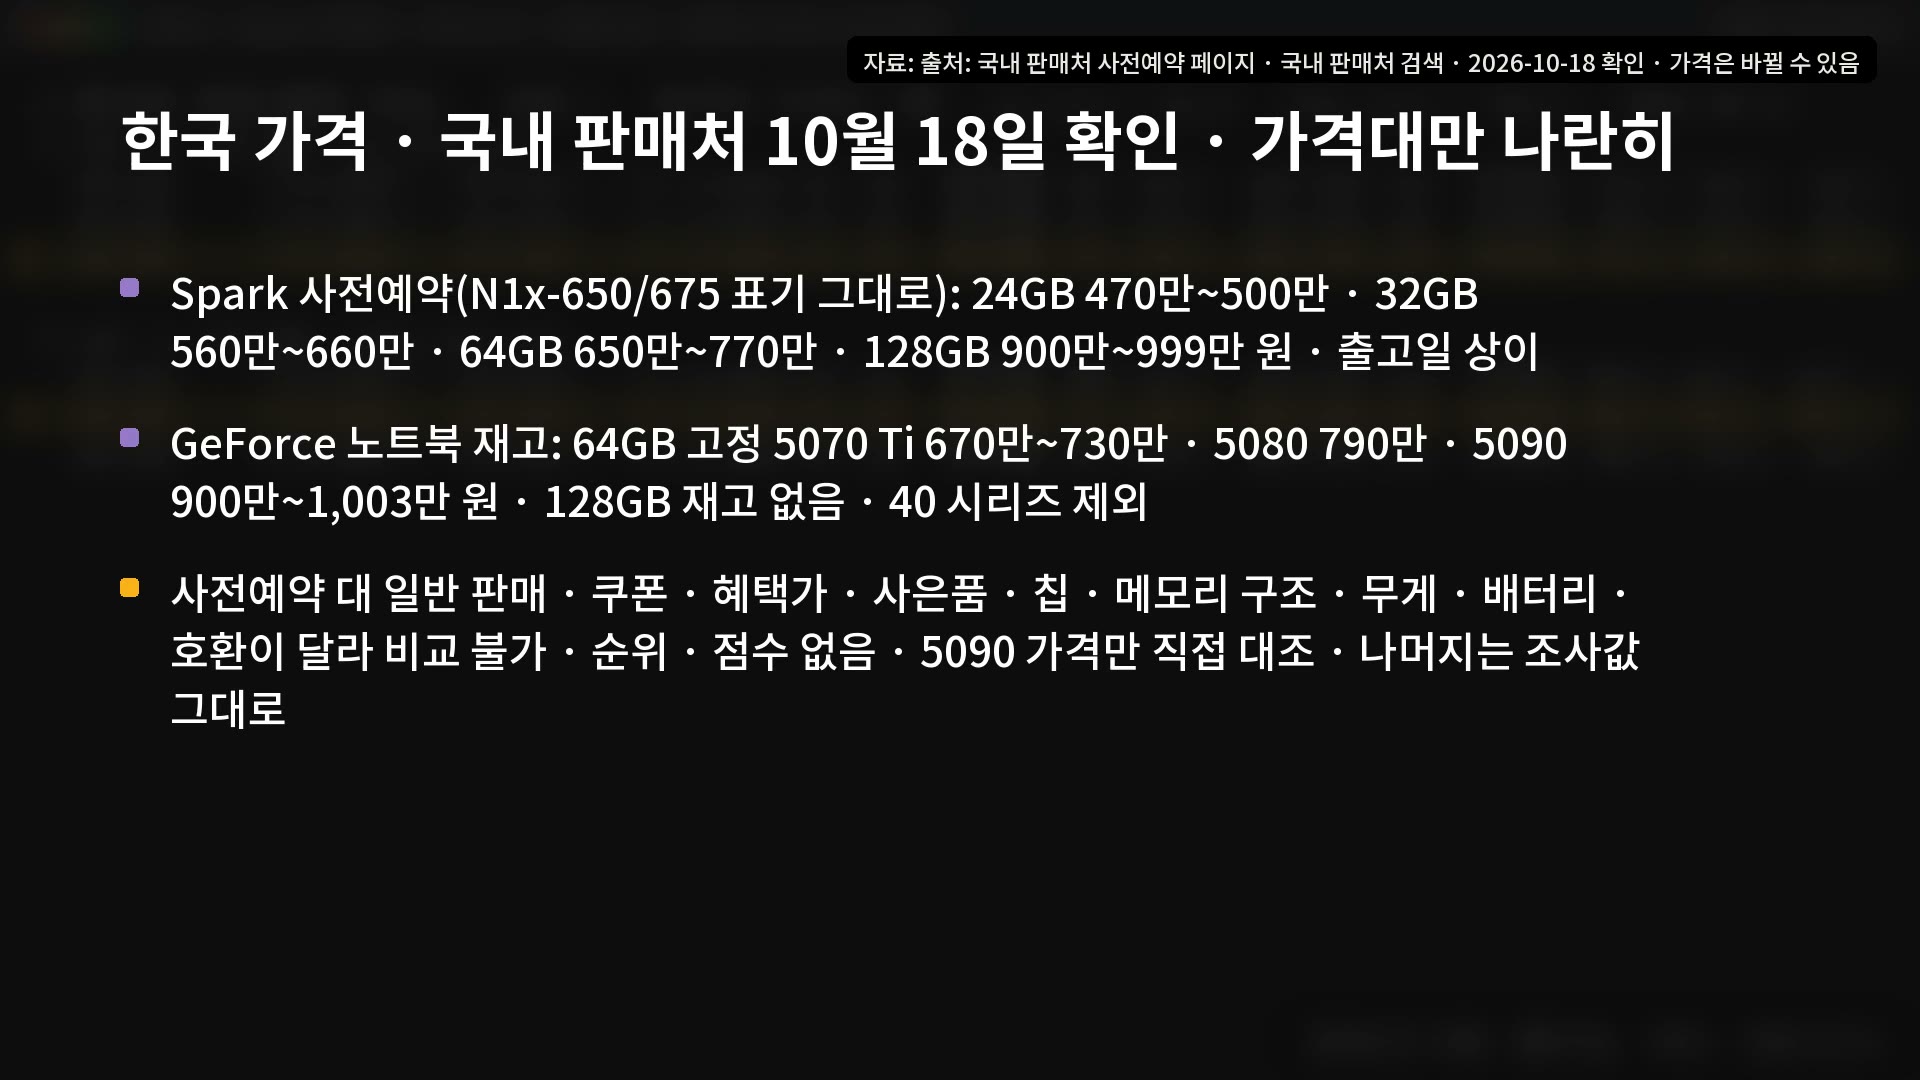
| 구성 | RTX Spark 사전예약 | GeForce 노트북(재고, 램 고정 구성) |
|---|---|---|
| 64GB | 650만~770만 원 | 5070 Ti 670만~730만, 5080 790만, 5090 900만~1,003만 원 |
| 128GB | 900만~999만 원 | 재고 없음 |
Spark 24GB는 470만~500만 원, 32GB는 560만~660만 원이었습니다. 사전예약, 쿠폰, 사은품, 칩, 메모리 구조, 무게, 배터리가 달라 순위나 점수는 매기지 않았습니다. 맥북 프로 14인치 M5 Max(40코어 GPU) 128GB 2TB는 Apple 한국 스토어에서 1,141만 원이었습니다. 가격은 바뀔 수 있습니다.
호환과 안정성: 보고가 둘
호환은 llama.cpp, Ollama, LM Studio에서 동작 보고가 있고 Strata는 없습니다. 안정성은 서로 다른 두 건입니다. StorageReview에서 Surface는 10월 14일 저녁 OpenBLAS 수치계산 부하에서 세 번 꺼졌고, HP는 같은 부하를 끝냈습니다. The Register의 HP는 약 한 시간 이어진 추론에서 GPU가 90°C를 넘고 화면 깨짐과 간헐적 멈춤이 나왔으며, 쉬면 안정됐다고 합니다. 부하와 기기가 달라 합쳐 읽지 않습니다.
한계
- 우리는 RTX Spark를 재지 못했고, 우리가 잰 DGX Spark(GB10) 값은 RTX Spark가 아닙니다.
- 남의 리뷰는 소프트웨어·양자화·기기가 서로 달라 직접 비교가 안 됩니다. 출시 직후 자료이고 독립 리뷰가 아직 적었으며, 한국은 사전예약이라 출고일이 제품마다 달랐습니다.
- 이 글은 판정이 아니라 고르는 틀입니다. 새 자료가 나오면 영상 설명란을 고친다고 했으므로, 최신 값은 그쪽을 확인해 주세요.
기준일: 2026-10-19(영상 공개일 2026-10-20). 이후 바뀐 가격·리뷰는 반영하지 않았습니다.