플린트(Flint) 맥 미니 32GB 실측, 엔진 5개 52.4~76.0 tok/s와 큐웬 비교
올린 날 영상 공개
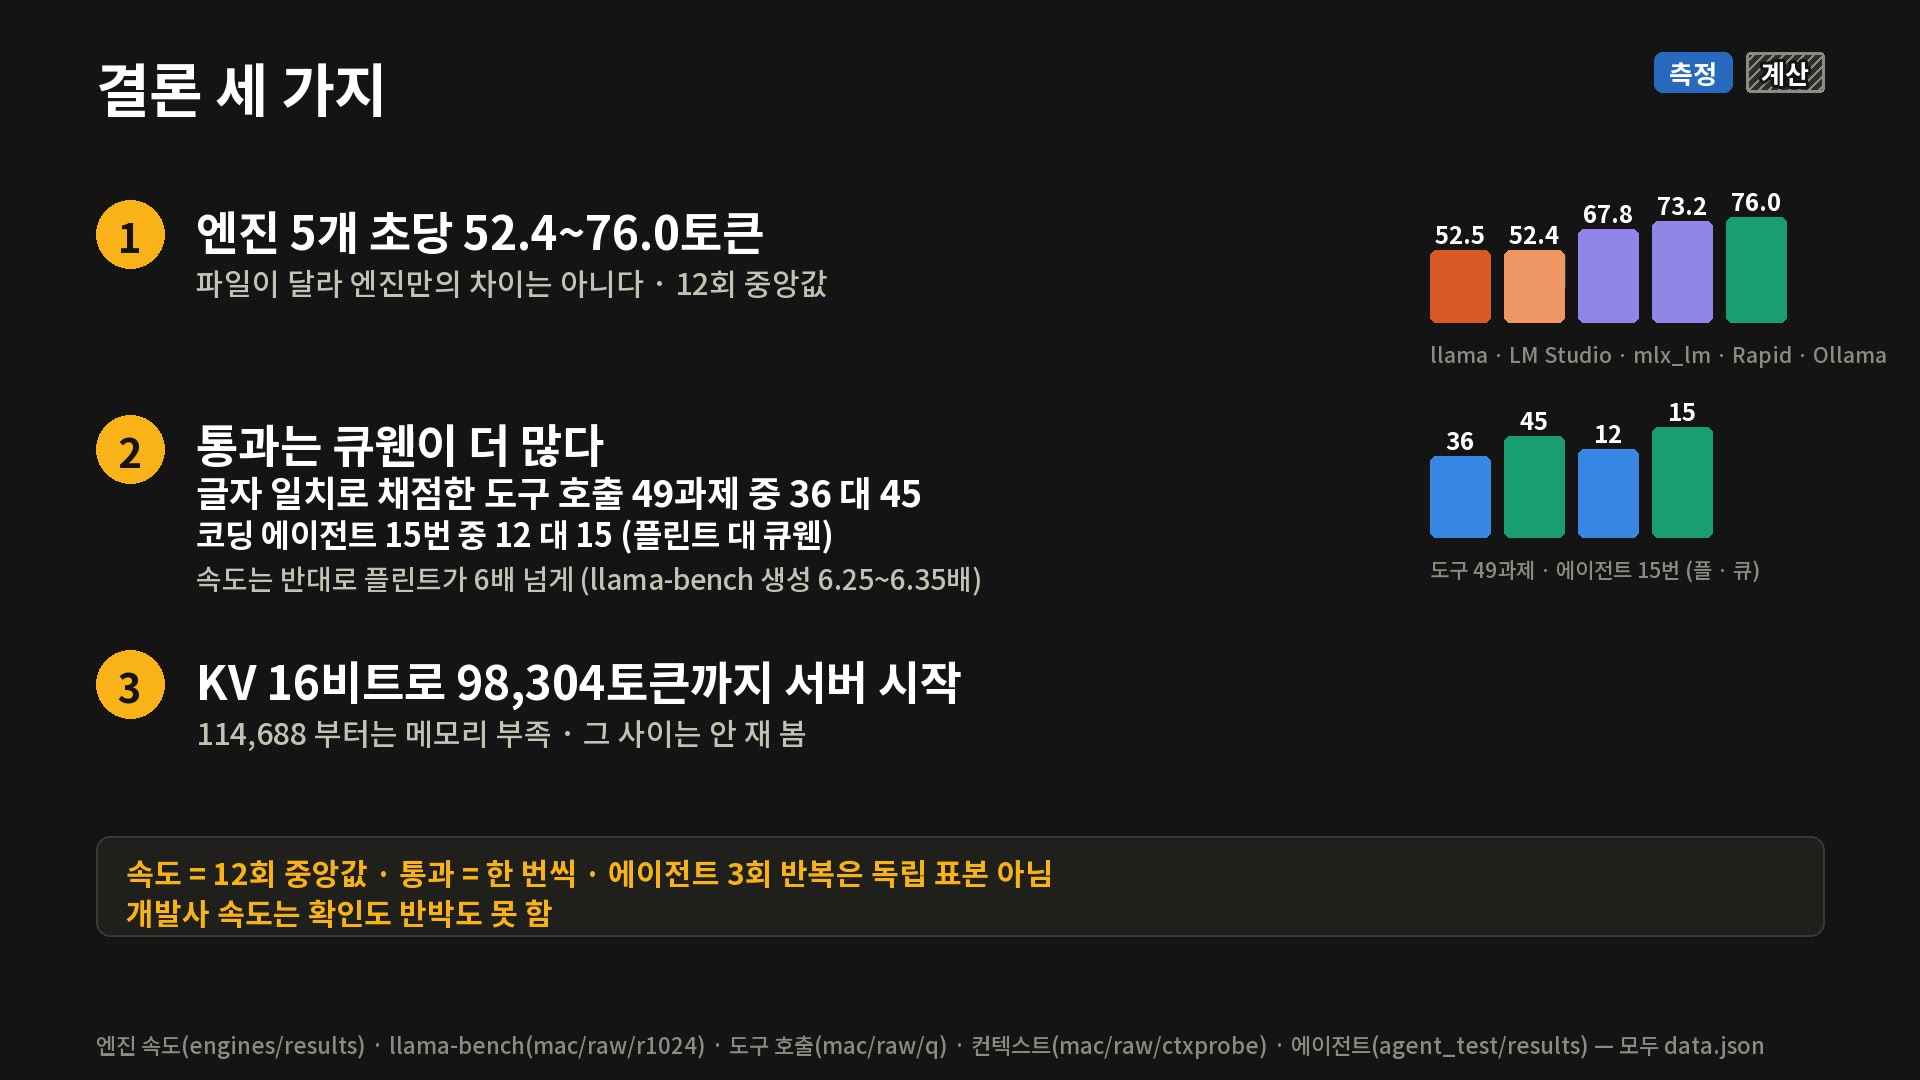
플린트(Flint)를 맥 미니 M6 32GB에서 엔진 5개로 쟀더니 초당 52.4~76.0토큰. 파일이 달라 엔진만의 차이는 아니고, 코딩 에이전트 통과는 큐웬 15 대 플린트 12였습니다.
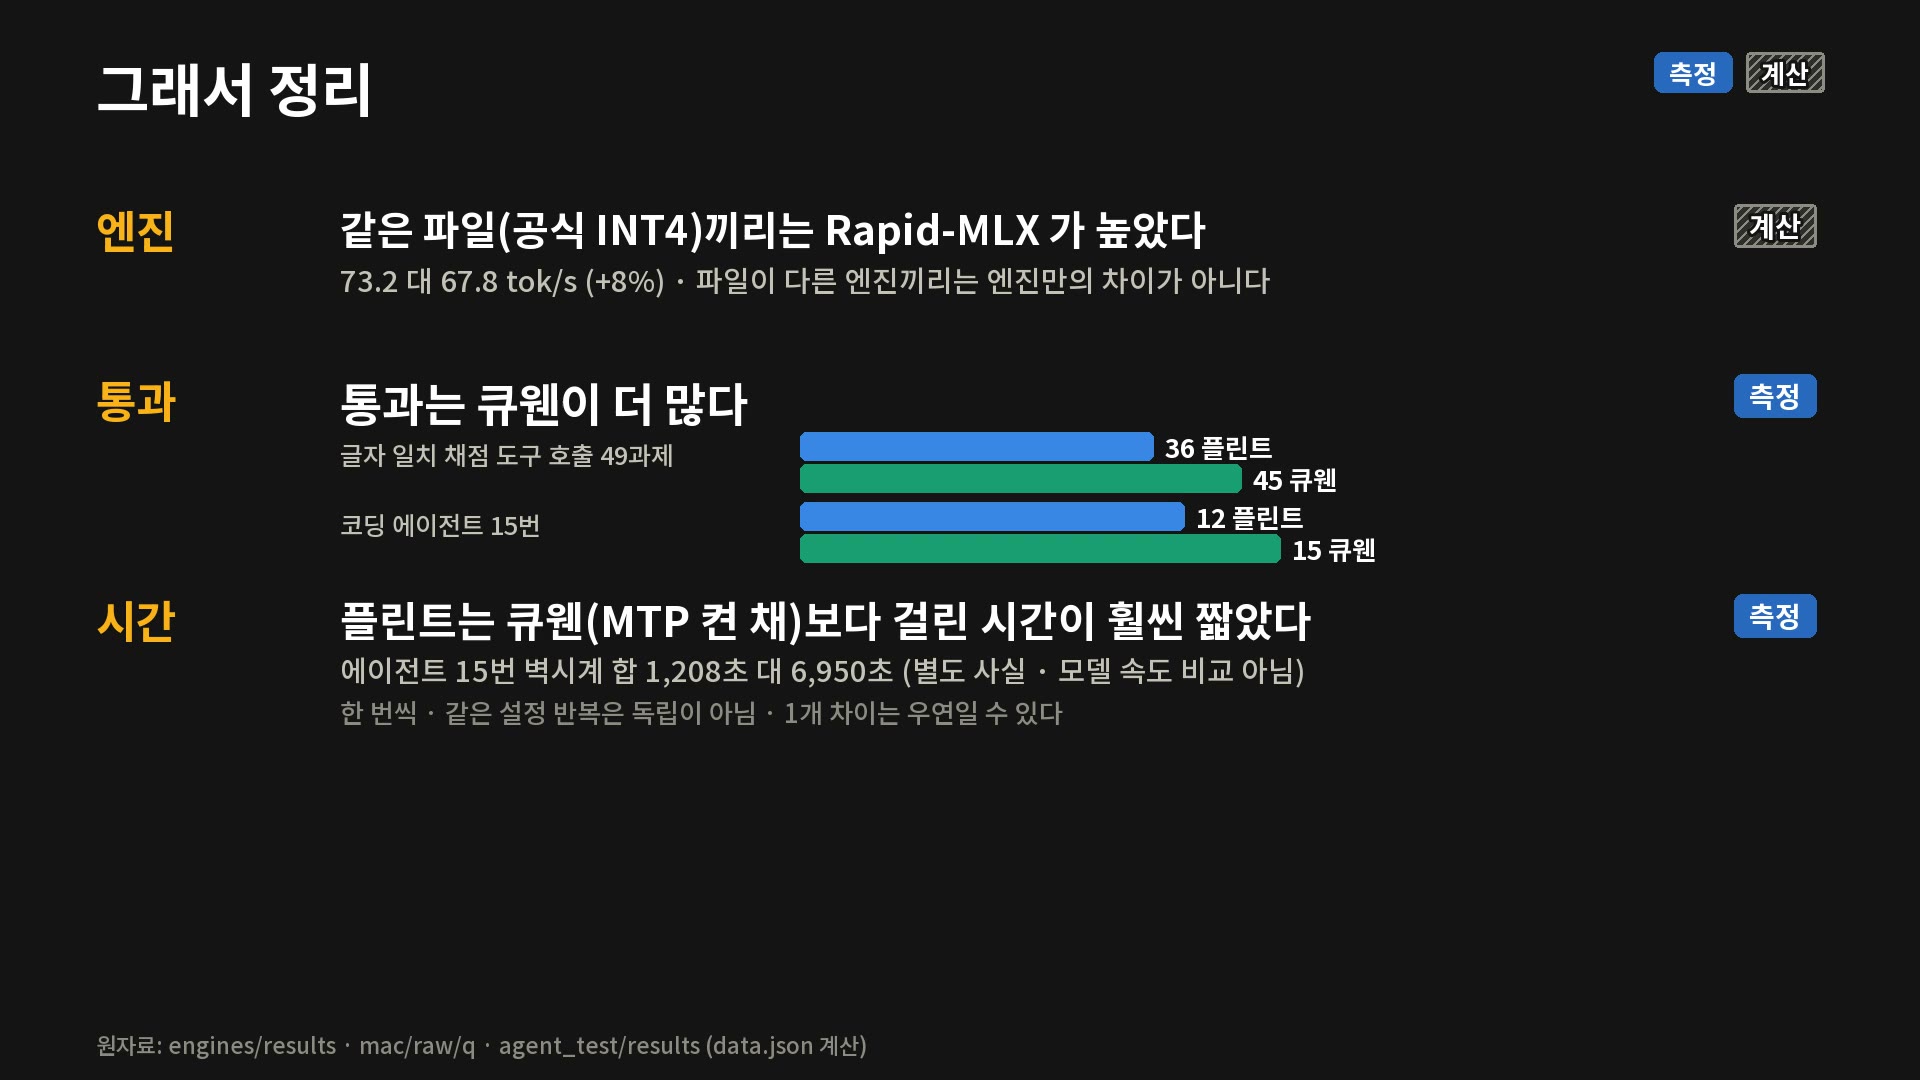
플린트(Flint)를 맥 미니 M6 32GB에서 엔진 5개로 직접 돌려 쟀더니, 초당 생성 속도 중앙값이 52.4~76.0토큰으로 나왔습니다. 다만 엔진마다 쓴 파일이 달라서 이 폭은 엔진만의 차이가 아닙니다. 같은 파일로 비교할 수 있는 쌍은 Rapid-MLX와 mlx_lm 둘뿐입니다. 같은 코딩 에이전트 과제를 큐웬(Qwen) 3.8 27B에도 풀게 했을 때는 통과 수가 큐웬 15번, 플린트 12번(15번 중)이었습니다.
결론 먼저
- 엔진 5개의 속도: 초당 52.4~76.0토큰(열두 번 중앙값, 생각을 켠 채). 파일이 달라 엔진만의 차이는 아닙니다.
- 통과는 큐웬이 더 많았습니다: 글자 일치로 채점한 도구 호출 49과제는 36 대 45(플린트 대 큐웬), 코딩 에이전트 15번은 12 대 15입니다. 속도는 반대로 llama-bench 생성에서 플린트가 큐웬의 6배 넘게 빨랐습니다.
- 컨텍스트: KV 16비트에서 98,304토큰까지 서버가 시작됐고, 114,688토큰에서 메모리 부족이 났습니다.
이 글의 숫자 종류
- 우리 측정: 맥 미니 M6 32GB에서 직접 잰 값입니다. 속도는 질문 4종을 3회씩, 12회의 중앙값입니다.
- 계산: 우리 값으로 한 산수입니다(예: 약 8퍼센트 차이, 6배 넘게, 피셔 검정).
- 개발사 주장: 개발사가 밝힌 값으로, 우리가 확인하지 못했습니다.
- 타인 보고: 다른 사람이 적은 값입니다.
기준일은 영상 공개일인 2026-10-25입니다. 측정은 2026-10-24~25에 했습니다.
플린트는 어떤 모델인가
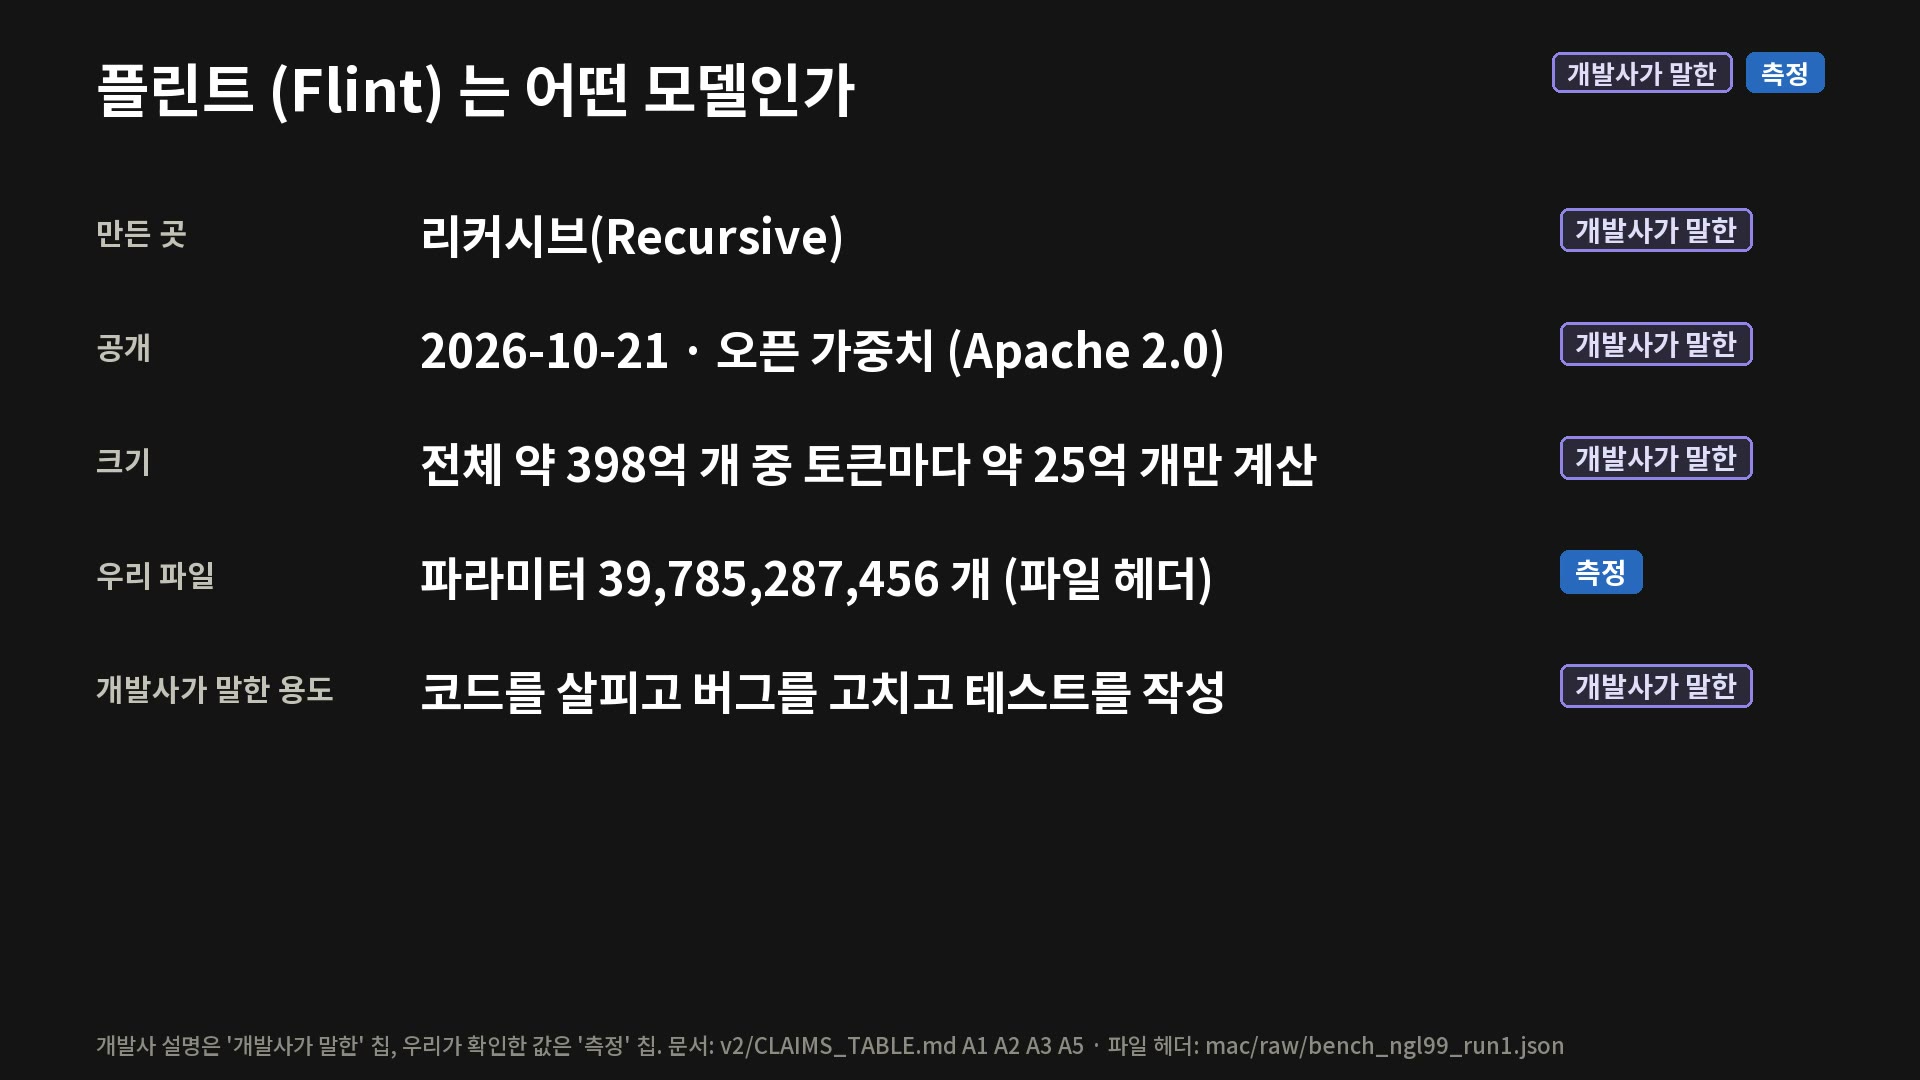
플린트는 2026년 10월 21일 공개된 리커시브(Recursive)의 오픈 가중치 모델입니다. 개발사 설명에 따르면 전체 약 398억 개 가운데 토큰마다 약 25억 개만 계산하는 MoE 구조이고, 코드를 살피고 버그를 고치고 테스트를 쓰는 코딩 에이전트용이라고 합니다(개발사 주장). 우리가 쓴 GGUF 파일의 헤더에는 파라미터 39,785,287,456개가 적혀 있었고, 파일 크기는 23,387,911,136바이트였습니다(우리 측정).
개발사 카드에 따르면 MoE 층 47개에서 전문가 256개 중 6개와 공유 전문가 1개만 씁니다. 다만 우리 GGUF 헤더에는 공유 전문가 수가 2로 적혀 있어 표기가 맞지 않았고, 원인은 가리지 못했습니다. 계산하는 양이 25억일 뿐 메모리에는 전체가 올라가야 하므로, 2.5B 모델 정도의 성능이라는 뜻은 아닙니다.
측정 조건과 한계
- 맥 미니 M6 32GB, 요청은 한 번에 하나씩, 그리디(temperature 0, seed 1), 최대 256토큰.
- 질문 4종(입력 26~443토큰)을 3회씩 해서 12회, 가운데 값을 썼습니다.
- 플린트는 생각을 길게 쓰는 모델이라 생각을 켠 채 쟀고, 속도에는 생각 토큰이 포함됩니다. 열두 번 모두 256토큰이 생각으로만 찼습니다.
- 생각 끄기는 엔진마다 달랐습니다. Ollama는 끌 수 있었고 끄면 초당 79.9토큰에 열두 번 모두 답이 시작됐습니다. Rapid-MLX, mlx_lm, llama.cpp는 끄는 방법을 확인하지 못했습니다.
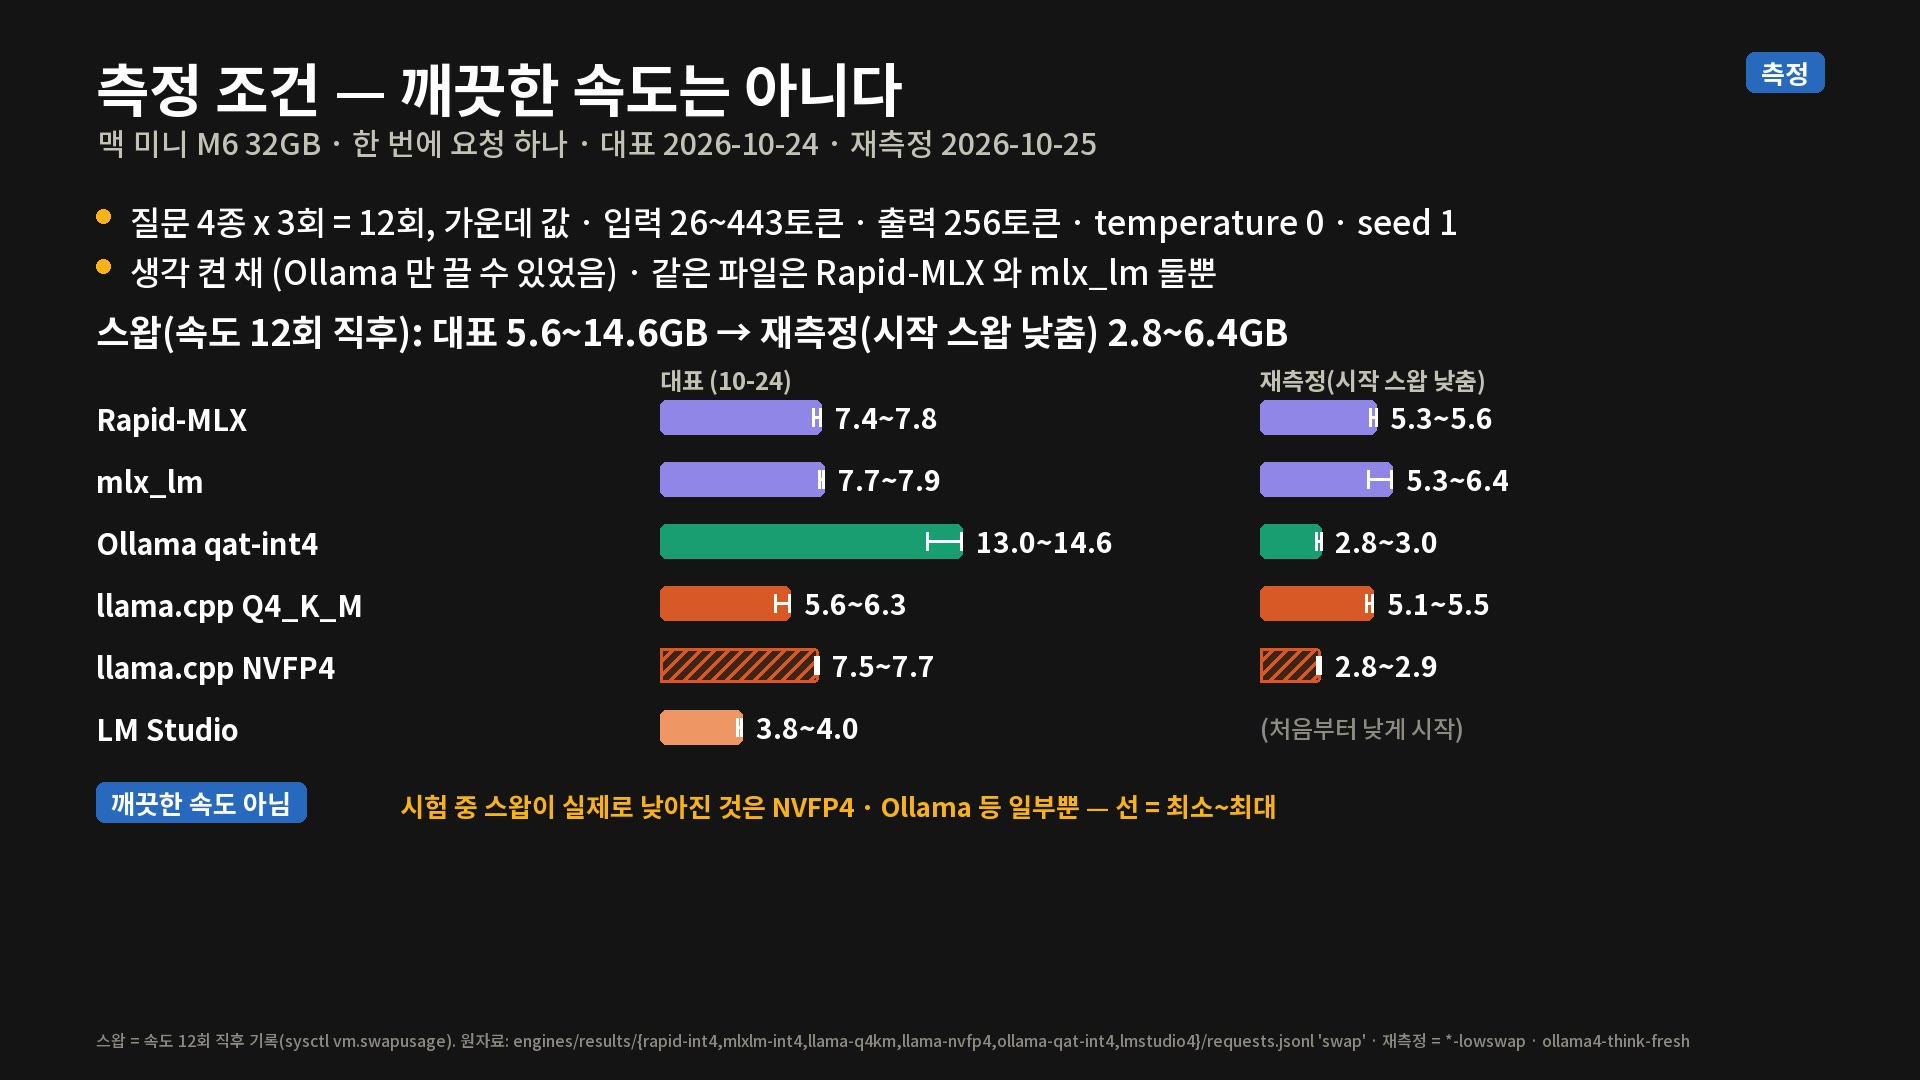
- 속도를 잴 때 스왑은 처음 5.6~14.6GiB였고, 시작 스왑을 낮춰 다시 쟀을 때는 2.8~6.4GiB였습니다. 깨끗한 환경에서 잰 속도가 아닙니다(영상 화면에는 GB로 표기).
엔진별 생성 속도
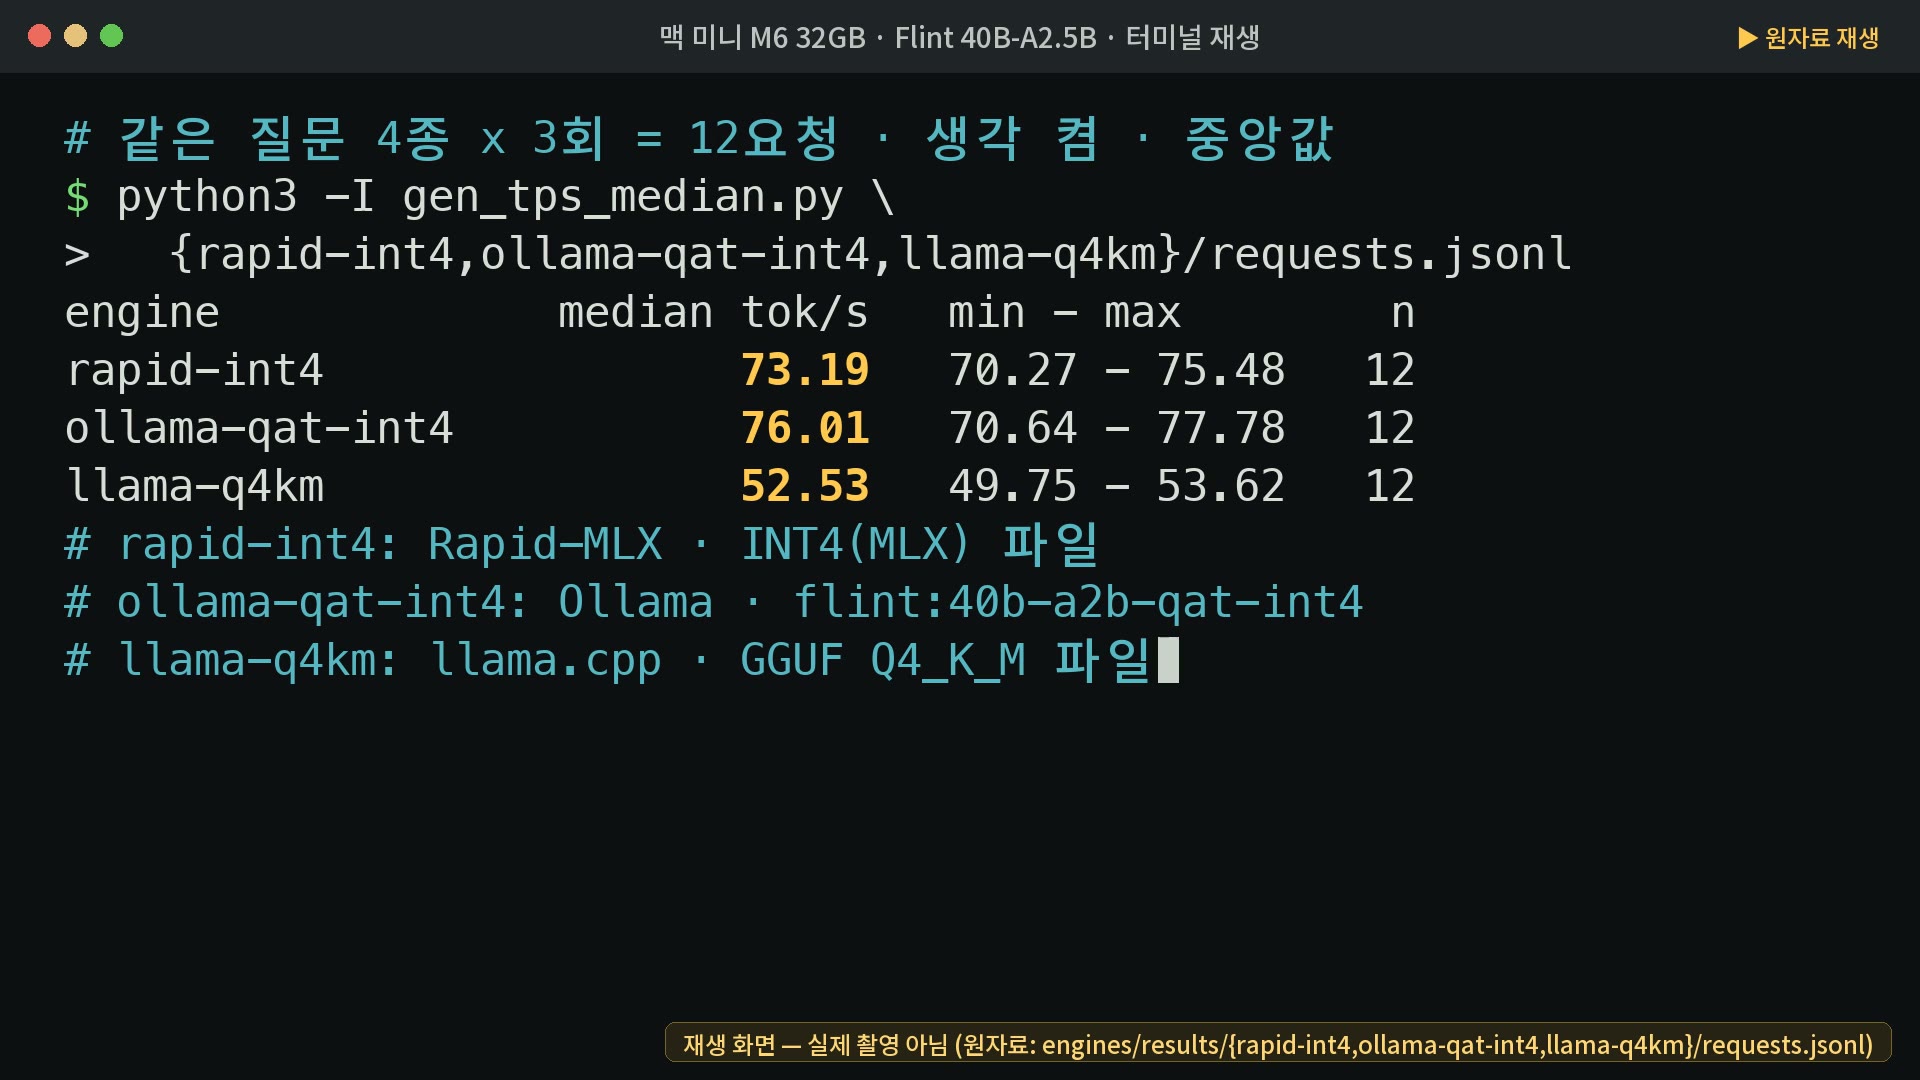
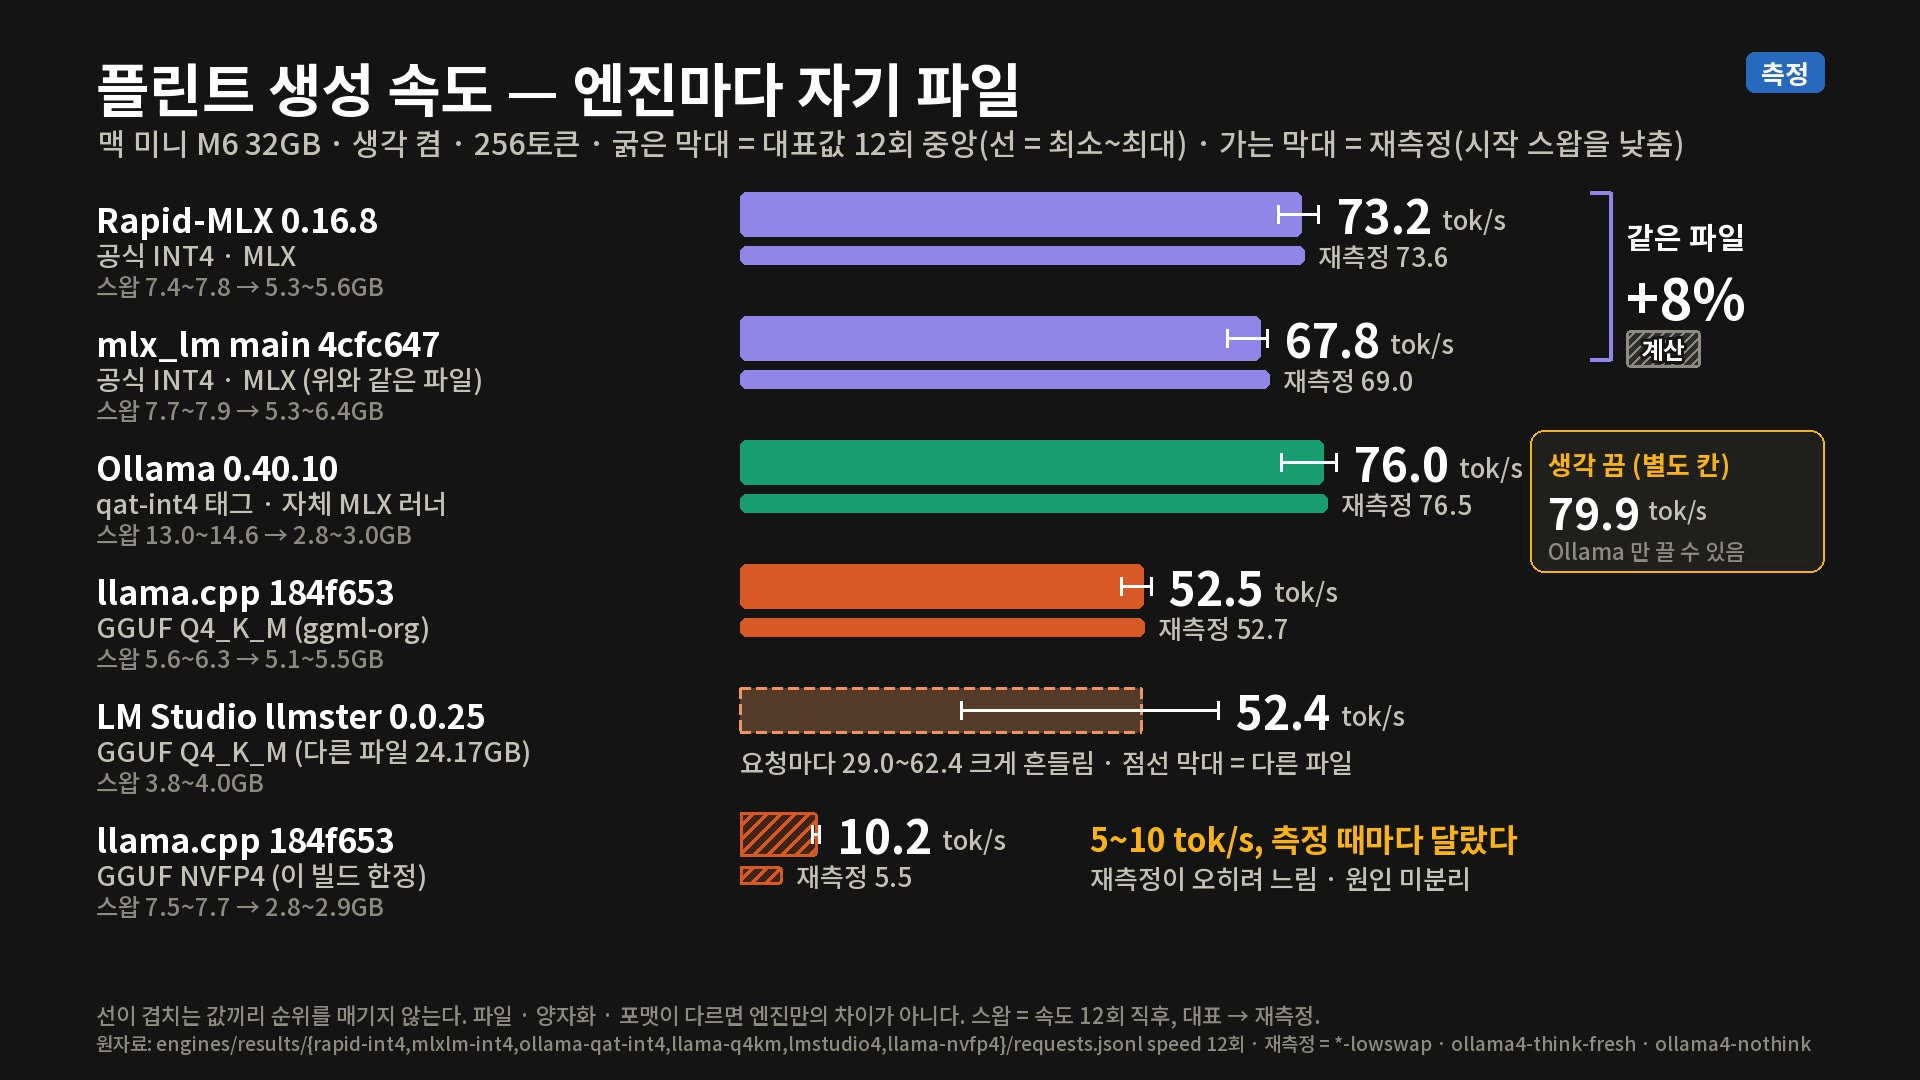
다음은 우리 측정입니다(생각 켬, 12회 중앙값, 괄호는 범위).
| 엔진 | 파일 | 초당 토큰 |
|---|---|---|
| llama.cpp 184f653 | Q4_K_M GGUF | 52.5 (49.8~53.6) |
| LM Studio (런타임 llama.cpp 2.64.0) | 다른 GGUF | 52.4 (29.0~62.4) |
| mlx_lm main 4cfc647 | 공식 INT4 | 67.8 (63.6~68.8) |
| Rapid-MLX 0.16.8 | 같은 공식 INT4 | 73.2 (70.3~75.5) |
| Ollama v0.40.10 | flint:40b-a2b-qat-int4 태그 | 76.0 (70.6~77.8) |
- 같은 파일은 Rapid-MLX와 mlx_lm 둘뿐이고, 73.2 대 67.8로 약 8퍼센트 차이입니다(계산). 범위가 겹치지 않았습니다.
- Ollama는 qat-int4 태그만 쟀고, 이 태그가 같은 가중치인지는 확인하지 못했습니다. 기본 태그는 재지 않았습니다. 중앙값은 가장 높지만 범위는 다른 엔진과 겹칩니다.
- LM Studio는 다른 파일(24.17GB)이었고 요청마다 29.0~62.4로 크게 흔들렸습니다.
- 스왑을 낮춰 다시 재도 Rapid-MLX, mlx_lm, llama.cpp, Ollama는 처음 값과 2퍼센트 안쪽으로 비슷했습니다(Ollama는 76.5).
- NVFP4 GGUF는 처음 10.2, 다시 쟀을 때 5.5로 달라서(원인 못 가림) 범위 52.4~76.0에서 뺐습니다.
- 첫 토큰까지의 시간(입력 약 3만 3천 토큰)은 파일이 달라 순위를 매기지 않고 값만 적으면 Ollama 27.6초, Rapid-MLX 27.4초, mlx_lm 27.3초, llama.cpp 48.2초, LM Studio 50.5초입니다. 처음 쟀던 Ollama의 194.5초는 다시 쟀을 때 재현되지 않았고 원인은 가리지 못했습니다.
엔진 지원은 2026-10-24 기준 문서상 llama.cpp, Rapid-MLX, Ollama, Unsloth, 개발사 엔진 rec이 지원하고, LM Studio는 모델 목록에 있으며 mlx_lm은 main 버전에만 있었습니다. 우리 맥에서는 다섯 개가 돌아갔습니다. LM Studio는 런타임 2.41.0에서 플린트 채팅 템플릿 오류로 실패했다가 2.64.0에서 로드됐습니다.
개발사 속도 주장은 확인도 반박도 못 했습니다
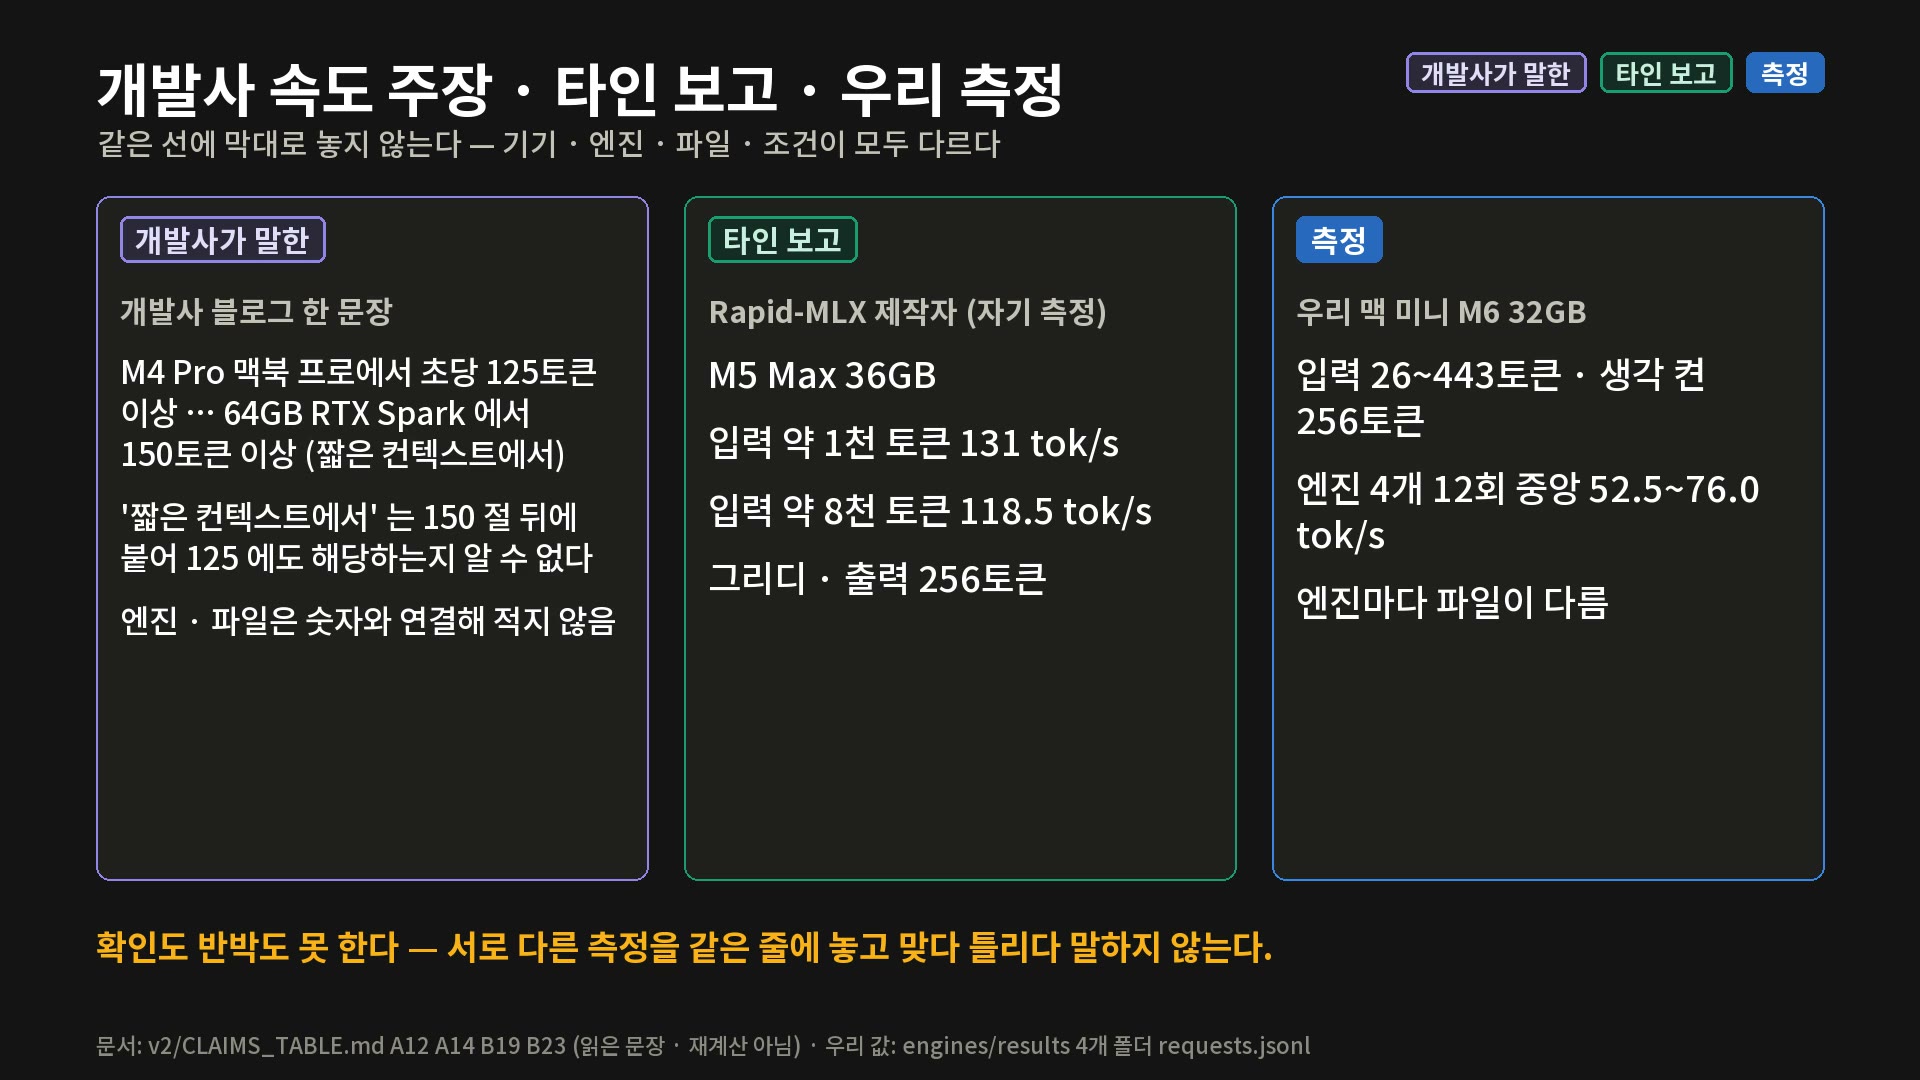
개발사 블로그는 한 문장에 M4 Pro 맥북 프로 125토큰 이상과 64GB RTX Spark 150토큰 이상을 쓰고, 끝에 '짧은 컨텍스트에서'를 붙였습니다. 이 단서가 125에도 해당하는지는 알 수 없고, 어떤 엔진과 파일로 쟀는지는 숫자와 연결해 적지 않았습니다(개발사 주장). Rapid-MLX 제작자는 M5 Max 36GB에서 입력 약 1천 토큰 131토큰, 약 8천 토큰 118.5토큰이라고 적었습니다(타인 보고, 그리디, 출력 256토큰).
우리 질문은 입력이 26~443토큰으로 짧지만 기기가 M6 32GB로 다르고 엔진과 파일도 달라서, 어느 쪽 숫자도 확인하거나 반박할 수 없습니다.
큐웬 3.8 27B와 비교
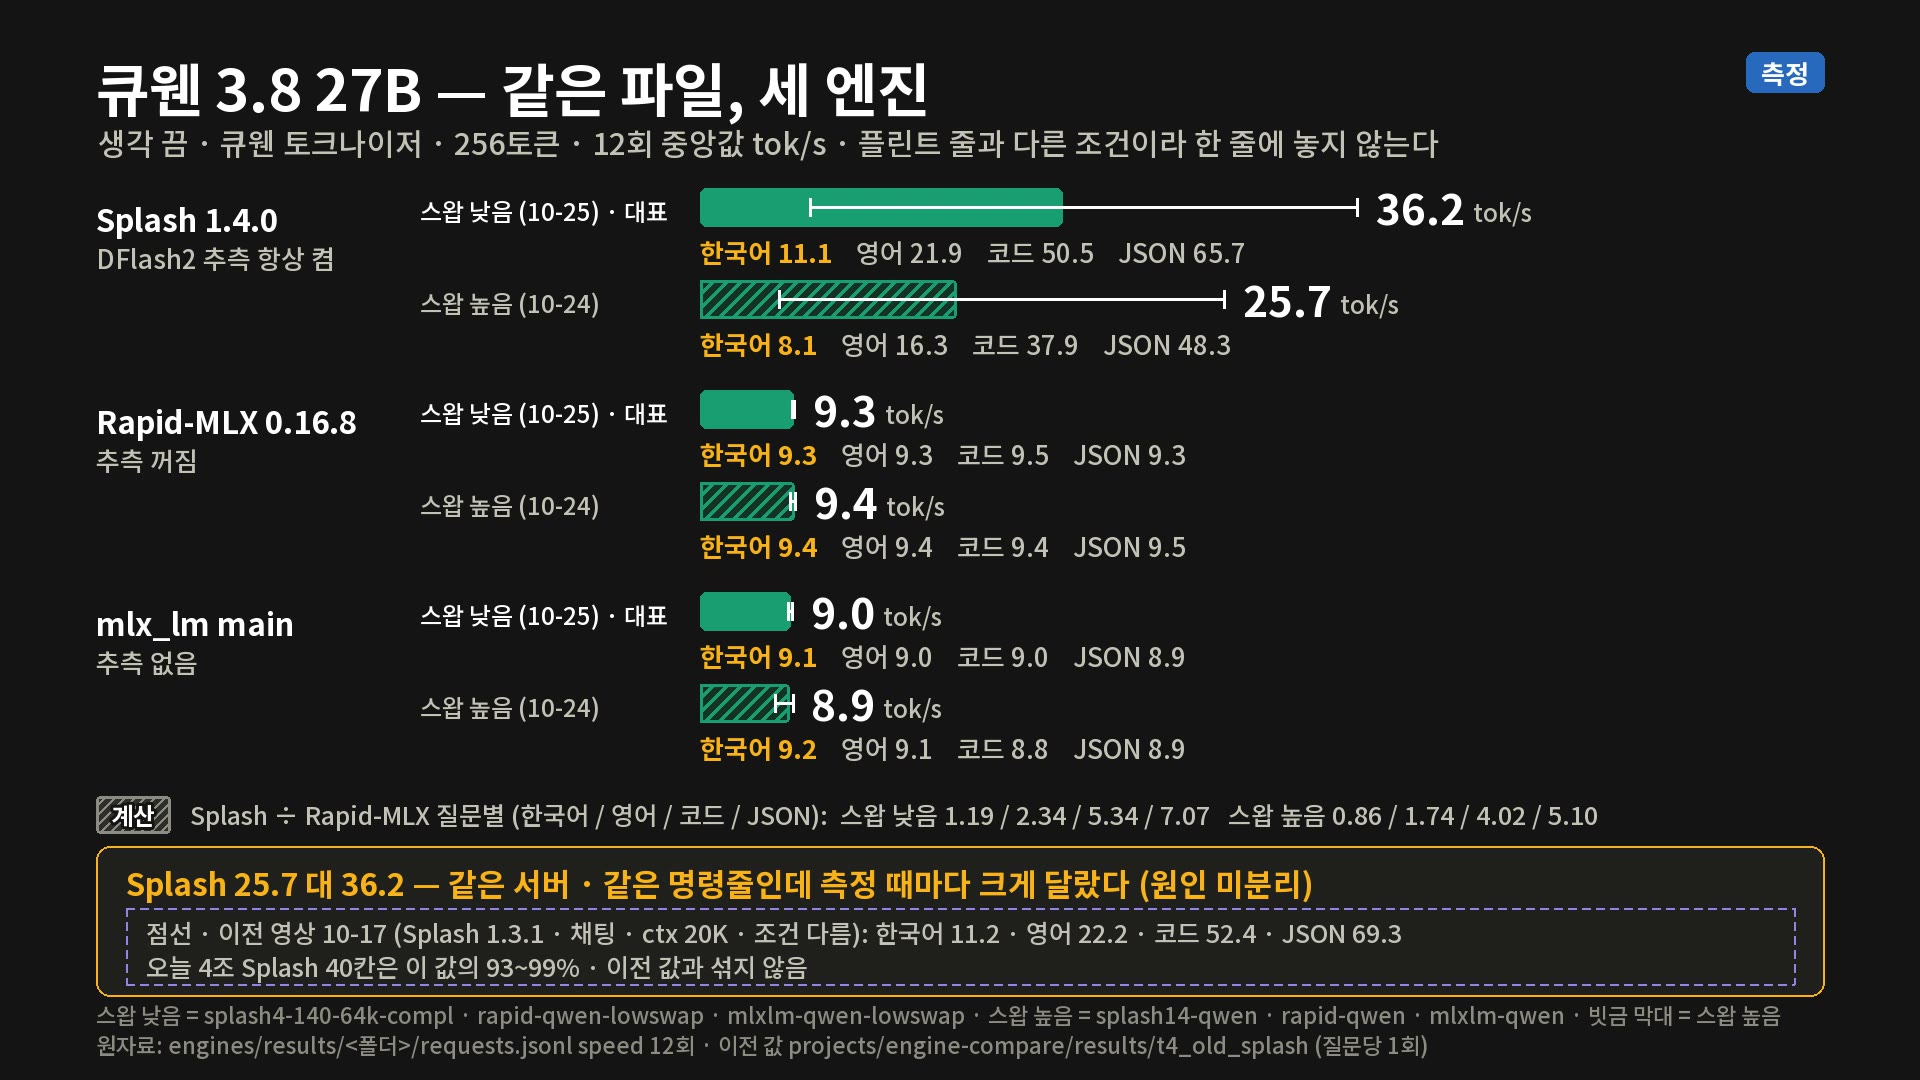
큐웬 쪽 속도는 생각을 끈 조건이라 플린트(생각 켬)와 같은 줄에 놓지 않습니다. 같은 큐웬 파일, 스왑 약 2~3GB에서 Splash 1.4는 초당 36.2토큰, Rapid-MLX 9.35, mlx_lm 9.03이었고, 한국어 질문만 보면 Splash 11.1, Rapid-MLX 9.35, mlx_lm 9.12였습니다(우리 측정). Splash는 같은 서버, 같은 인자인데 처음에는 25.7, 다시 쟀을 때 36.2로 크게 달랐고 원인은 가리지 못했습니다.
같은 llama-bench(깊이 0, 생성 128토큰)로 같은 날 두 번 재면 플린트가 큐웬의 6.25~6.35배였습니다(계산). 전날 밤에 잰 큐웬 값 7.04를 쓰면 7배대가 되고 원인은 모릅니다. 파일은 각자의 4비트입니다.
코딩 에이전트
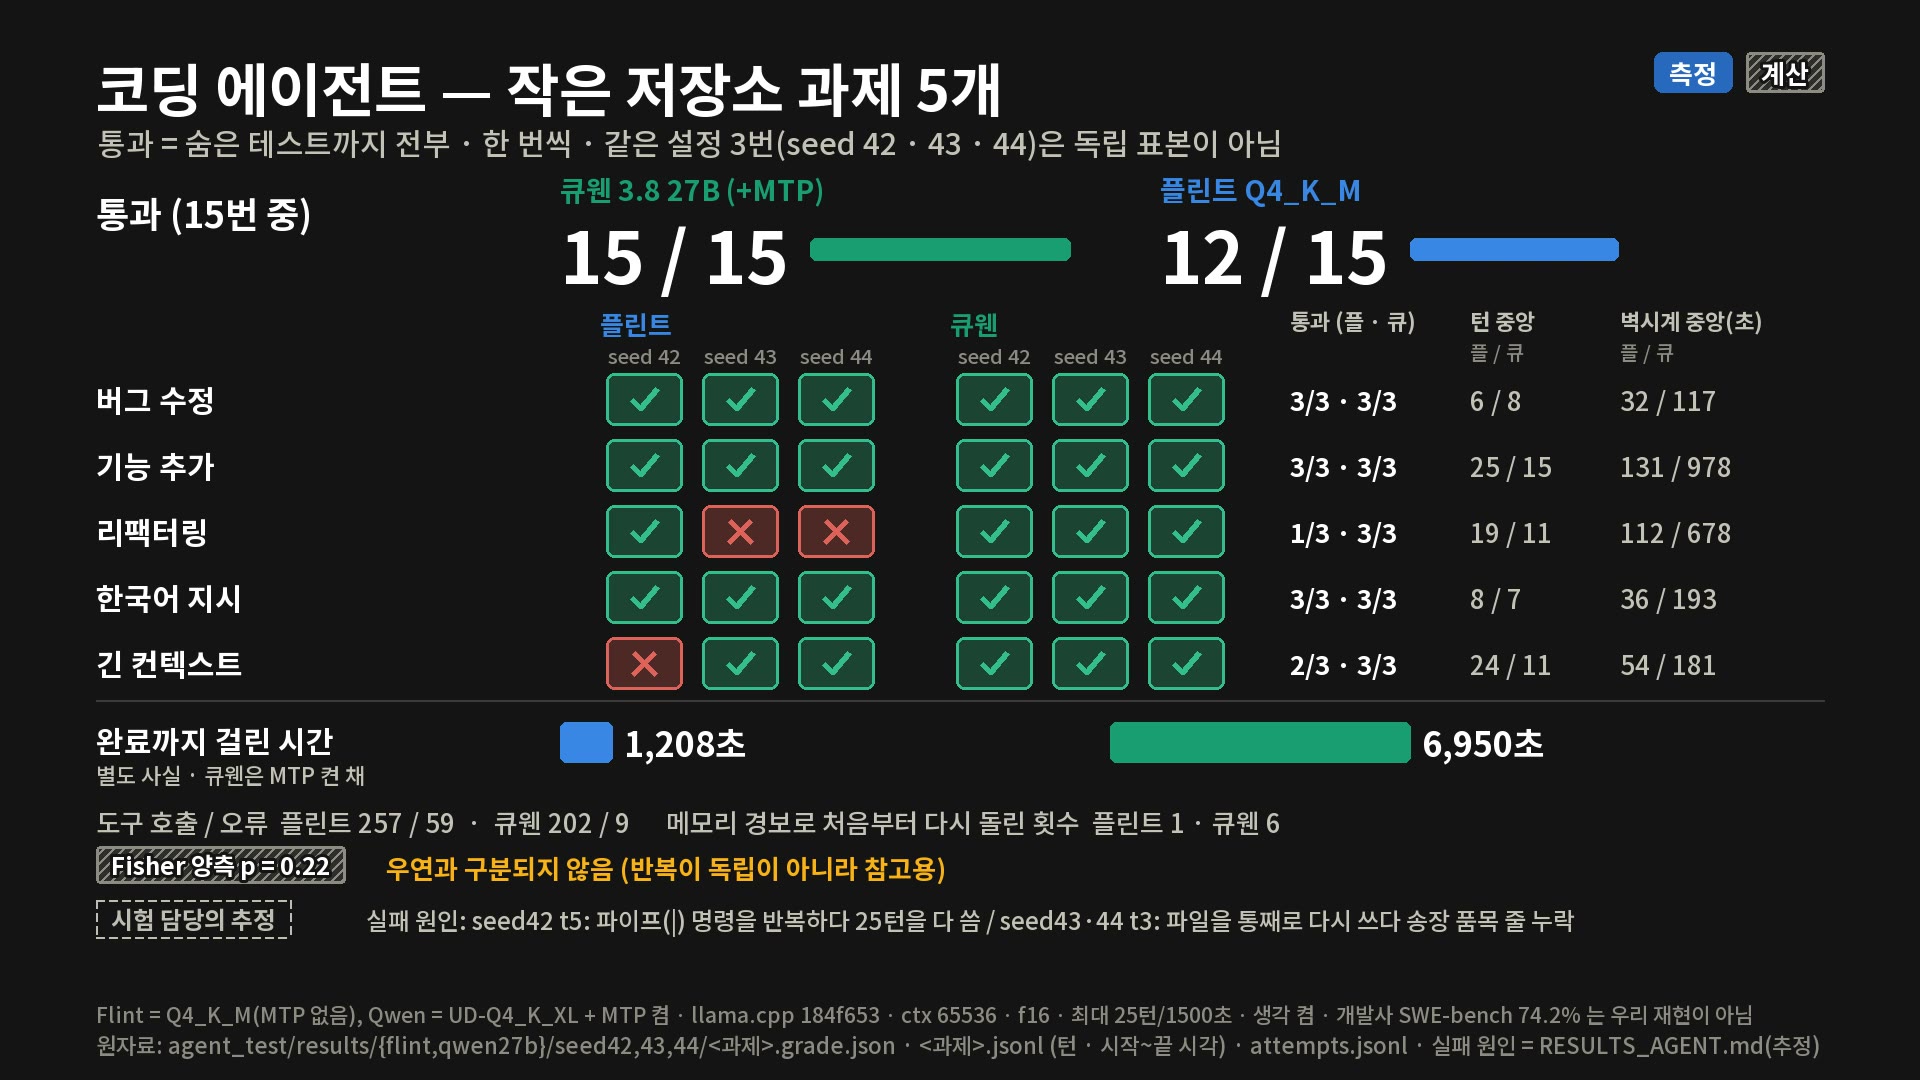
우리 코딩 52문제와 도구 호출 49과제는 에이전트 시험이 아닙니다. 그래서 작은 저장소 과제 5개(버그 수정, 기능 추가, 리팩터링, 한국어 지시, 긴 컨텍스트)를 에이전트 루프로 풀게 했습니다. 통과는 숨은 테스트까지 모두 넘기는 것이고, 시작값(seed) 42·43·44 세 개로 세 번씩, 모두 15번을 돌렸습니다(큐웬은 MTP를 켠 채).
- 15번 중 통과는 큐웬 15번, 플린트 12번입니다. 플린트는 긴 컨텍스트 과제에서 한 번, 리팩터링에서 두 번 실패했고 한국어 지시 과제는 세 번 모두 통과했습니다.
- 세 번 반복은 독립 표본이 아니므로 이 차이는 우연과 구분되지 않습니다(계산, 피셔 정확 검정 p=0.22는 참고용).
- 실패 원인은 시험 담당의 추정입니다. 긴 컨텍스트 과제는 금지된 파이프 명령을 반복하다 턴을 다 썼고, 리팩터링은 파일을 통째로 다시 쓰다 한 줄을 빠뜨렸다고 봅니다.
- 메모리 경보로 처음부터 다시 돈 것이 7번 섞여 있습니다(플린트 1, 큐웬 6).
- 15번을 끝내는 데 걸린 벽시계 시간 합은 플린트 1,208초, 큐웬(MTP 켠 채) 6,950초였습니다. 모델 속도 비교가 아니라 별도의 사실입니다.
- 도구 호출 49과제는 한 번씩 돌렸고 채점기가 글자 일치를 요구해 뜻이 맞아도 탈락한 사례가 있어, 36 대 45는 이 채점기의 통과 수입니다.
긴 컨텍스트와 기기 크기
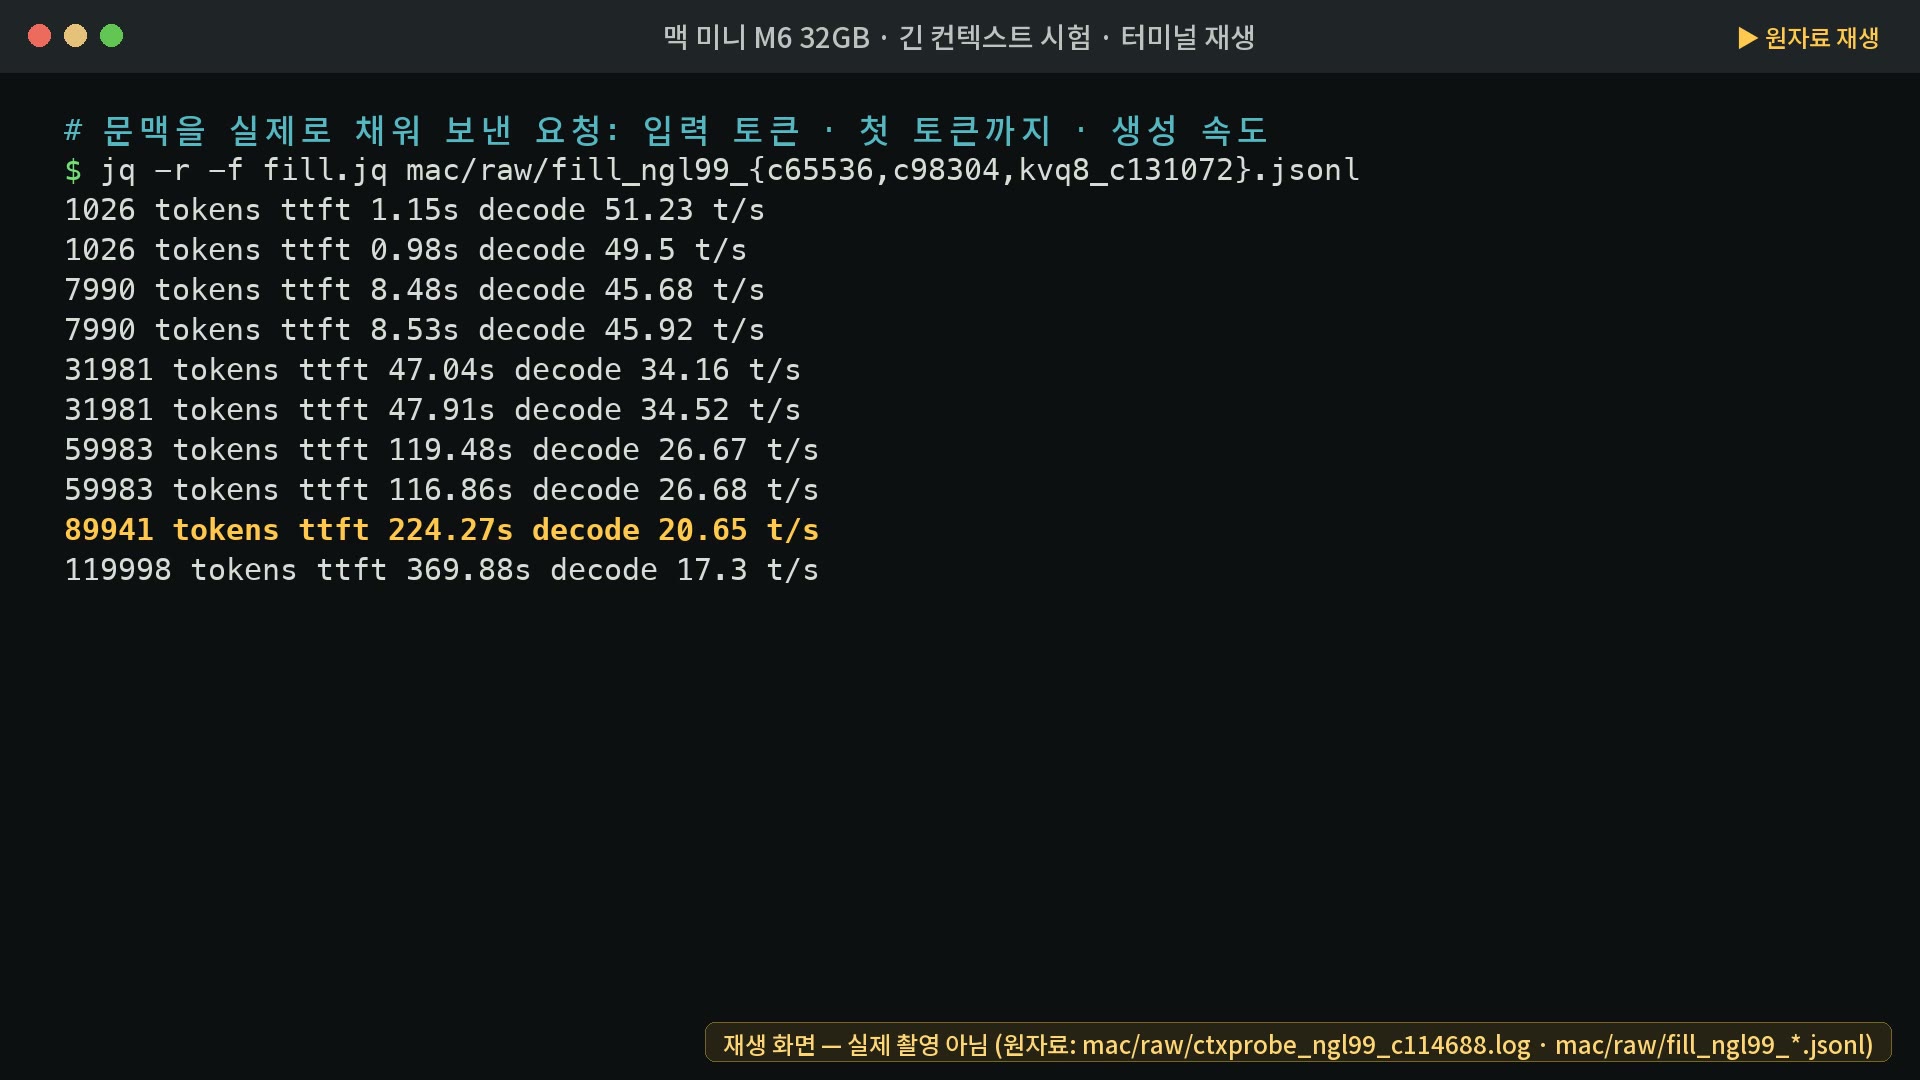
개발사 카드의 컨텍스트는 262,144토큰입니다(개발사 주장). 우리 맥 미니의 KV 16비트에서는 98,304토큰까지 서버가 시작됐고 114,688토큰에서 메모리 부족이 났으며, 그 사이는 재지 않았습니다. 서버가 시작되는 것과 그 길이를 채워 응답하는 것은 다릅니다. 실제 입력을 채워 응답까지 확인한 최대는 KV 16비트 약 9만 토큰(89,941토큰)으로, 첫 토큰까지 224.3초, 생성 초당 20.65토큰이었습니다. KV 8비트에서는 119,998토큰 입력에 첫 토큰까지 369.88초였습니다.
24GB 맥과 48GB 맥은 없어서 재지 못했습니다. 한도 비율이 기기 크기와 무관하다고 가정하면 우리 23.39GB 파일은 24GB 맥에 들어가지 않는다는 계산이 나옵니다(계산). 48GB는 Rapid-MLX 제작자가 36GB에서도 돈다고 적었습니다(타인 보고).
못 잰 것과 한계
- 개발사 속도 주장, 24GB 맥, 48GB 맥, 윈도우 실행, Ollama 기본 태그는 재지 못했습니다.
- 깨끗한 환경의 속도가 아닙니다. 속도를 잴 때 스왑이 있었습니다.
- 도구 호출은 한 번씩이라 표본이 작고, 에이전트 시험은 세 번 반복이 독립 표본이 아닙니다.
- 큐웬의 코딩 52문제와 KMMLU 완주, OpenCode 같은 실제 코딩 도구 시험은 하지 못했습니다. 입력 길이별 생성 속도도 영상에 넣지 못했습니다.
- 영상 속 터미널 화면은 측정 기록 파일을 재생한 것이며 촬영한 화면이 아닙니다.
정리하면 통과 수는 큐웬이 많았고(도구 호출 36 대 45, 코딩 에이전트 12 대 15), 걸린 시간은 플린트가 큐웬(MTP 켠 채)보다 훨씬 짧았습니다.