맥 미니 32GB 로컬 AI 엔진 8개 비교, 스플래시 JSON 69.3 vs 기준선 8.5토큰
올린 날 영상 공개
맥 미니 M6 32GB에서 로컬 AI 엔진 8개를 같은 질문으로 쟀습니다. 영어·코드·JSON은 크게 빨라졌고 한국어는 폭이 작았습니다. 속도만 잰 표이며 파일이 달라 엔진만의 효과는 아닙니다.
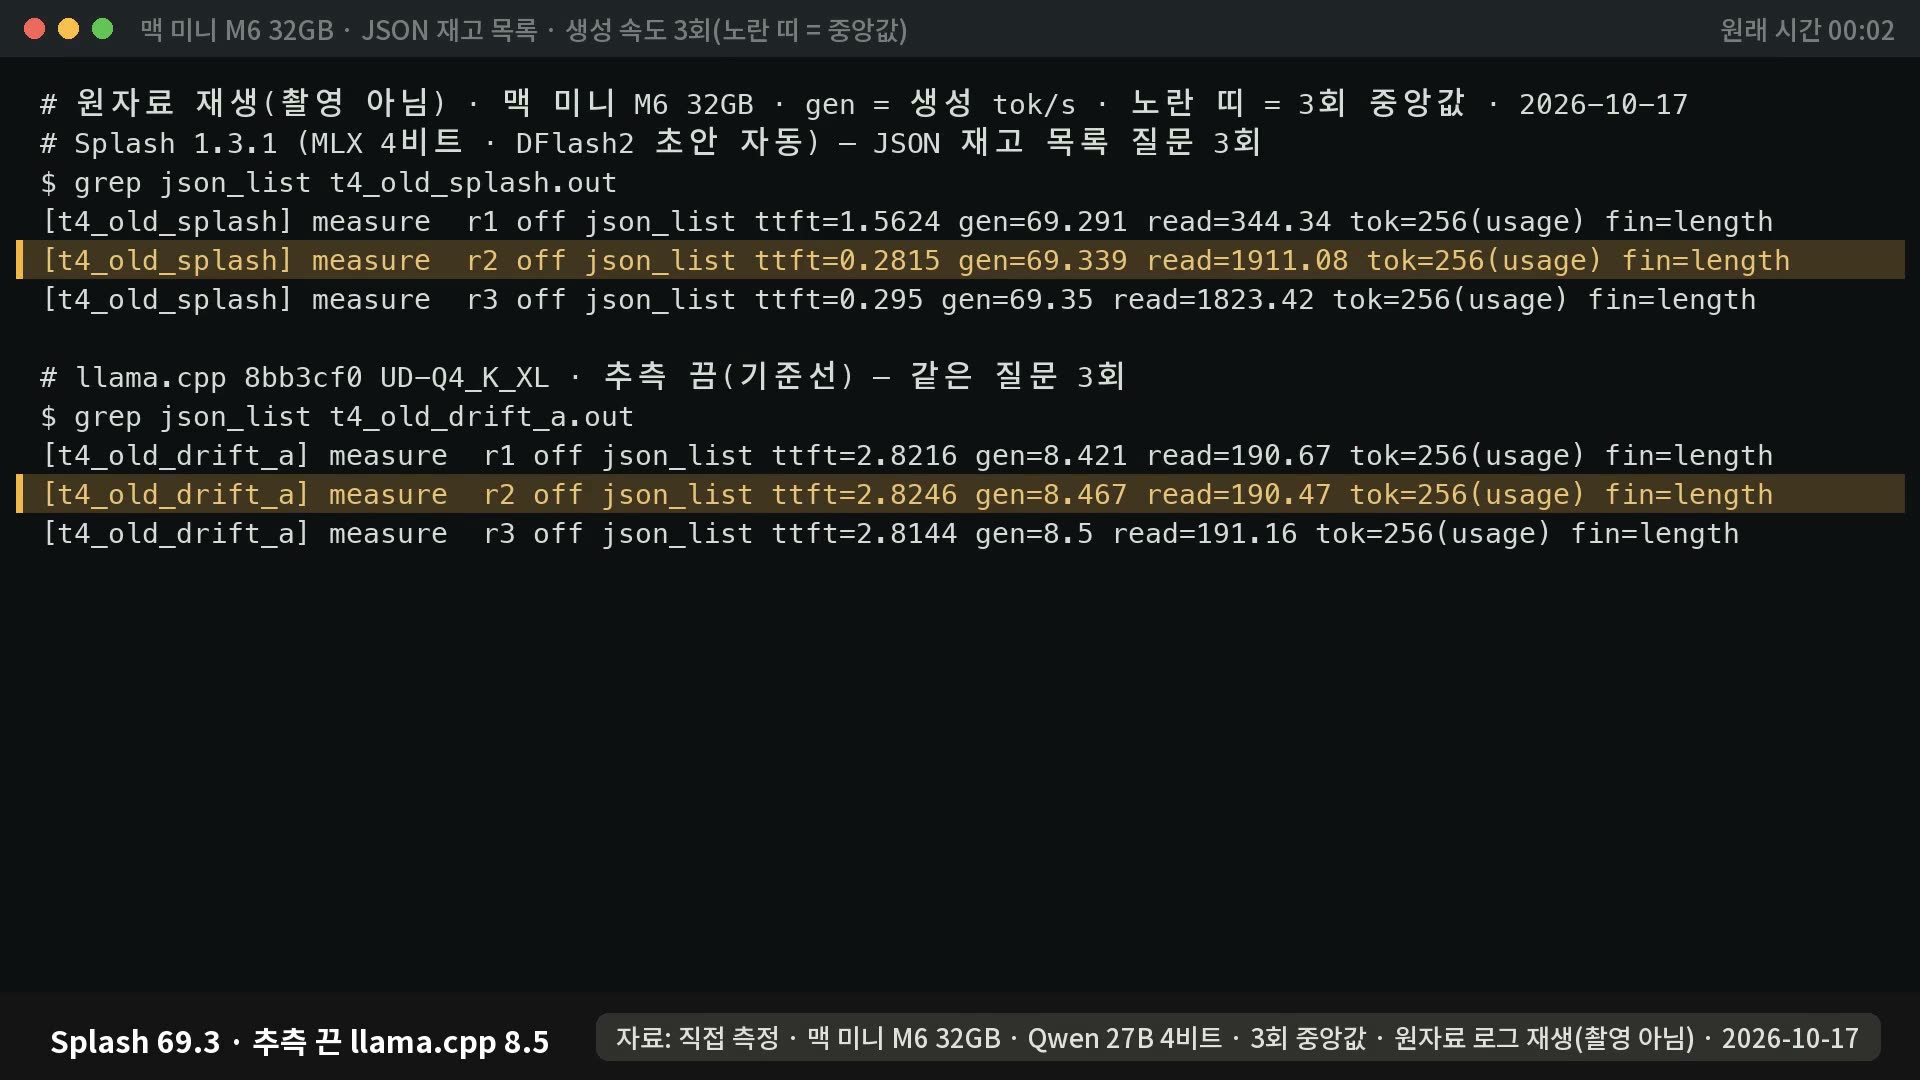
같은 맥 미니 M6 32GB, 같은 Qwen 27B, 같은 JSON 질문으로 추측을 끈 llama.cpp는 초당 8.5토큰, 스플래시(Splash)는 69.3토큰이 나왔습니다. 로컬 AI 엔진 8개(llama.cpp · mlx_lm · MTPLX · 래피드MLX(Rapid-MLX) · 스플래시 · LM Studio · 스트라타(Strata) · 스시(Sushi))를 맥 미니 한 대에서 같은 질문으로 재 본 기록입니다. 모두 속도만 잰 표이고 파일이 서로 달라 엔진만의 효과는 아닙니다. 기준일은 영상 공개일인 2026-10-17입니다.
결론 먼저
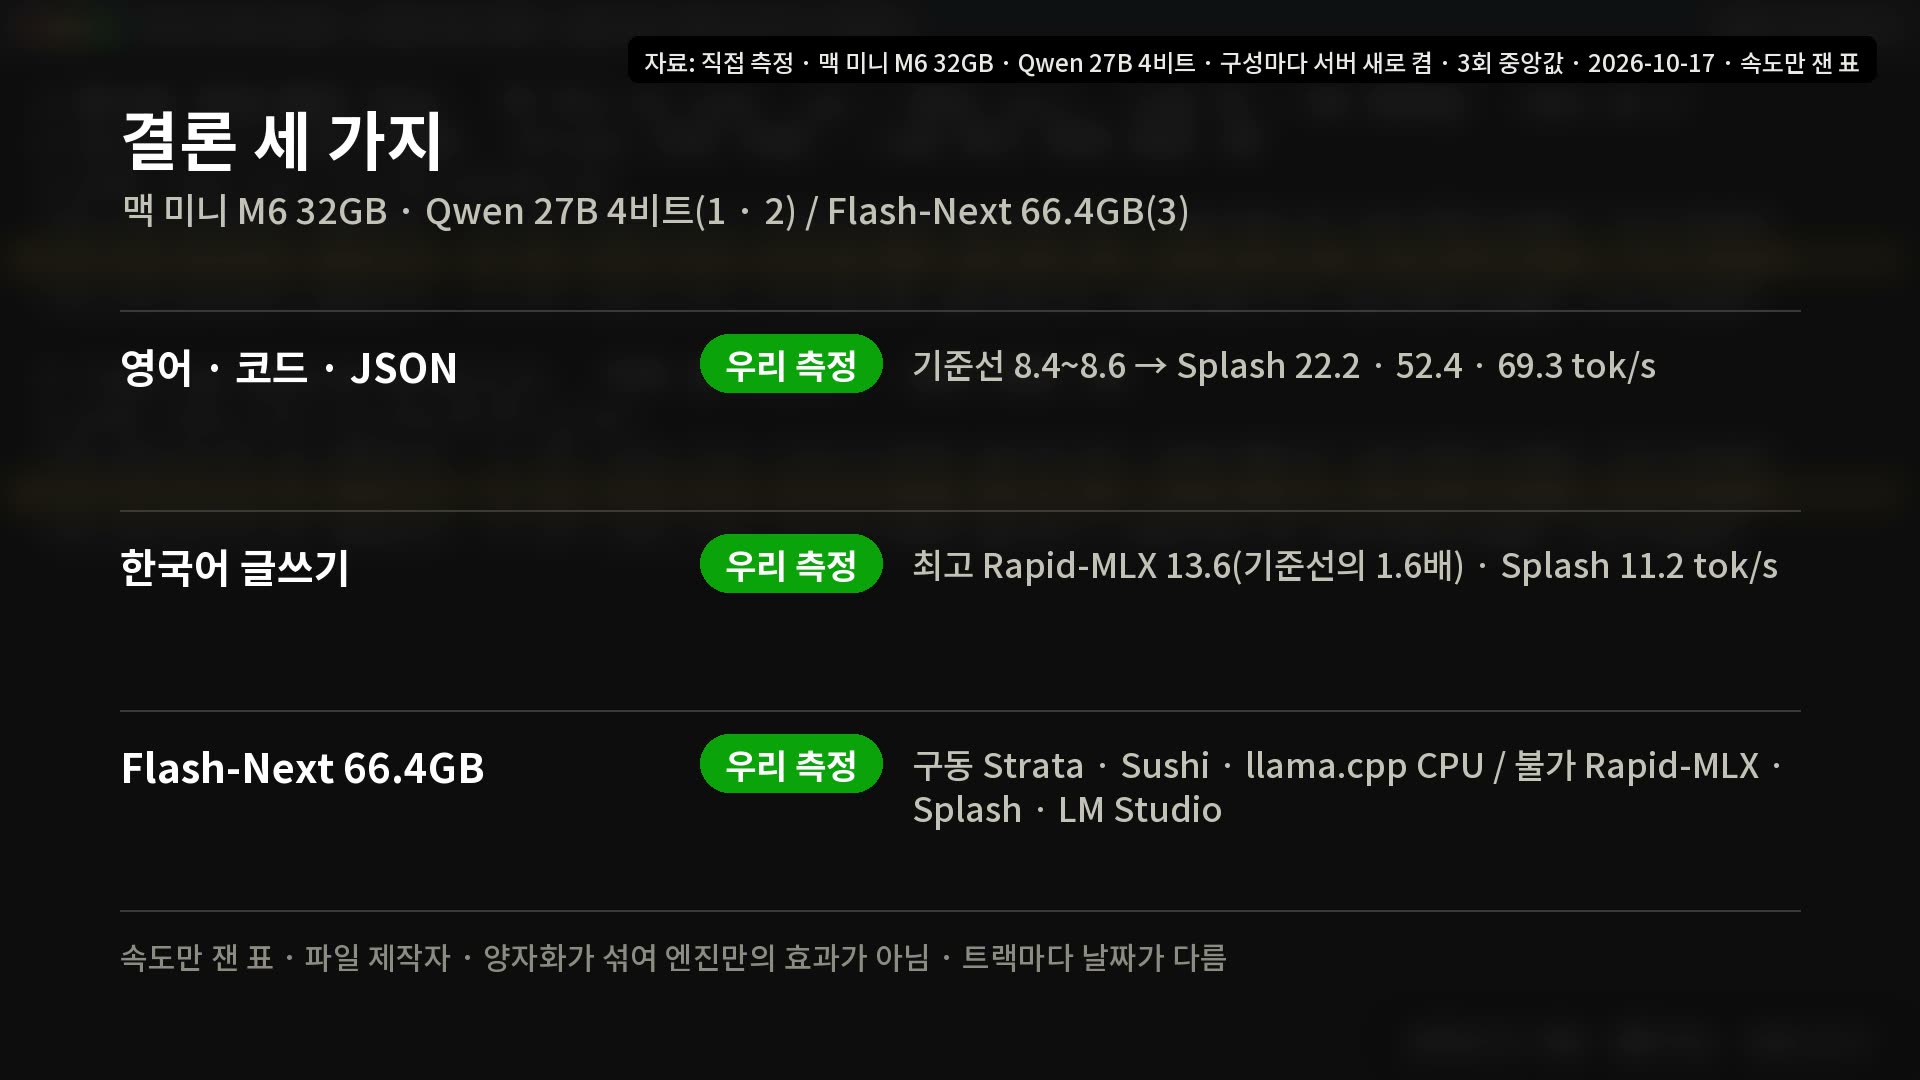
- 영어·코드·JSON은 크게 빨라졌습니다. 추측을 끈 기준선이 8.4~8.6토큰인데, 스플래시는 영어 22.2 · 코드 52.4 · JSON 69.3토큰이었습니다 [우리 측정].
- 한국어 글쓰기는 폭이 작았습니다. 가장 잘 나온 래피드MLX가 13.6토큰으로 기준선의 1.6배 [계산], 스플래시는 11.2토큰이었습니다 [우리 측정].
- 66.4GB Flash-Next는 엔진 선택지가 좁았습니다. 32GB 맥 미니에서는 스트라타 · 스시 · llama.cpp CPU만 돌았고 래피드MLX · 스플래시 · LM Studio는 못 돌렸습니다 [우리 측정]. 모델이 달라 Qwen 27B 속도와 줄을 세우지 않았습니다.
숫자의 종류
- 우리 측정: 맥 미니 Apple M6 32GB 한 대, macOS 27.2. 구성마다 서버를 새로 켜고 3회 중앙값, 채팅 방식, 생각 끔, 온도 0, 최대 256토큰.
- 계산: 우리 측정값끼리 나눈 배수와 퍼센트 차이.
- 제작자 문서: 래피드MLX의 팩 크기, 스플래시의 최소 메모리 등(재지 않음).
- 10-11 영상 값 인용: 양자화 품질(KL, 이번에는 다시 재지 않음).
질문은 한국어 글쓰기 · 영어 글쓰기 · 코드 · JSON 재고 목록 네 가지로 10월 11일 영상과 같습니다. 그 영상의 '가장 빠른 조합'에는 스플래시가 빠져 있어서 이번에 같은 질문으로 쟀습니다.
Qwen 27B 4비트: 질문마다 1위가 달랐습니다
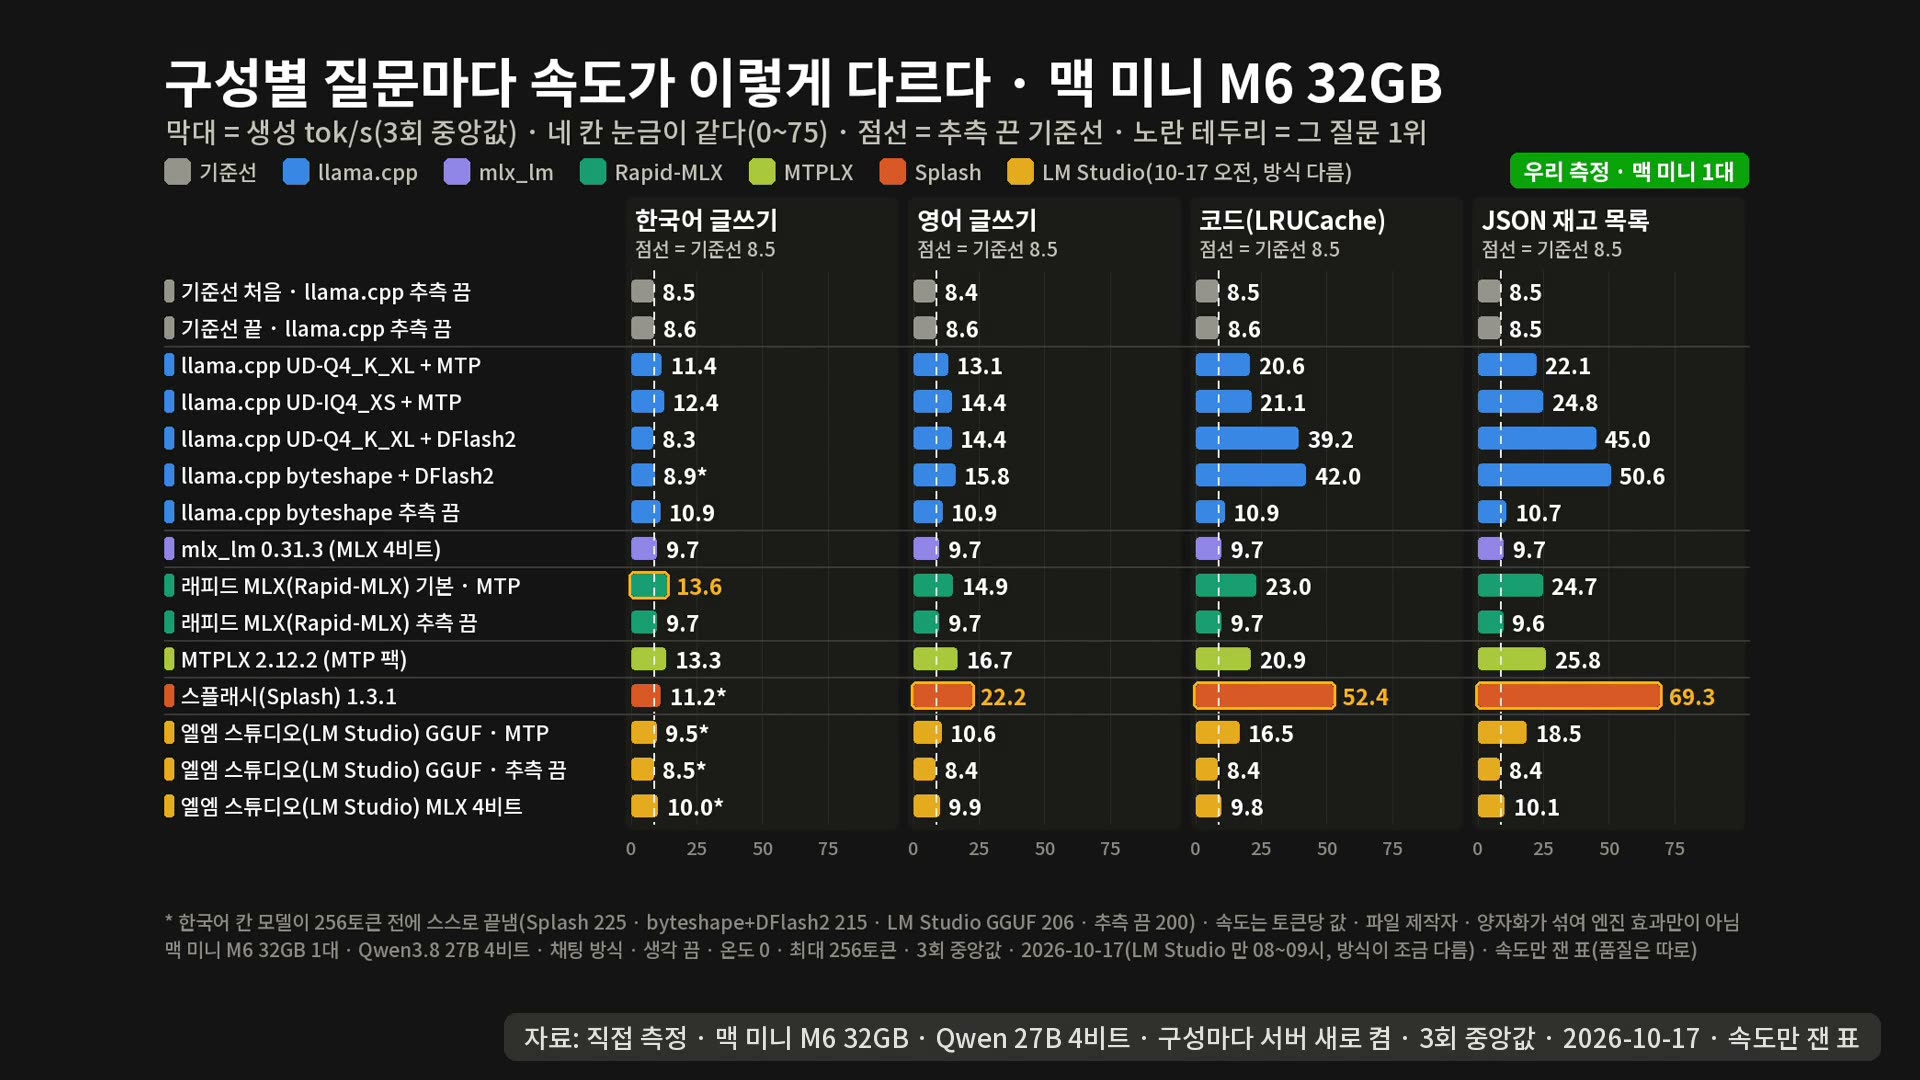
기준선은 llama.cpp UD-Q4_K_XL에서 추측(speculative) 디코딩을 끈 구성이고, 네 질문 모두 8.4~8.6토큰입니다. 추측 디코딩은 다음 토큰 몇 개를 미리 짐작해 한꺼번에 확인하는 방식으로, MTP와 DFlash2가 여기에 듭니다. 스플래시는 DFlash2 초안이 자동으로 붙는 구성입니다.
생성 속도(tok/s, 3회 중앙값, 2026-10-17, 우리 측정):
| 구성 | 한국어 | 영어 | 코드 | JSON |
|---|---|---|---|---|
| 기준선 llama.cpp UD-Q4_K_XL 추측 끔(처음/끝) | 8.5/8.6 | 8.4/8.6 | 8.5/8.6 | 8.5/8.5 |
| 스플래시 1.3.1 (MLX 4비트 · DFlash2 자동) | 11.2 | 22.2 | 52.4 | 69.3 |
| 래피드MLX 0.16.1 기본(MTP) | 13.6 | 14.9 | 23.0 | 24.7 |
| 래피드MLX 추측 끔 | 9.7 | 9.7 | 9.7 | 9.6 |
| MTPLX 2.12.2 | 13.3 | 16.7 | 20.9 | 25.8 |
| mlx_lm 0.31.3 | 9.7 | 9.7 | 9.7 | 9.7 |
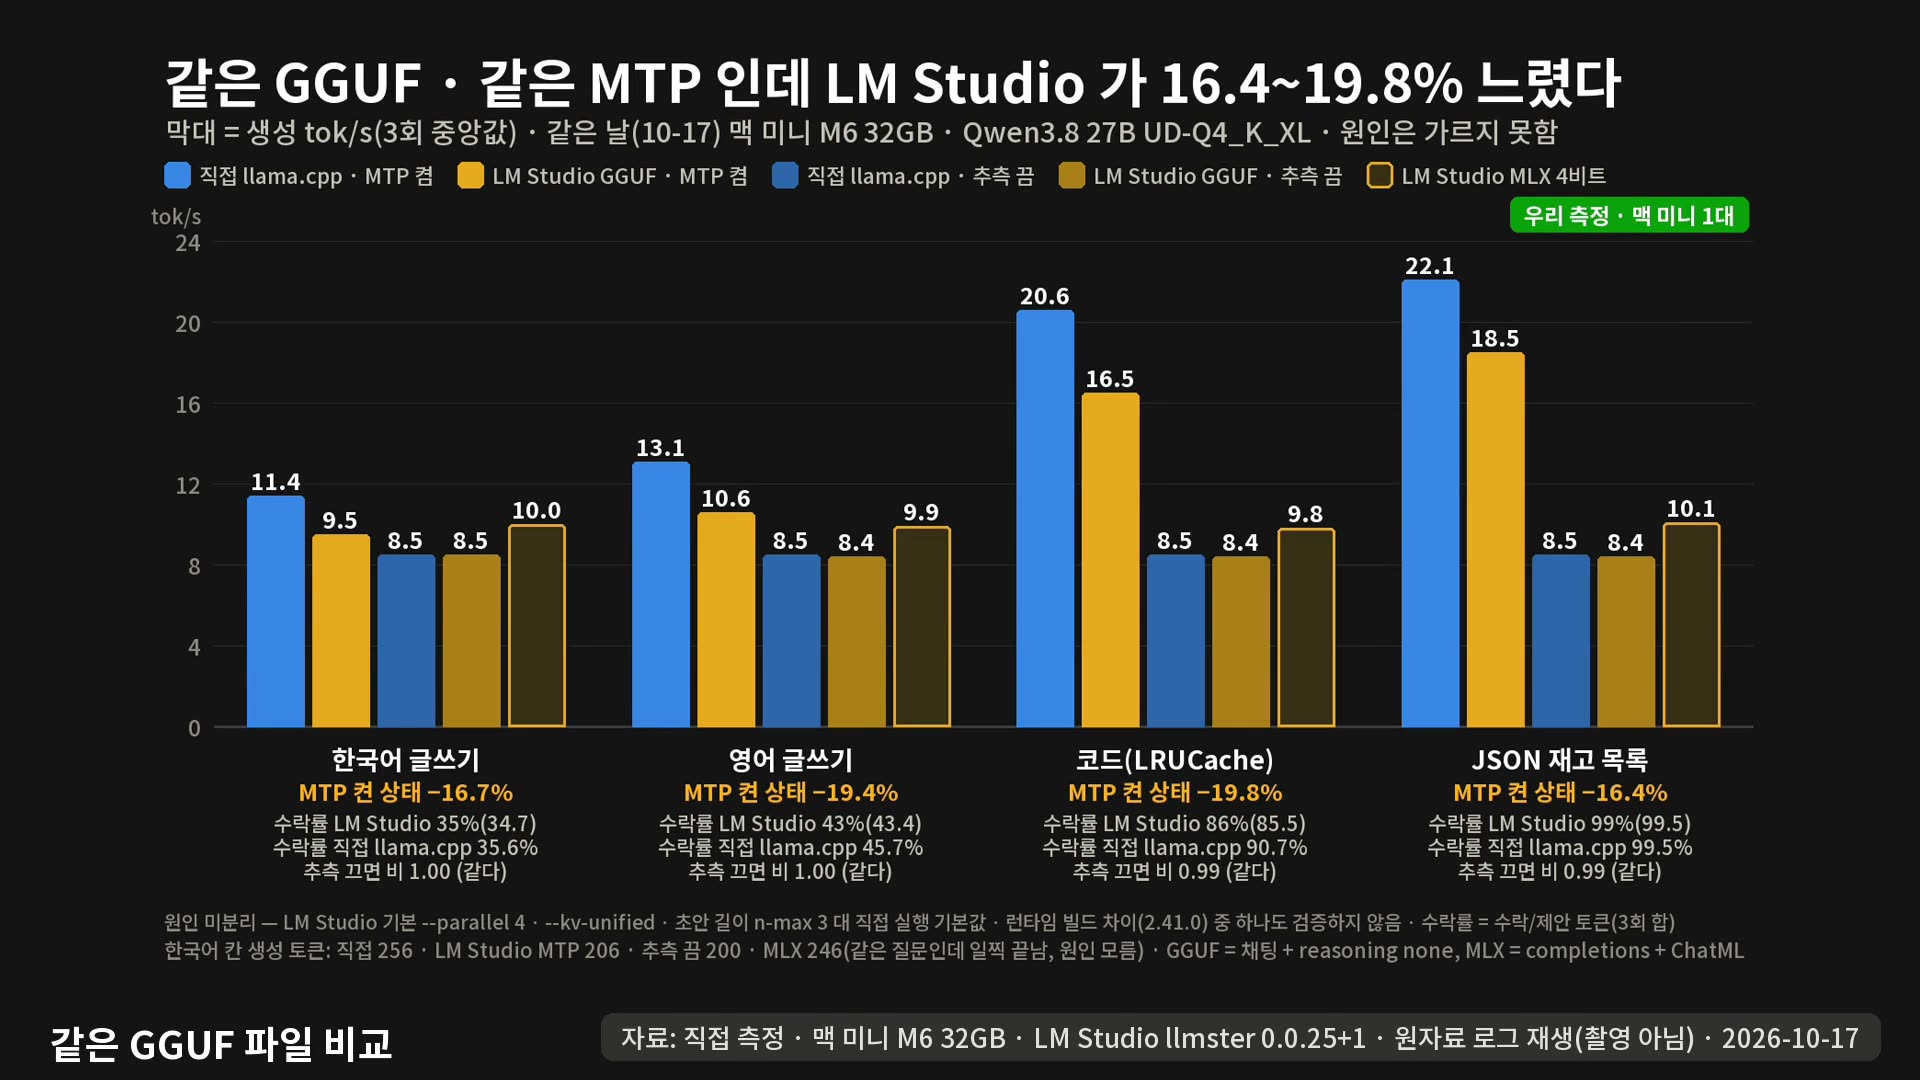
| llama.cpp UD-Q4_K_XL + MTP | 11.4 | 13.1 | 20.6 | 22.1 |
| llama.cpp UD-Q4_K_XL + DFlash2 | 8.3 | 14.4 | 39.2 | 45.0 |
| llama.cpp UD-IQ4_XS + MTP | 12.4 | 14.4 | 21.1 | 24.8 |
| llama.cpp byteshape + DFlash2 | 8.9 | 15.8 | 42.0 | 50.6 |
| llama.cpp byteshape 추측 끔 | 10.9 | 10.9 | 10.9 | 10.7 |
| LM Studio GGUF MTP 기본 | 9.5 | 10.6 | 16.5 | 18.5 |
| LM Studio GGUF 추측 끔 | 8.5 | 8.4 | 8.4 | 8.4 |
| LM Studio MLX 4비트 | 10.0 | 9.9 | 9.8 | 10.1 |
- 영어·코드·JSON 1위는 스플래시입니다. 한국어는 래피드MLX 13.6 · MTPLX 13.3 · UD-IQ4_XS에 MTP를 켠 llama.cpp 12.4토큰 순이었습니다.
- 질문별 1위 구성이 기준선보다 빨라진 배수는 한국어 1.6 · 영어 2.6 · 코드 6.2 · JSON 8.2배입니다 [계산]. 기준선이 다른 파일이라 엔진 효과만은 아닙니다.
- 같은 MLX 4비트 가중치를 쓴 엔진끼리 JSON을 보면 추측을 끈 mlx_lm 9.7, MTP를 켠 래피드MLX 24.7, DFlash2가 붙은 스플래시 69.3토큰입니다.
- llama.cpp에서 DFlash2는 한국어에 거의 도움이 안 됐습니다. byteshape 파일은 추측을 끄면 10.9인데 DFlash2를 켜면 8.9였습니다. DFlash2가 맞힌 비율은 UD-Q4_K_XL 한국어 6.7%, 코드 86.2%였습니다. 이것이 이유인지는 가려내지 못했습니다.
코드와 JSON에서 2위인 byteshape 파일은 llama.cpp 파일 중 가장 작지만, 10월 11일 영상에서 UD-Q6_K와 견준 KL(한국어/영문)이 UD-Q4_K_XL 0.0068/0.0236 · UD-IQ4_XS 0.0226/0.0621 · byteshape 0.0507/0.1146으로 더 컸습니다(클수록 UD-Q6_K 분포에서 멉니다). MLX · MTPLX 파일의 품질은 재지 않았습니다.
LM Studio는 같은 파일의 직접 llama.cpp보다 느렸습니다
화면 없는 버전 llmster로 같은 GGUF 파일을 돌렸고, 기본 설정에 MTP가 켜져 있었습니다. 한국어 9.5 · 영어 10.6 · 코드 16.5 · JSON 18.5토큰으로, 같은 파일을 직접 돌린 llama.cpp MTP보다 16.4~19.8% 느렸습니다 [계산]. 추측을 끄면 기준선과 같았습니다. 원인은 가려내지 못했습니다. LM Studio 로그의 MTP 수락률은 한국어 35 · 영어 43 · 코드 86 · JSON 99%였고, DFlash2 초안은 켜지 못했습니다.
엔진 한 줄씩
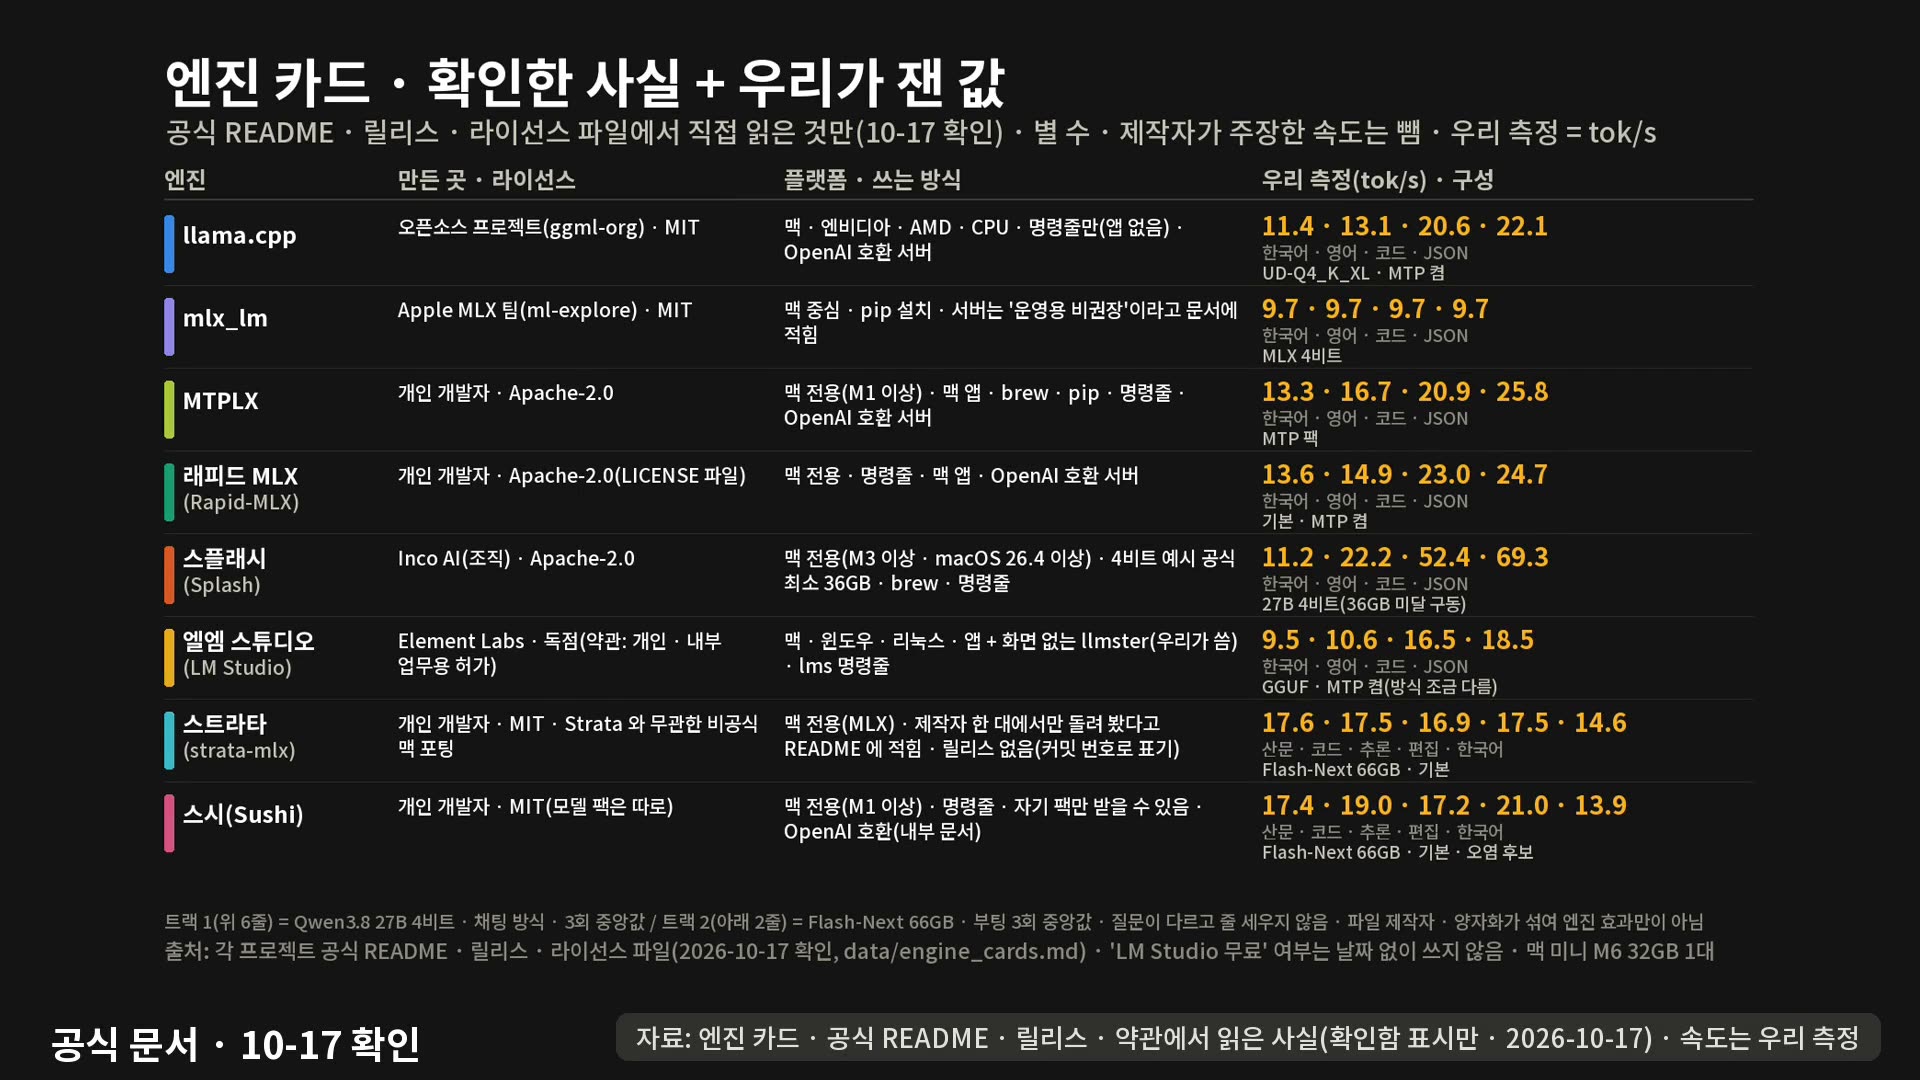
- 앱이 따로 있어 명령줄 없이 시작할 수 있는 것은 LM Studio · MTPLX · 래피드MLX입니다. 나머지는 명령줄로 설치하고 서버를 켭니다.
- MTPLX · 래피드MLX · 스플래시 · 스시 · strata-mlx는 맥 전용입니다. LM Studio는 소스가 비공개, llama.cpp는 MIT 오픈소스입니다.
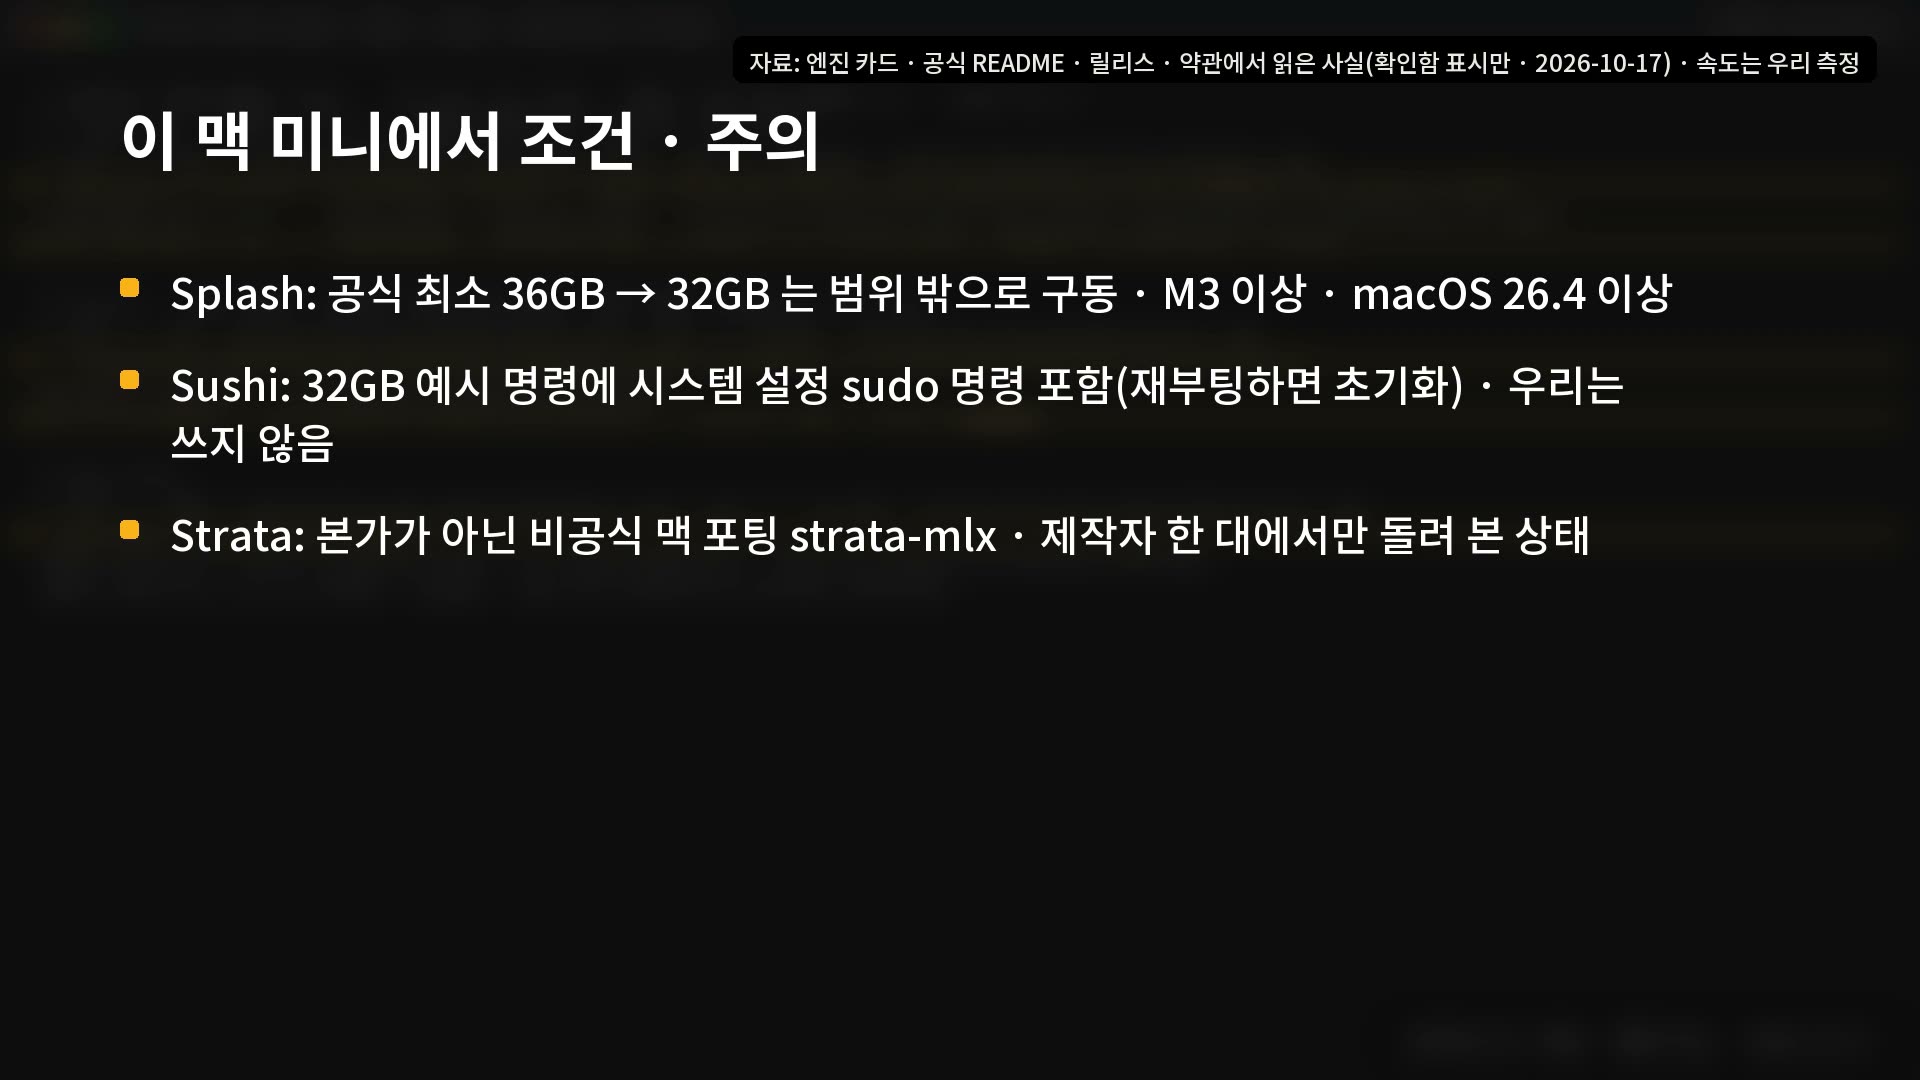
- 스플래시는 공식 최소가 36GB라 이 32GB 맥 미니는 범위 밖이고, 비공식으로 Qwen 27B를 구동했습니다 [제작자 문서].
- 스시의 32GB 예시 명령에는 시스템 설정을 바꾸는 sudo 명령이 있어 쓰지 않았습니다. 여기서 스트라타는 본가가 아닌 비공식 맥 포팅 strata-mlx입니다.
큰 모델 Flash-Next 66.4GB
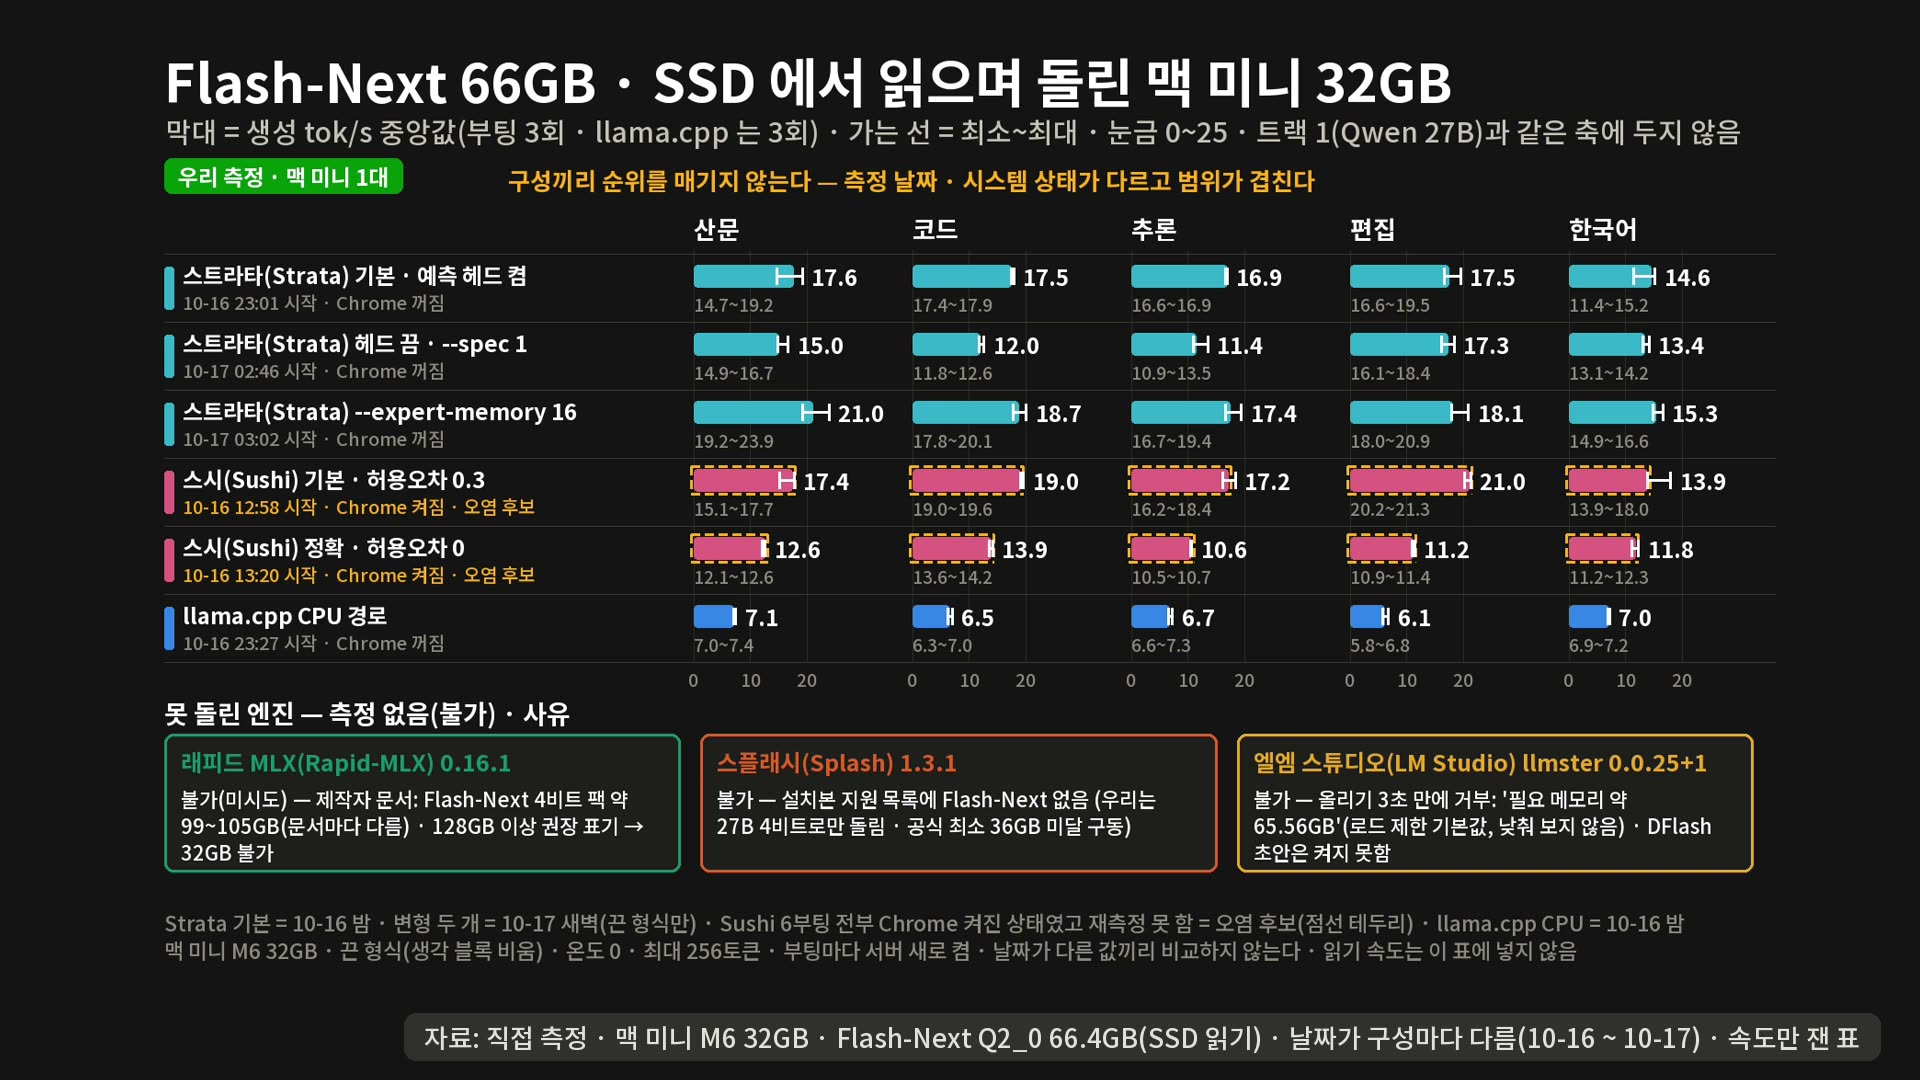
Flash-Next Q2_0은 66.4GB라 32GB 메모리에 들어가지 않아 SSD에서 읽어 가며 돕니다. 질문은 산문 · 코드 · 추론 · 편집 · 한국어 다섯 가지이고, 부팅 3회 중앙값입니다. 측정 날짜가 구성마다 달라 서로 순위를 매기지 않았습니다.
생성 속도(tok/s, 우리 측정):
| 구성 | 산문 | 코드 | 추론 | 편집 | 한국어 |
|---|---|---|---|---|---|
| 스트라타 기본 · 10-16 밤 | 17.6 | 17.5 | 16.9 | 17.5 | 14.6 |
| 스트라타 헤드 끔 · 10-17 새벽 | 15.0 | 12.0 | 11.4 | 17.3 | 13.4 |
| 스트라타 expert-memory 16 · 10-17 새벽 | 21.0 | 18.7 | 17.4 | 18.1 | 15.3 |
| 스시 1.2.3 기본 · 10-16 오후 | 17.4 | 19.0 | 17.2 | 21.0 | 13.9 |
| 스시 1.2.3 정확 · 10-16 오후 | 12.6 | 13.9 | 10.6 | 11.2 | 11.8 |
| llama.cpp CPU · 10-16 밤 | 7.1 | 6.5 | 6.7 | 6.1 | 7.0 |
- 스시는 크롬(Chrome)이 켜져 있던 날 쟀고 재측정을 못 해 오염 후보입니다. 이전 영상 값보다 5~25% 낮았고 이유는 가려내지 못했습니다.
- 못 돌린 것: 래피드MLX는 제작자 문서에 팩이 약 99~105GB(문서마다 다름)라고 적혀 있어 32GB에서는 시도하지 않았습니다 [제작자 문서]. 스플래시는 설치본 지원 목록에 Flash-Next가 없었습니다. LM Studio는 필요 메모리 65.56GB라며 3초 만에 로드를 거부했고, 가드레일은 풀어 보지 않았습니다.
용도별로 보면(승패가 아니라 이 조건에서의 방향)
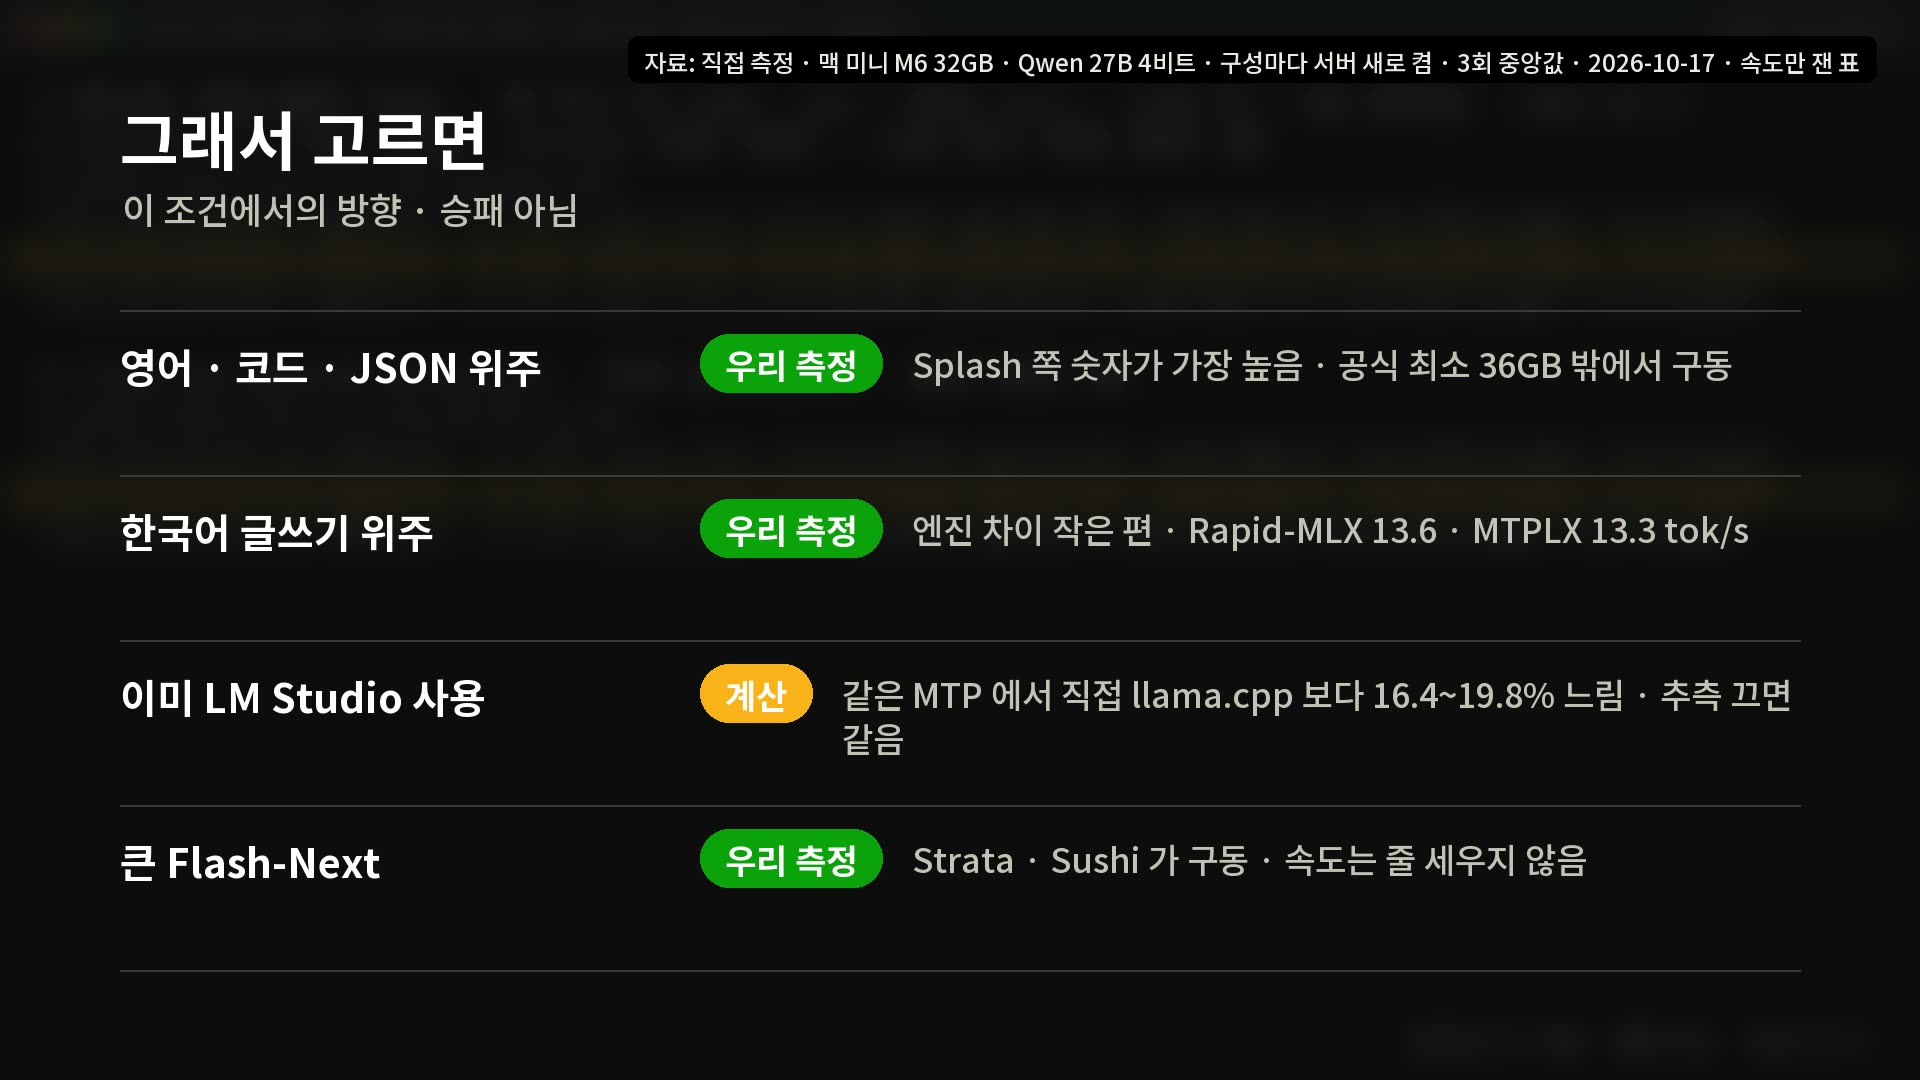
- 영어·코드·JSON 위주라면 스플래시 쪽 숫자가 가장 높았지만, 공식 최소 36GB 밖에서 돌린 값입니다 [우리 측정].
- 한국어 글쓰기 위주라면 엔진을 바꿔도 늘어난 폭이 가장 작았고, 래피드MLX와 MTPLX가 13토큰대로 앞섰습니다 [우리 측정].
- 이미 LM Studio를 쓴다면 같은 MTP에서 직접 llama.cpp보다 16~20% 느렸고, 추측을 끄면 같았습니다 [계산].
- 큰 Flash-Next는 스트라타와 스시 쪽이 돌았습니다.
한계와 확인하지 못한 것
- 속도만 잰 표입니다. 파일 제작자와 양자화(UD-Q4_K_XL · UD-IQ4_XS · byteshape · MLX 4비트)가 섞여 있어 엔진만의 효과가 아닙니다.
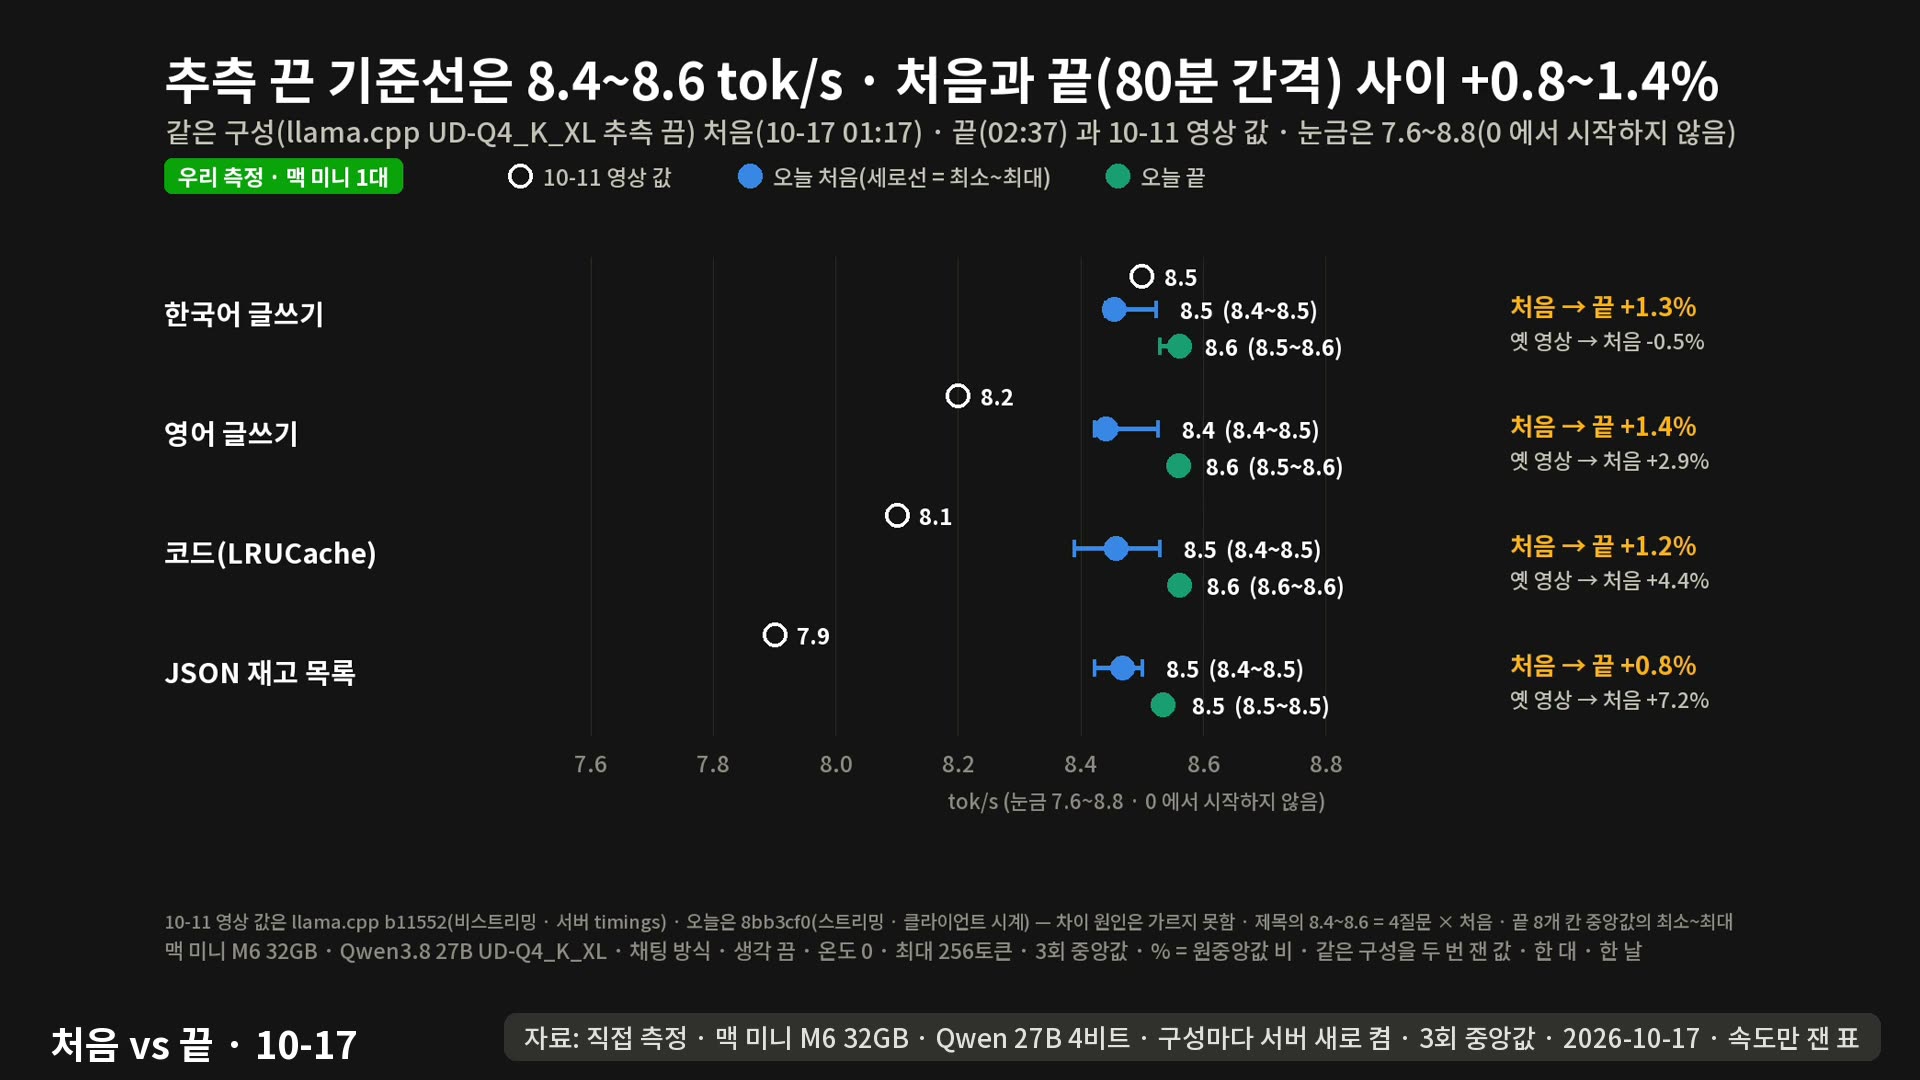
- 기준선을 처음과 끝에 두 번 재 보니 0.8~1.4% 흔들렸습니다. 10월 11일 영상 값과는 36칸 중 28칸이 3% 안이었고 최대 8% 달랐으며, 원인은 가려내지 못했습니다.
- LM Studio가 느린 이유, DFlash2가 한국어에서 약한 이유, 스시 값이 낮았던 이유는 가려내지 못했습니다. 한 대에서 3회 잰 값이라 다른 맥이나 파일에서는 달라질 수 있습니다.
기준일
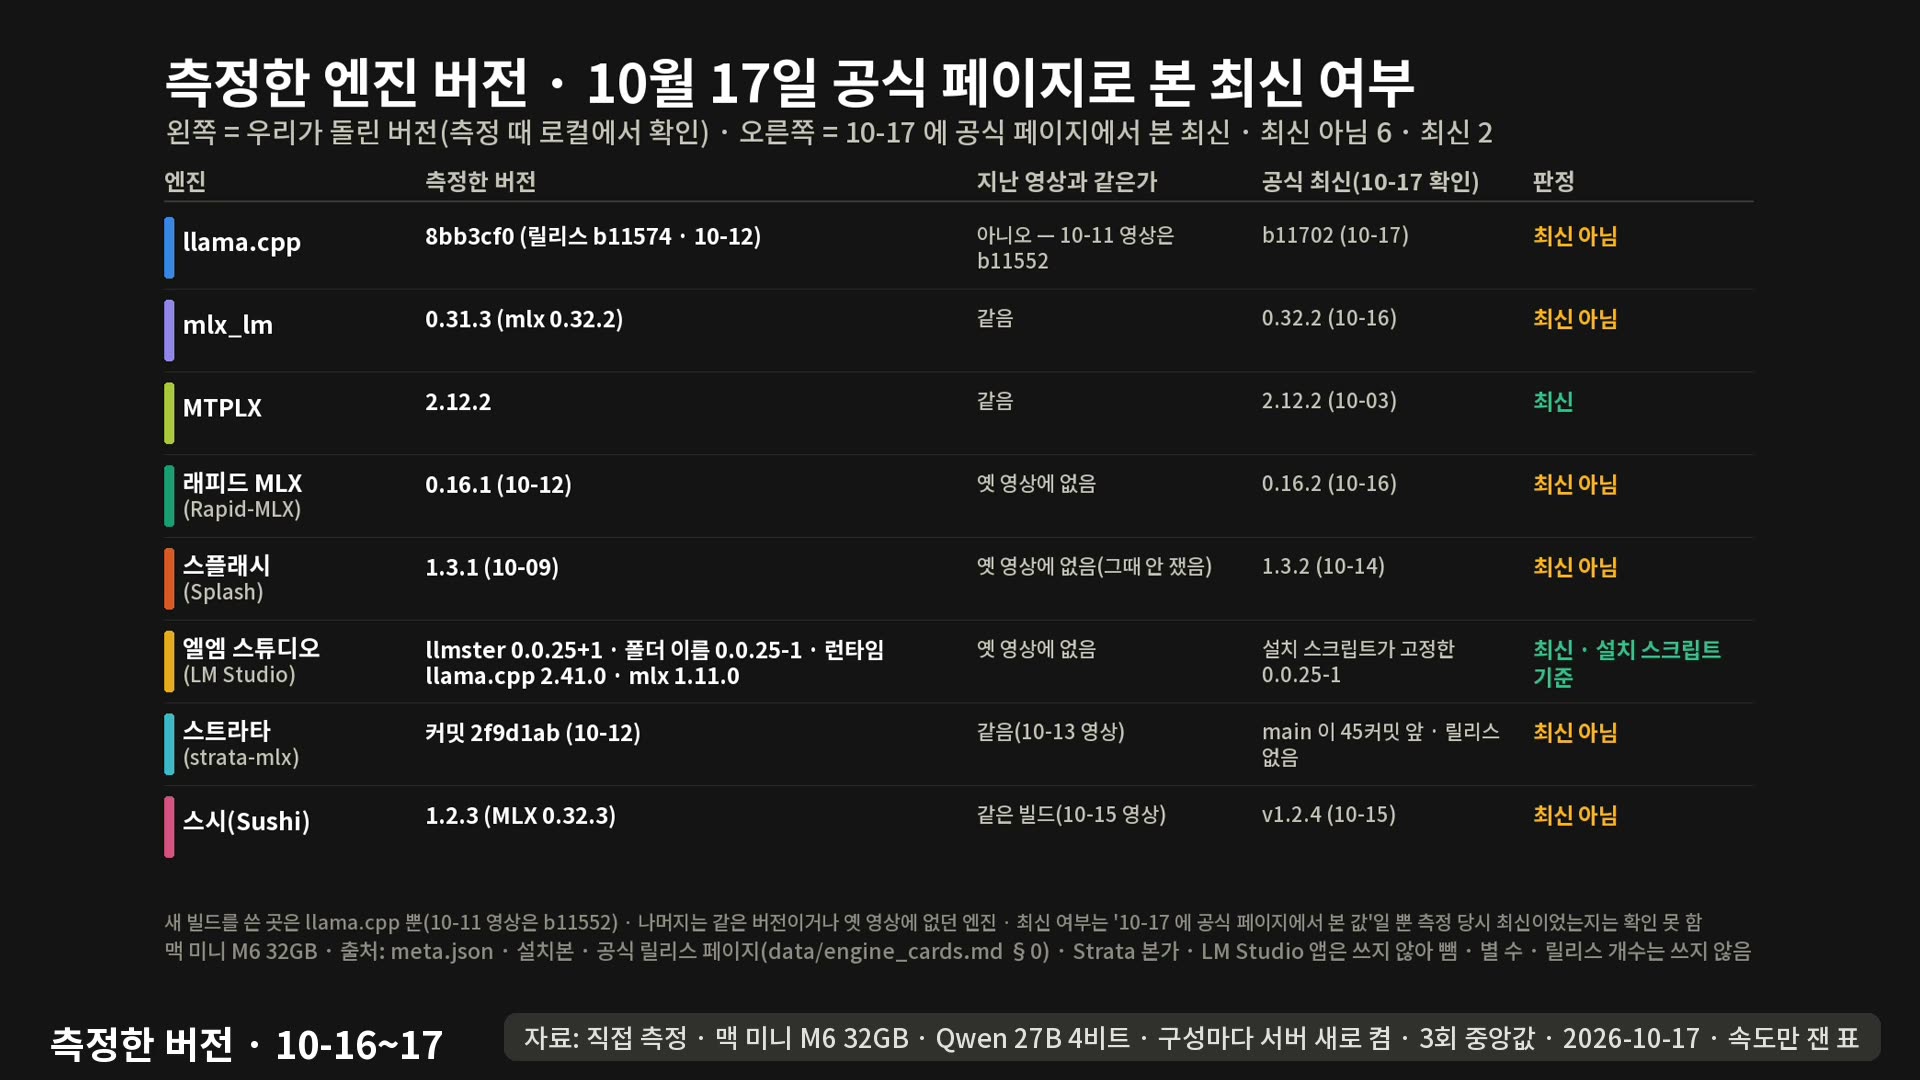
측정은 2026-10-16~17에 했고, 측정한 버전은 llama.cpp 8bb3cf0 · mlx_lm 0.31.3 · MTPLX 2.12.2 · 래피드MLX 0.16.1 · 스플래시 1.3.1 · 스시 1.2.3 · strata-mlx 2f9d1ab · LM Studio llmster 0.0.25+1입니다. 영상 공개일 기준으로 공식 페이지에는 MTPLX와 LM Studio(설치 스크립트 기준)를 뺀 엔진에 더 새 버전이 있었고, 측정 당시 최신이었는지는 확인하지 못했습니다. 이후 버전이 바뀌었을 수 있어 현재 속도는 확인하지 않았습니다.