맥 미니 M6 구독 없이 목소리 복제·작곡·받아쓰기, 로컬 AI 8종 유료와 비교
올린 날 영상 공개
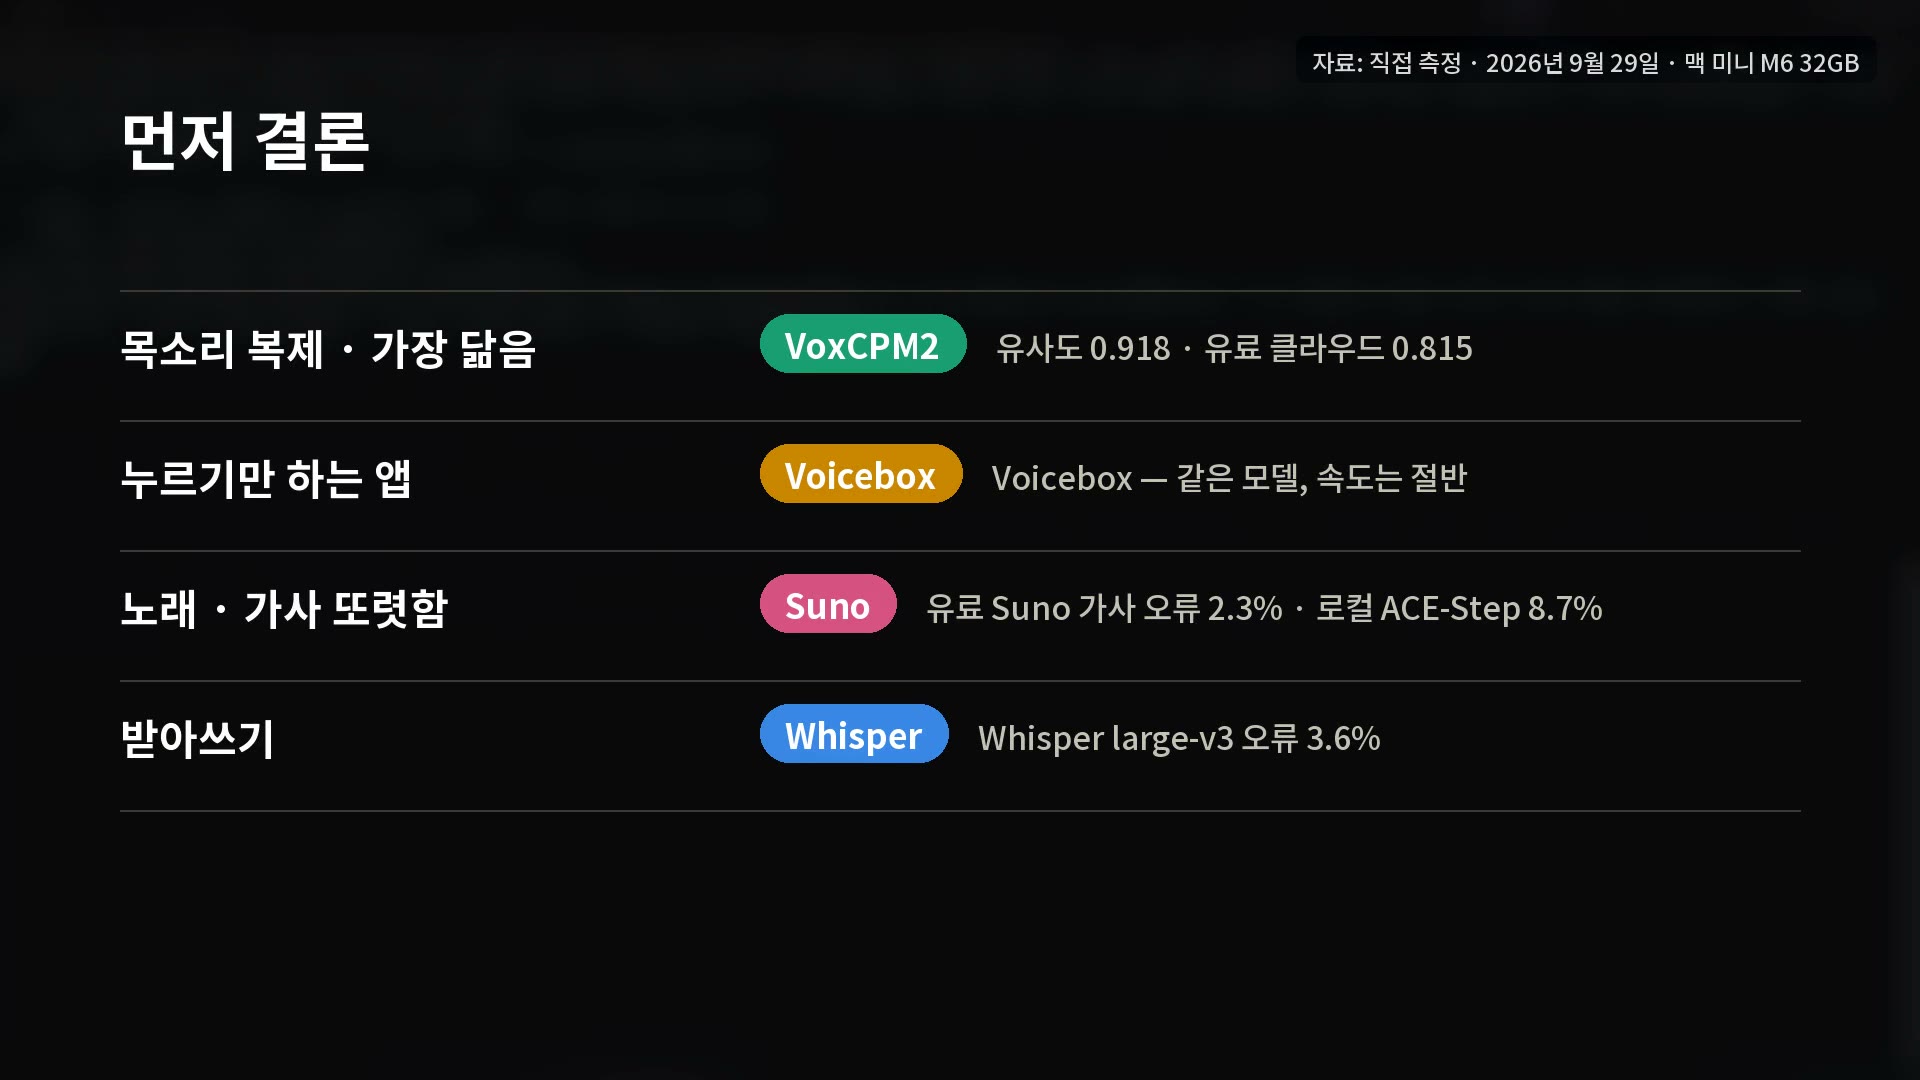
맥 미니 M6 32GB에서 로컬 AI 8종으로 목소리 복제, 작곡, 받아쓰기를 유료 서비스와 같은 조건으로 쟀습니다. 복제는 VoxCPM2 0.918, 노래 가사는 Suno 2.3%, 받아쓰기는 Whisper 3.6%였습니다.
구독 없이 맥 미니 M6 32GB 한 대로 목소리 복제, 작곡, 받아쓰기를 해 보면 어디까지 될까요. 로컬 AI 8가지를 유료 클라우드 서비스 두 개(목소리 복제와 Suno)와 같은 문장, 같은 가사로 직접 비교했더니, 목소리 복제는 로컬이 더 닮았고 노래 가사의 또렷함은 유료 Suno가 앞섰으며 받아쓰기는 Whisper large-v3가 가장 정확했습니다. 이 글은 YouTube 영상의 내용을 글로 다시 정리한 것입니다.
결론 먼저
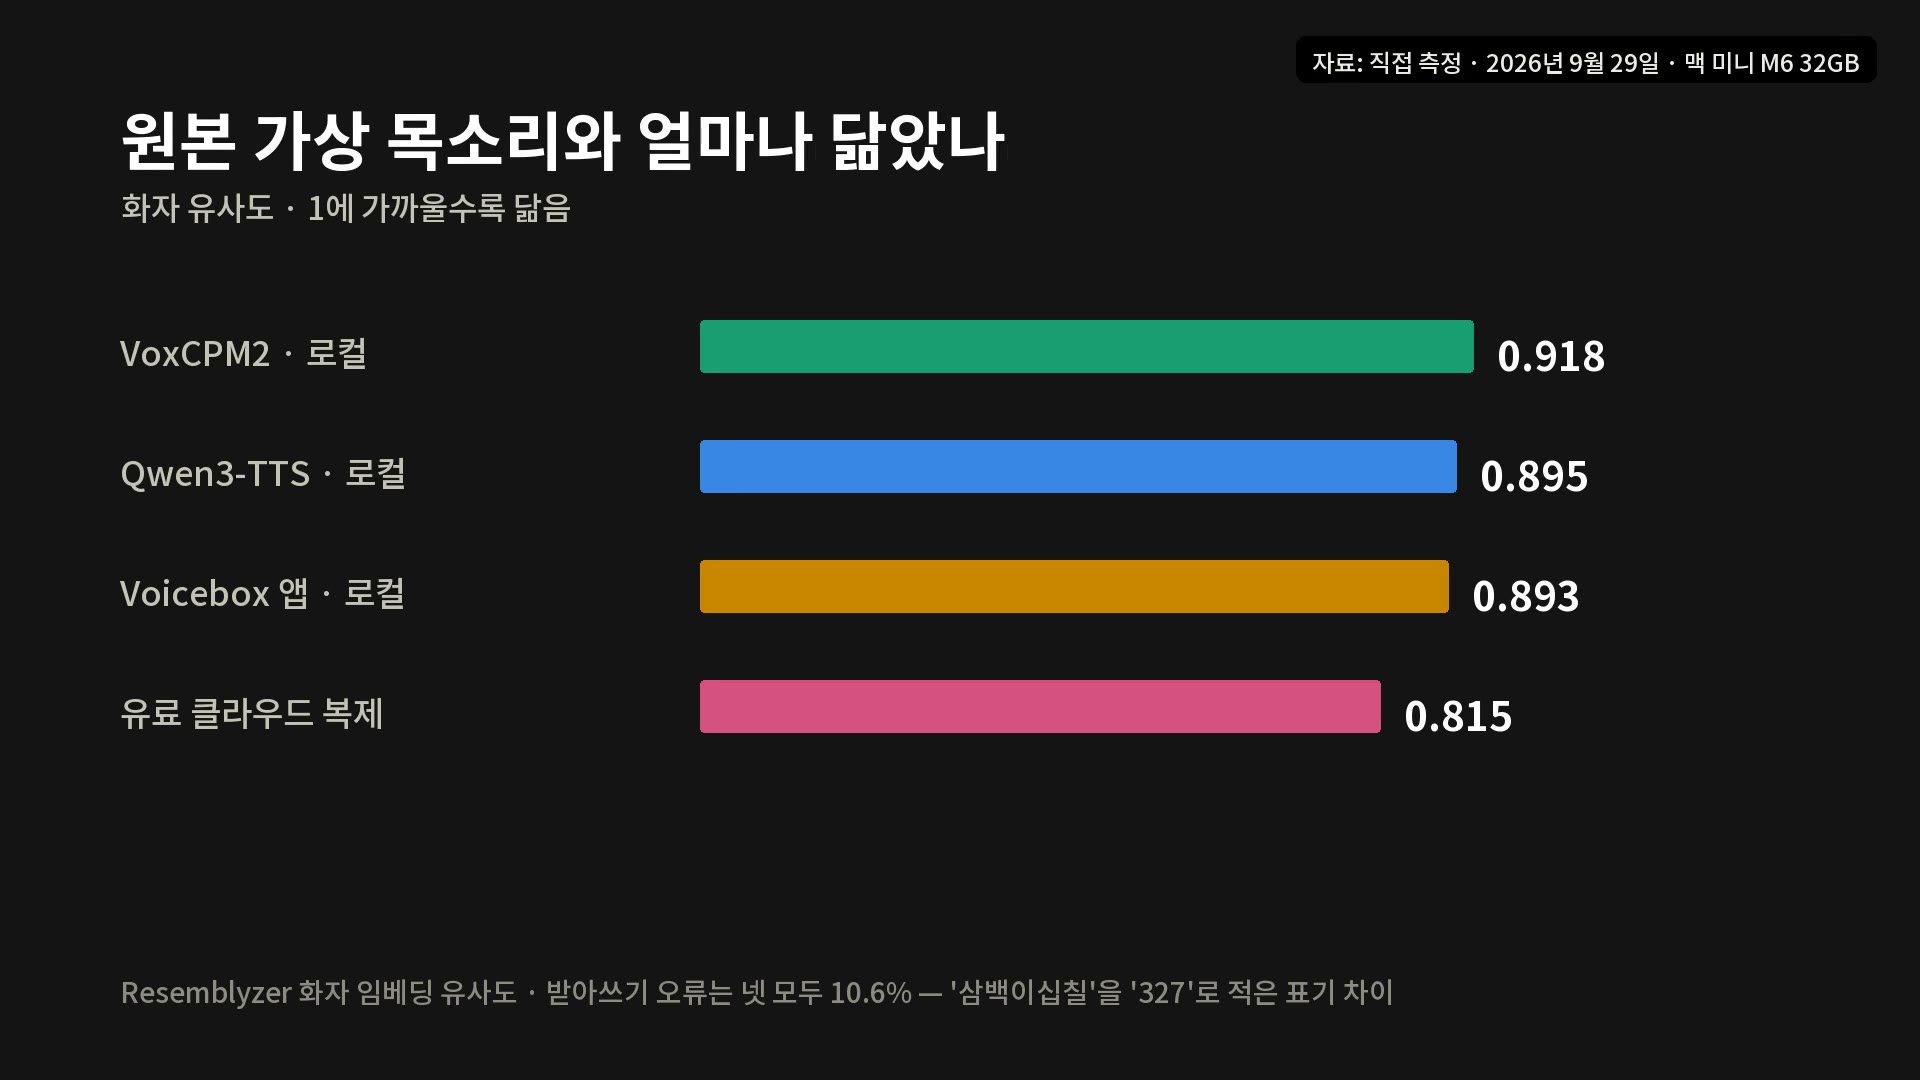
- 목소리 복제는 로컬이 유료보다 더 닮았습니다. 화자 유사도는 VoxCPM2 0.918, Qwen3-TTS 0.895, Voicebox 앱 0.893, 유료 클라우드 즉시 복제 0.815입니다.
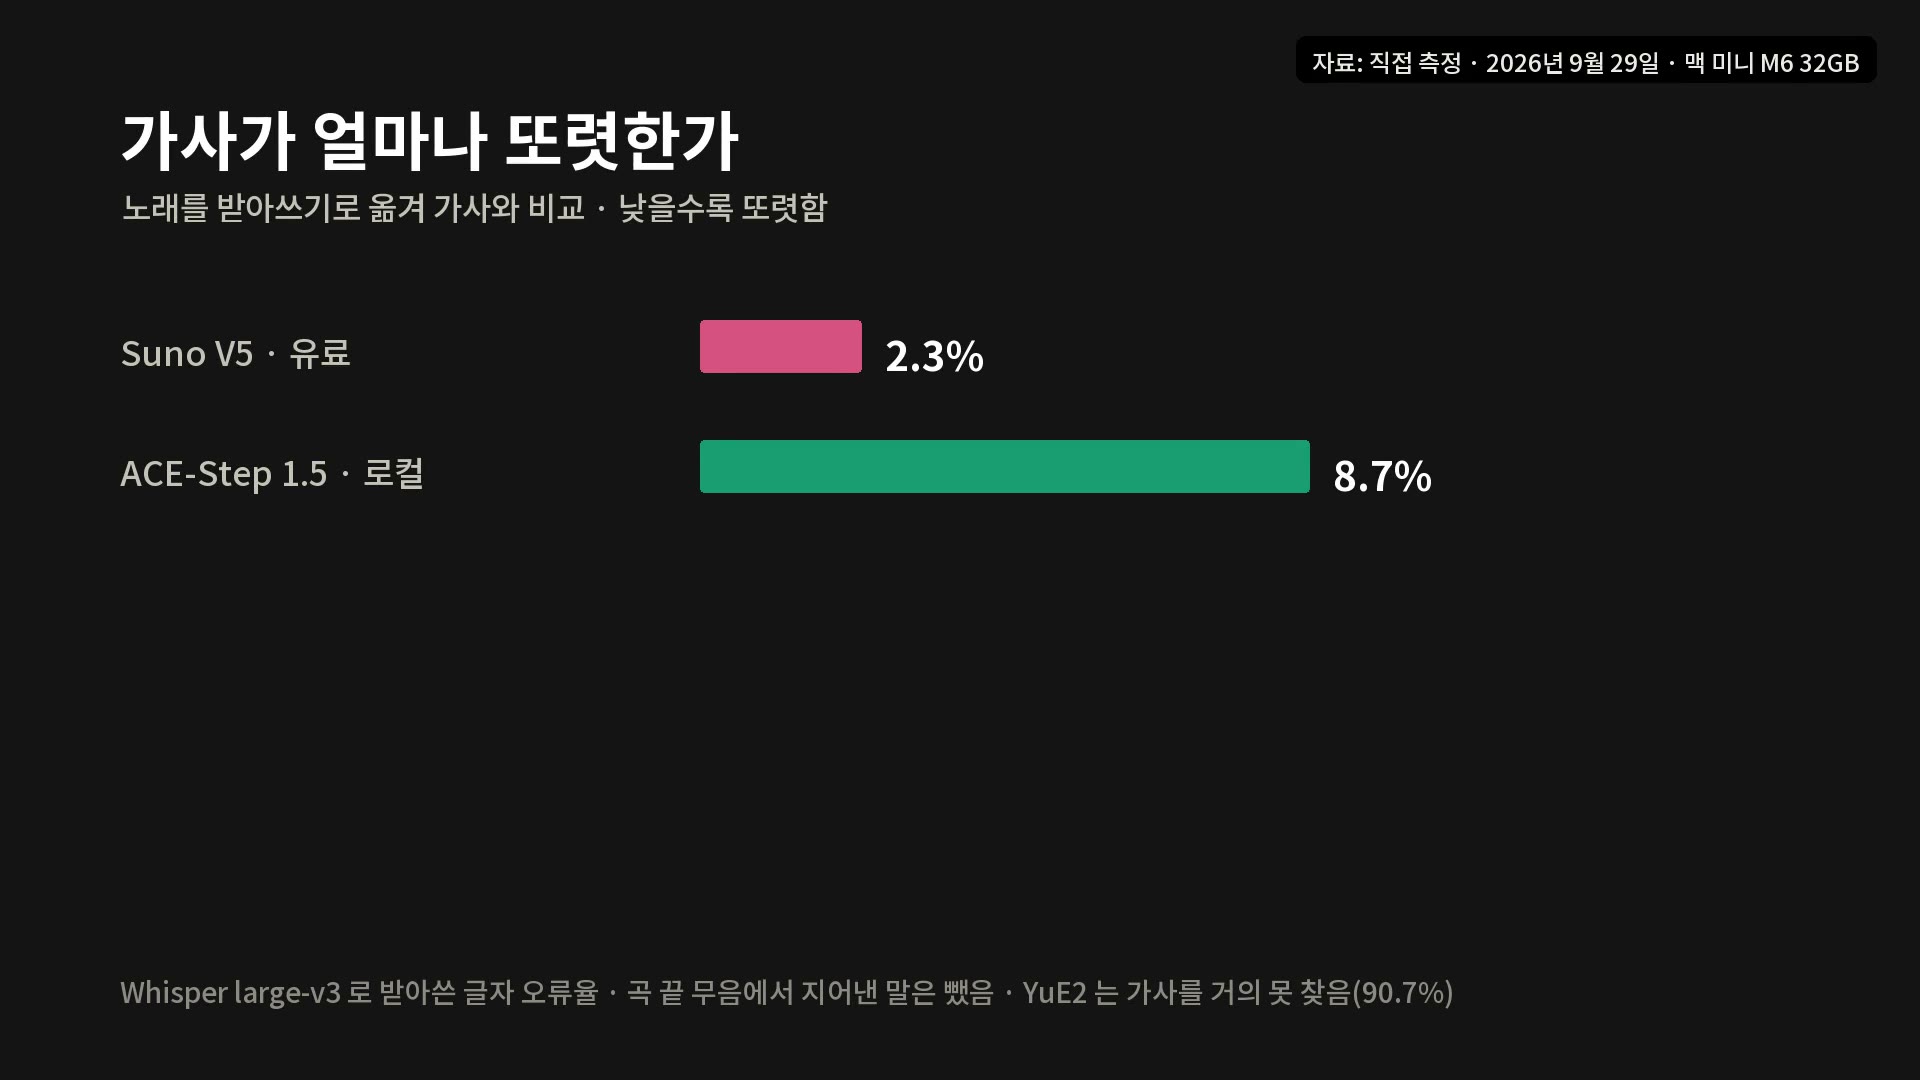
- 노래는 가사가 가장 또렷한 쪽이 유료 Suno입니다(가사 오류 2.3%). 로컬 ACE-Step 1.5는 8.7%였고, 가장 큰 ACE-Step XL(4B)은 32GB 맥 미니에서 메모리가 모자라 멈췄습니다.
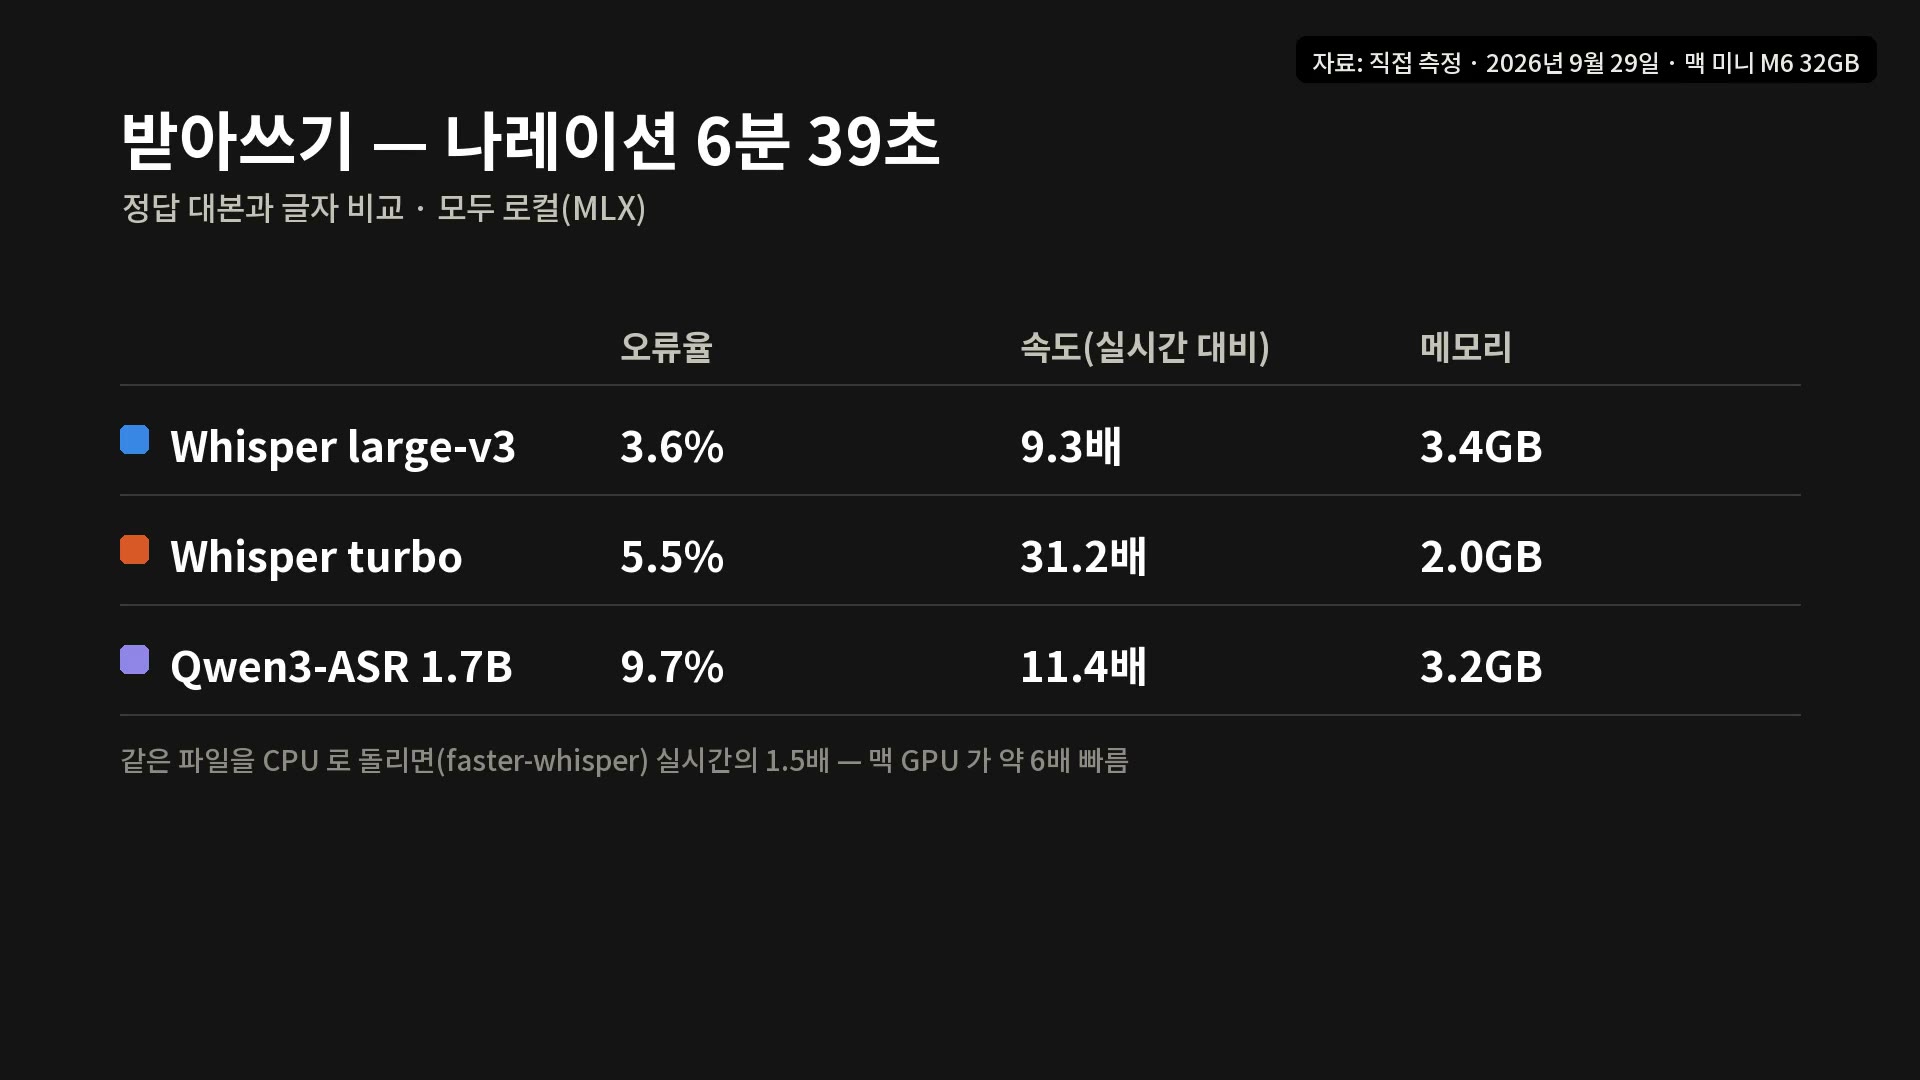
- 받아쓰기는 오래된 Whisper large-v3가 오류 3.6%로 1등이었고, 새로 나온 Qwen3-ASR은 우리 한국어 나레이션에서 9.7%로 가장 많이 틀렸습니다.
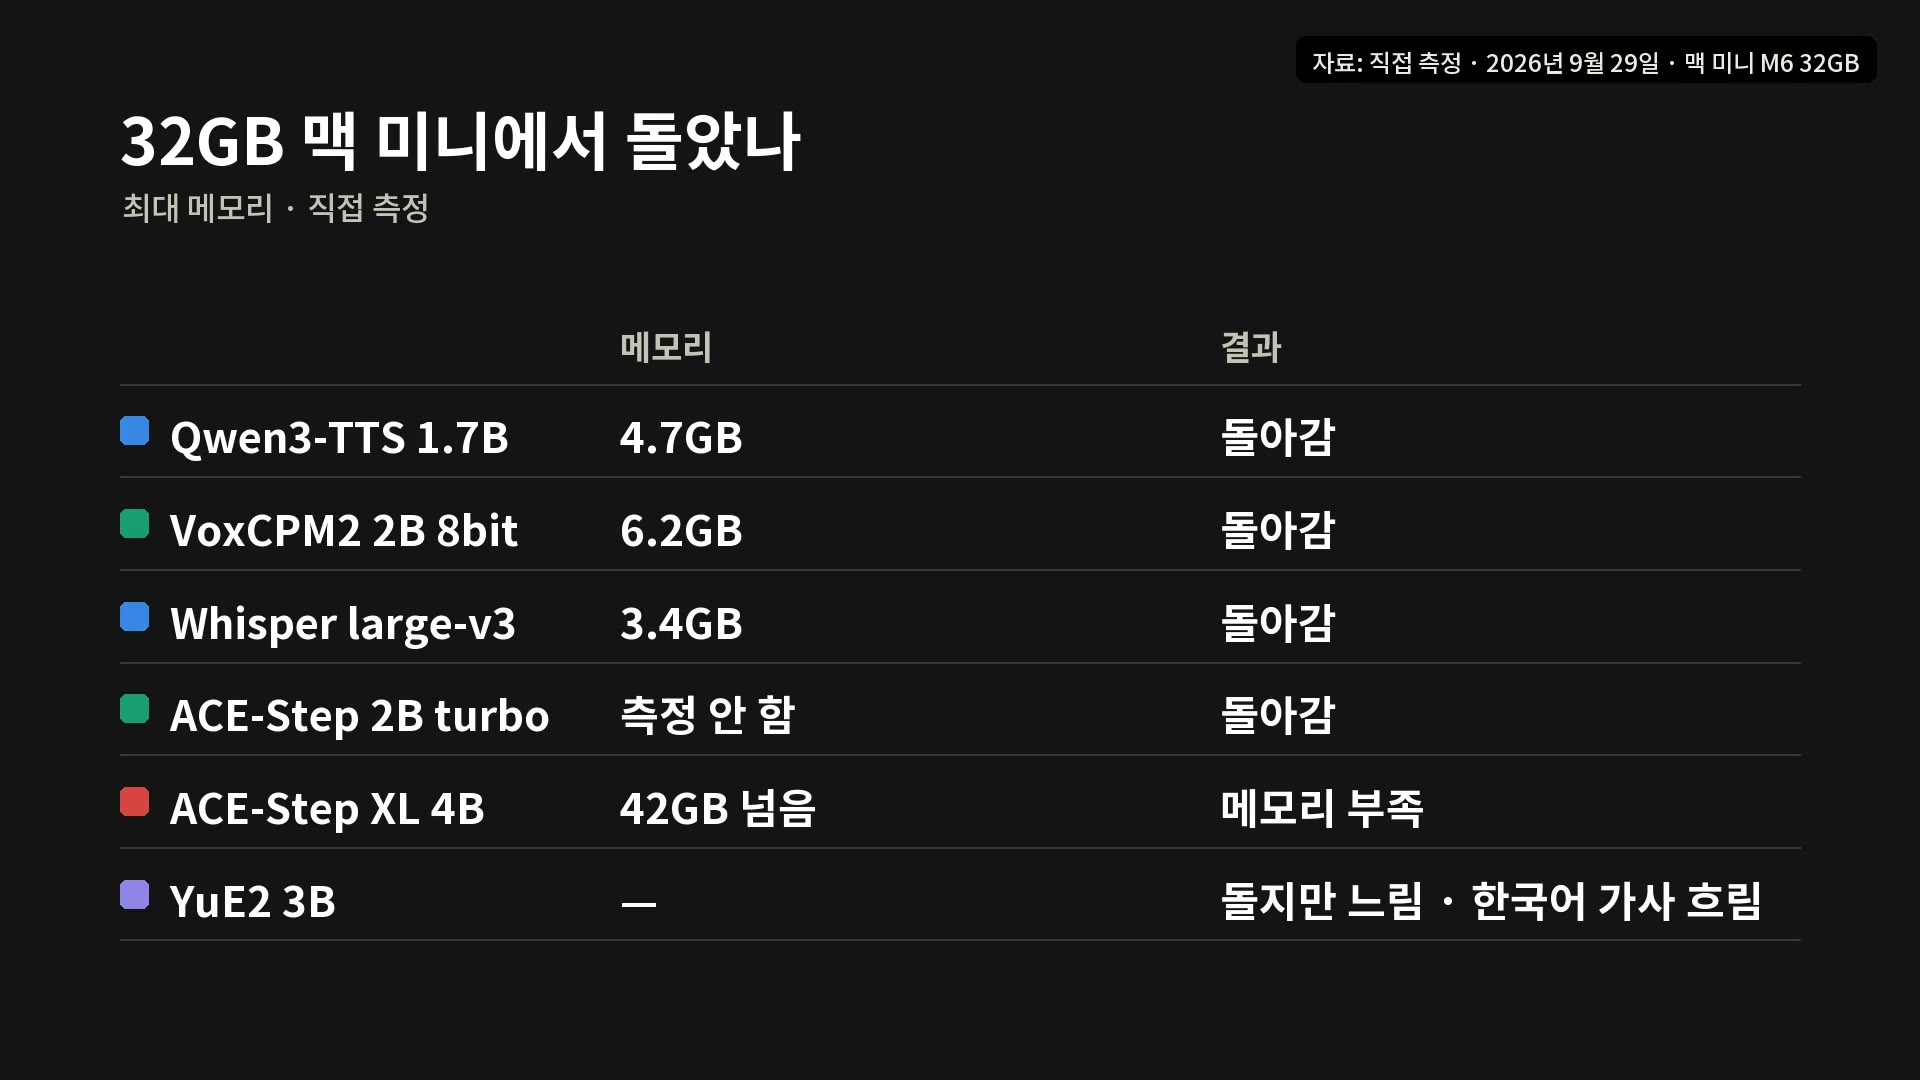
- 32GB로 목소리와 받아쓰기는 여유롭고(대부분 6GB 안팎), 빠듯한 것은 작곡입니다.
이 글의 숫자 종류
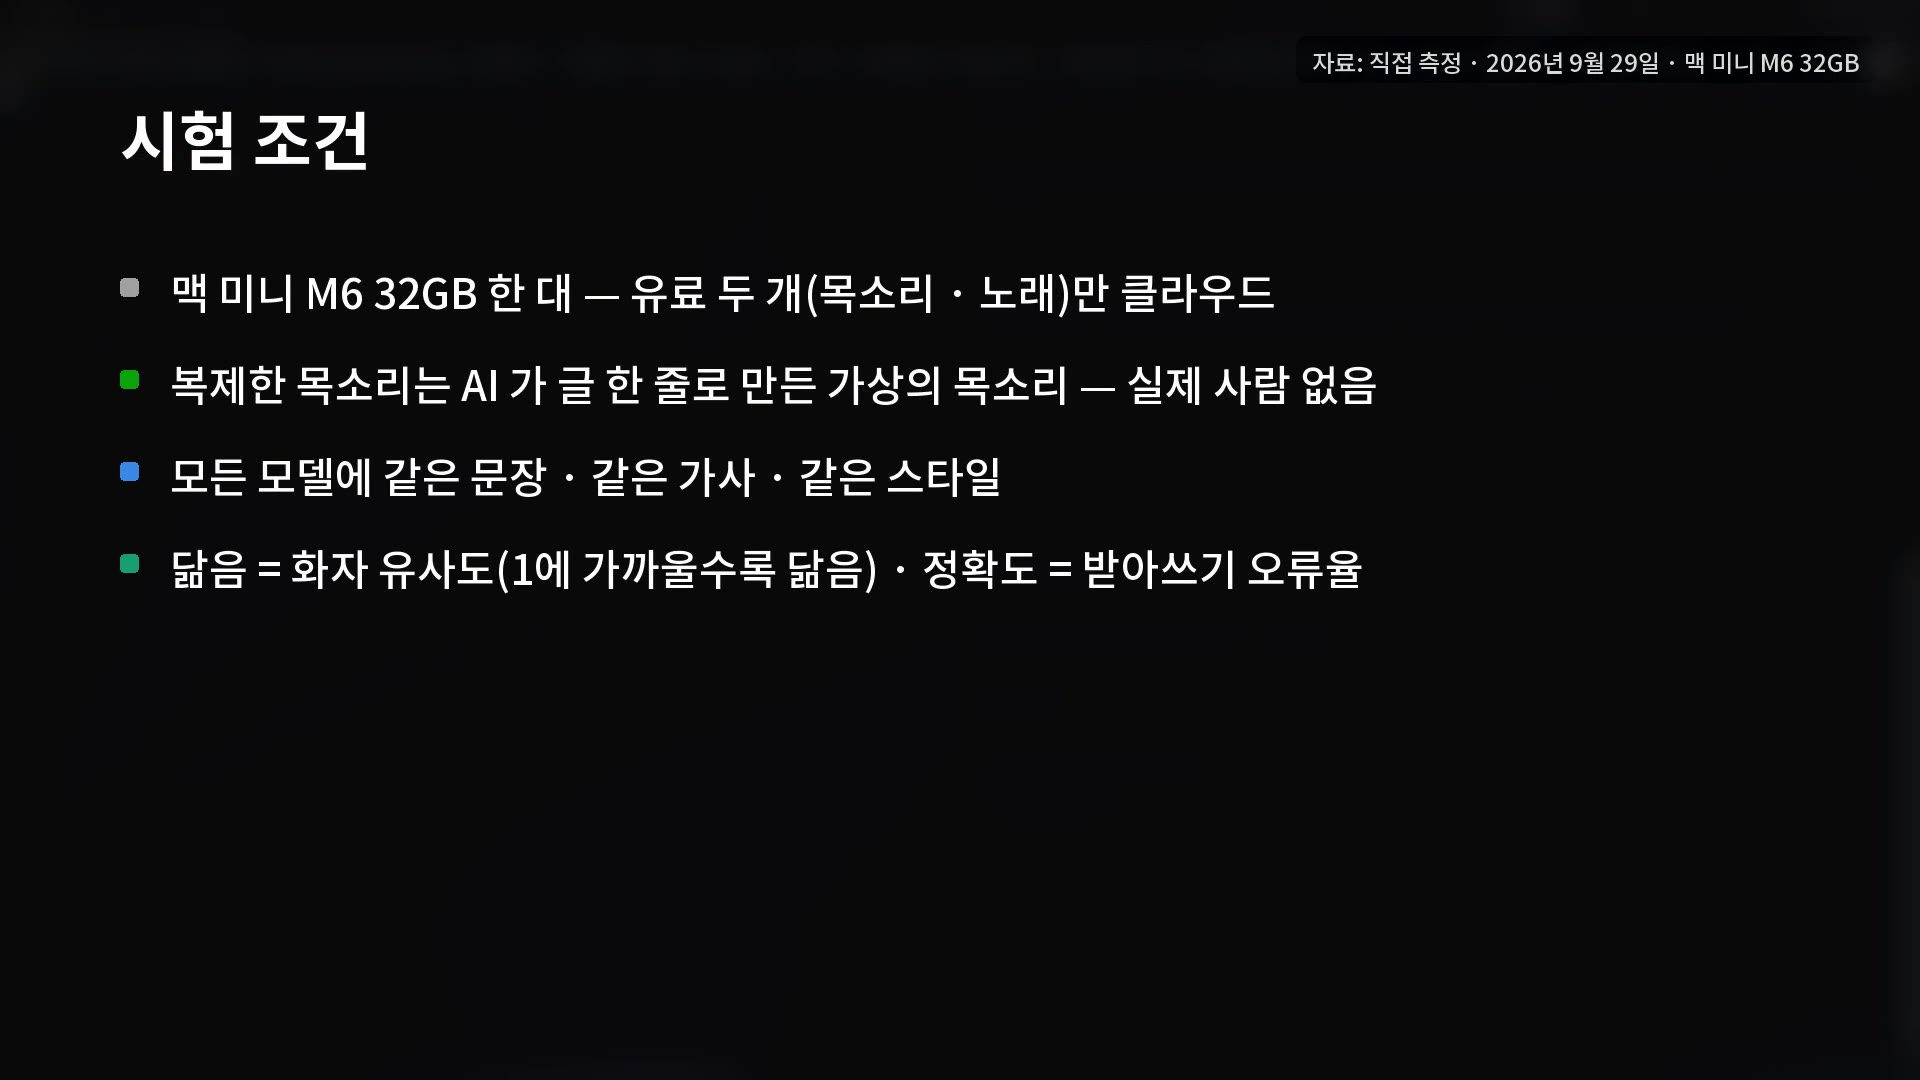
모든 숫자는 우리 측정입니다(맥 미니 M6 32GB, 2026-09-29, 모든 모델에 같은 문장과 같은 가사). 유료 두 개를 빼면 모두 인터넷 없이 맥 안에서 돌렸습니다. 닮은 정도는 Resemblyzer 화자 임베딩 유사도(1에 가까울수록 닮음), 정확도는 Whisper large-v3 받아쓰기 글자 오류율, 메모리는 프로그램이 보고한 최대값입니다. 복제한 목소리의 원본은 실제 사람이 아니라 AI가 글 한 줄로 만든 가상의 목소리이고, 영상 속 목소리는 모두 AI 합성입니다.
시험 조건
복제할 목소리부터 만들었습니다. Qwen3-TTS VoiceDesign 1.7B(bf16)에 '30대 한국 남성, 낮고 차분한 목소리'라고 글로만 설명해 12.1초 분량을 11.5초에 만들었고 메모리는 4.7GB를 썼습니다. 녹음 파일은 하나도 없고, 이 목소리가 모든 복제의 원본입니다. 읽히는 문장에는 숫자 '삼백이십칠'과 영어 'GPU'를 섞었습니다. 모델은 Qwen3-TTS 1.7B bf16, VoxCPM2 2B 8비트(참조 음성과 참조 대사를 함께 주는 방식), mlx-audio 0.5.7, Voicebox 0.5.0 앱, ACE-Step 1.5 turbo 2B + LM 1.7B(MLX), YuE2 3B 공식 코드(device=mps), Whisper large-v3, large-v3-turbo, Qwen3-ASR 1.7B 8비트(MLX)입니다.
목소리 복제: 로컬이 더 닮았다
| 방법 | 유사도 | 속도(분량 → 걸린 시간) | 메모리 |
|---|---|---|---|
| VoxCPM2 2B 8비트 | 0.918 | 10.4초 → 17.2초 | 6.2GB |
| Qwen3-TTS Base 1.7B | 0.895 | 8.9초 → 10.6초 | 4.7GB |
| Voicebox 앱(속은 같은 Qwen3-TTS) | 0.893 | 9.8초 → 23.5초(첫 판 32초) | - |
| 유료 클라우드 즉시 복제 | 0.815 | 9.85초 → 1.5초 | - |
넷 모두 받아쓰기 오류가 10.6%로 같았는데, 전부 '삼백이십칠'을 숫자 327로 적은 표기 차이라 틀린 발음은 없었습니다. Voicebox는 설치 파일을 응용 프로그램 폴더로 끌어 넣으면 끝나는 무료 앱이고(영상은 깃허브 별 5만 개가 넘는다고 소개), 목소리 만들기에서 프로필 저장까지 40초쯤 걸렸습니다. 같은 모델인데 터미널보다 약 2배 느린 이유는 확인하지 않았습니다.
작곡: 가사는 유료가 앞섰다
같은 한국어 가사와 스타일로 비교했습니다(가사는 직접 썼습니다). ACE-Step 1.5는 60초 두 곡에 76.8초가 걸렸고 가사 오류는 8.7%였습니다. 반주와 멜로디는 그럴듯하지만 '팬 소리도'가 '벤 소리도'로, '맥 미니로'가 '맹이로'로 들리는 곳이 있었습니다. 유료 Suno V5는 같은 가사로 24.8초 만에 두 곡(각각 50.9초, 40.4초 길이)이 나왔고 가사 오류는 2.3%였습니다. 가사 오류율은 곡을 받아쓰기로 옮겨 가사와 비교한 값이며 곡 끝 무음에서 지어낸 말은 뺐습니다.
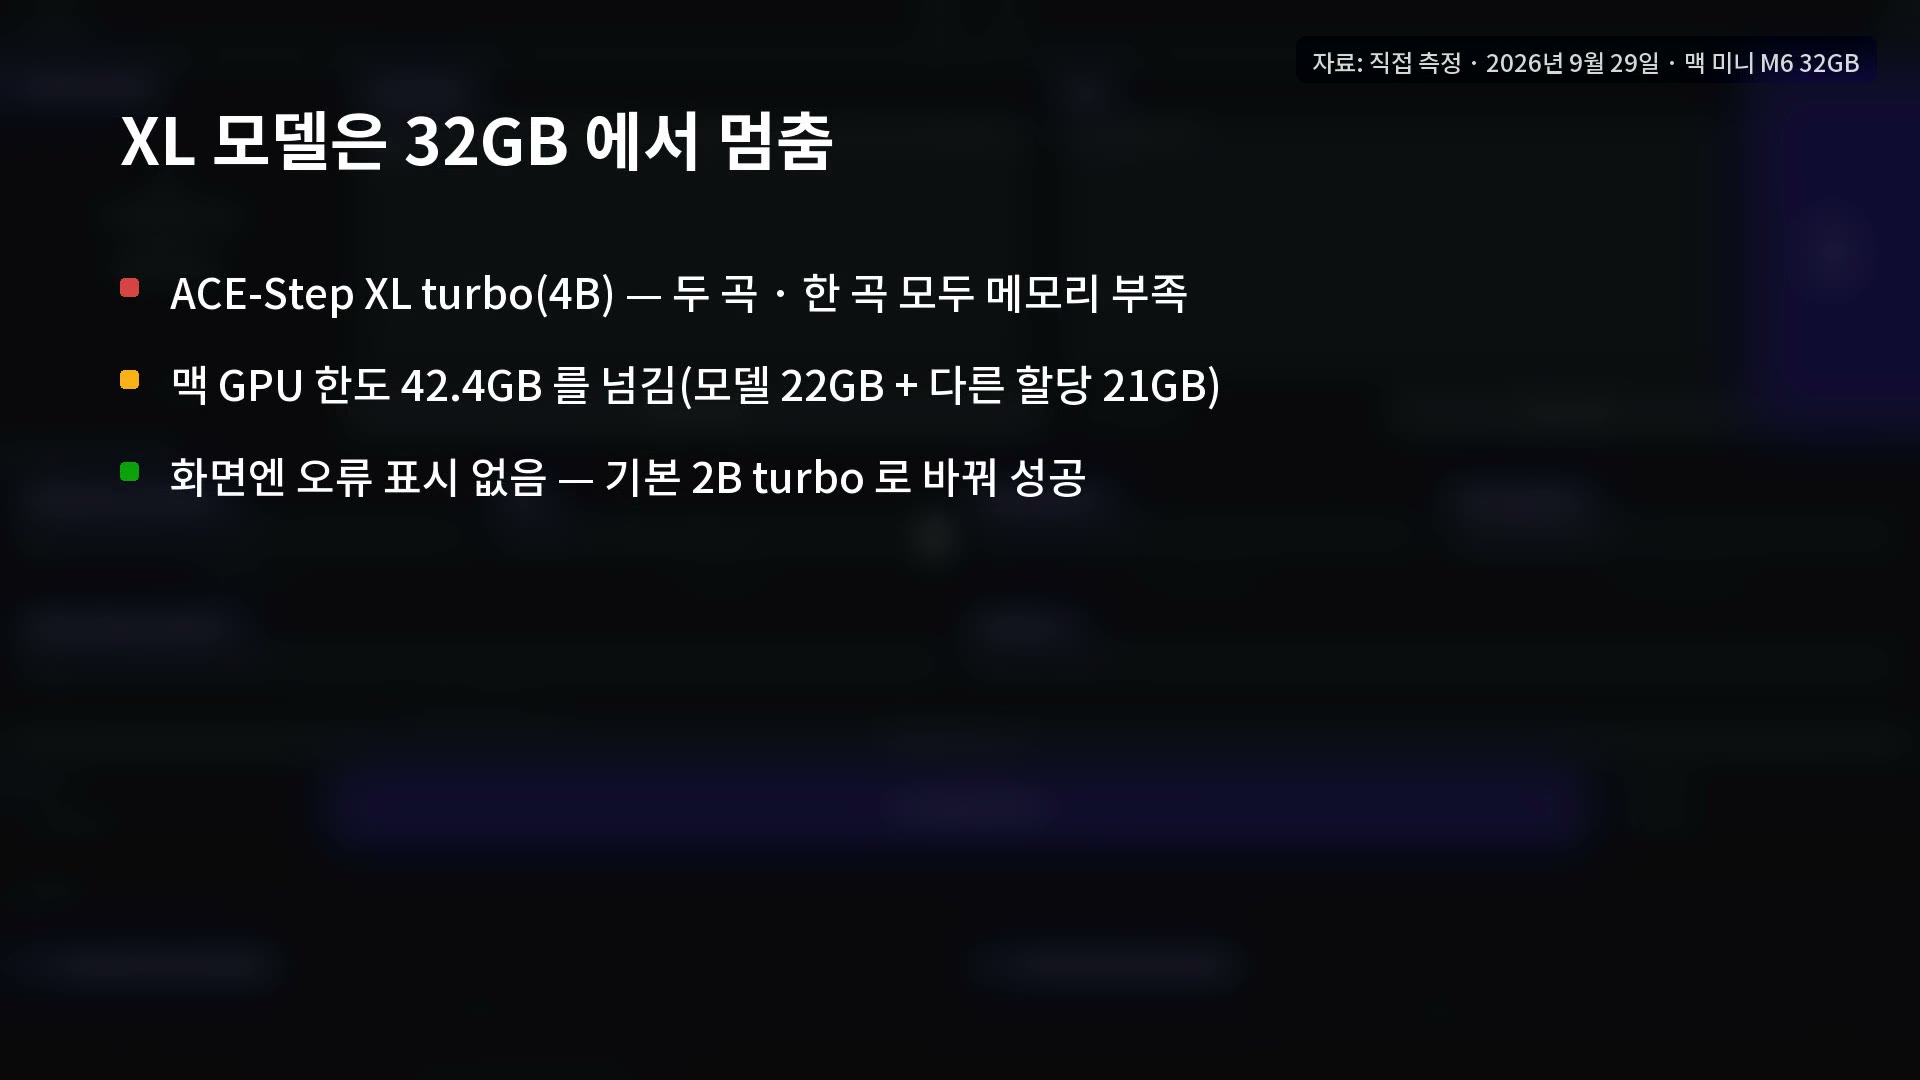
가장 큰 ACE-Step XL turbo(4B)는 두 곡씩도 한 곡씩도 메모리 부족으로 멈췄습니다. 맥 GPU 한도 42.4GB를 모델 22GB와 다른 할당 21GB가 넘겼고, 화면에는 오류가 한 줄도 뜨지 않아 기본 2B 모델로 바꿨습니다. YuE2는 공식 안내가 리눅스와 NVIDIA 24GB 전용인데 맥 GPU(MPS)로 실제 돌았고, 65.5초 곡에 246초(약 4분)가 걸렸지만 한국어 가사를 받아쓰기가 거의 찾지 못했습니다(90.7%). 한국어는 공식 지원 언어가 아닙니다.
받아쓰기: 오래된 Whisper가 1등
우리 채널 나레이션 27개(6분 39초)를 정답 대본과 비교했습니다. 같은 16초 샘플에서 Whisper와 Qwen3-ASR은 둘 다 1.5초 만에 끝났지만, Whisper는 '3090과 4090'을 제대로 적었고 Qwen3-ASR은 '3,990, 4,990'으로 적었습니다.
| 모델 (모두 로컬, MLX) | 글자 오류율 | 속도(실시간 대비) | 메모리 |
|---|---|---|---|
| Whisper large-v3 | 3.6% | 9.3배 | 3.4GB |
| Whisper large-v3-turbo | 5.5% | 31.2배 | 2.0GB |
| Qwen3-ASR 1.7B | 9.7% | 11.4배 | 3.2GB |
같은 파일을 CPU로 돌리면(faster-whisper) 실시간의 1.5배여서 맥 GPU가 약 6배 빠릅니다.
32GB 맥 미니로 충분한가
| 모델 | 메모리 | 결과 |
|---|---|---|
| Qwen3-TTS 1.7B | 4.7GB | 돌아감 |
| VoxCPM2 2B 8bit | 6.2GB | 돌아감 |
| Whisper large-v3 | 3.4GB | 돌아감 |
| ACE-Step 2B turbo | 측정 안 함 | 돌아감 |
| ACE-Step XL 4B | 42GB 넘음 | 메모리 부족 |
| YuE2 3B | - | 돌지만 느림, 한국어 가사 흐림 |
영상의 정리와 쓰기 전에
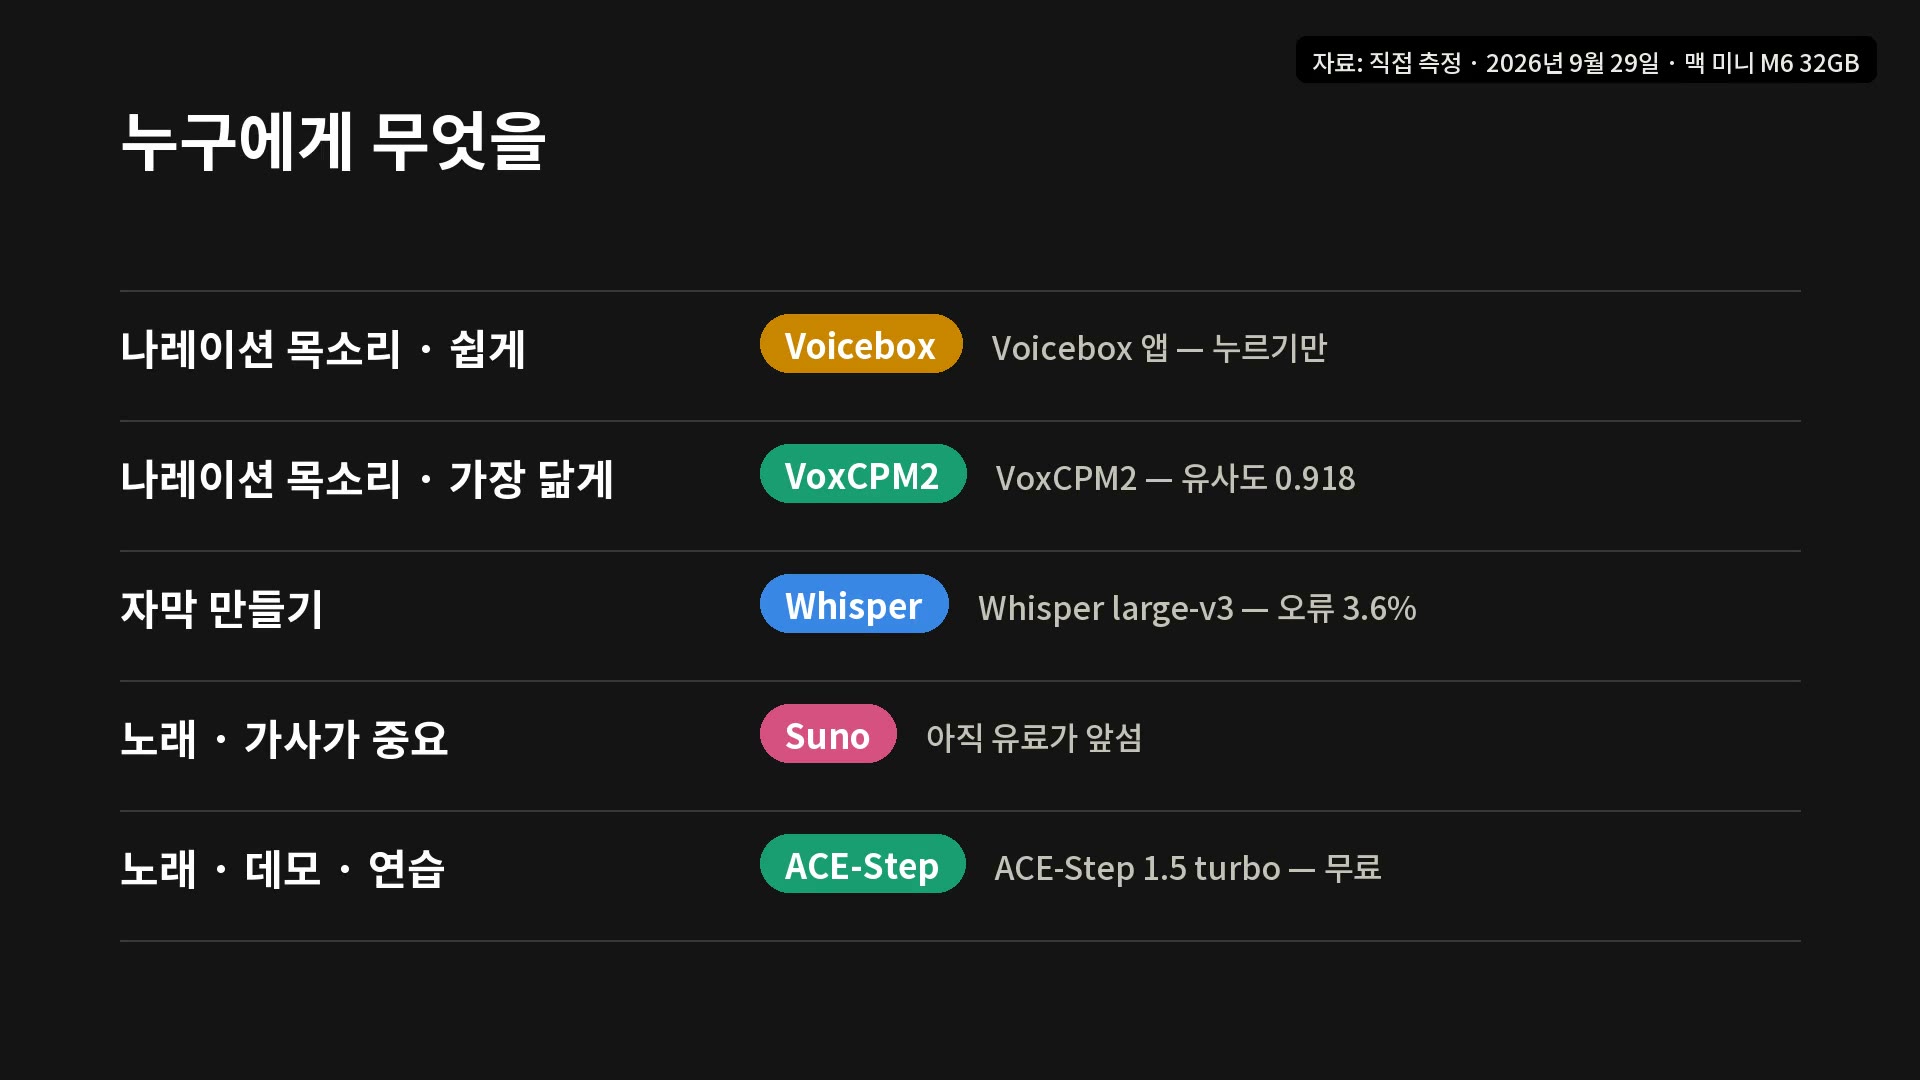
나레이션용 목소리 복제는 이제 구독 없이 맥 미니로 충분하다는 것이 영상의 결론입니다. 쉬운 것은 Voicebox, 가장 닮은 것은 VoxCPM2, 자막은 Whisper large-v3이고, 노래는 아직 유료가 앞서지만 데모곡이나 연습용이라면 ACE-Step으로 무료로 뽑을 수 있습니다. 목소리 복제는 본인 목소리나 서면으로 허락받은 목소리로만 하세요. 라이선스는 Qwen3-TTS와 VoxCPM2가 Apache-2.0, ACE-Step이 MIT, YuE2는 비상업 기본에 개인 크리에이터 허용 조건이라, 쓰기 전에 각 저장소의 최신 라이선스를 확인해야 합니다.
한계 · 기준일
- 복제는 한 문장, 모델당 한 번 잰 결과입니다. 유사도는 한 가지 지표(Resemblyzer)이고, 가사 오류율은 받아쓰기를 거친 값입니다.
- 유료 클라우드 속도(1.5초, 24.8초)는 인터넷을 거친 값이라 로컬 속도와 조건이 다릅니다. Voicebox가 느린 원인은 확인하지 않았습니다.
- 받아쓰기는 우리 채널 한국어 나레이션 기준이라 다른 음성에서는 달라질 수 있습니다.
- 기준일: 측정 2026-09-29, 영상 공개 2026-10-01(영상 공개일 기준이며 이후 모델 버전이 바뀌었을 수 있습니다).