Bonsai 2 27Bを実測:6GBに縮めた27BをMac mini M6とRTX 3090で
投稿日 動画公開
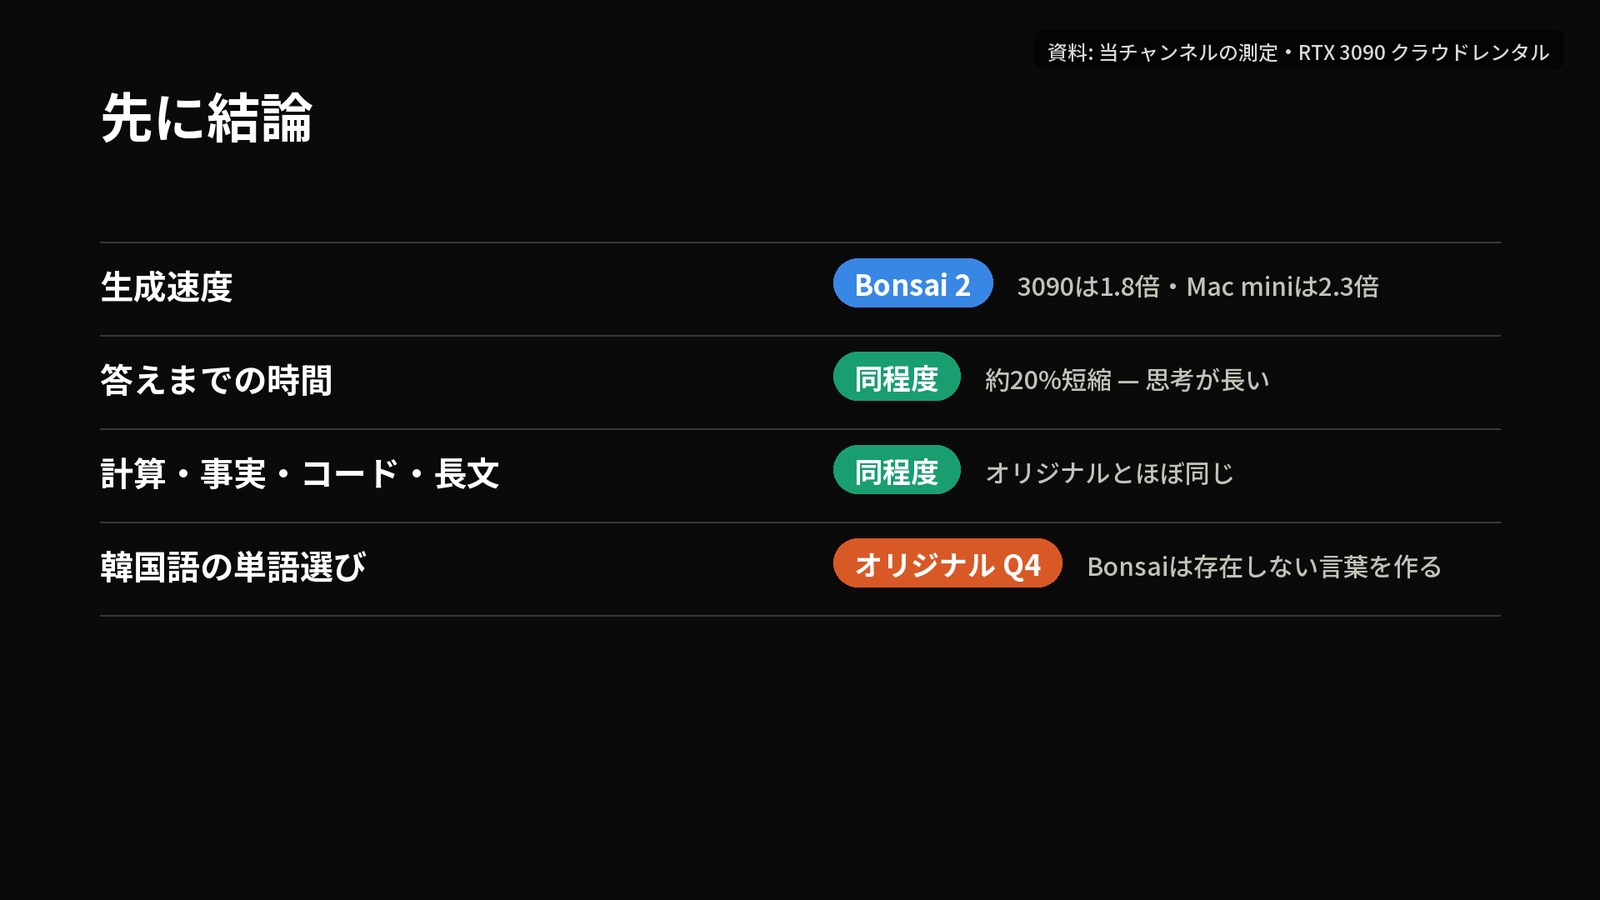
6GBに縮めたBonsai 2 27Bを、Mac mini M6とRTX 3090でオリジナルのQwen3.8 27Bと比較。速度は1.8〜2.3倍ですが、答えまでの時間は20%しか縮まりませんでした。
27Bのモデルを6GBに縮めても元の知能の98.2%が残るという「Bonsai 2 27B」を、Mac mini M6 32GBと、クラウドで借りたRTX 3090で、オリジナルと並べて実測しました。結論は「速度は確かに速く、答えが返るまでの時間は2割ほどしか縮まず、韓国語の単語選びでは存在しない言葉を作る」です。この記事は、YouTube動画での測定を読みやすく整理し直したものです。
結論から
- 生成速度は3090で1.8倍、Mac miniで2.3倍速くなりました。
- ただし、質問してから答えを受け取るまでの時間は約20%しか短くなりませんでした。思考(推論)をより長くするためです。
- 計算、事実の検索、コード、長い文章の中から探す課題は、オリジナルとほぼ同じでした。
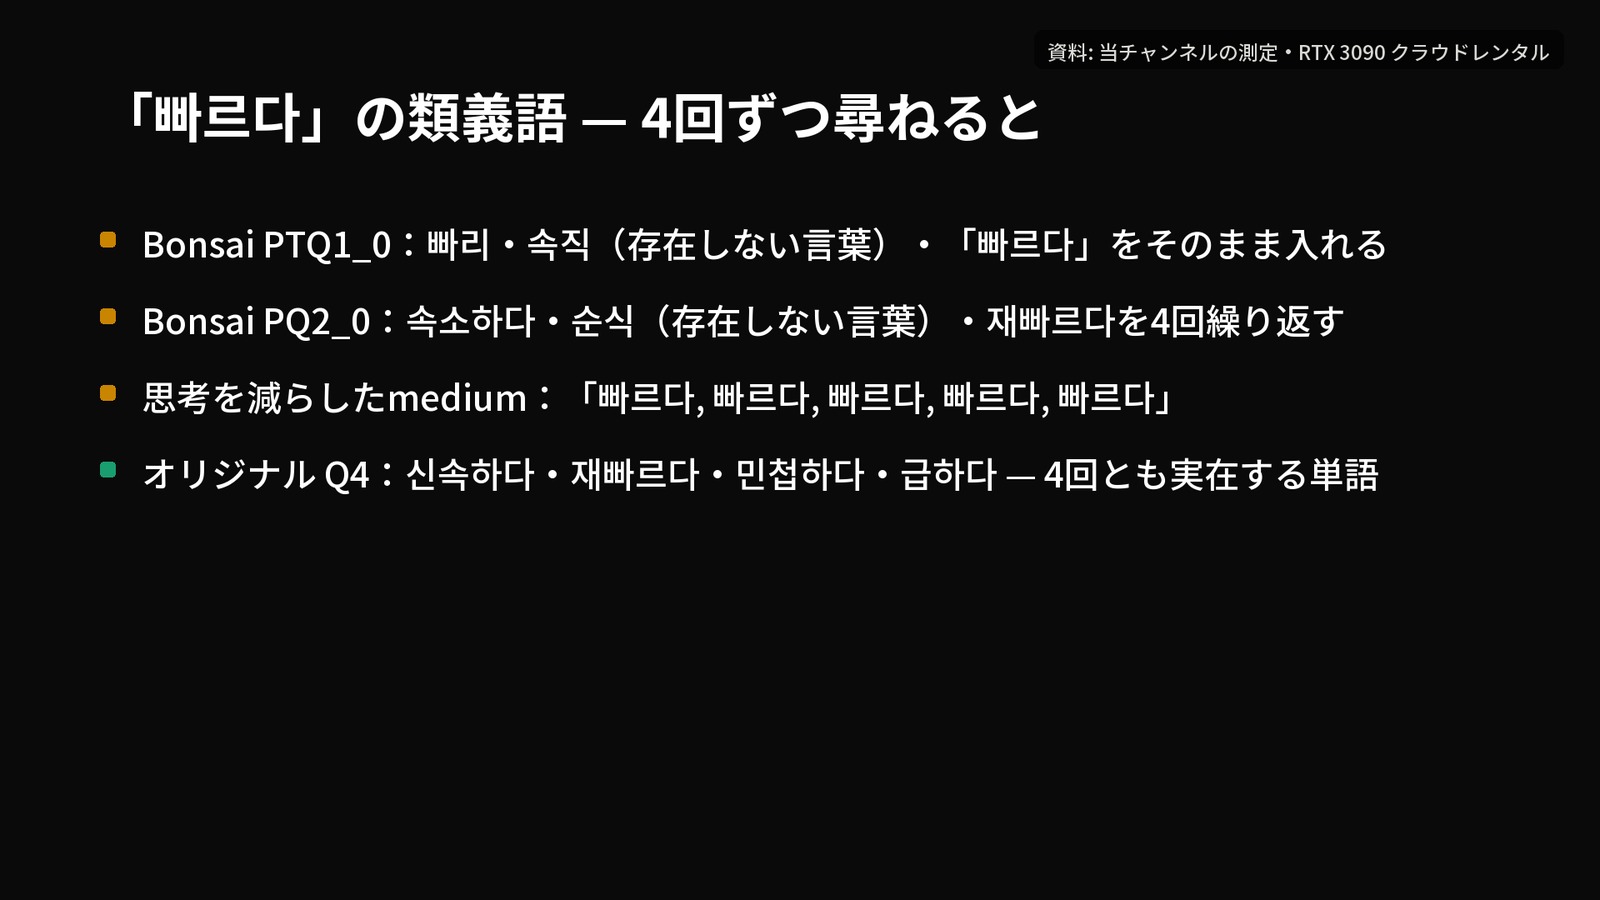
- 韓国語の単語選びでは、「빠리」「속직」「속소하다」「순식」のような存在しない言葉が出ました。オリジナルは4回とも実在する単語でした。
この記事の数字は3種類です
| 表記 | 意味 |
|---|---|
| 当チャンネルの測定 | Mac mini M6 32GBと、借りたRTX 3090 24GBで自分たちが測った値(2026-09-28) |
| 開発元の発表・他者の報告 | Bonsai開発元の表(98.2%、M5 ProとM5 Maxの速度)、視聴者やコミュニティが投稿した値 |
| 視聴者の情報提供 | 3090でLM Studioを使ってオリジナルを動かしたというコメントの値(48.5トークン/秒) |
3090はクラウドで1枚を約35分借り、費用は約$0.20でした。オリジナルもBonsaiも24GBに載るので、同じカードでそのまま比べられました。
Bonsai 2 27Bとは
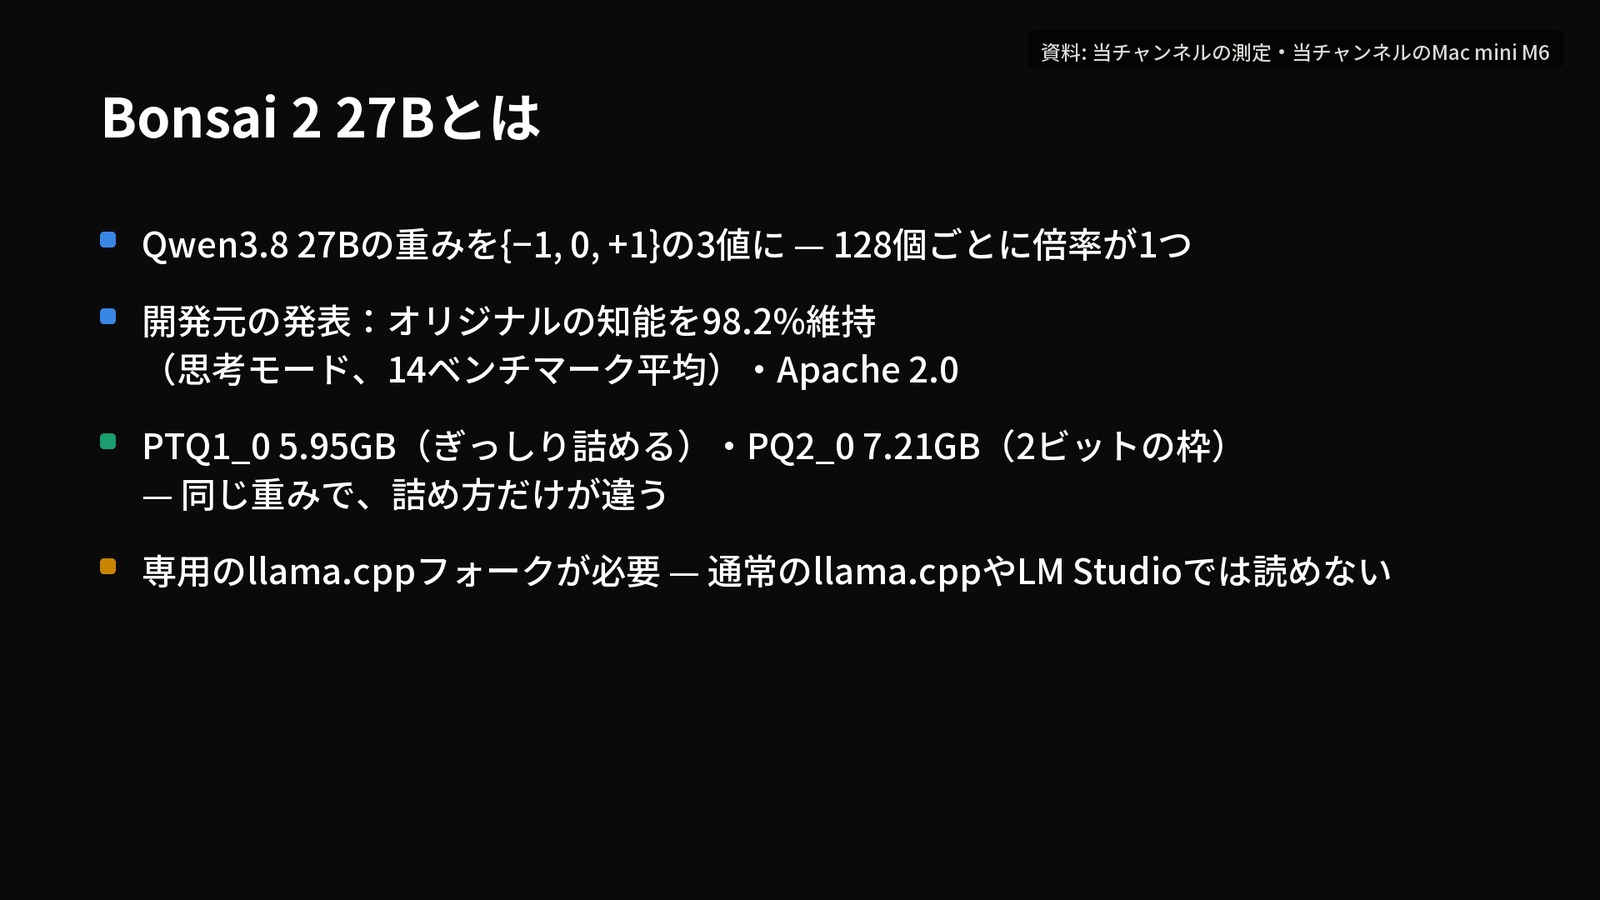
Bonsai 2は、Qwen3.8 27Bの重みを-1、0、+1の3つの値だけに変えたモデルです(128個ごとに倍率が1つ)。開発元の発表では、14個のベンチマーク(思考モード)の平均でオリジナルの知能の98.2%を維持し、ライセンスはApache 2.0です。ファイルは2種類あります。ぎっしり詰めたPTQ1_0(5.95GB)と、2ビットの枠に入れたPQ2_0(7.21GB)で、中の重みは同じで、詰め方だけが違います。
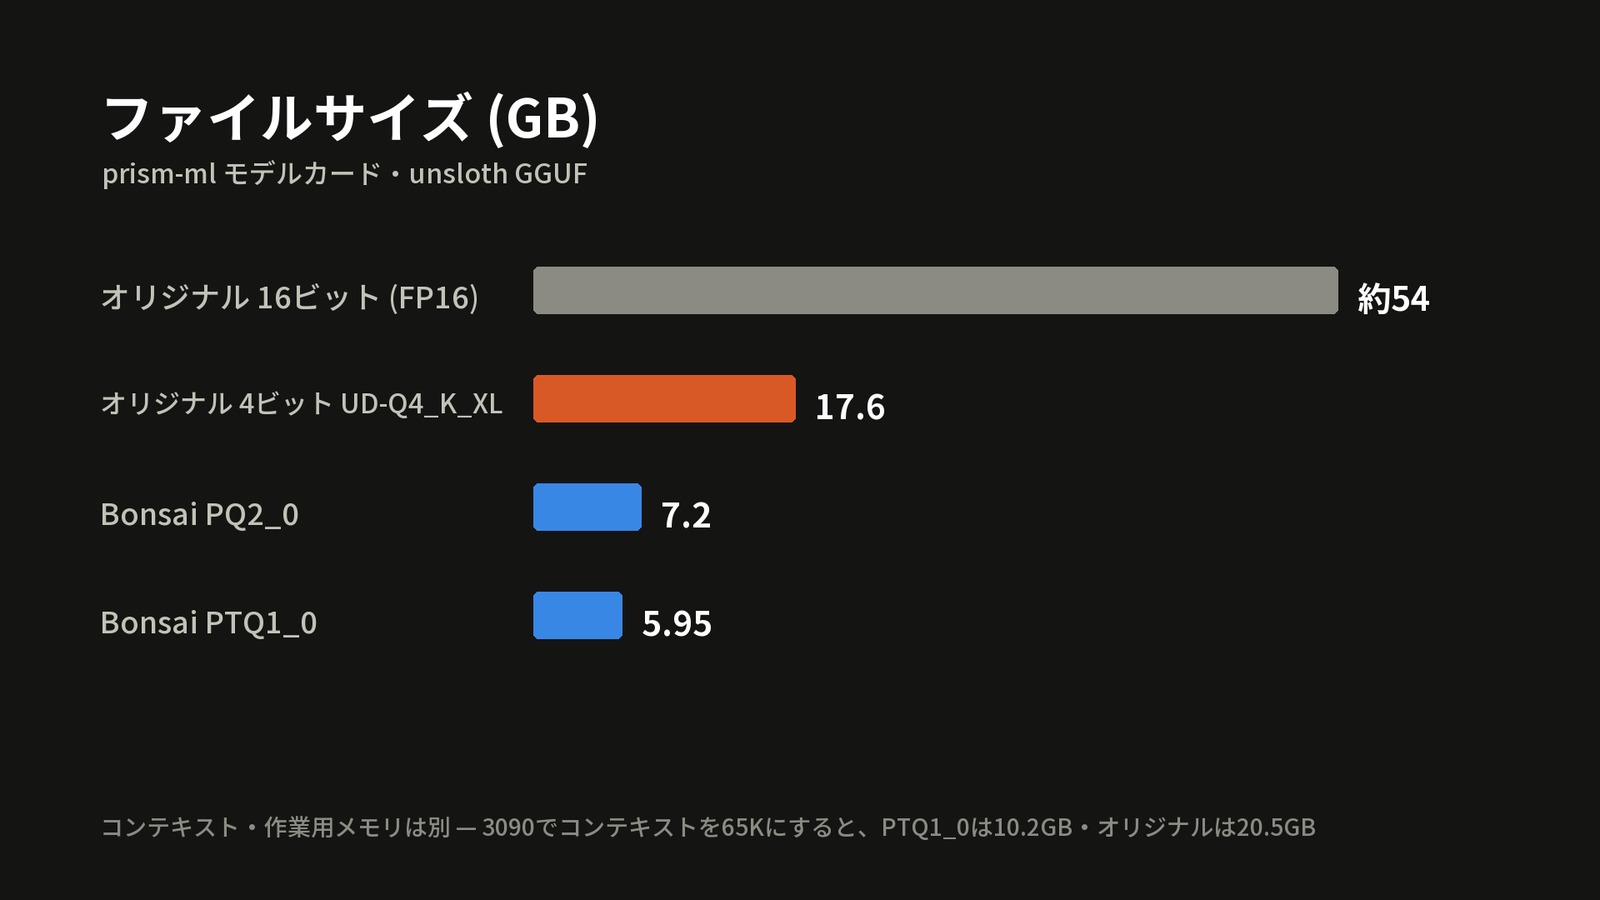
オリジナルの16ビットは約54GB、よく使われる4ビット(UD-Q4_K_XL)は17.6GBなので、サイズだけで見るとオリジナルの4ビットの3分の1です。そのため12GBのグラフィックカードや16GBのMacにも27Bが載ります。ただし専用のllama.cppフォークが必要で、通常のllama.cppやLM Studioでは読み込めません。
測定条件は、専用フォークのprism-b10743、コンテキスト65,536、temperature 1.0、top_p 0.95、top_k 20、min_p 0.05、出力上限16,384、思考の強さは既定値(xhigh)で、2つのモデルに同じ条件を与えました。
速度:3090とMac mini M6
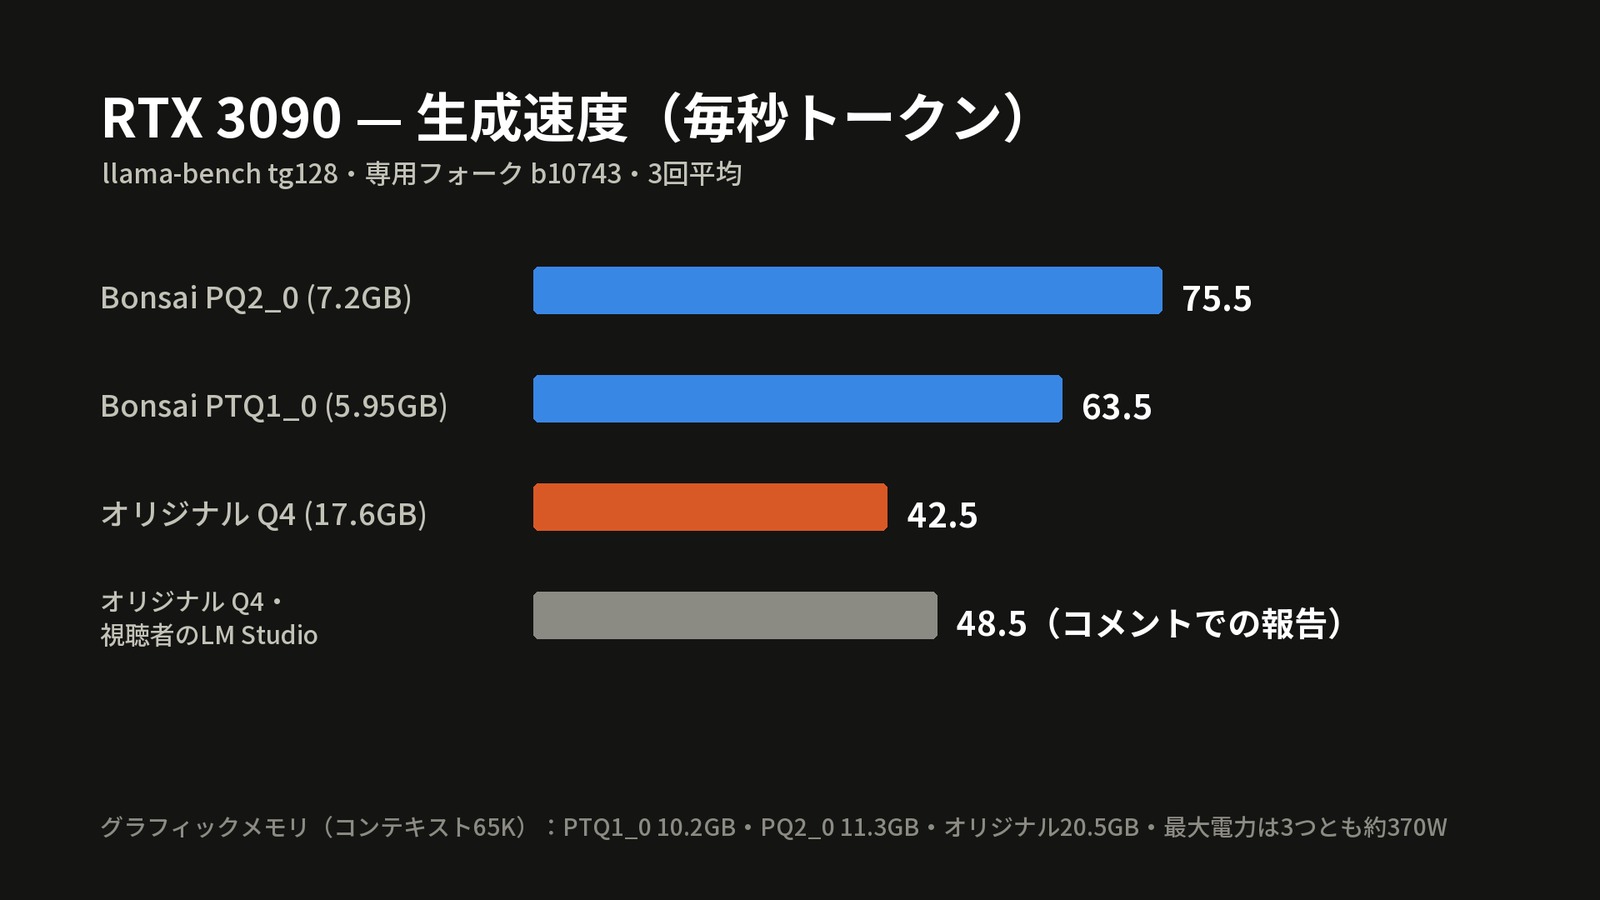
標準の測定ツール(llama-bench)で、トークンを128個生成する速度(tg128、3回の平均)を測りました。
| 機器 | モデル | サイズ | 毎秒トークン数 |
|---|---|---|---|
| RTX 3090 | Bonsai PQ2_0 | 7.21GB | 75.5 |
| RTX 3090 | Bonsai PTQ1_0 | 5.95GB | 63.5 |
| RTX 3090 | オリジナル4ビット | 17.56GB | 42.5 |
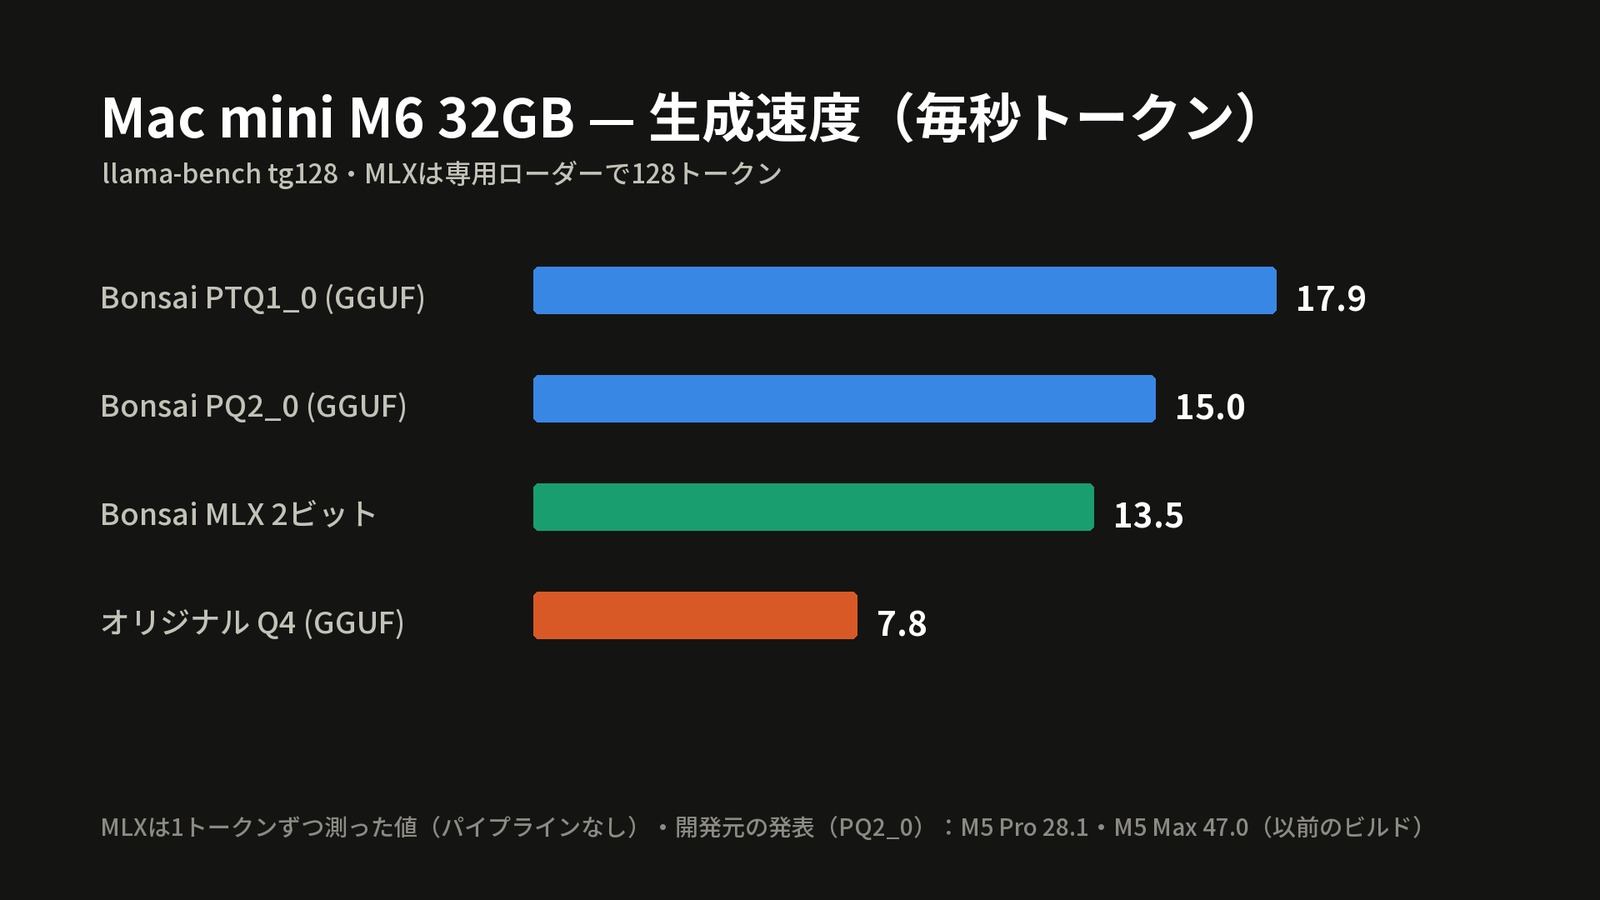
| Mac mini M6 32GB | Bonsai PTQ1_0 | 5.95GB | 17.9 |
| Mac mini M6 32GB | Bonsai PQ2_0 | 7.21GB | 15.0 |
| Mac mini M6 32GB | Bonsai MLX 2ビット(専用ローダー) | 8.6GB | 13.5 |
| Mac mini M6 32GB | オリジナル4ビット | 17.56GB | 7.8 |
3090では、大きいほうのPQ2が最速で(開発元の表でも、同じ世代のA100ではPQ2が速くなっています)、Macではむしろ小さいPTQ1のほうがPQ2より速くなりました。3090のグラフィックメモリは、コンテキスト65Kでオリジナルが20.5GB、Bonsaiが10GB強(PTQ1 10.2GB、PQ2 11.3GB)でした。3090でLM Studioを使ってオリジナルを動かしているという視聴者から48.5トークン/秒という情報をいただきましたが、当チャンネルの設定では42.5でした(視聴者の情報と当チャンネルの測定は設定が異なります)。MLXの値は1トークンずつ測る方式のため、他の方式より低く出る可能性があります。開発元の発表した速度はM5 Proが28.1、M5 Maxが47トークン/秒(PQ2_0の値。動画のカードには「以前のビルド」と記載)で、動画が調べた範囲では、M6の実測はまだありませんでした。
落とし穴:速くても答えまでの時間は20%しか縮まない
このモデルは、答える前にまず思考します。広域市6都市を尋ねたところ、Bonsaiは蔚山を特別自治市と勘違いし、ソウルを除くと6つにならないと長く悩み、1,103トークンを思考して19秒で答えました。同じ質問にオリジナルは176トークンだけ思考し、5秒で答えました。
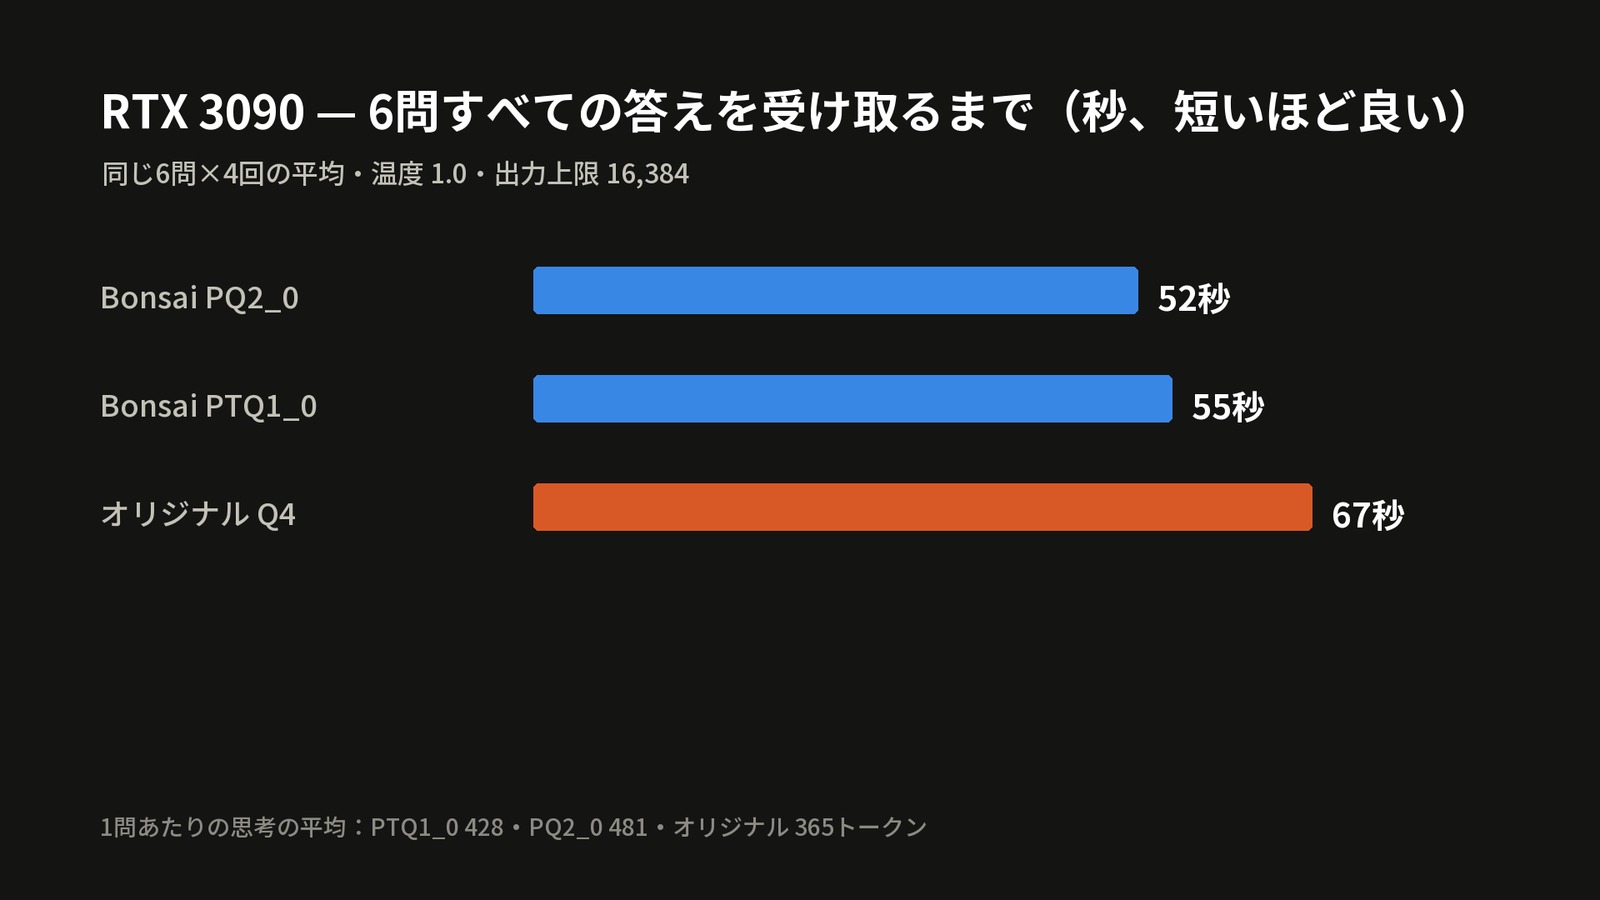
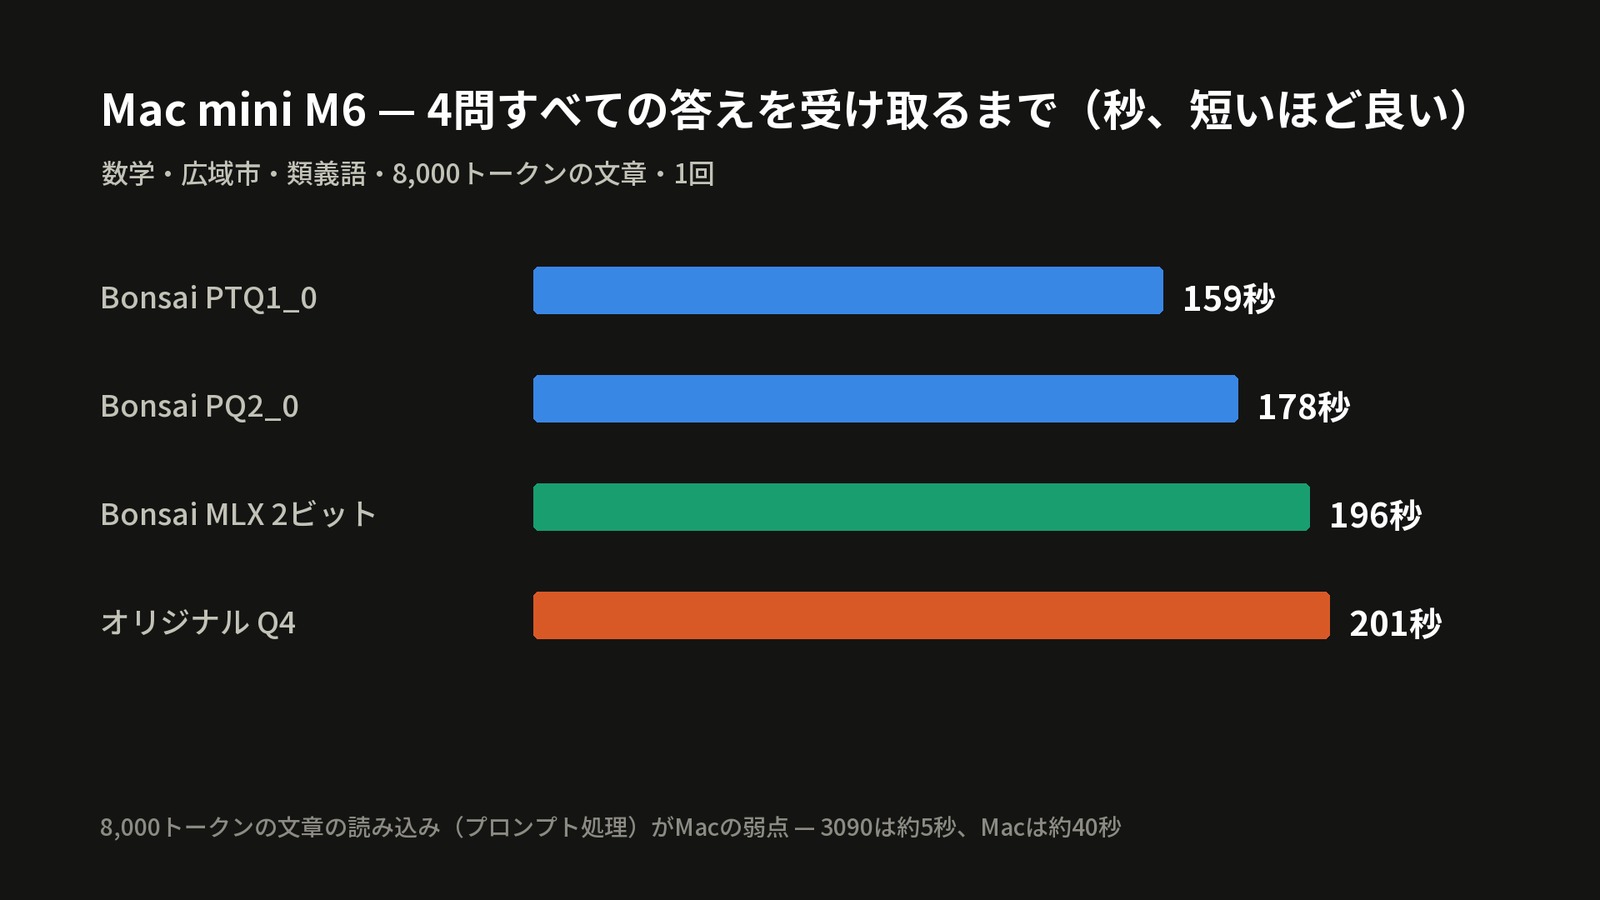
3090で6つの質問を4回ずつ実行し、すべての質問に答えが返るまでにかかった時間の平均は、Bonsai PQ2が52秒、PTQ1が55秒、オリジナルが67秒でした。質問あたりの思考トークンは、平均でPTQ1が428、PQ2が481、オリジナルが365でした。速度は1.5〜1.8倍なのに、待った時間は約20%しか短くなりませんでした。Mac miniでも同じで、4つの質問でBonsai PTQ1が159秒、オリジナルが201秒となり、2.3倍の速度が約21%の短縮にとどまりました。8,000トークンの文章を読むだけでも、どちらのモデルも40秒近くかかりました(Macの弱点)。コミュニティで不満の多かった「思考するだけで答えが空」は、今回の測定では一度もなく、最も長い思考は2,130トークンでした。出力上限を16,384と余裕を持たせたためと見られます。思考の強さを下げるmedium設定では、PQ2で思考が22%減り、PTQ1ではほぼそのまま(428→418)でした。
正確さ:どこで合い、どこで崩れたか
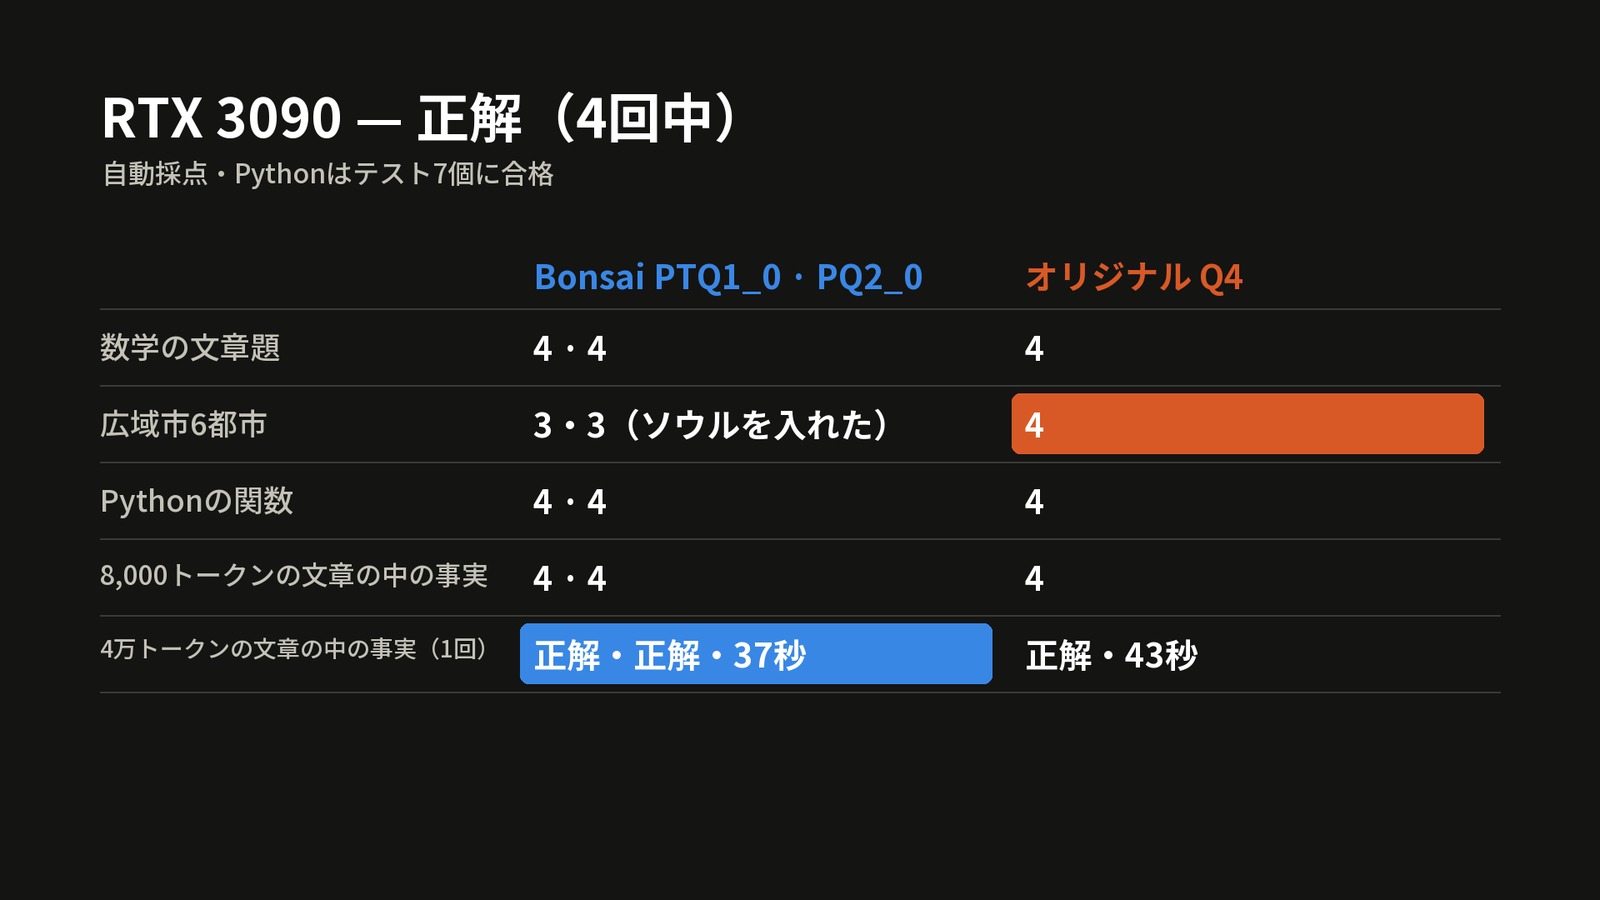
3090で4回実行した自動採点の結果です。数学の文章題、Pythonの関数(テスト7個)、8,000トークンの文章の中から事実を探す課題は、Bonsaiもオリジナルもすべて4/4でした。広域市6都市はBonsaiが3/4で、4回に1回はソウルを入れて蔚山か仁川を抜かしました(オリジナルは4/4)。4万トークンの業務日誌の真ん中に隠したパスワードは、Bonsaiの2つが37秒、オリジナルが43秒で、すべて正解でした(1回)。
崩れたのは、「빠르다」(速い)に意味が近い単語を5つ挙げる問題でした。Bonsai PTQ1は、思考の末に「빨리」と決めておきながら、答えには存在しない言葉「빠리」を書き、「빠름」「빠른」のように形を変えただけのものも混ぜました。4回尋ねると、Bonsaiからは속직、속소하다、순식のような言葉が出て、思考を減らしたmedium設定では「빠르다」だけを5回書きました。オリジナルは4回とも、신속하다、재빠르다、민첩하다のような実在する単語でした。Mac miniで1回実行したMLX 2ビット版は、広域市に城南を入れました。3値への圧縮は計算と事実の検索は守りましたが、まれにしか使わない韓国語の知識や単語の感覚は削られたように見えます。
動画が集めたコミュニティの反応も同じ方向です。98.2%という発表に反して、オリジナルと最初の単語が一致する割合は77.8%(4ビットは96.9%)だったという測定、思考が長すぎるという不満、日本語25問をすべて正解したという報告、不自然な韓国語の単語を除けばよくできているという評価が紹介されました(他者の報告)。
動画の判定と使う前の注意
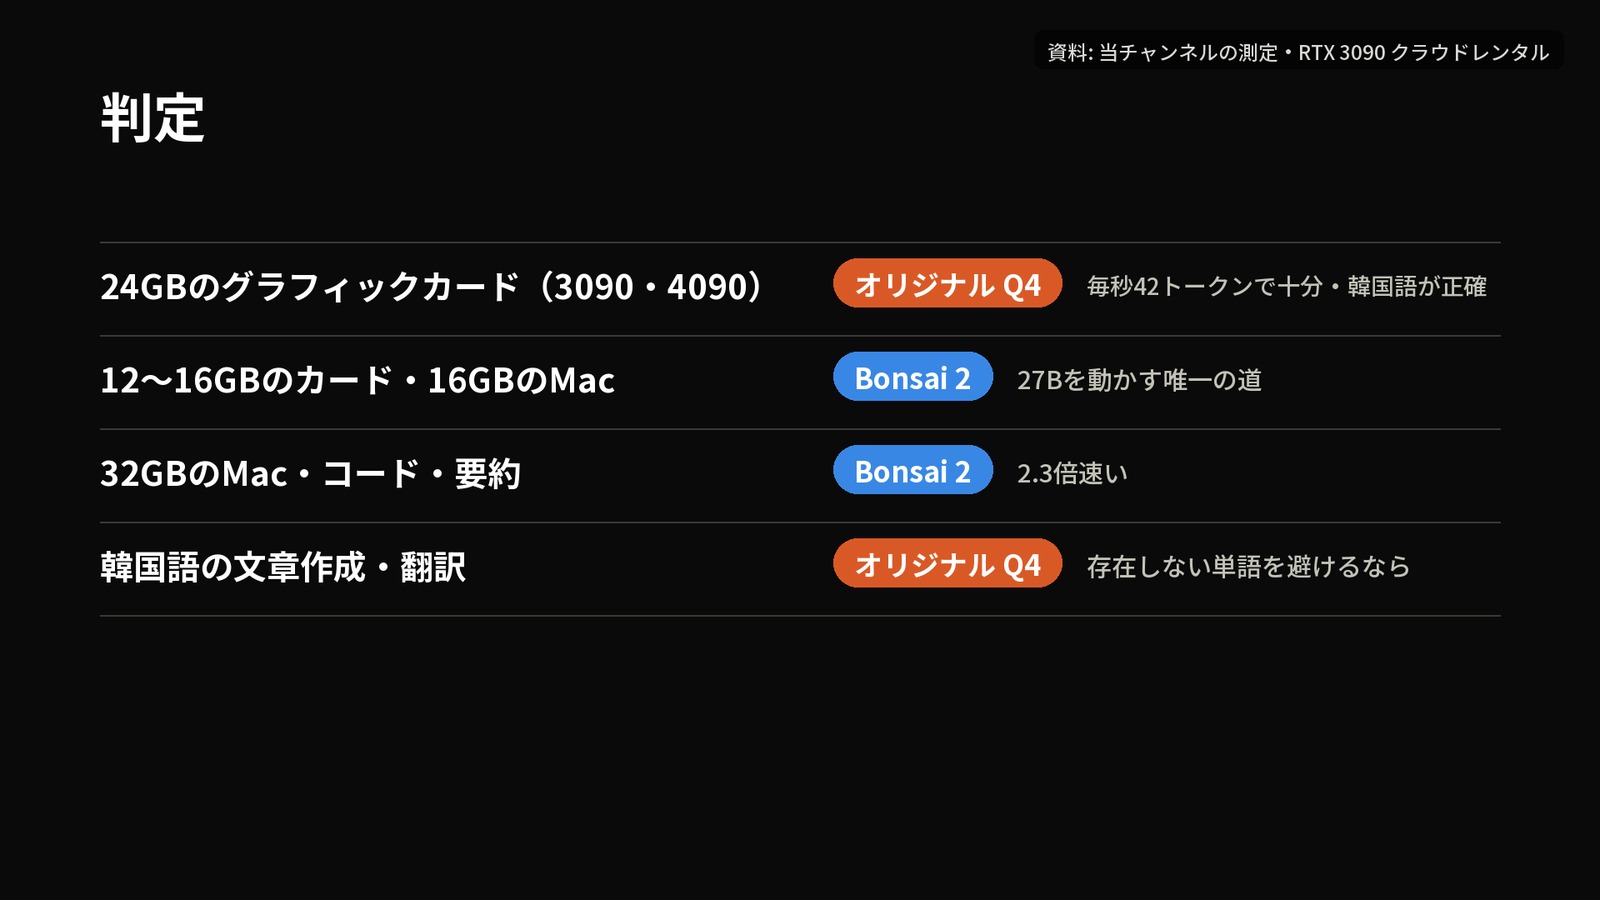
- 24GBのグラフィックカード(3090・4090)ならオリジナル4ビット:42トークン/秒で十分で、韓国語も正確です。
- 12〜16GBのカードや16GBのMacなら、Bonsaiが27Bを動かせる唯一の道です。
- 32GBのMacでコードや要約ならBonsai、韓国語の文章作成と翻訳ならオリジナルをすすめていました。
- 使う前に:専用のllama.cppフォークが必要で、出力上限は16,384以上と余裕を持たせ、3090ではPQ2、MacではPTQ1のほうが速くなりました。
限界と基準日
- 3090は1枚で6問×4回、Mac miniは4問を1回と、標本が小さいです。韓国語の単語の問題も数問だけです。
- 速度は専用フォークの1つのビルド(prism-b10743)での値で、他のツールや今後のアップデートで変わる可能性があります。
- M5 ProとM5 Maxの速度、98.2%は開発元の発表で、当チャンネルでは測っていません。
- 基準日:測定は2026-09-28、動画の公開は2026-09-29です。この記事は購入をすすめるものではありません。