MiniMax H3の最適設定:RTX 5090 1枚でAI短編映画を作って遭遇した問題7つ
投稿日 動画公開
RTX 5090 1枚で20分のAI短編映画を作りながら決めたMiniMax H3の設定と、セリフの繰り返し、話し声、全景の位置の問題の解決法、SageAttentionの実測をまとめました。
RTX 5090 1枚で20分のAI短編映画「90秒」(15シーン、クリップ198本)を作りながら、MiniMax H3の最適設定を探し、実際に起きた問題を解決した過程を整理しました。設定のうち速度を最も大きく変えたのはTurbo LoRAで、残りの問題の多くはGPUと無関係な「品質のルール」でした。この記事は、YouTube動画の内容を読みやすく整理し直したものです。
結論から
- 映像モデルはint8版を使い、速度はモード別のTurbo LoRAで稼ぎました。人物参照カットはref2v 8ステップ、最初のフレームから始まるインサートカットはfl2v 4ステップで、どちらも768p向けなので解像度を1344x768に合わせました。
- SageAttentionはオフにすると1区間が151秒から204秒へ約1.35倍遅くなるので、オンにしておきます。fp16 accumulationはH3の生成では違いがありませんでした。
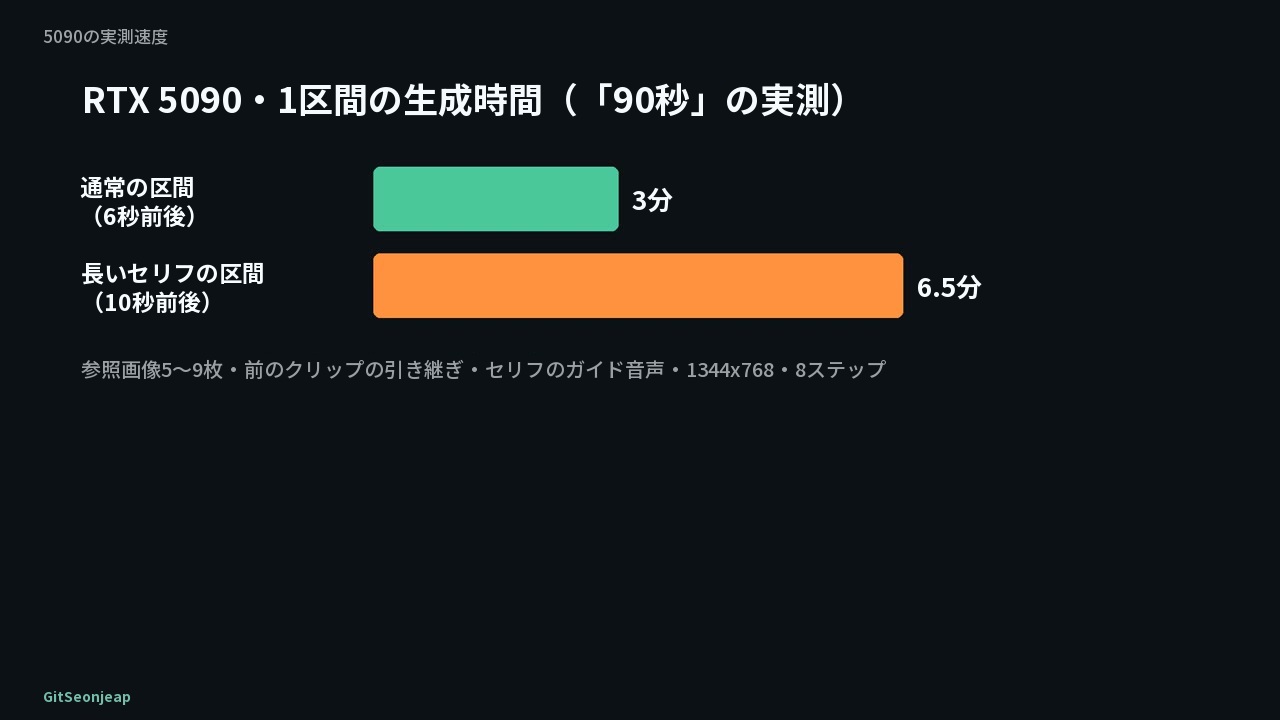
- 実際の生成は、通常の区間(6秒前後)で3分、長いセリフの区間(10秒前後)で6.5分でした。全体の所要時間の予想は、6〜9時間から10〜12時間に直しました。
- セリフは区間の最後に、音の説明には部屋の音だけを、画面内の文字は編集で、複数人が映る全景は位置を固定した最初のフレームから作ります。
この記事の数字は3種類です
| 表記 | 意味 |
|---|---|
| 当チャンネルの測定 | RTX 5090 32GB 1枚(クラウドで借用)、ComfyUI 0.37で自分たちが測った値(動画の日付2026-09-25時点) |
| 他者の主張・報告 | モデル側の説明、他チャンネルの測定、コミュニティの意見(出典は動画の概要欄) |
| 推定 | 直接は測っていないもの。低いGPUへのアドバイスがこれに当たります |
何を作り、どう動かしたか
「90秒」は心理スリラーです。人物と場所の画像はFLUX.2 [dev]、映像はMiniMax H3で作り、セリフの音声を先に作ってH3のガイド音声として入れることで、別途リップシンクをしなくても、生成の時点で口が言葉に合わせて動きます。映像生成はクラウドのRTX 5090で行いました。
設定①モデルファイルと設定②Turbo LoRA
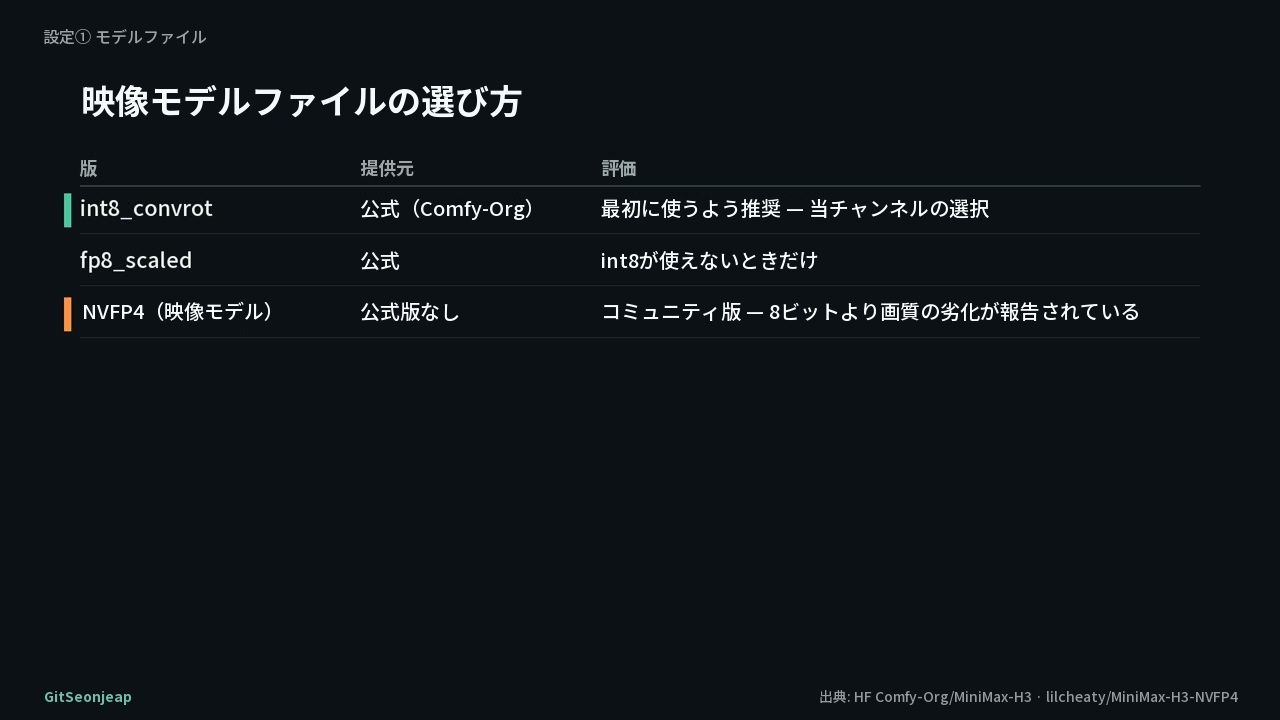
公式リポジトリ(Comfy-Org)は、int8_convrot版を先に使うよう勧めています。fp8_scaledはint8が使えないときだけ使う公式版です。50シリーズなのでNVFP4が思い浮かびますが、映像モデルには公式のNVFP4版はなく、コミュニティ版は8ビットより画質の劣化が目立つという報告があるため、int8にしました。
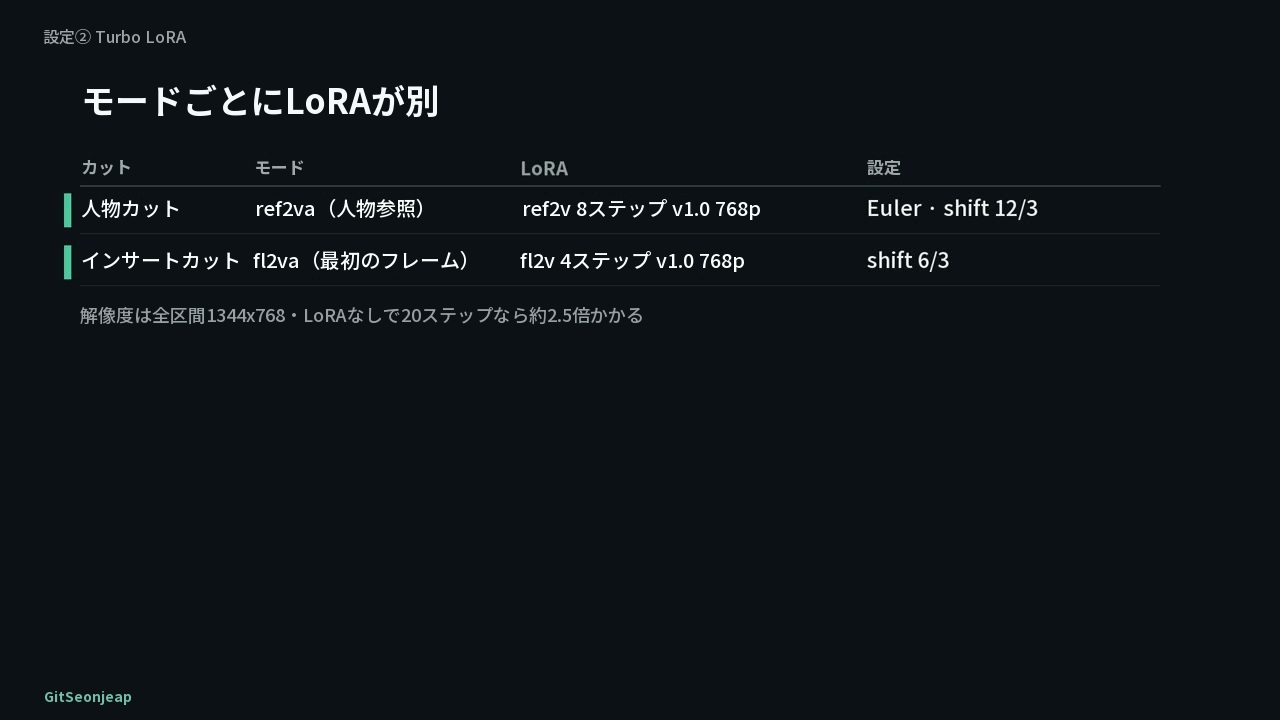
速度を最も大きく変えるのはlightx2vのTurbo LoRAで、モードごとにLoRAが別です。解像度1344x768の全区間で、LoRAなしの20ステップだと約2.5倍かかると動画に表示されていました。
| カット | モード | LoRA | 設定 |
|---|---|---|---|
| 人物カット | ref2v(人物参照) | ref2v 8ステップ v1.0 768p | Euler、shift 12/3 |
| インサートカット | fl2v(最初のフレーム) | fl2v 4ステップ v1.0 768p | shift 6/3 |
fl2vのバージョンは評価が分かれます。v1.2が良いという動画もあれば、v1.0が最も良くv1.2は元を大きく変えるというユーザーの声もあるため(他者の意見)、最初のフレームを変えにくいv1.0を選びました。
設定③オンにしたものとオンにしなかったもの(実測)
コミュニティが勧める速度オプション2つを、5090でオンオフして、同じ区間・同じシードで4通りの組み合わせを生成しました(組み合わせごとに1回ずつ)。
| 組み合わせ | 1区間の生成時間 | 基準との比較(SSIM) |
|---|---|---|
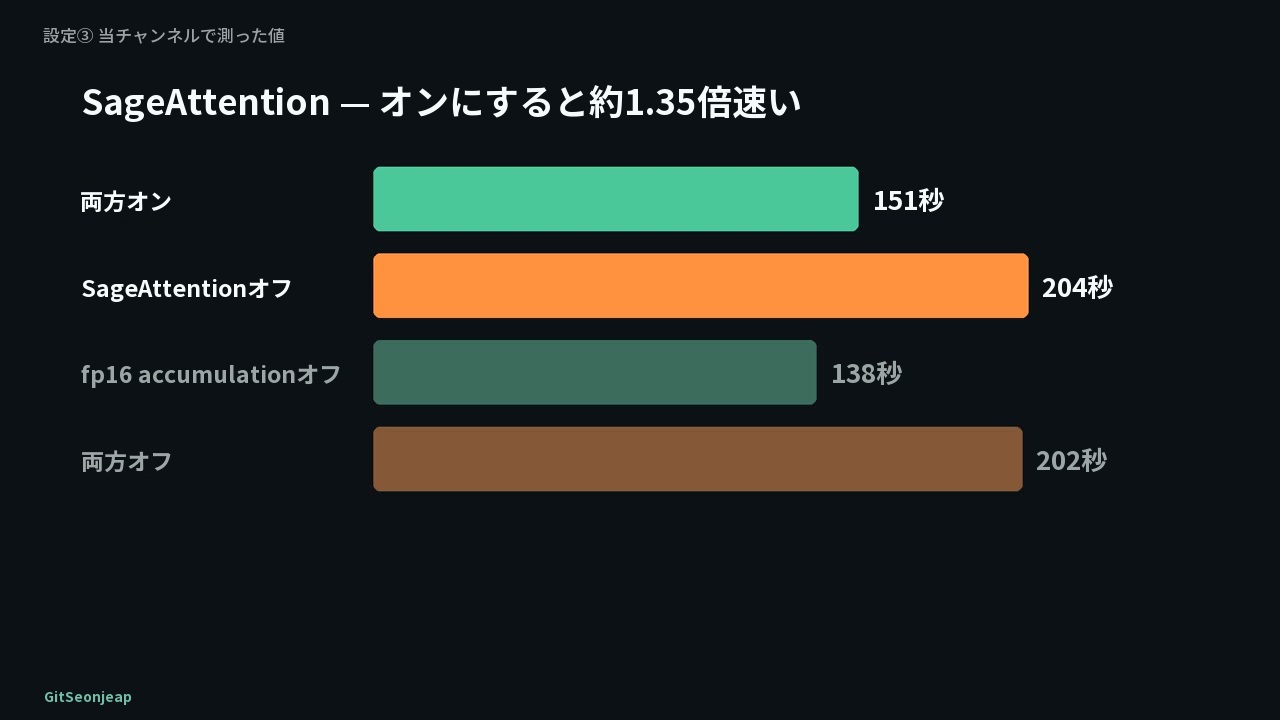
| 両方オン | 151秒 | 基準 |
| SageAttentionオフ | 204秒 | 0.947 |
| fp16 accumulationオフ | 138秒 | 0.929 |
| 両方オフ | 202秒 | 0.932 |
SageAttentionは確かな効果がありました(約1.35倍)。fp16 accumulationはむしろオフのほうが少し速かったのですが、1回ずつの値なので誤差の範囲と見ています。Comfyのブログがこのオプションで速くなったと書いたのは、映像生成ではなく映像のVAEでした。画面は4通りとも構図も内容も同じでした。
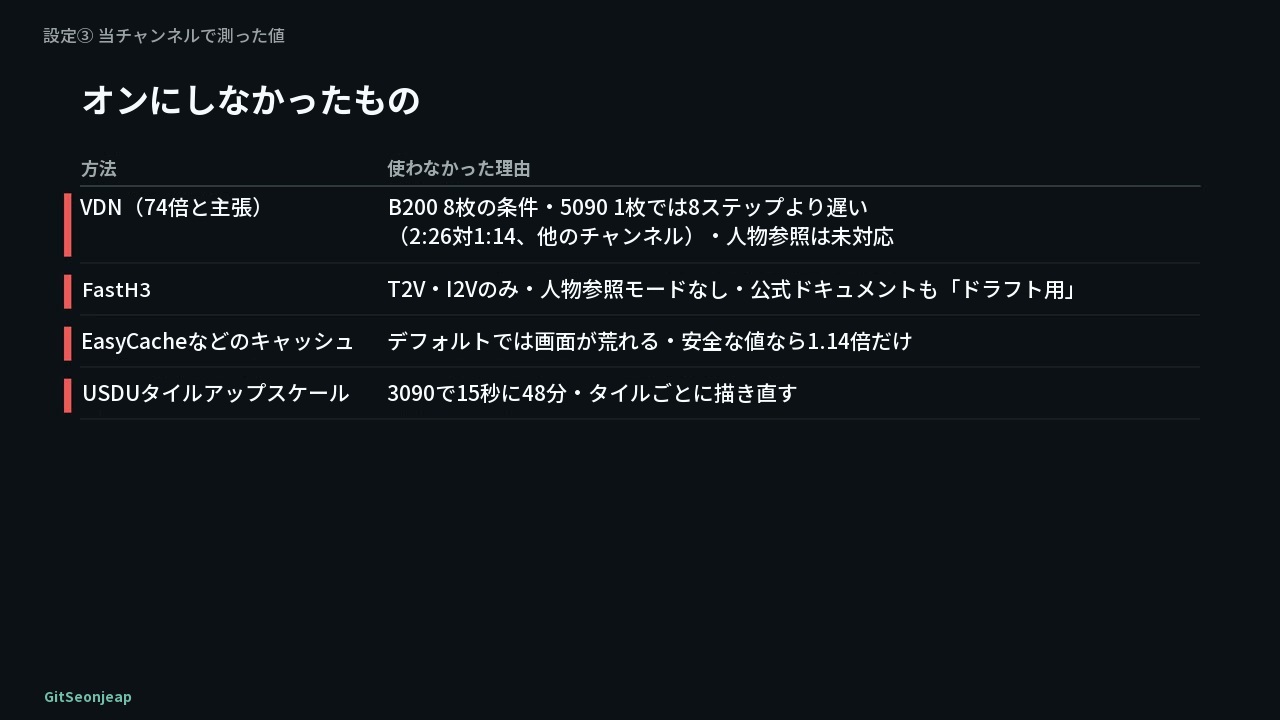
オンにしなかったものもあります。74倍速いというVDNはB200 8枚の条件での主張で、5090 1枚では8ステップより遅いという他チャンネルの測定があり、人物参照にも対応していません。FastH3はT2VとI2Vだけで人物参照モードがなく、公式ドキュメントも「ドラフト用」と書いています。EasyCacheなどのキャッシュ加速は、既定値では画面が荒れ、安全な値だと1.14倍だけなのでオフにし、USDUタイルアップスケールは動画の表記では3090で「15秒に48分」かかり、タイルごとに描き直すので使いませんでした。
5090での実測速度
1区間の生成は、通常の区間(6秒前後)で約3分、長いセリフの区間(10秒前後)で約6.5分でした(動画のナレーションでは2〜4分と5〜8分)。参照画像が5〜9枚、前のクリップの引き継ぎ、セリフのガイド音声が付くため、コミュニティの数字より遅くなります。198クリップ全体の最初の予想は6〜9時間でしたが、最初のクリップの実測を見て10〜12時間に直しました。
問題①同じセリフを2回言う
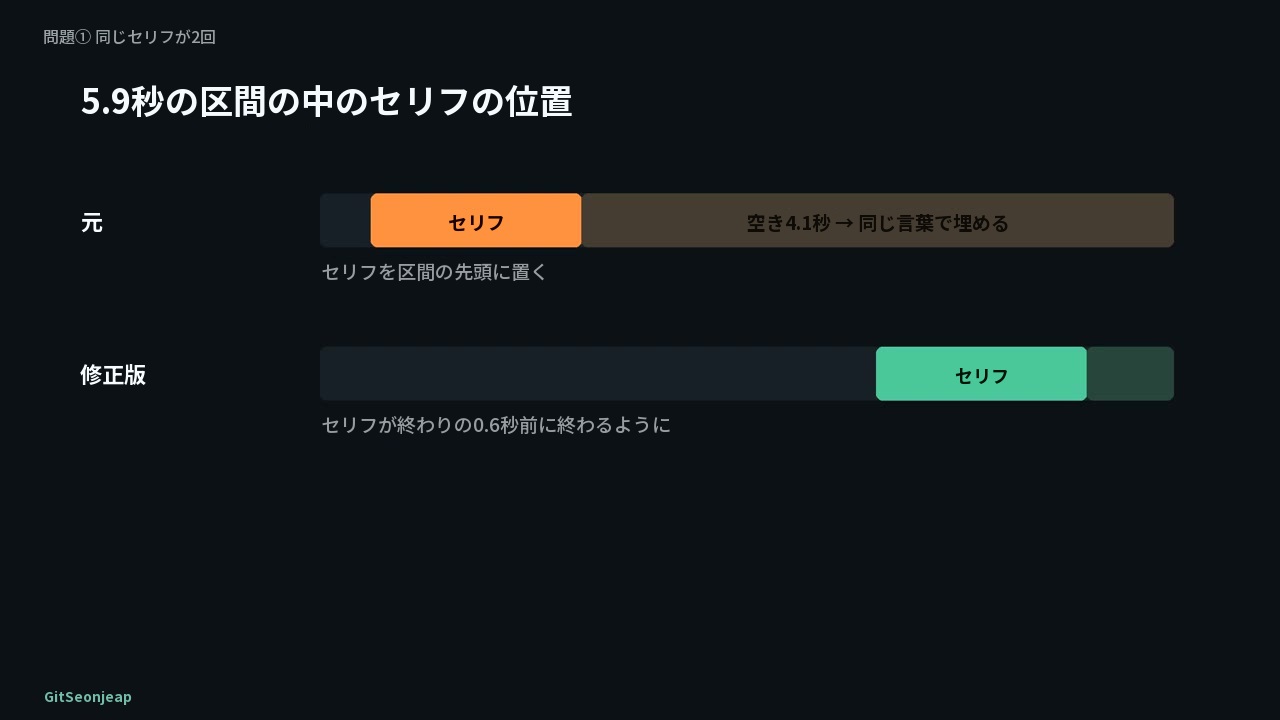
セリフは1.5秒なのに区間は5.9秒で、残った4.1秒をH3が同じ言葉でもう一度埋めました。プロンプトに「セリフの後は口を閉じる」と入れても効果はなく、音だけをガイドに変えると、繰り返しの音は消えても口は動き続けました。解決は、セリフ音声を区間の頭ではなく、区間の終わりの0.6秒前に終わるよう移すことでした。2つのシードとも1回だけ言い、その後のセリフ区間90個はすべて、文字起こし(Whisper large-v3)と音の比較で検査し、繰り返しはゼロでした。
問題②〜④音と空白の画面
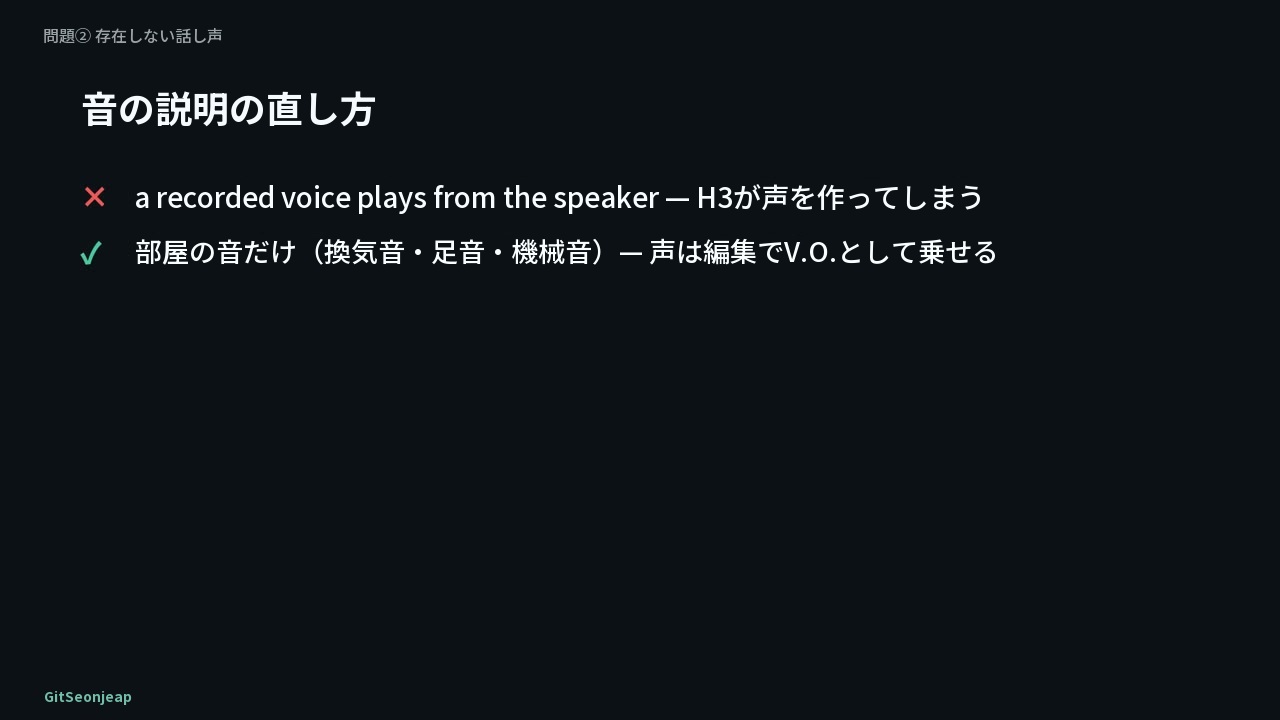
②セリフのないカットで、ロシア語のように聞こえる言葉や意味のない韓国語が混ざりました。音の説明に「スピーカーから流れる録音の声」とだけ書いたところ、H3がその声を作ってしまいました。声は編集で乗せ、H3には換気音、足音、機械音のような部屋の音だけを書くのが正解です。
③「声を出さずに唇で読む」という指示は、H3には話す口になります。口を閉じた動作に変えたら解決しました。
④真っ白な空白の画面は、H3が1秒以内に何かで埋めます(白い柱の空白画面に、いなかった人が現れました)。画面内の文字や映像は生成せず、最初のフレームを止めて使い、編集で乗せます。
問題⑤7人の全景で位置が入れ替わる
7人がそれぞれガラスの部屋にいる全景で、カットごとに誰がどの部屋かが変わり、位置を文章で書いても小さな顔7つの順番は守られませんでした。画像モデルに、人を所定の位置に座らせた最初のフレームを描かせると、「一番上の部屋」を柱のてっぺんと読み、部屋の外に立つ人が出たり、服が混ざったりしました。結局、人を切り抜いて座標で各部屋に貼り付けた画像を最初のフレームにしたところ、7カットとも最後まで同じ位置を守りました。位置の書き方にも注意が必要です。「一番左の奥の部屋」は画面の左端と読まれ、「柱のすぐ左の小さな部屋」のように目印で書くと合いました。
アップスケールと運用
動画の概要欄の章で番号が付いている問題は①〜⑤で、その後にアップスケールとMac mini・クラウドの運用の問題が続きます(動画のタイトルは「問題7つ」ですが、⑥⑦の番号は動画に別途表示されていません)。
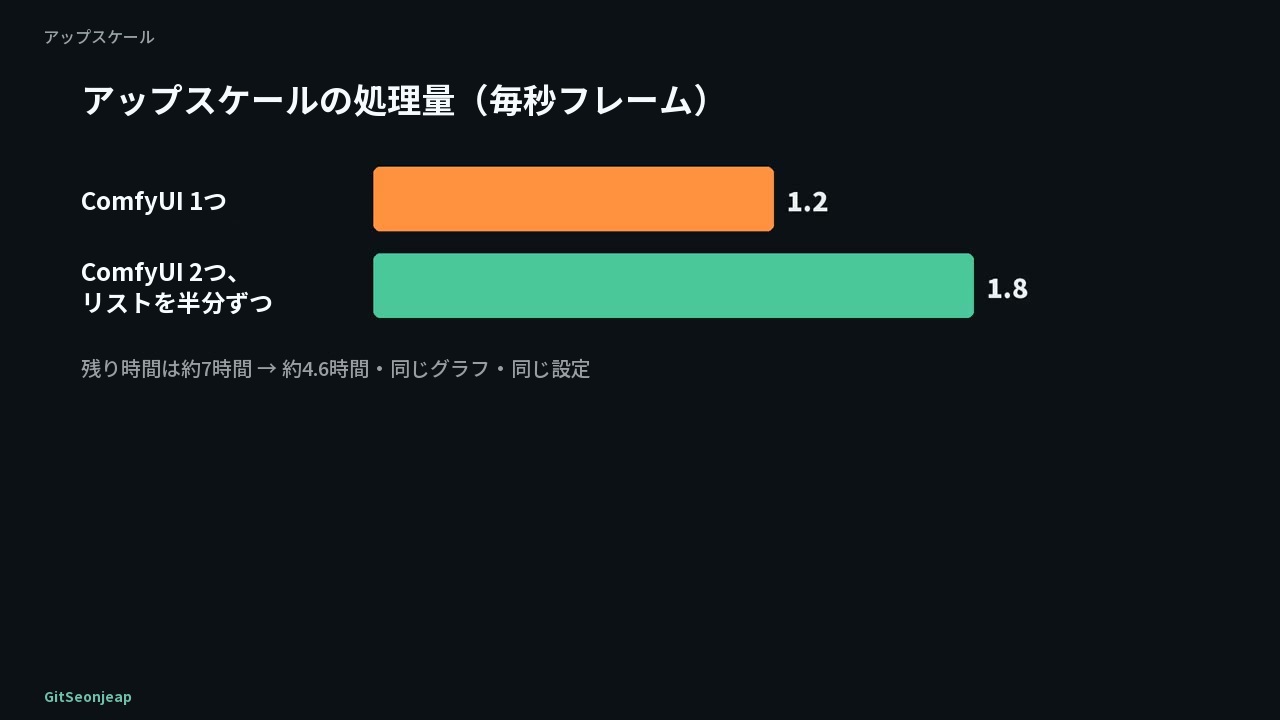
アップスケールはFlashVSR(v1.1 tiny-long)の2倍です。入力を960に下げると毎秒2.7フレームで、768入力の1.2フレームの2倍以上速いのですが、顔が少し変わり、ガラスになかった線が濃く出るため、元の768のまま入れました。5090の使用率を4秒間隔で見ると、100%と0%を行き来し、半分は遊んでいました。映像をエンコードしている間、GPUが休んでいるのです。サーバーにComfyUIをもう1つ立ち上げ、リストを半分ずつに分けて回すと、同じ設定・同じ画質で毎秒1.2から1.8フレーム、約1.5倍になり、残り時間は約7時間から約4.6時間に減りました。
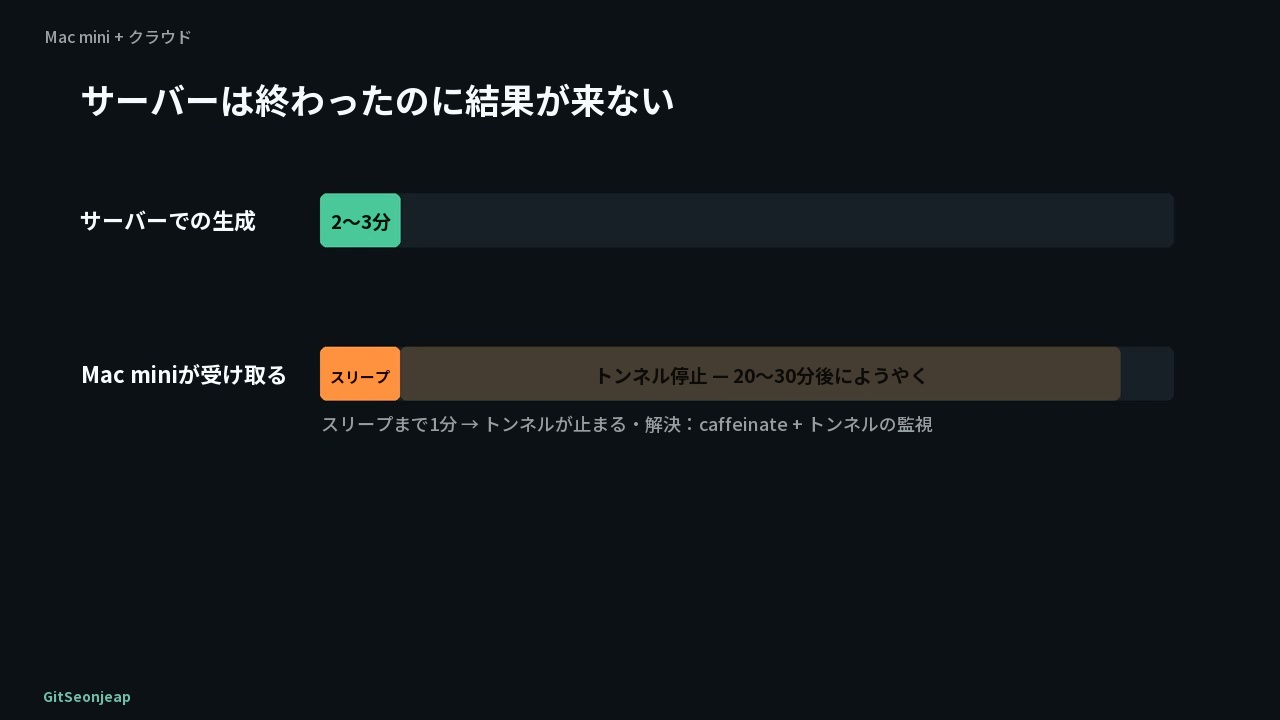
サーバー側では、2〜3分で終わる生成の結果が、Mac miniに20〜30分後にやっと届くことがありました。Mac miniが1分でスリープに入ってサーバーへのトンネルが切れ、その間サーバーはお金だけ使って遊んでいました。生成中はスリープを止め(caffeinate)、トンネルを守る監視を付けました。検査ツールはMac専用のMLXに移し、セリフ1区間の文字起こし(Whisper large-v3、Mac mini M6)がCPUのfaster-whisperの6.2秒からMLXの0.9秒に速くなりました。より速いturbo版(1.2秒)は、「PD」を「피디」と書き換えてしまうため使いませんでした。
5090より低いGPUなら(推定)
以下は直接測っていない推定です。動画のアドバイスは、24GBなら同じLoRAで参照画像の数を減らして長い区間は分け、16GB以下なら960x544で生成してからアップスケールし、複数人の全景は短くする、というものです。どのカードでも、セリフの位置、音の説明、画面内の文字、全景の最初のフレームのルールはそのまま通用します。
限界と基準日
- 速度オプションの比較は組み合わせごとに1回ずつで誤差があり、fp16 accumulationの差は誤差の範囲と見ています。
- 速度と設定は、RTX 5090 32GB 1枚、ComfyUI 0.37、「90秒」の参照画像5〜9枚という条件で測った値で、他の作業では変わる可能性があります。
- VDN、FastH3、キャッシュ加速、USDUの値は、動画の表記をそのまま載せたものです。5090 1枚でのVDN比較は他チャンネルの実測、FastH3は公式ドキュメントの引用ですが、キャッシュ加速とUSDUの値は出典が動画に別途表示されておらず、直接測ったものか報告の引用かは区別できません。
- 低いGPUへのアドバイスは推定です。完成した「90秒」はこの動画には含まれていません。
- 基準日:動画の公開は2026-09-25です。モデルやLoRAのバージョン、推奨設定はその後変わっている可能性があります。実際に、この動画の公開後、チャンネルの標準の制作設定はTurbo LoRAなしの20ステップに変わり、アップスケールは1344x768の元画像を960x544に縮小してから2倍にする方式が標準になっています。この記事の設定と判断は、動画の公開日時点のものです。